comfyUI基础节点详解——条件
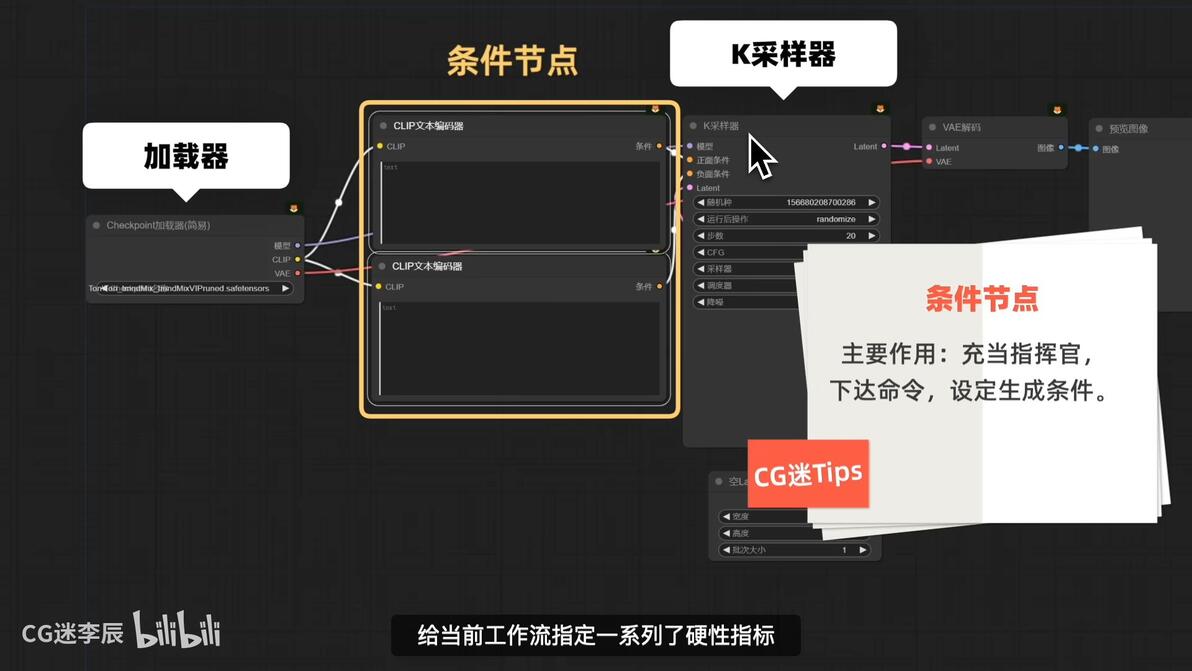
我们常用的条件节点都是添加在加载器和k采样器之间的,条件节点主要的作用就是充当命令指挥官,给当前工作流指定一系列硬性指标。
例如:提示词要求生成什么样的内容,ControlNet要求生成生么样的动作姿势。
最终画面都需要遵循这些条件节点的要求来生成图像。
一、风格模型应用节点
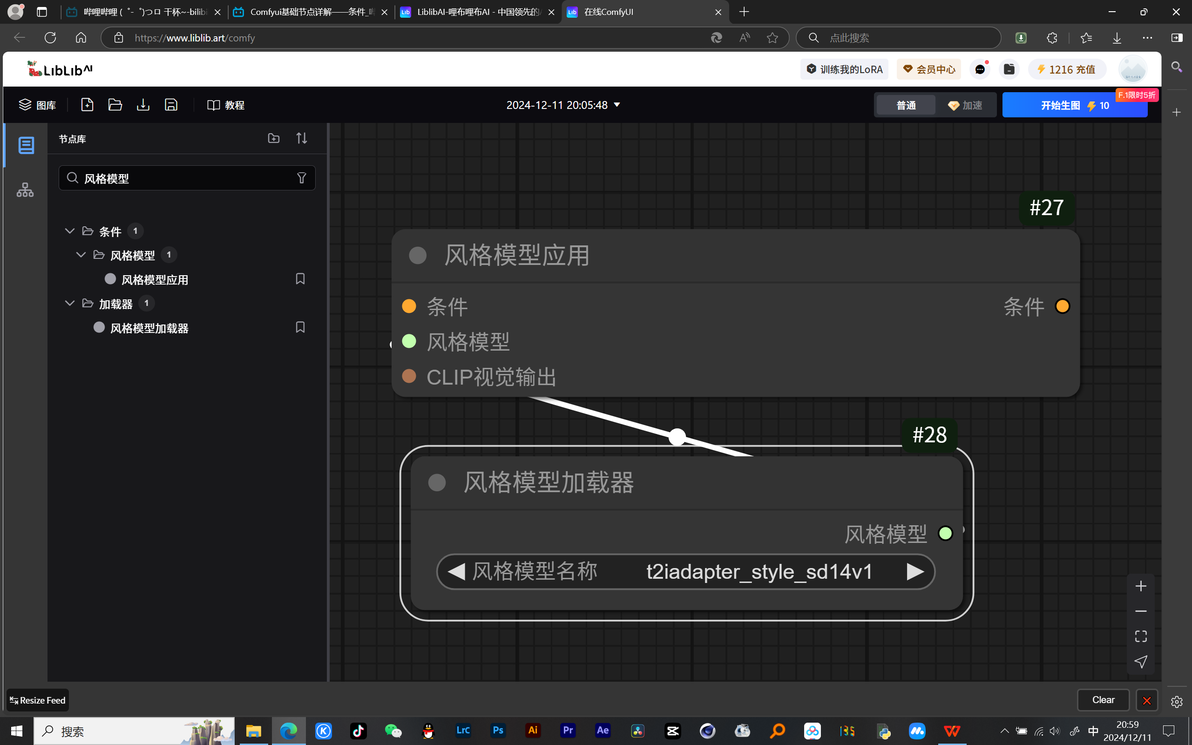
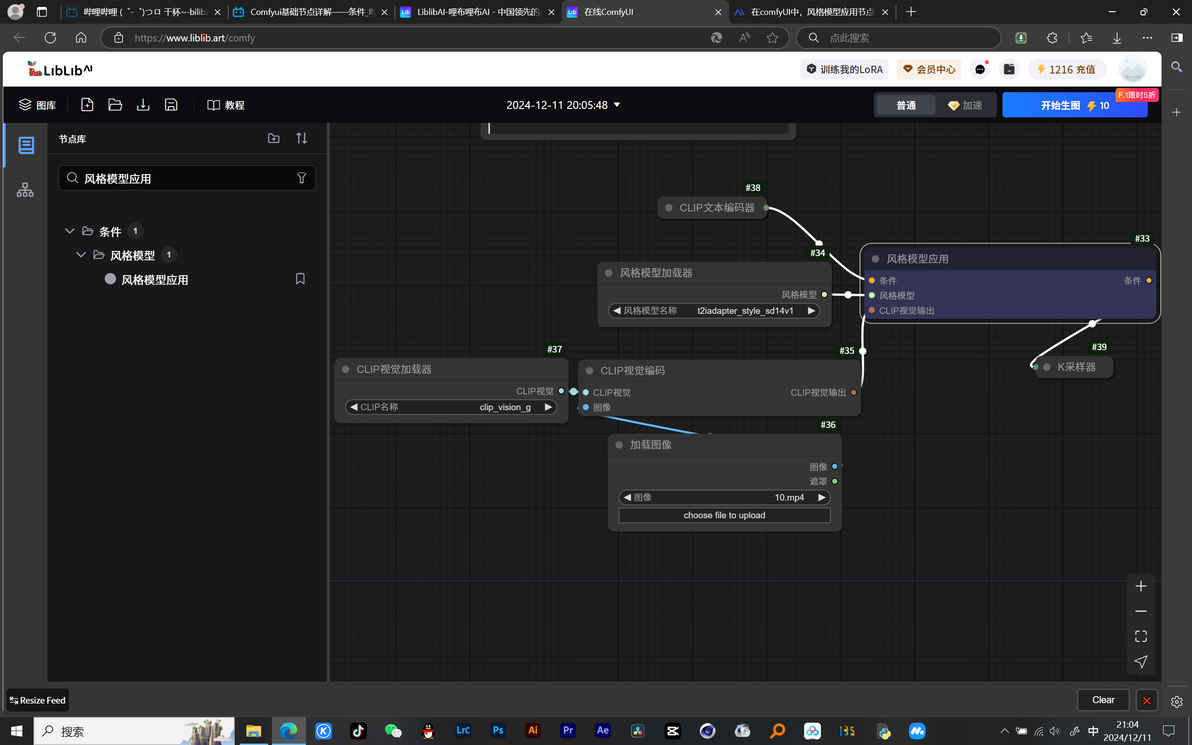
风格模型应用节点(StyleModelApply)是一个用于将风格模型应用于给定条件的节点。其主要功能是基于CLIP视觉模型的输出来增强或改变生成图像的风格。这个节点通过整合风格模型的条件到现有条件中,确保在生成过程中风格能够无缝融合。
详细请看(CG迷李辰)up上一节课的教程
二、ControlNet应用节点
ControlNet应用节点主要用于增强图像生成过程的控制能力。ControlNet是一种神经网络技术,通过引入额外的控制信号来指导生成模型,从而实现对图像生成的精确控制。这些控制信号可以是图像的边缘、草图、深度图或其他形态的信息。
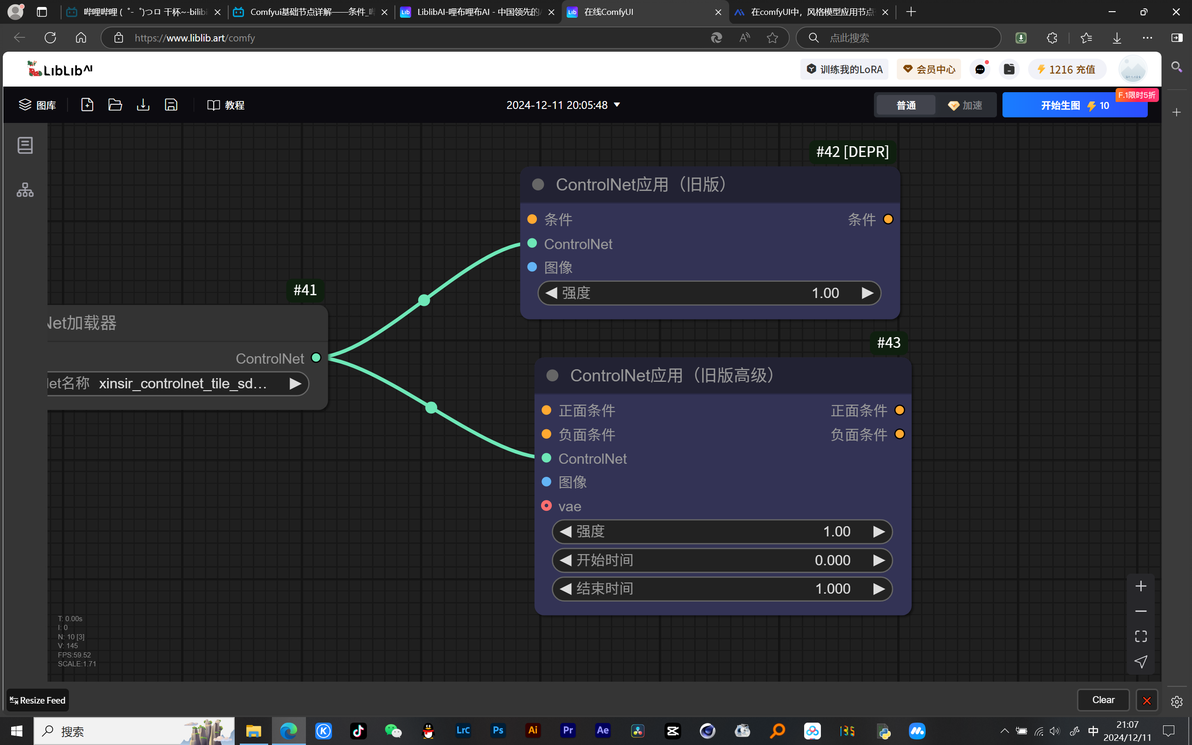
1、ControlNet应用(旧版)

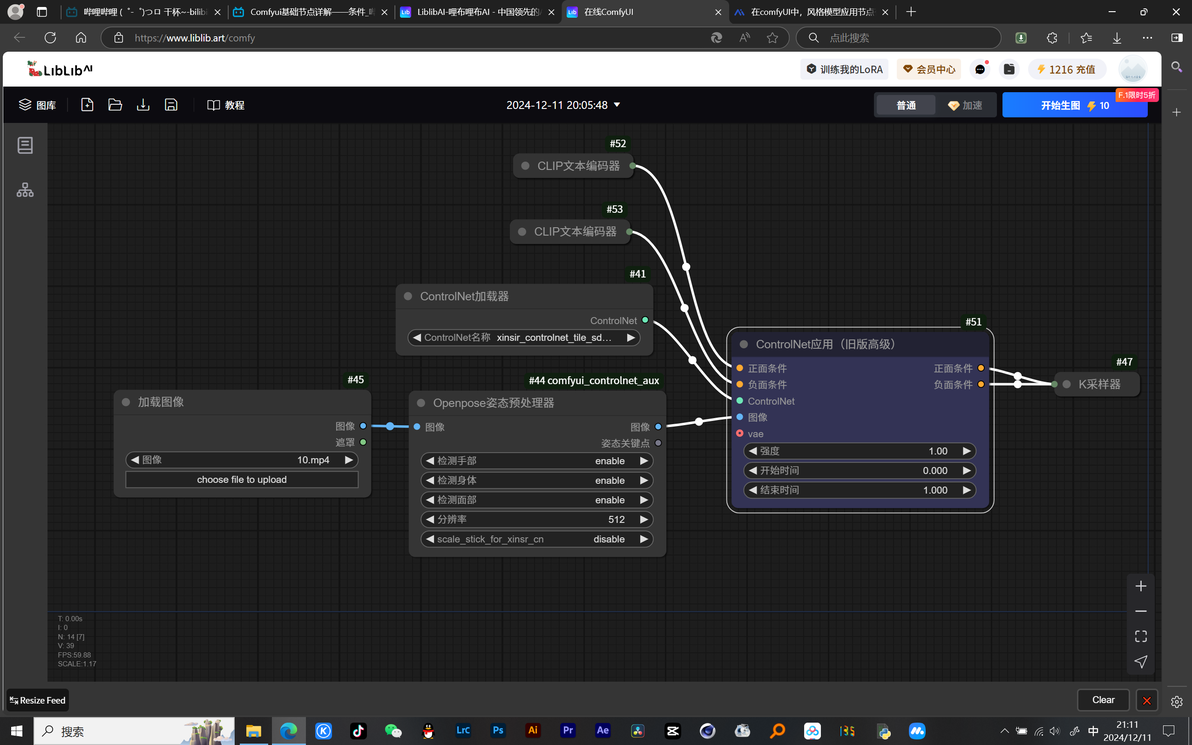
2、ControlNet应用(高级)
三、GLIGEN文本框节点
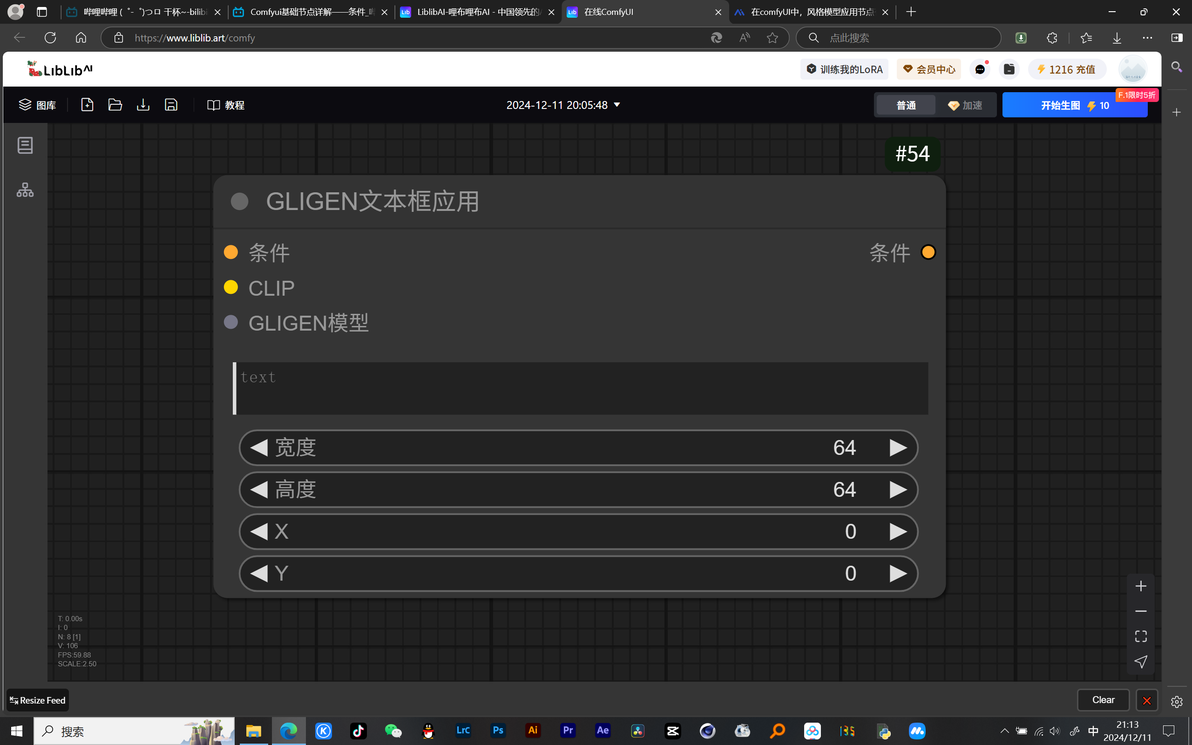
GLIGEN文本框节点主要用于为扩散模型提供空间引导,以便在图像的特定区域生成指定的提示部分。这个节点通过结合文本信息和空间信息,帮助用户更精确地控制生成模型的输出。
具体来说,GLIGEN文本框应用节点(GLIGEN Textbox Apply node)允许用户在图像中指定多个对象的位置和大小。用户需要编写一个包含所有信息的提示,并使用GLIGEN文本框应用节点来指定提示中特定对象或概念的位置。例如,如果用户希望生成一幅包含“猫”和“篮球”的图像,可以设置一个文本框,文本为“猫”,位置在图像的左上角,然后设置另一个文本框,文本为“篮球”,位置在图像的右下角。这样,模型在生成图像时就会尽可能地让“猫”出现在左上角,“篮球”出现在右下角。
此外,GLIGEN文本框节点还能够整合基于文本的条件信息到生成模型的输入中,通过空间和文本信息丰富条件信息,从而促进更精确和上下文感知的生成。这个过程不仅提高了生成的准确性,还增强了生成内容的上下文关联性。
四、内部模型条件(局部重绘节点)
内补=inpaint(局部重绘)
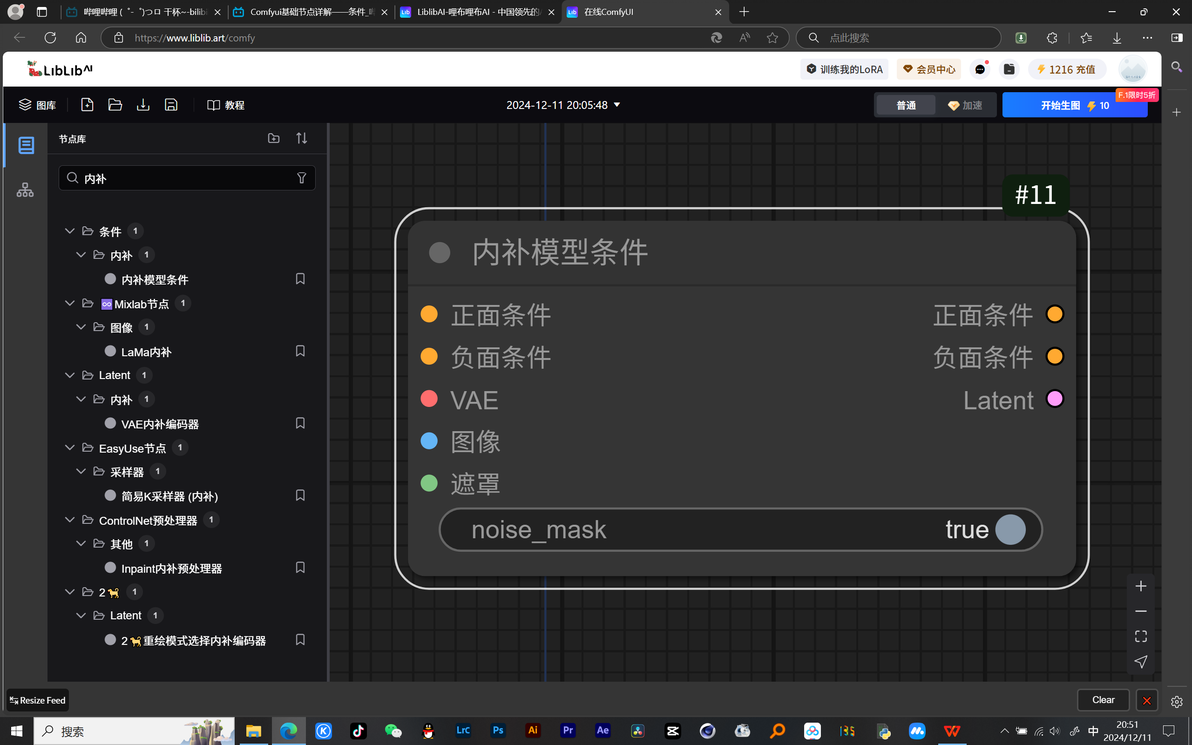
内部模型条件节点的接入图生图工作的连接方式:
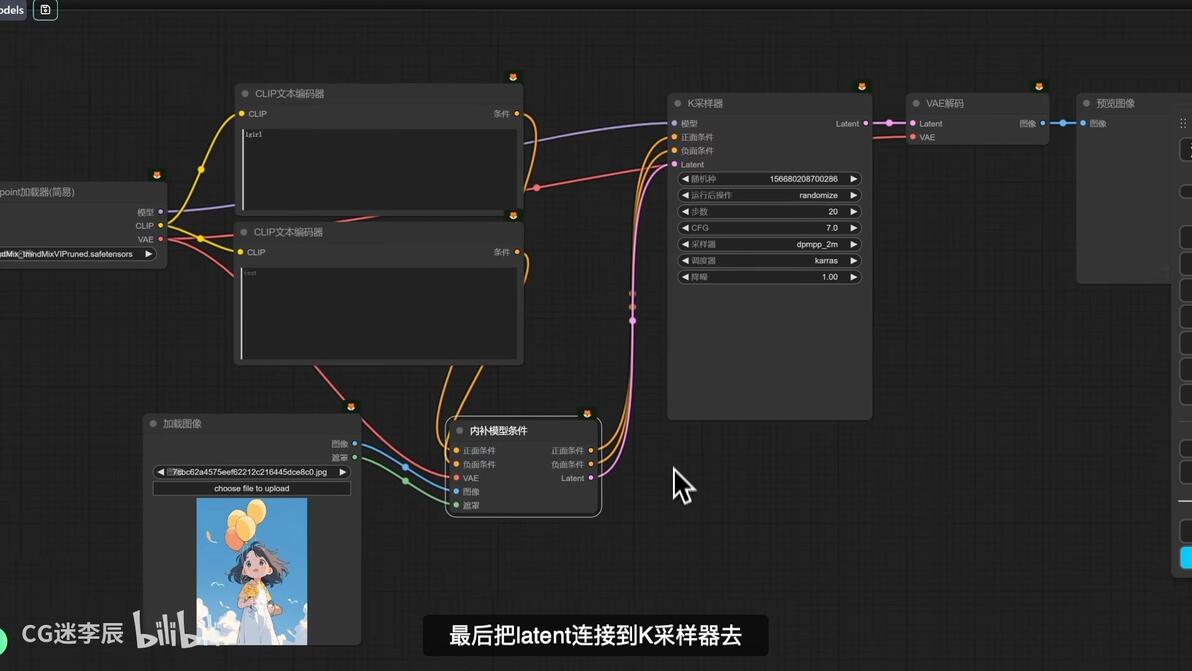
连接好后,我们需要给内补模型条件设定重绘的遮罩区域。
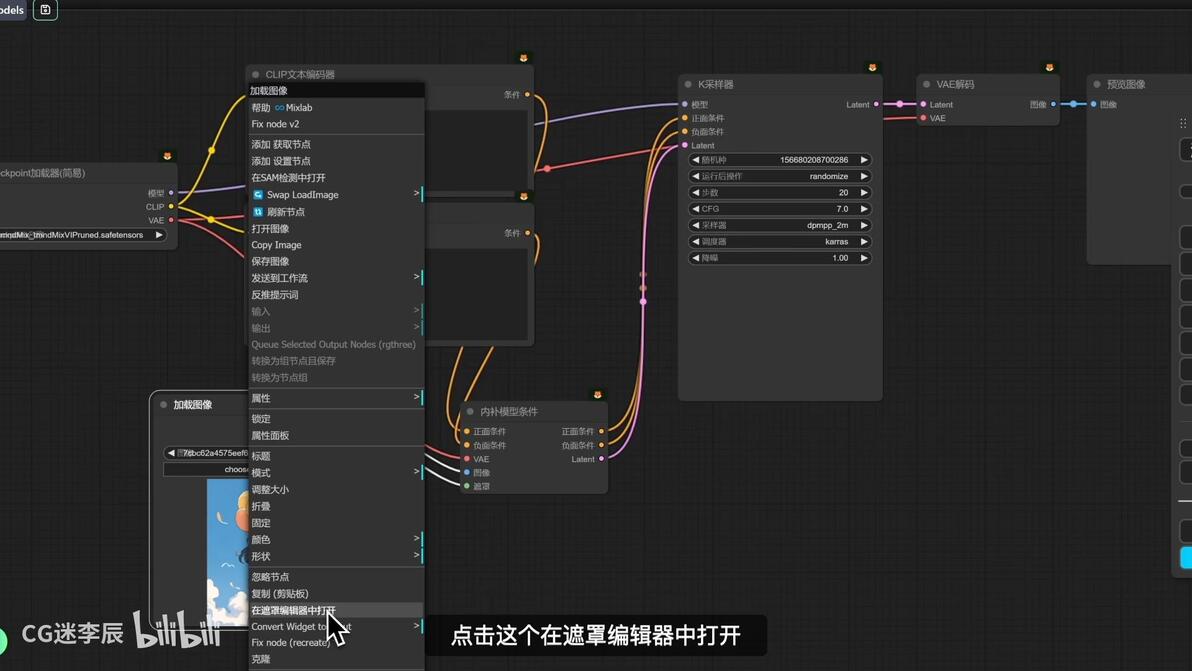
在加载图像节点上右键,点击【在遮罩编辑器中打开】
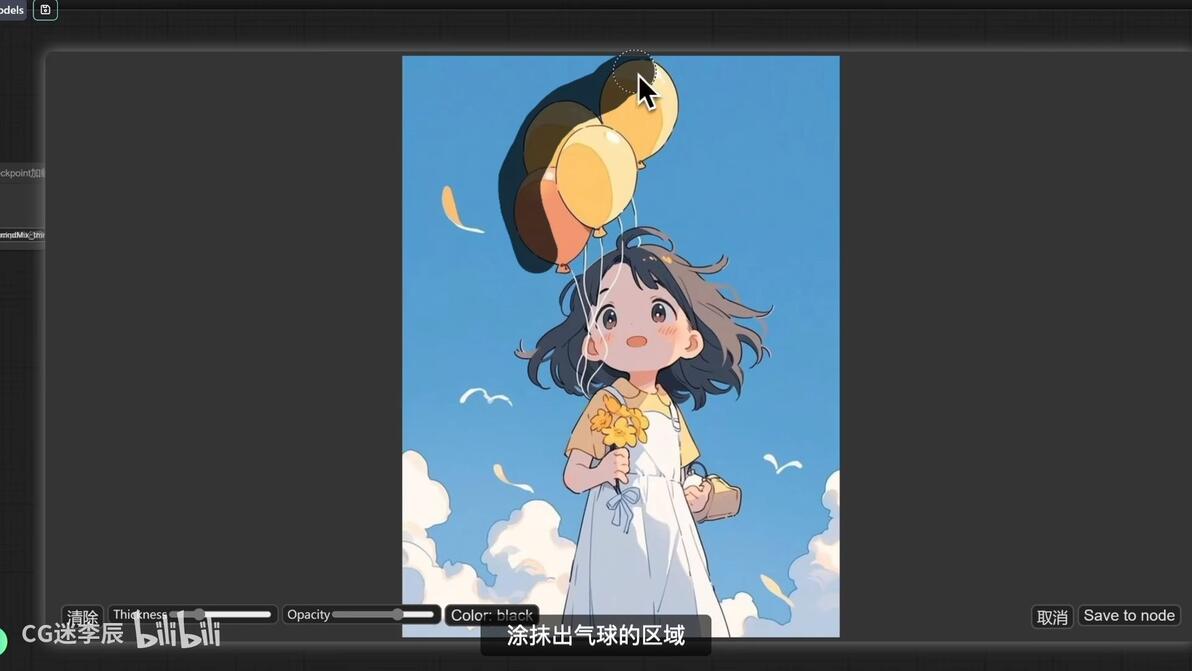
在画面中涂抹出你想修改(重绘)的区域,之后点击右下角save to node(保存)
这样需要重绘的区域就设定好了。
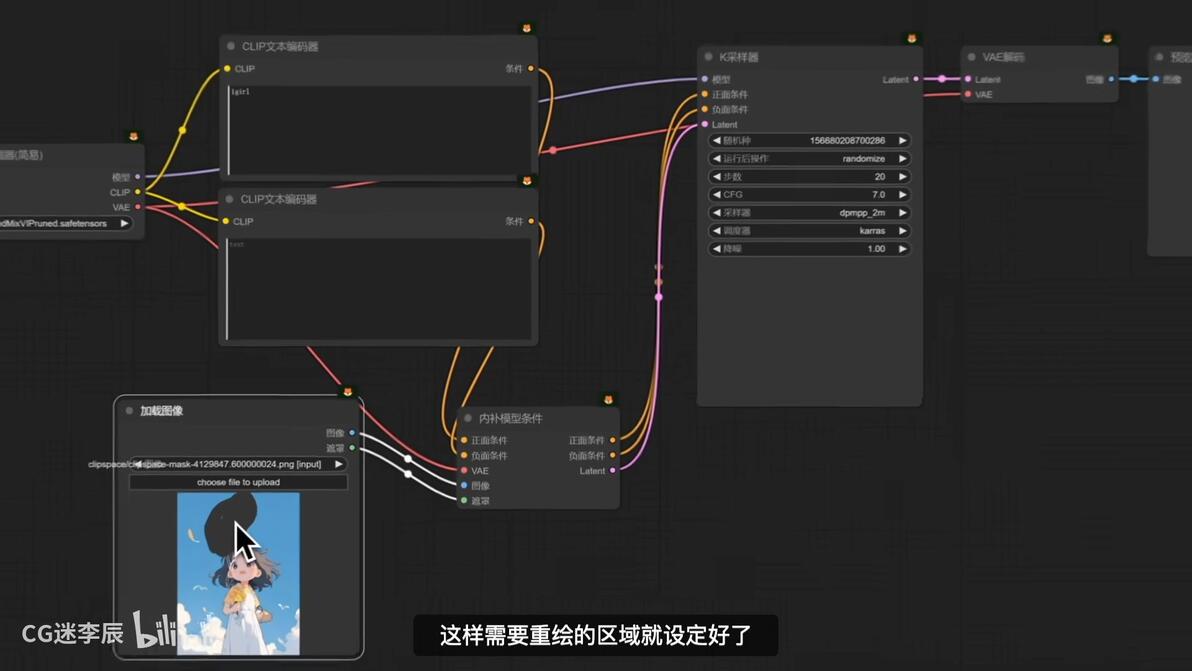
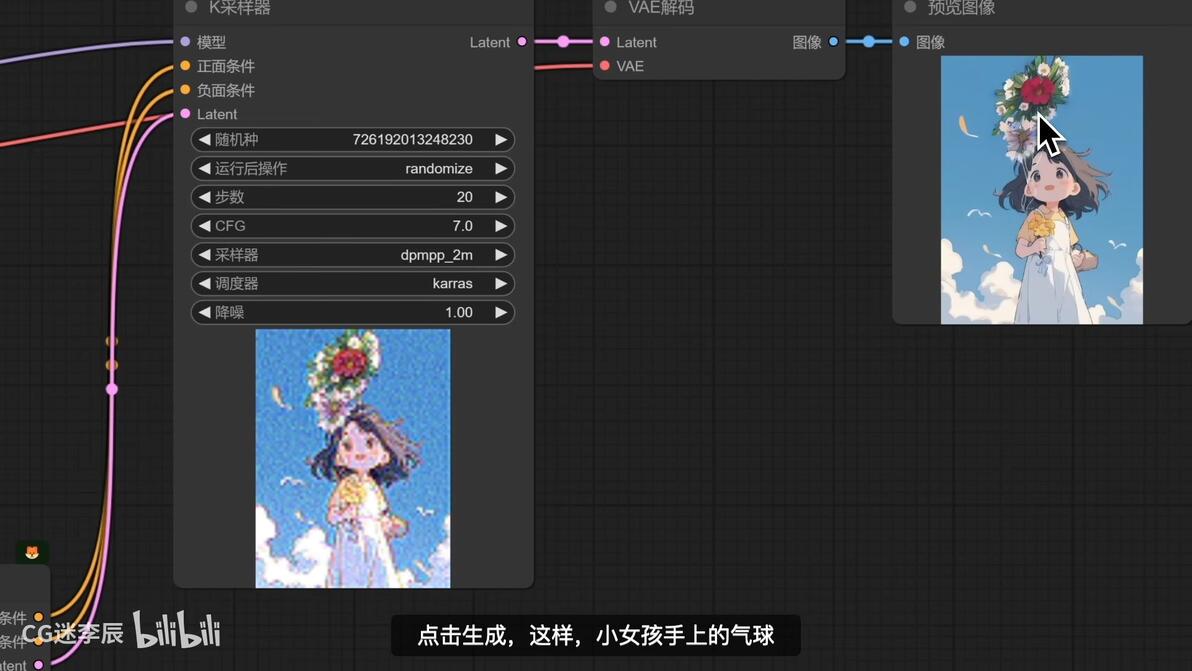
正面条件提示词是“鲜花”,点击生成后,小女孩受伤的气球就变成了鲜花。
五、SVD_图像到视频_条件
SVD节点(Stable Video Diffusion)是一种用于图像到视频生成的模型。该模型由Stability AI公司开发。
SVD的工作原理主要基于扩散技术,通过逐步增加噪声来模拟视频帧的生成过程。该技术允许用户调整缩放比率和噪声增强以微调增强过程,从而生成高质量的视频。
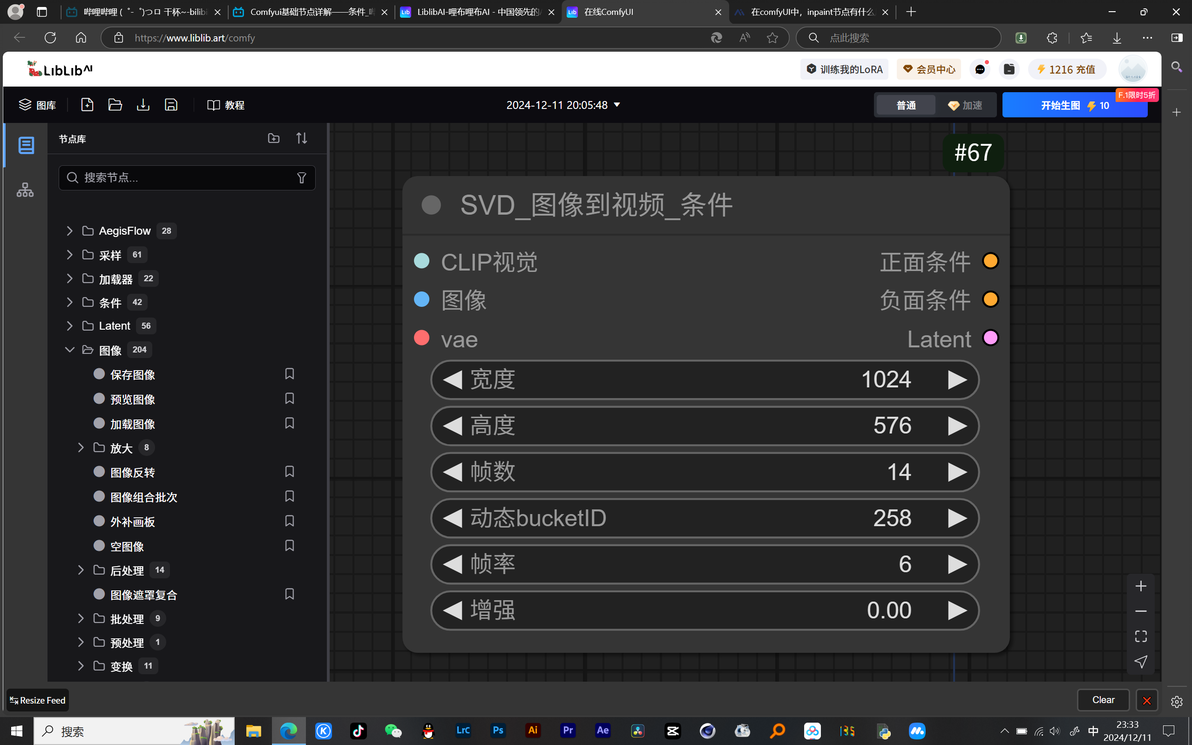
以下是SVD节点连接工作流的方式:
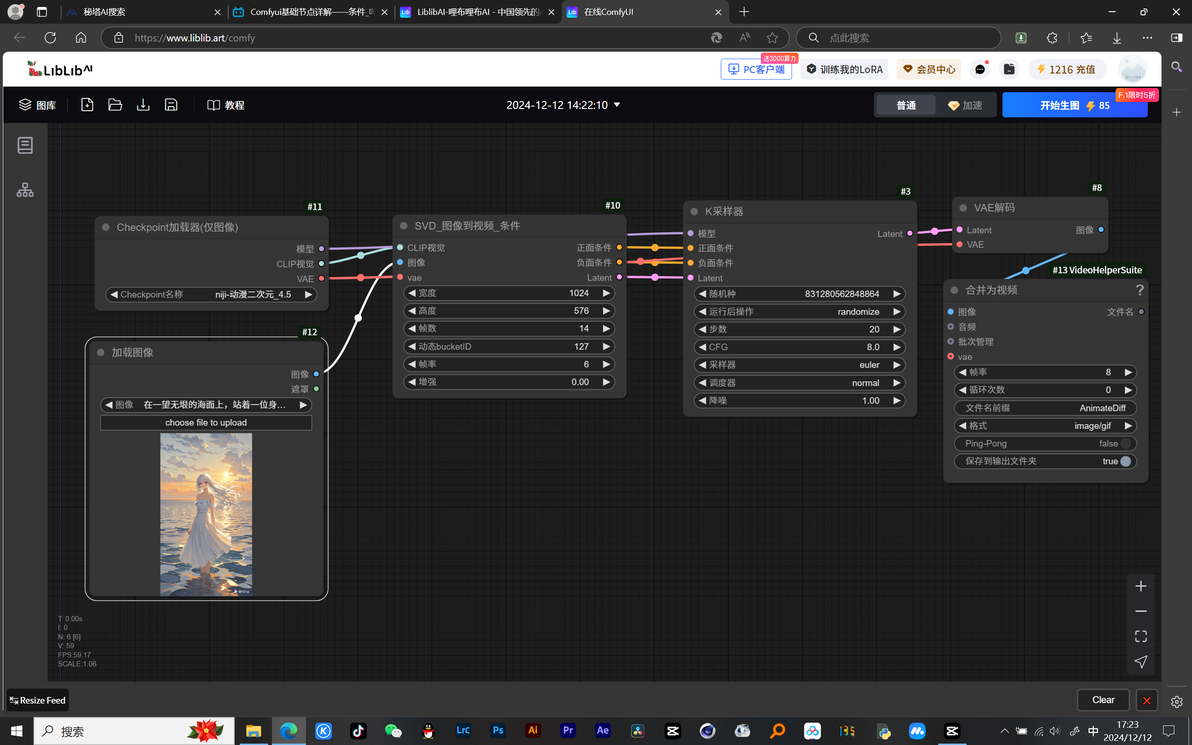
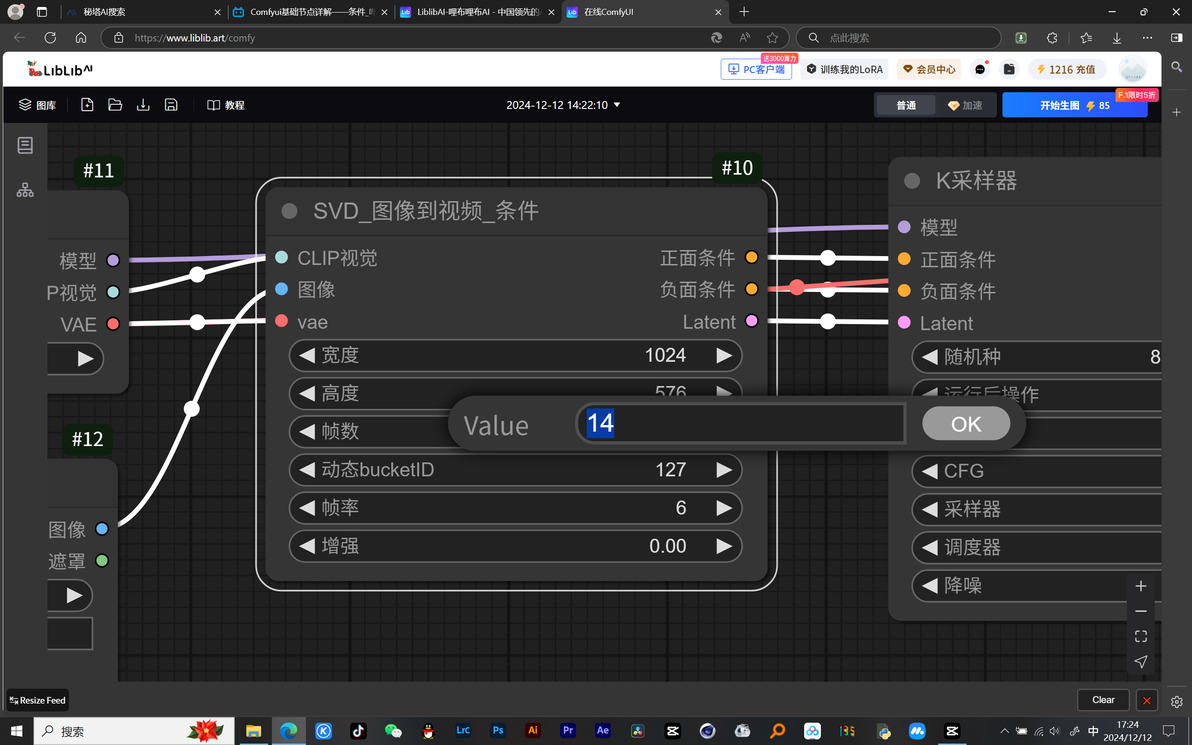
视频的帧数为视频的总长度,一般1秒为24帧,而帧率就是1秒钟能有多少张图片闪过。
eg:帧数:24
帧率:6
24/6=4秒
六、SZ123条件节点和SV3D条件节点
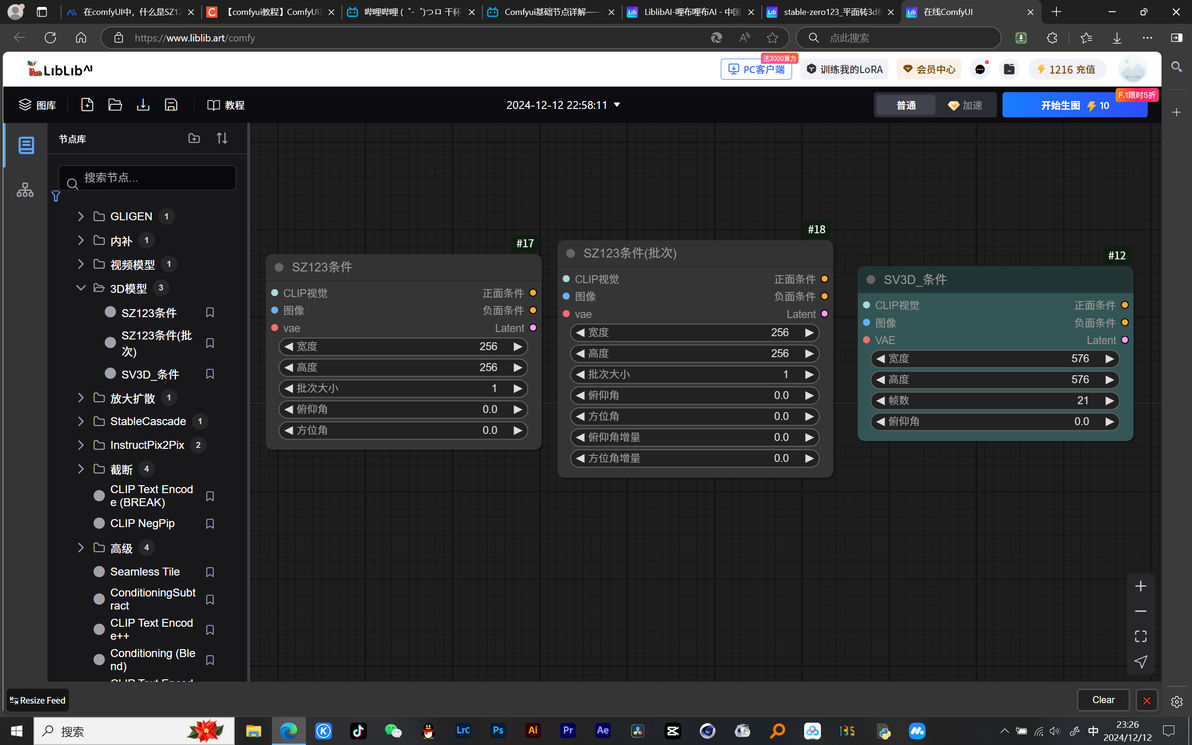
SZ123条件节点主要用于生成具有特定角度的3D视图,而SV3D条件节点则专注于生成高质量的3D视频。
1、SZ123条件节点 /(批次)
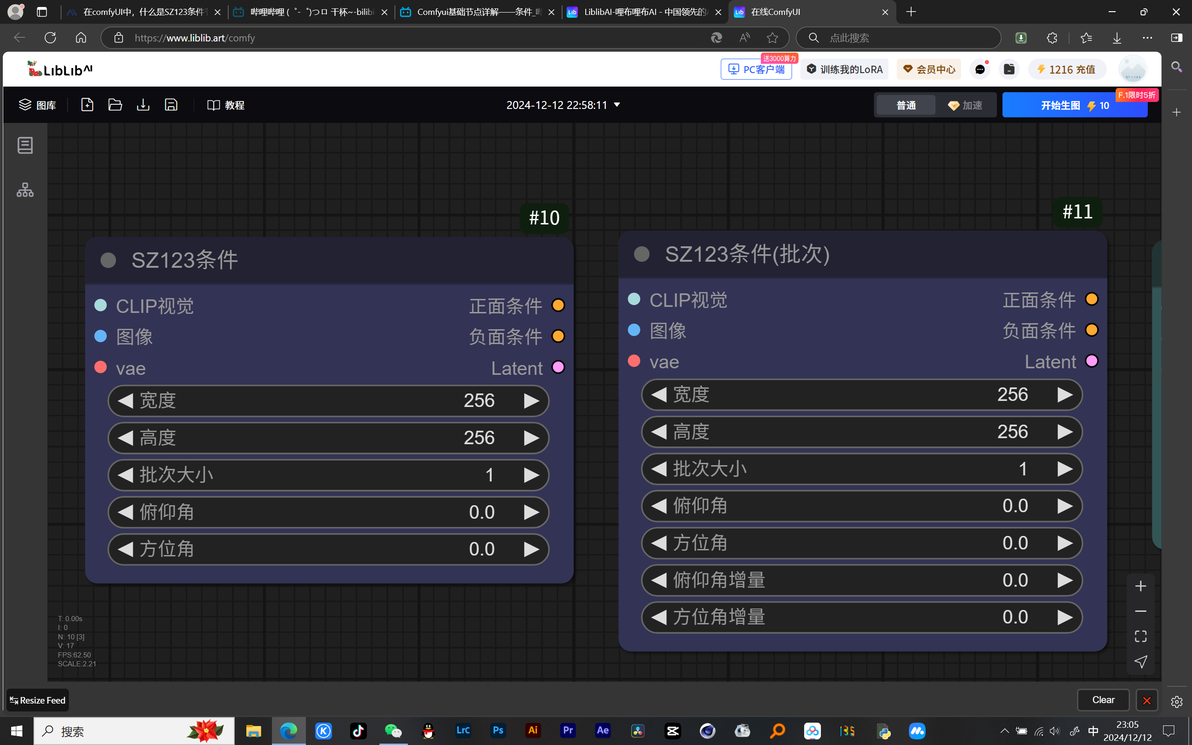
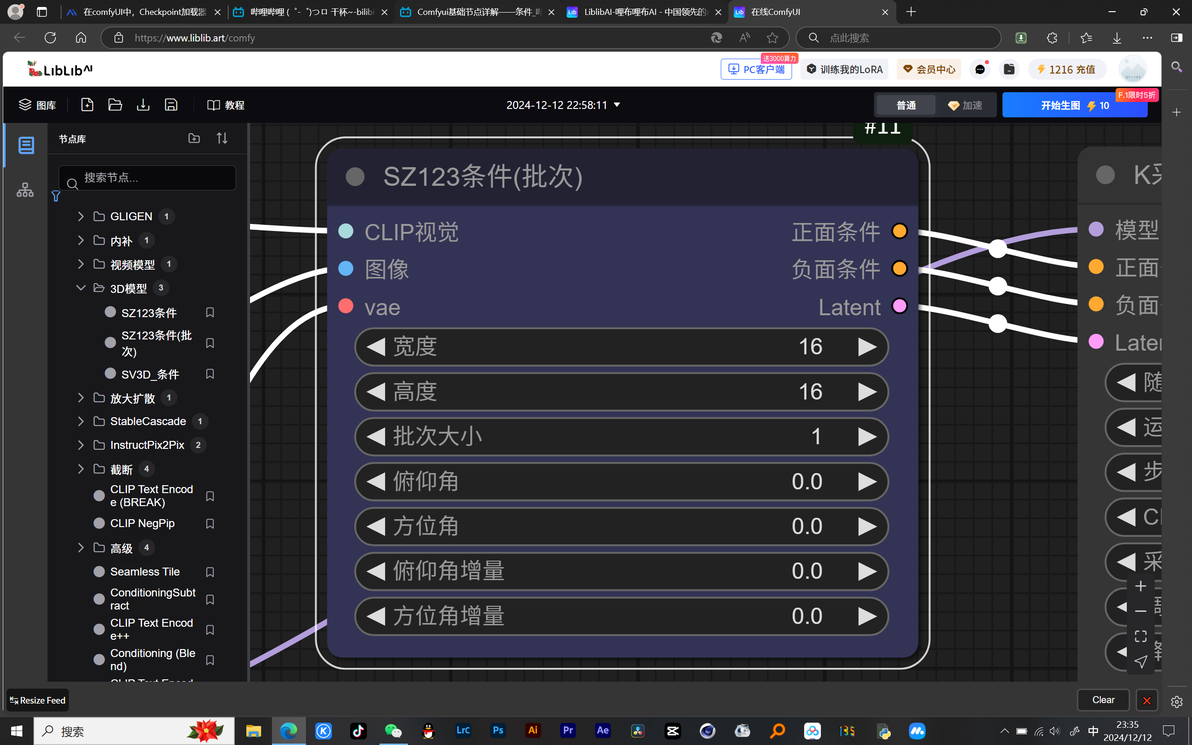
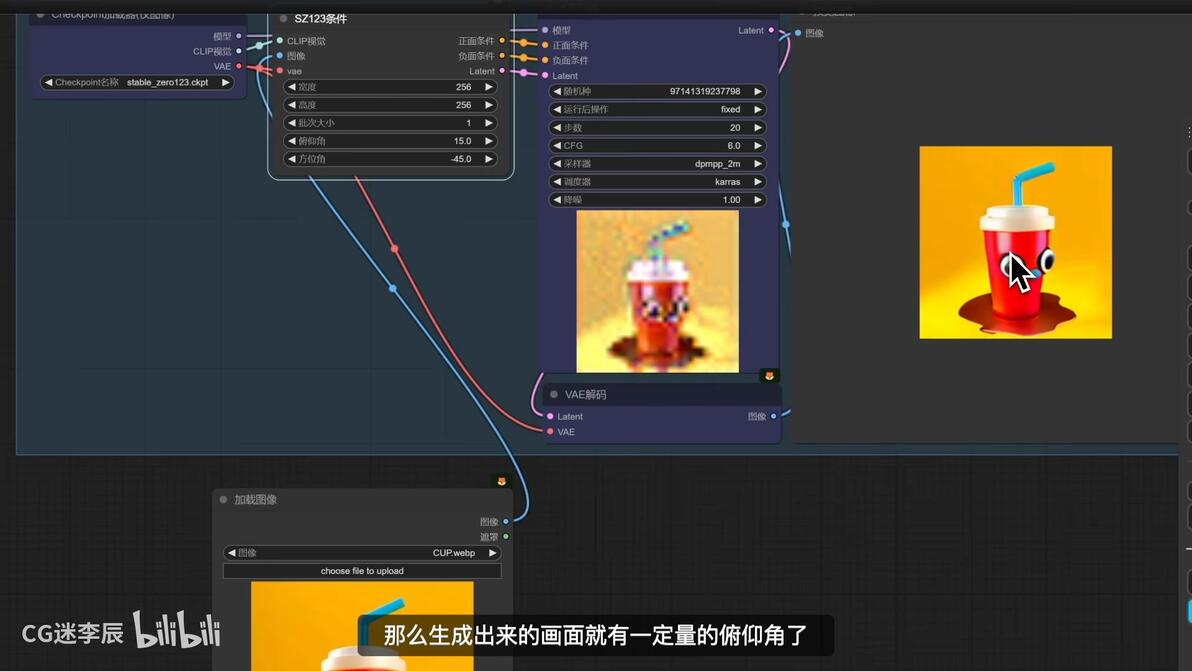
SZ123条件节点可以指定俯仰角和方位角来控制3D模型渲染的角度,俯仰角是垂直方向上的旋转,方位角是水平方向上的旋转。此外,SZ123条件节点还支持批量处理,允许用户按照一定的数值进行角度递增,从而实现批量生成不同角度的图像。
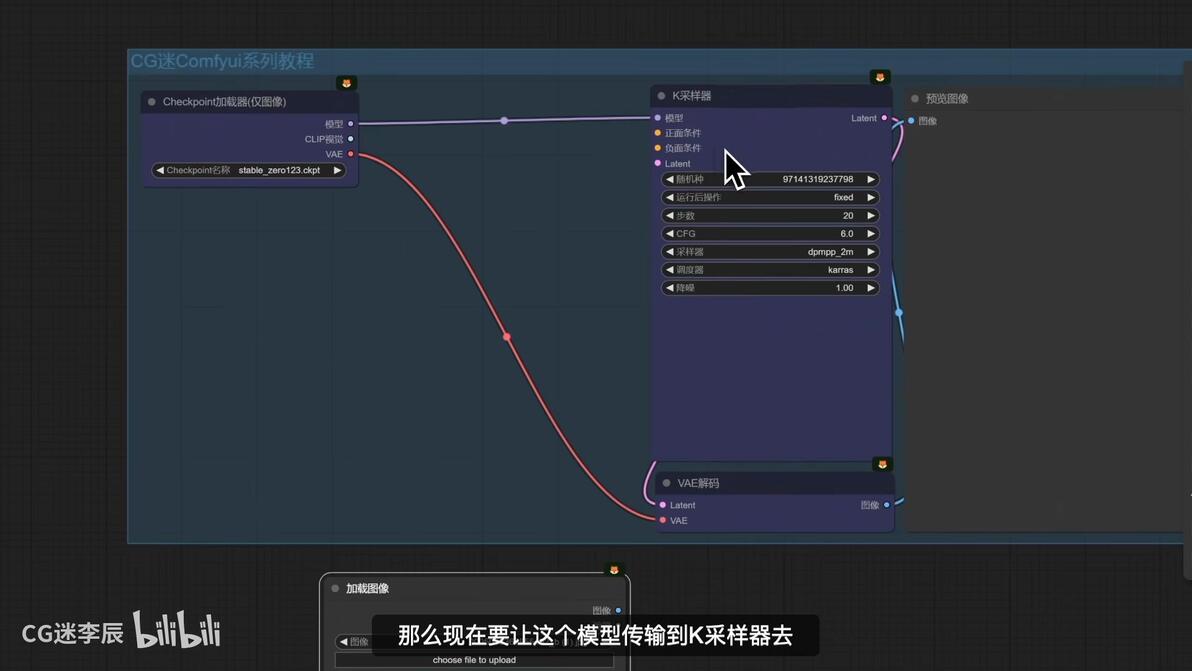
根据原理,我们需要加载一个特定的模型作为底层数据(这里使用的大模型,其实Lora也可以实现类似的效果),通过一系列条件作为限制,传输到k采样器中,最后生成对应的图片。
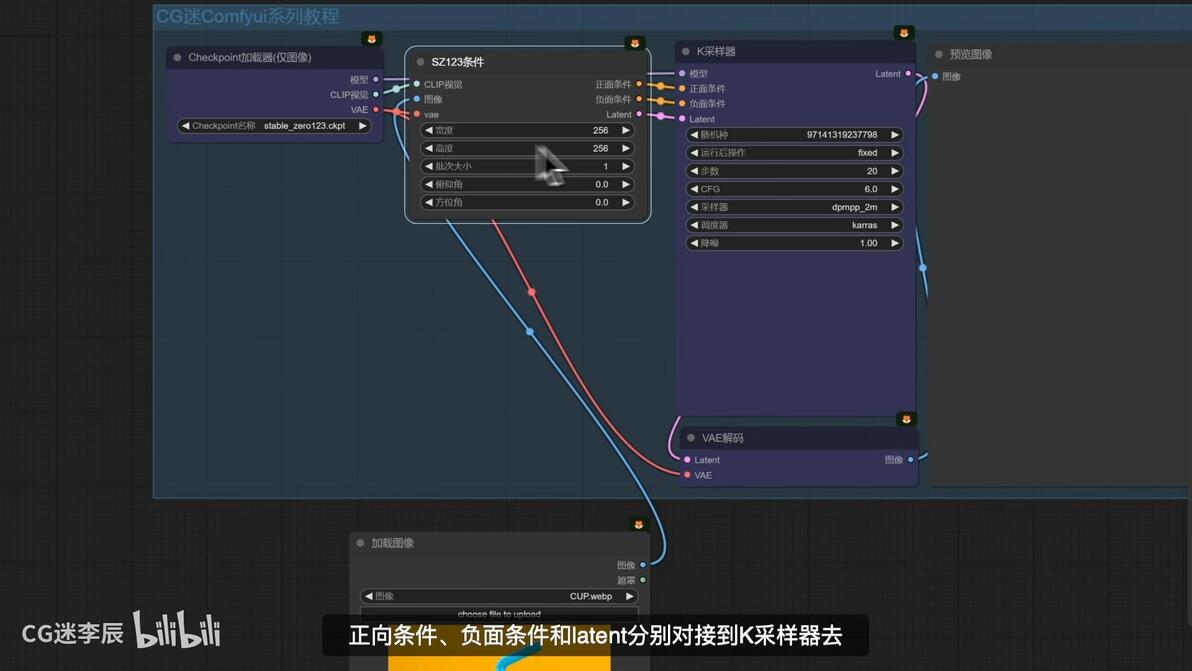
首先在大模型中加载一个Stable-zero 123模型出来
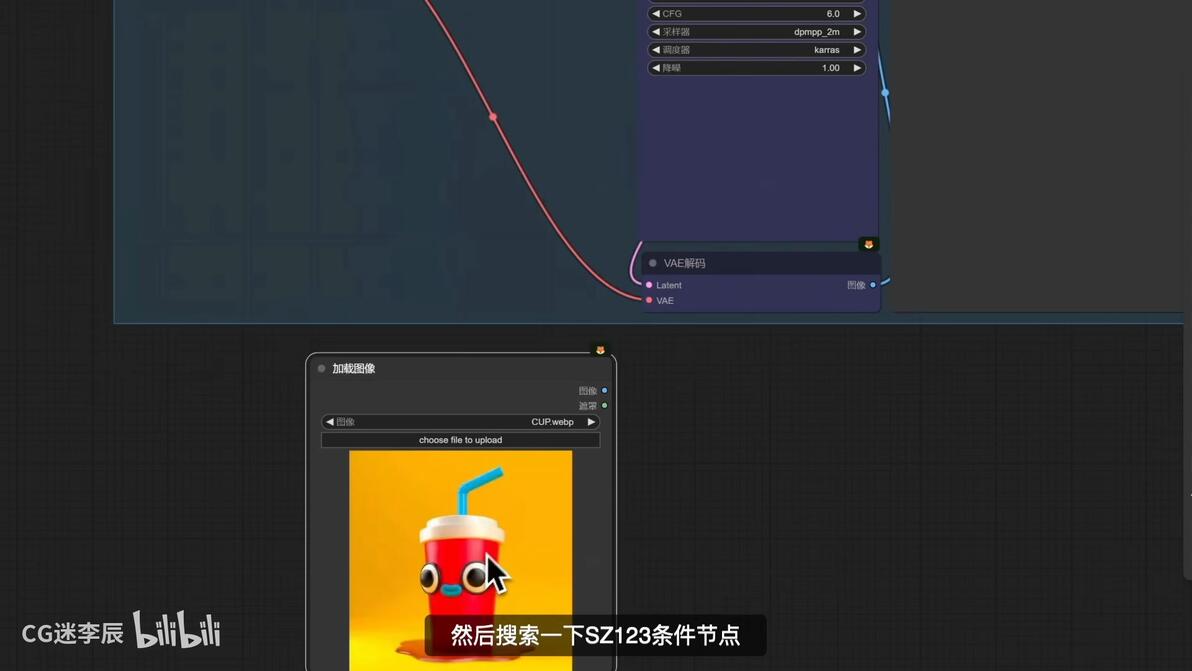
然后加载一张图片(最好是背景比较单调的图片)
然后将Checkpoint加载器(仅图像)与SZ123条件节点相连接,其余依次相连接。(因为SZ123条件与(批次)条件节点连接方式是类似的,所以这里不展开讲了)
Checkpoint加载器(简易) :适用于需要频繁切换不同AI艺术生成模型的用户,特别是在需要快速调整生成风格或质量时。
Checkpoint加载器(仅图像) :更适合专注于视频生成或图像处理的用户,特别是在需要高效处理图像到视频转换等任务时。
俯仰角:垂直方向的视觉调整(上正,下负)
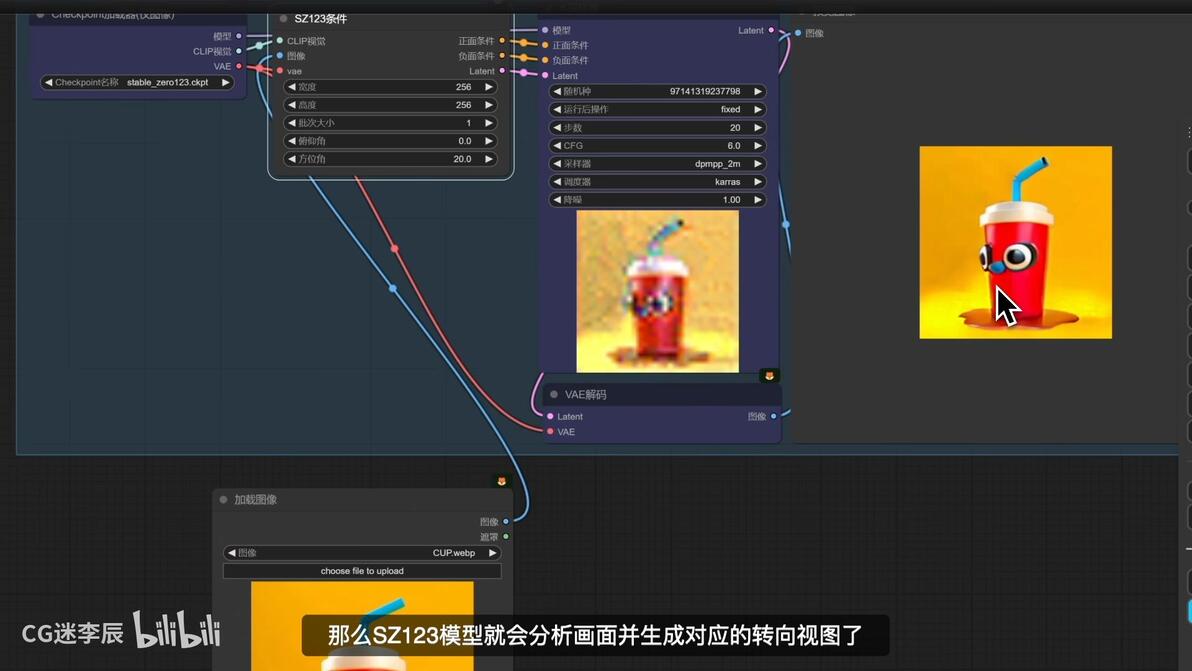
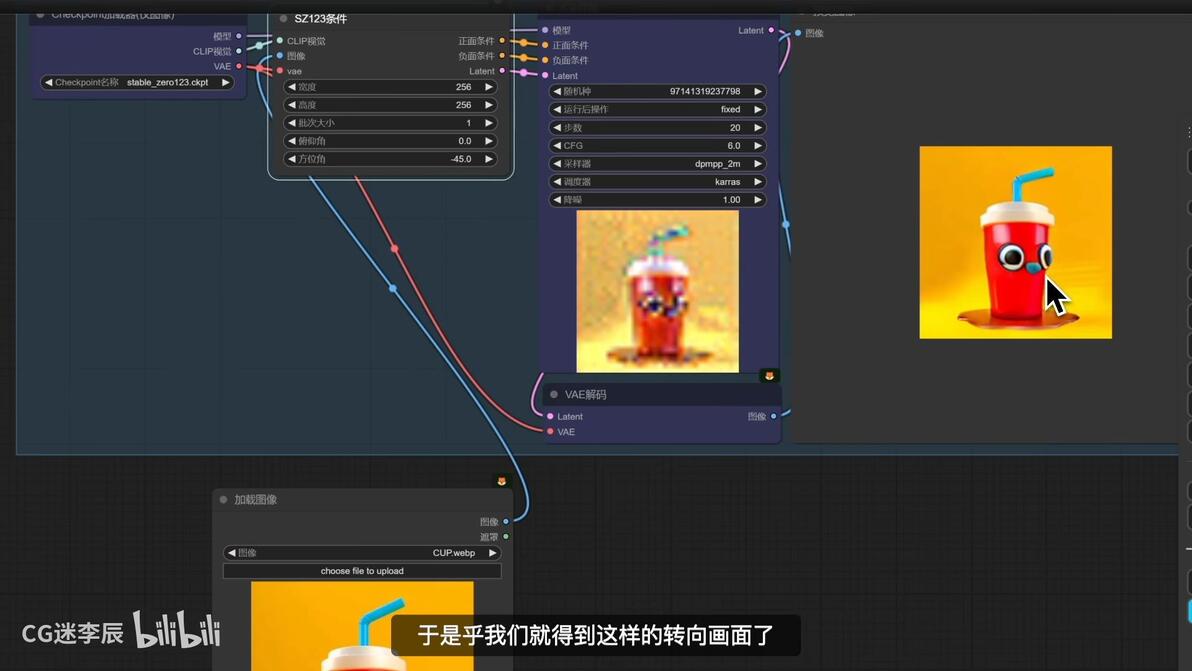
方位角:水平方向的视觉调整(左正,右负)
方位角:20
方位角:-45
俯仰角:15
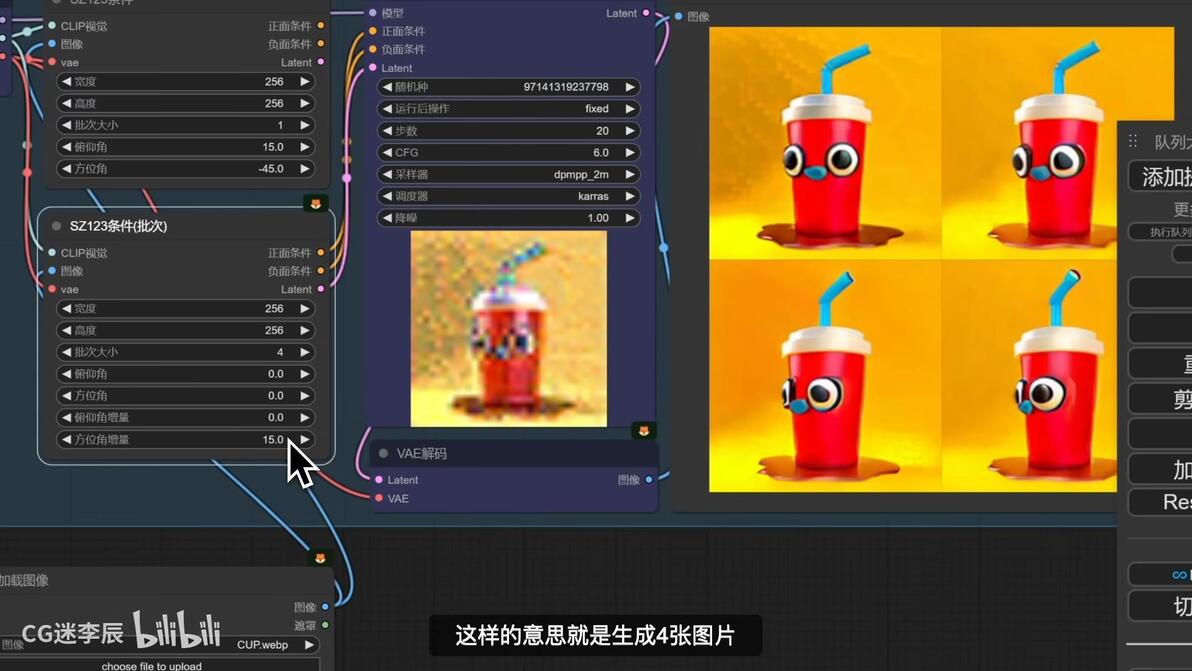
俯仰角增量:垂直方向增加角度
方位角增量:水平方向增加角度
这两个参数需要结合批次大小来进行使用。
eg:批次大小:4
方位角增量:15
这样的意思是生成4张图片,而每张图片的水平方向依次向左递减15度。
2、SV3D_条件
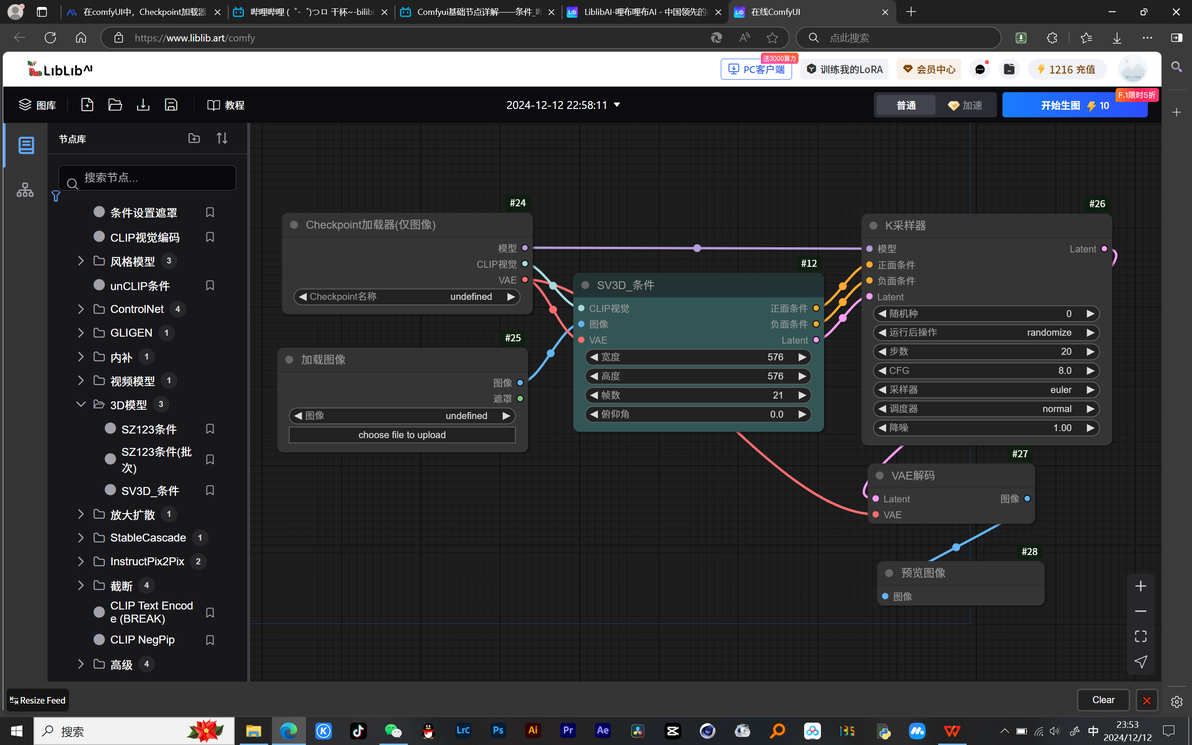
SV3D条件节点则基于Stable Video Diffusion模型,用于生成高质量的3D视频。SV3D模型能够从单个图像生成轨道视频,并且支持沿着指定的相机路径创建3D视频。

与前面SVD_图像到视频_条件节点类似,都是将图片转换为视频,节点连接方式都一样。不同的是,SV3D_条件节点可以控制画面的俯仰角度运动(控制镜头运动)
七、SD4V放大条件节点
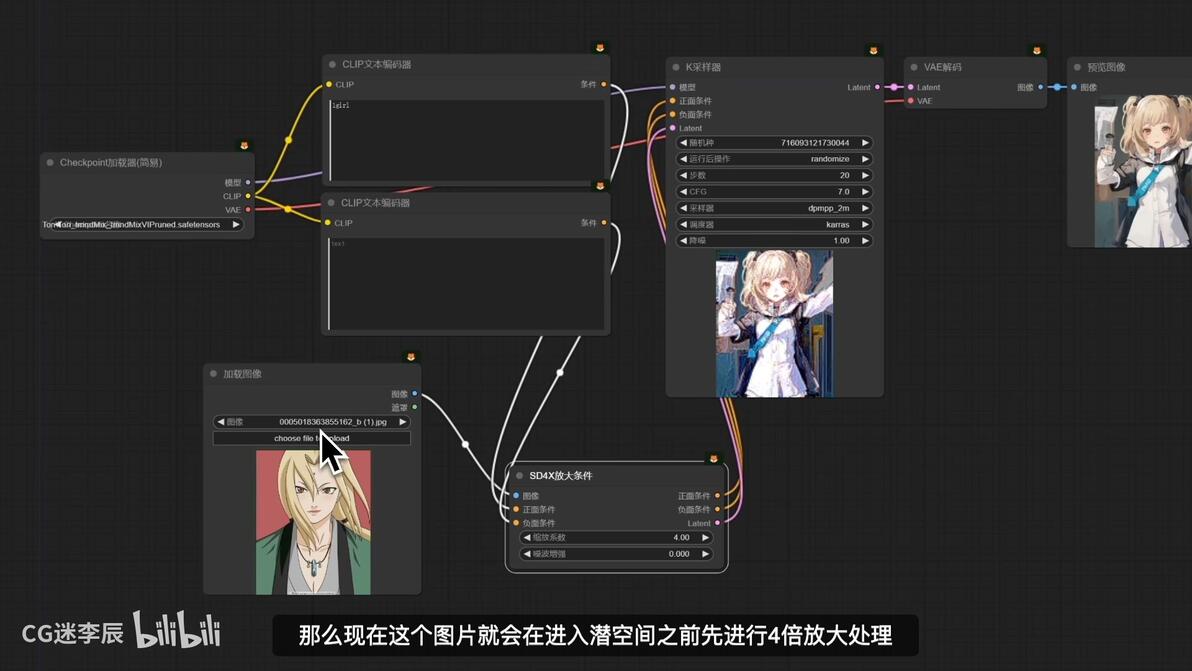
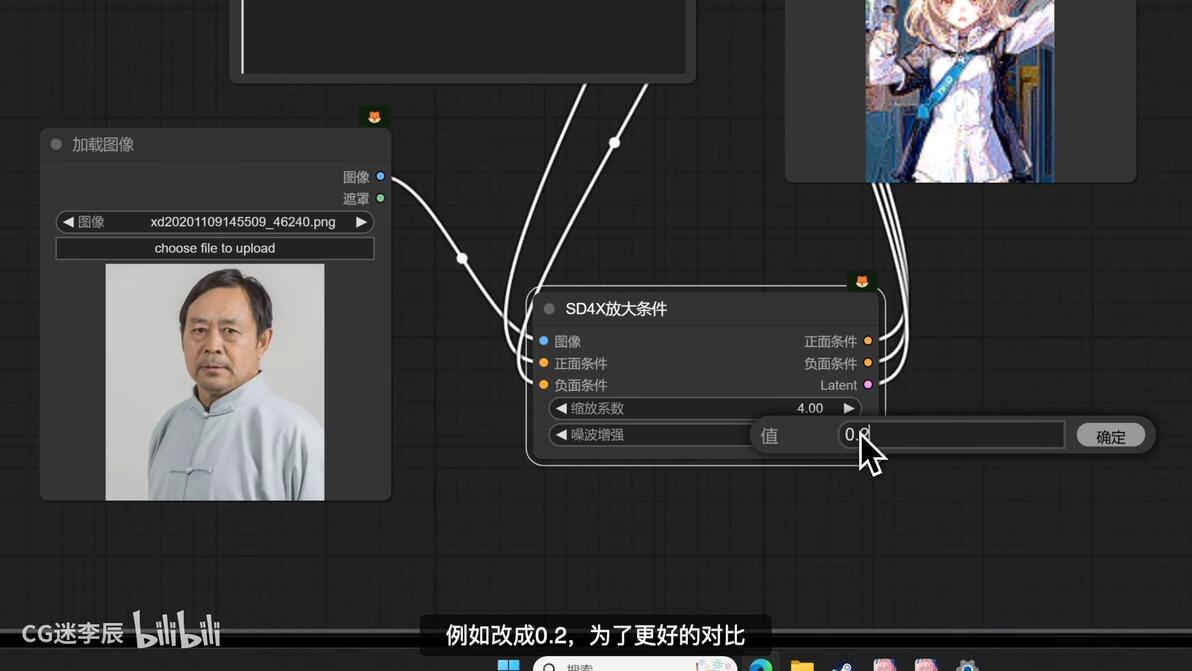
SD4X放大条件节点的作用是让图片进行4倍放大后再进入潜空间进行采样降噪处理。

eg:在标准的图生图工作流中添加SD4X放大条件节点。
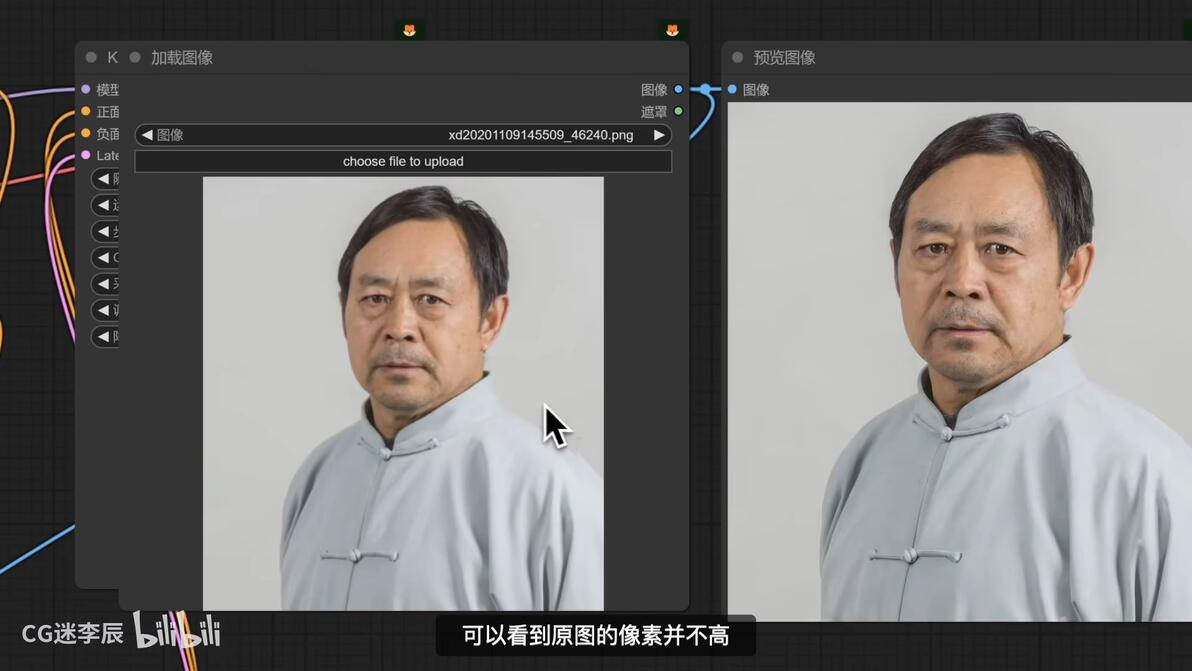
(这里的图片不适宜加载分辨率太大的图片进来,太大的图片容易爆显存)
选择专门用于放大的大模型

噪波:通常指的是在图像生成过程中引入的随机噪声。这种噪声是通过在潜空间内生成随机种子噪声图来实现的,然后逐步去噪以生成清晰的图像。噪波的引入使得模型能够生成多样化的图像,避免生成过程过于单一。
这里加点噪波,让AI能有更多细节上的创作。
生成后的对比图:
八、StableCascade条件节点
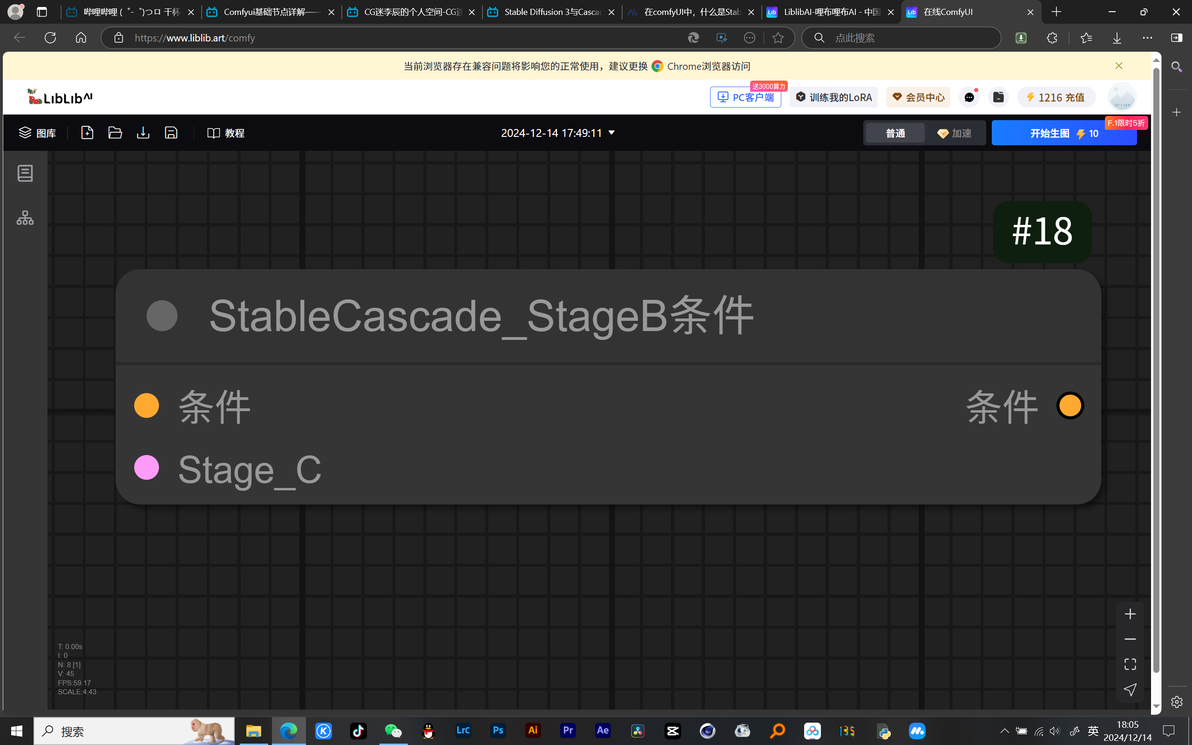
StableCascade条件节点是一个专门用于StableCascade模型的节点。这个节点的作用是处理和调整模型在不同阶段的参数,以优化图像生成过程。具体来说,StableCascade模型是一个三阶段的文本到图像生成流程,包括Stage A、Stage B和Stage C三个阶段。
在使用StableCascade时,需要通过特定的节点来连接和配置这些阶段。例如,StableCascade_StageB_Conditioning节点就是用于在Stage B阶段进行条件处理的节点,它允许用户对模型的输出进行微调和优化。这个节点通过与CLIP文本编码器的连接,可以对生成的图像进行进一步的细化和调整,从而提高最终图像的质量。
九、InstructPixtoPix条件节点
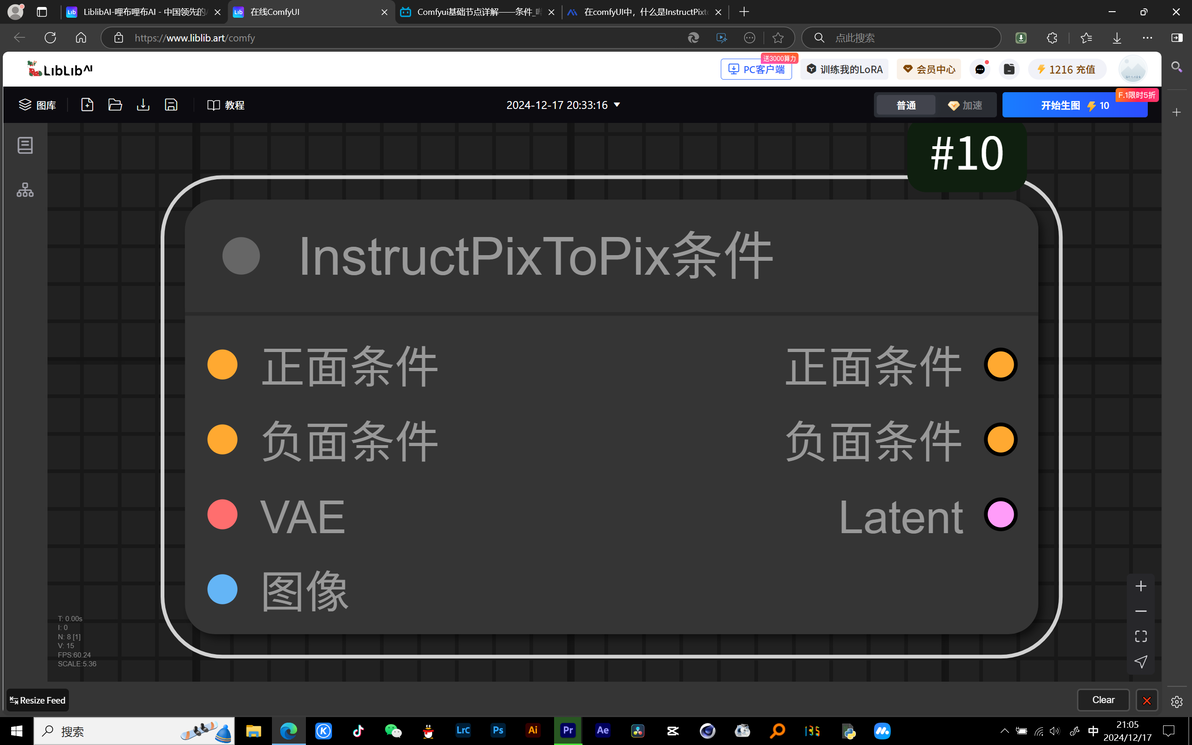
InstructPixToPix条件节点是一种用于指导模型生成特定风格或内容图像的条件节点。
具体来说,InstructPixToPix条件节点可能用于将输入的图像或文本提示转换为特定的图像输出,从而实现图像到图像的转换任务。
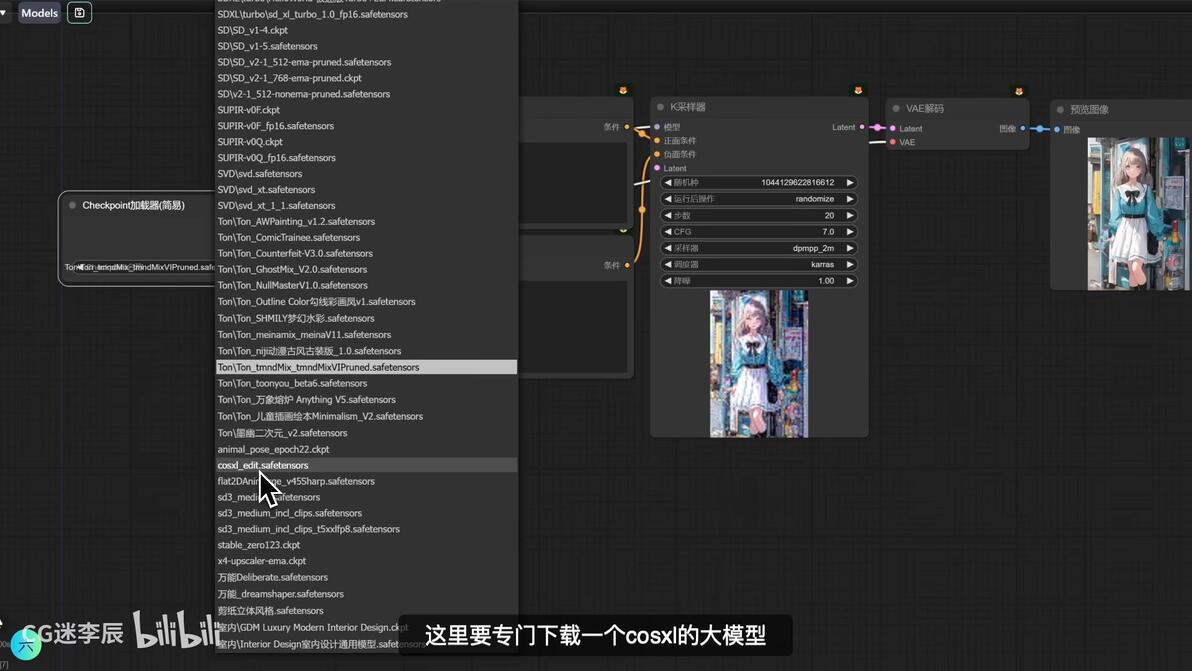
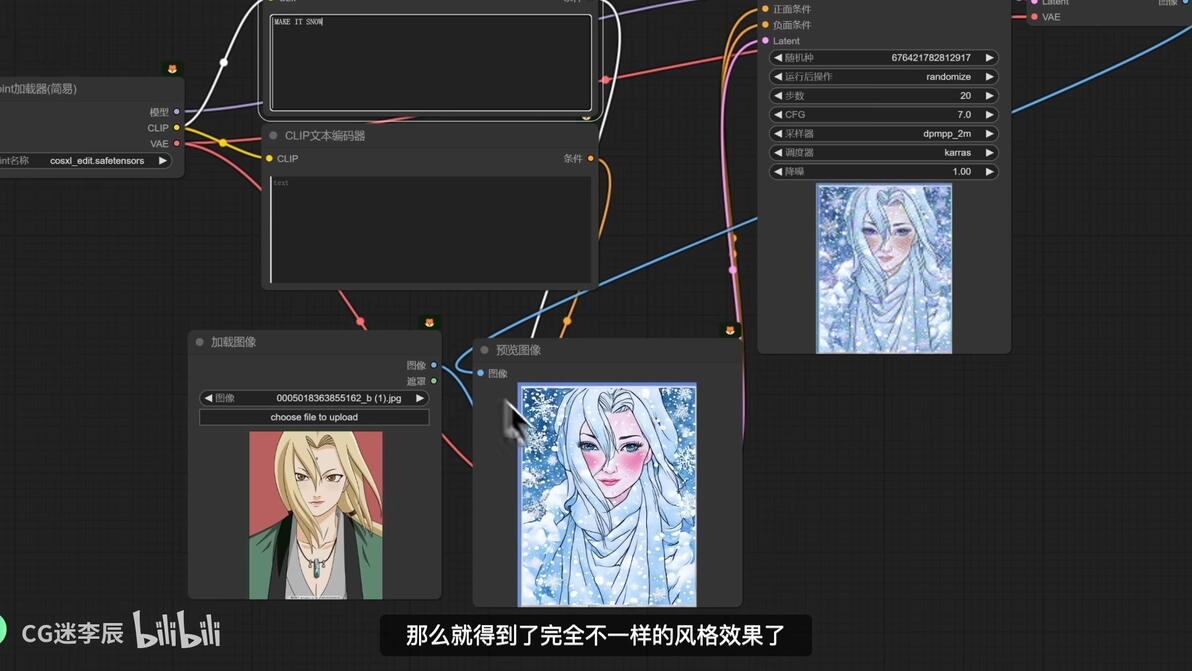
首先,加载cosxl的大模型(需要专门下载)
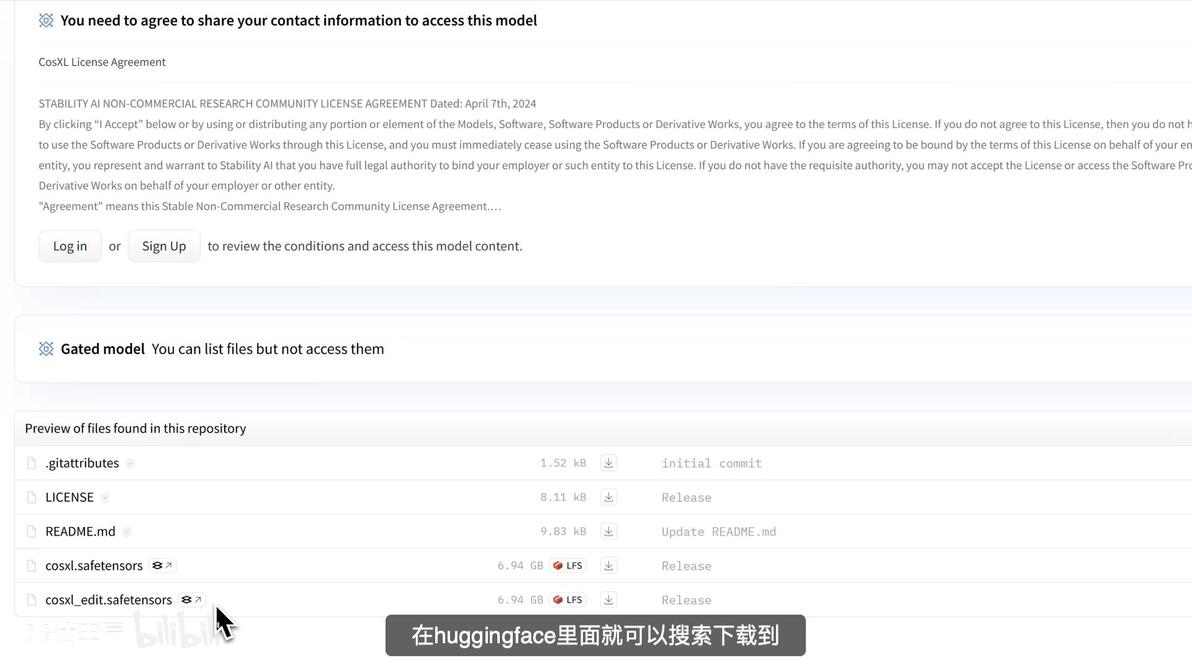
这个模型是stability官方研发的,在huggingface里面就可以搜索下载到。

添加InstructPixToPix条件节点,并连接工作流上。
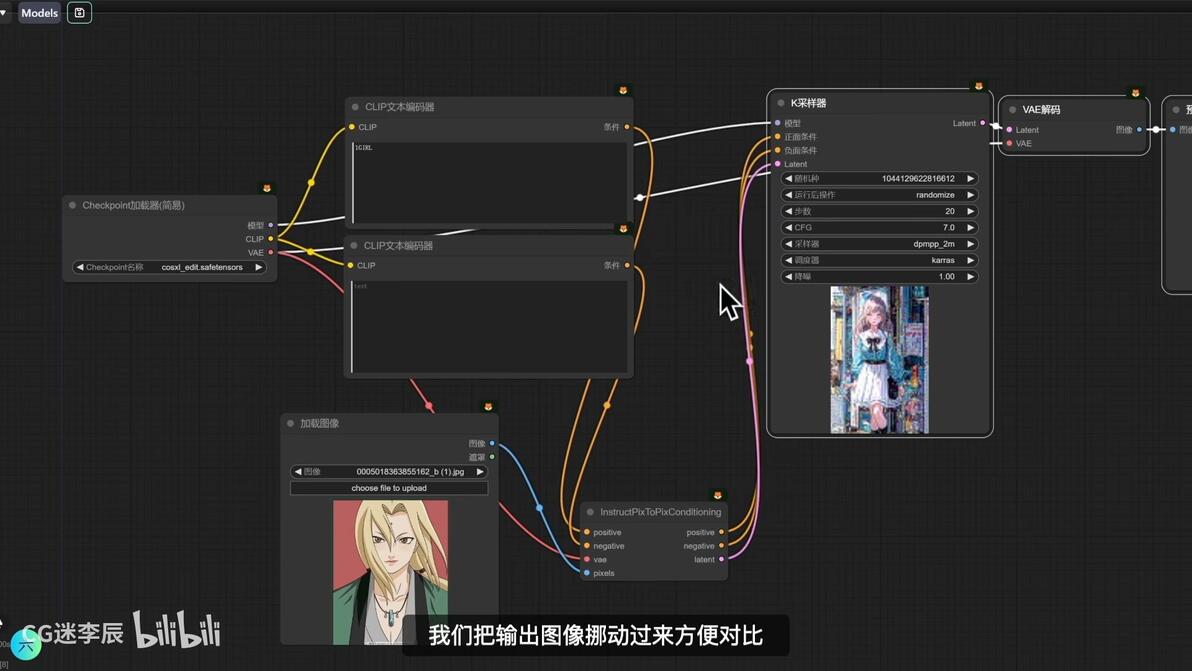
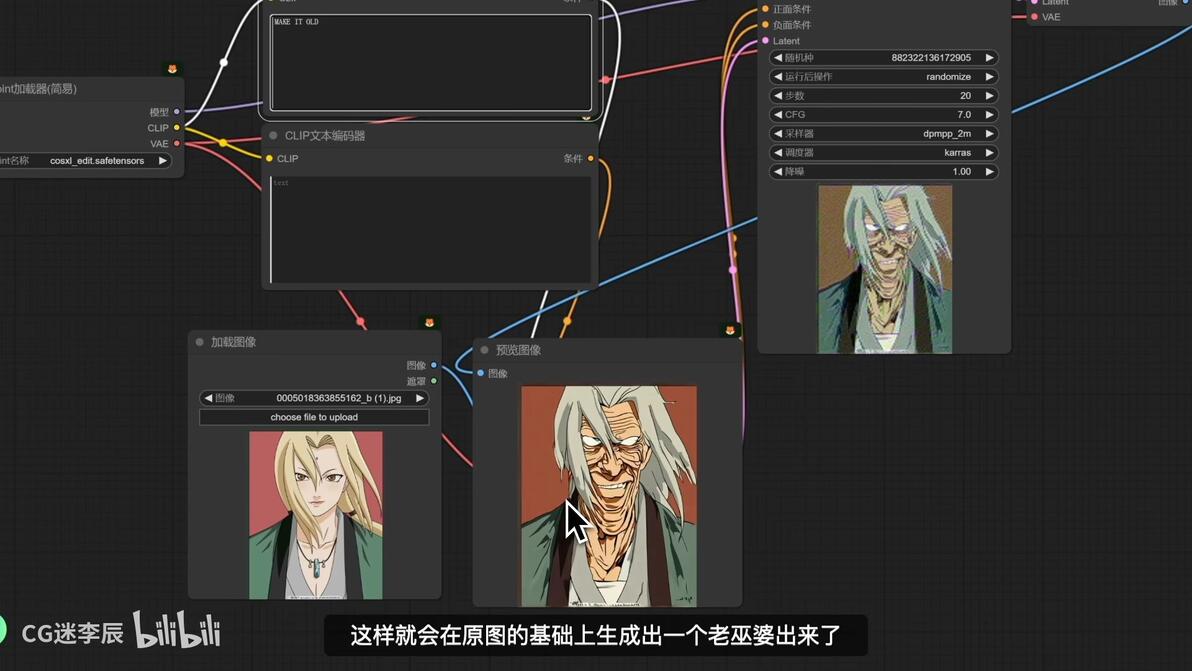
这个节点的作用就是通过提示词在我们上传图片的基础上赋予一系列新的样式风格。
(类似于对图片进行风格重绘,但不同的是这个会根据提示词对原图进行变化的)
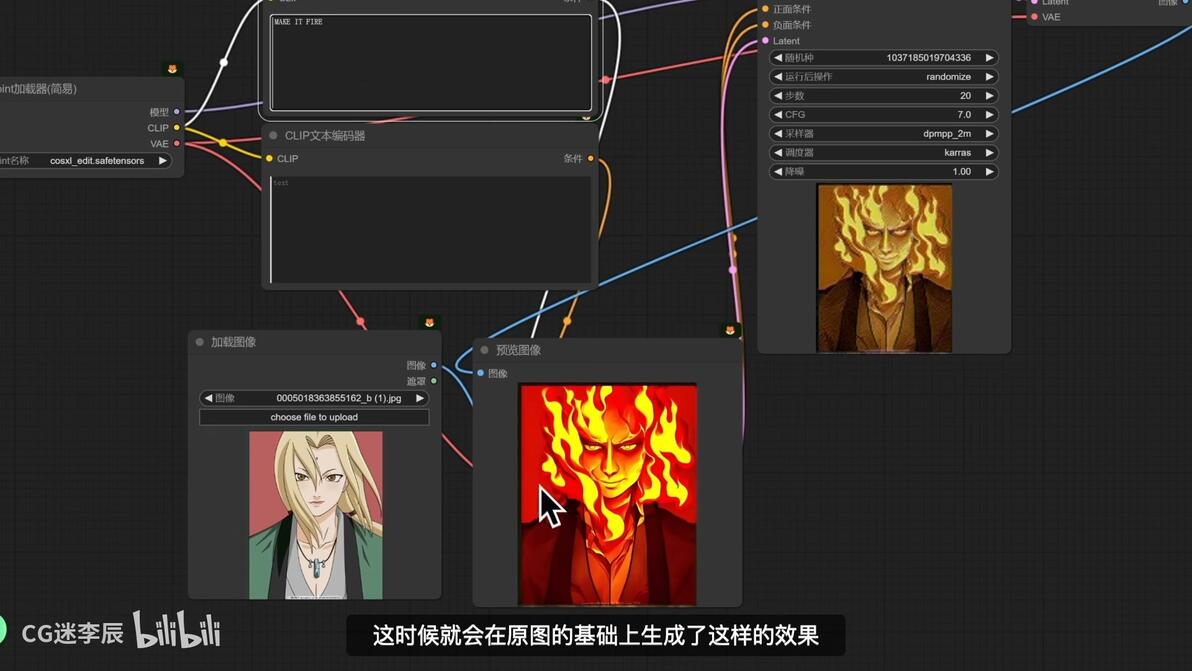
输入提示词:make it fire让它着火
最终生成的图片就是这样的。
(对图片进行风格重绘,提示词作为条件)
make it snow雪
make it old老的
十、CLIP文本编码器节点
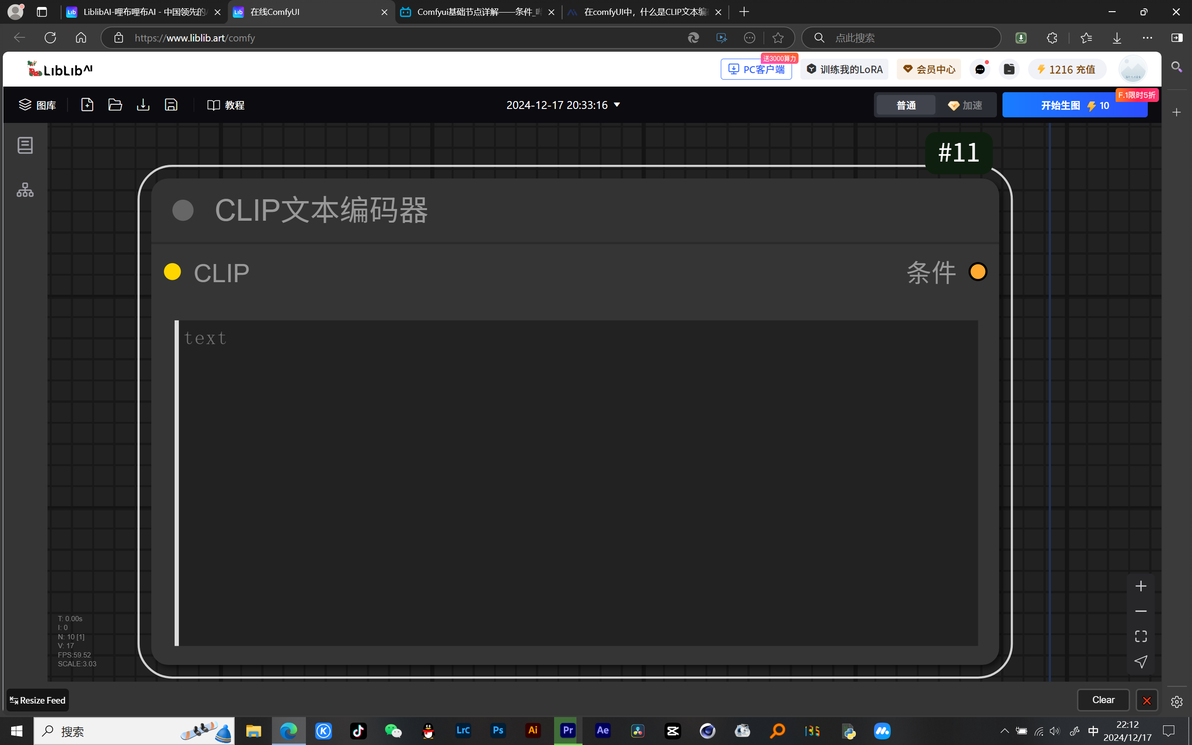
CLIP文本编码器节点(CLIP Text Encode Node)是一个用于处理文本输入的工具节点。它基于OpenAI开发的CLIP(Contrastive Language–Image Pretraining)模型,能够将自然语言转换为潜在空间中的特征向量,这些向量与图像的特征表示在同一个空间中,可以用于图像生成、匹配或分类等任务。
CLIP文本编码器节点的主要功能是通过输入的文本提示词对文本进行编码,生成一个嵌入向量,以引导扩散模型生成符合文本条件的图像。该节点的输入类型包括字符串类型的文本参数和CLIP模型,其中文本参数是编码过程的关键信息源,而CLIP模型则负责将文本转换为条件向量,影响输出质量和相关性。
十一、CLIP设置停止层节点
CLIP设置停止层节点(CLIP Set Last Layer Node)是一个用于调整CLIP模型行为的节点。该节点通过将特定层设置为最后执行层,允许用户自定义CLIP模型的处理深度,从而可能影响模型的输出。
具体来说,CLIP模型是一个神经网络,它将文本提示转换为数值表示,并通过多层处理来生成图像。传统的扩散模型通常会使用CLIP的最后一层输出作为条件设定,但有时在较早的层上进行条件设定可能会更有效。因此,CLIP设置停止层节点允许用户选择从哪个层获取文本嵌入,从而优化生成图像的效果。

CLIP停止层用于大模型CLIP端口连接CLIP文本编码器之间的

真人画面:-1
动漫画面:-2

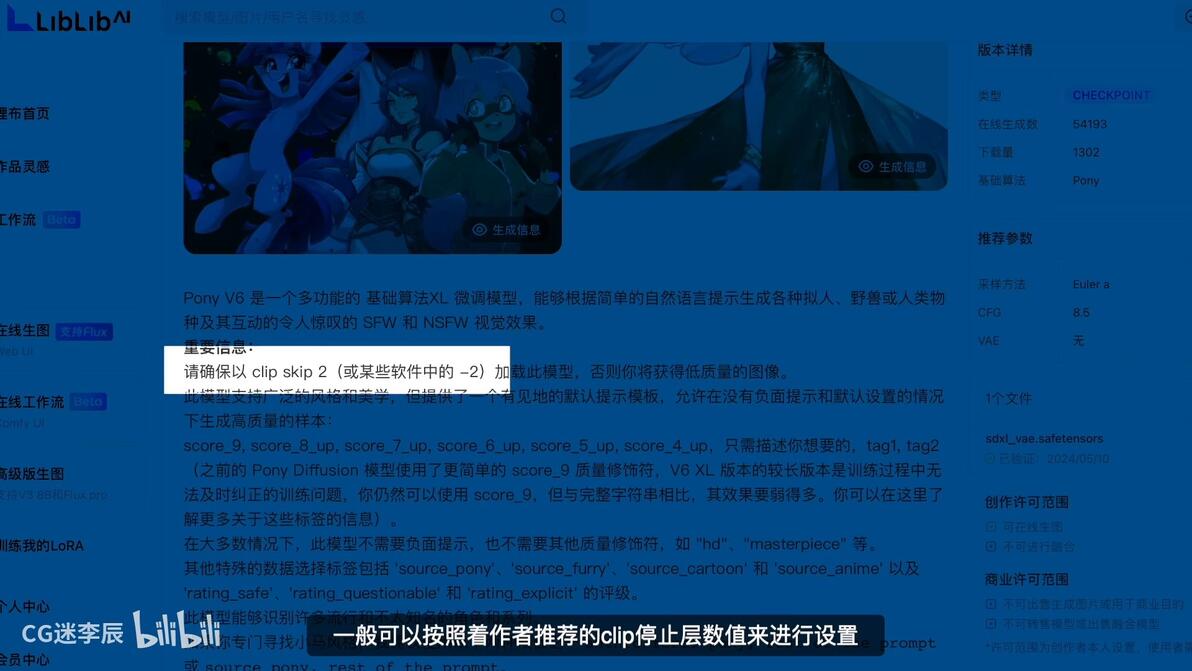
在下载大模型的时候,可以看看大模型的介绍说明,一般可以按照作者推荐的CLIP停止层数值来进行设置。
十二、CLIP多条件联结节点(Concat联结,Combine合并,Average平均)
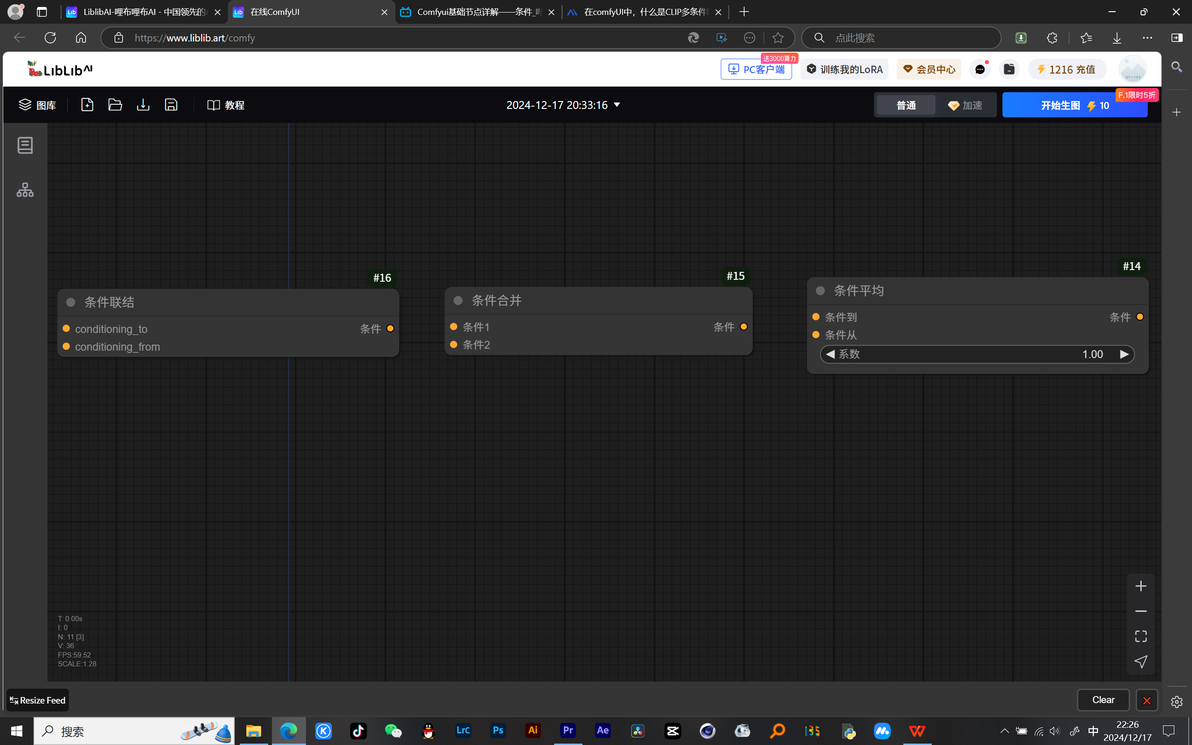
1、Concat(条件联结)节点:
功能:将两个条件向量连接成一个统一的条件向量集。此节点适用于需要将来自不同源的条件信息整合为单一表示的场景。
应用场景:例如,将人物与背景、上衣与裤子等不同部分的条件信息进行串联,以实现图像效果的改变。

eg:一个穿着白色体恤的女孩。
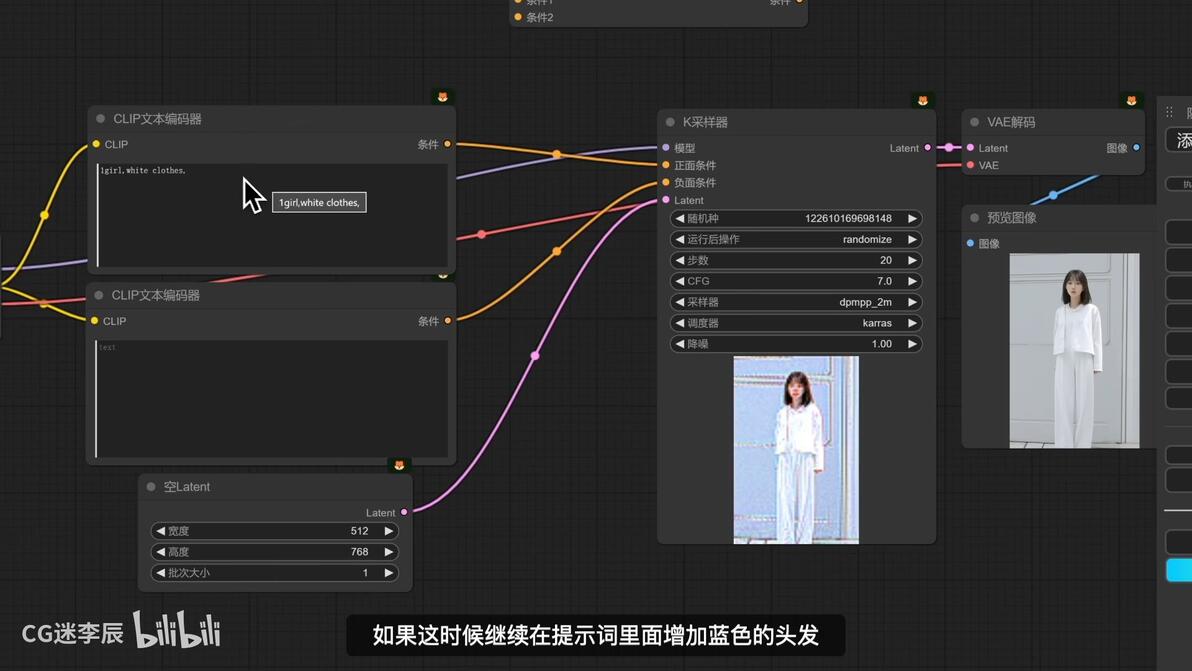
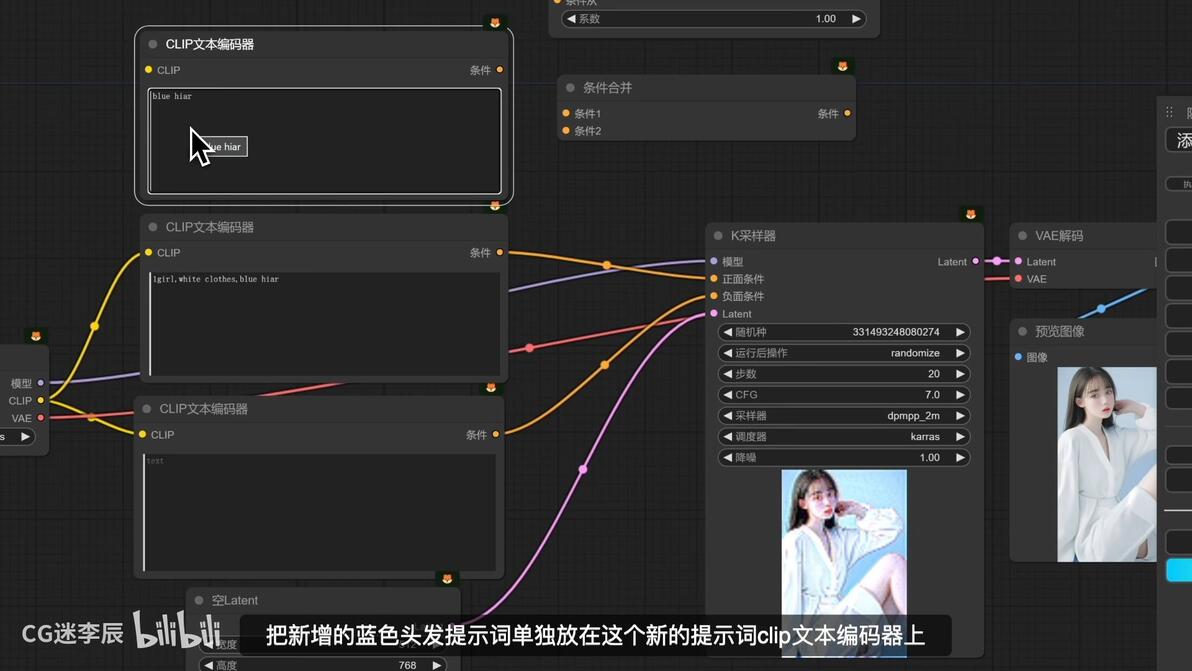
增加蓝色头发的提示词,但由于提示词的增加,就会遇到提示词不听话的情况。(这里呢就没有生成蓝色头发)
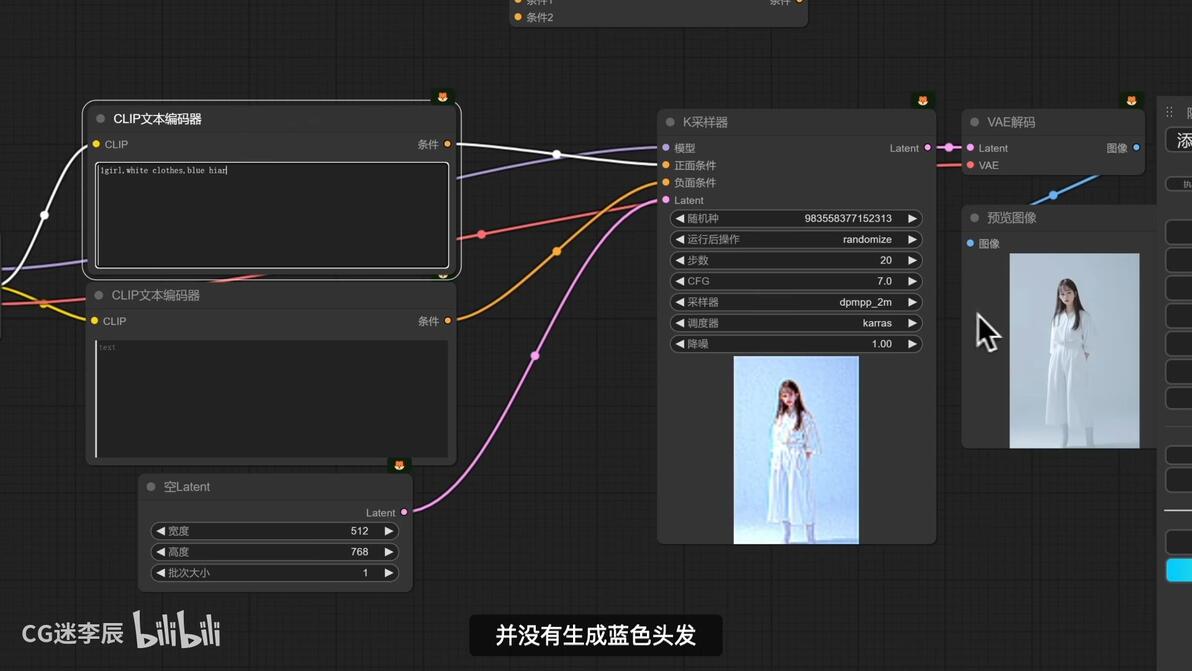
又或者出现提示词之间相互污染的情况,导致生成出来的画面并不符合要求。
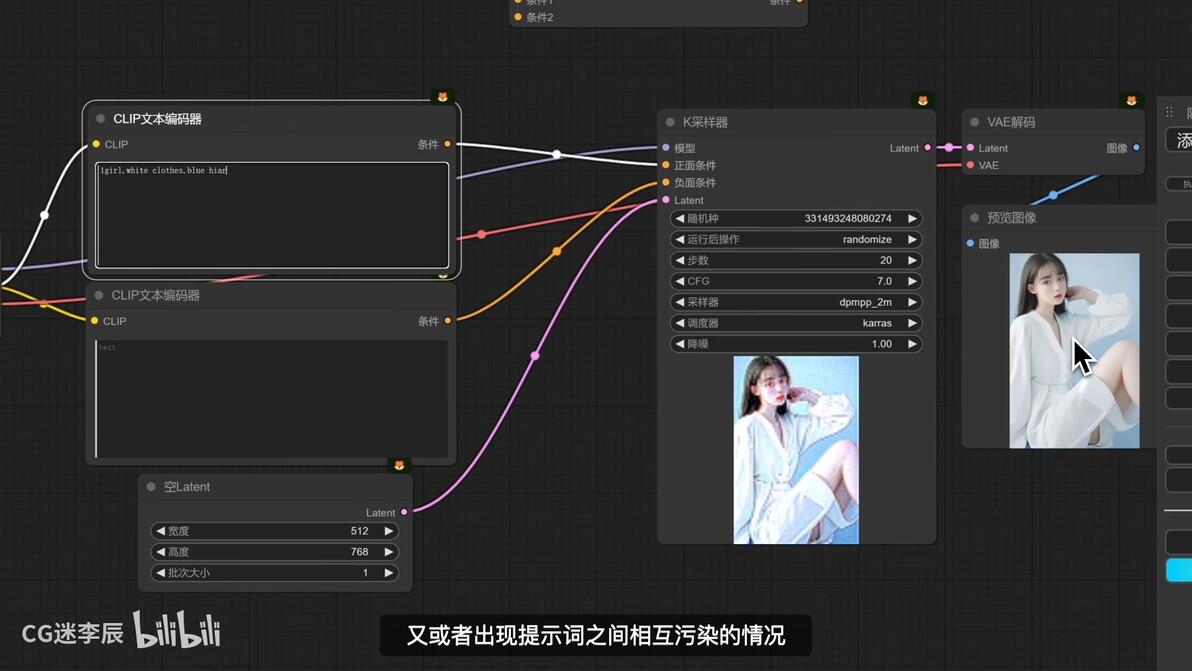
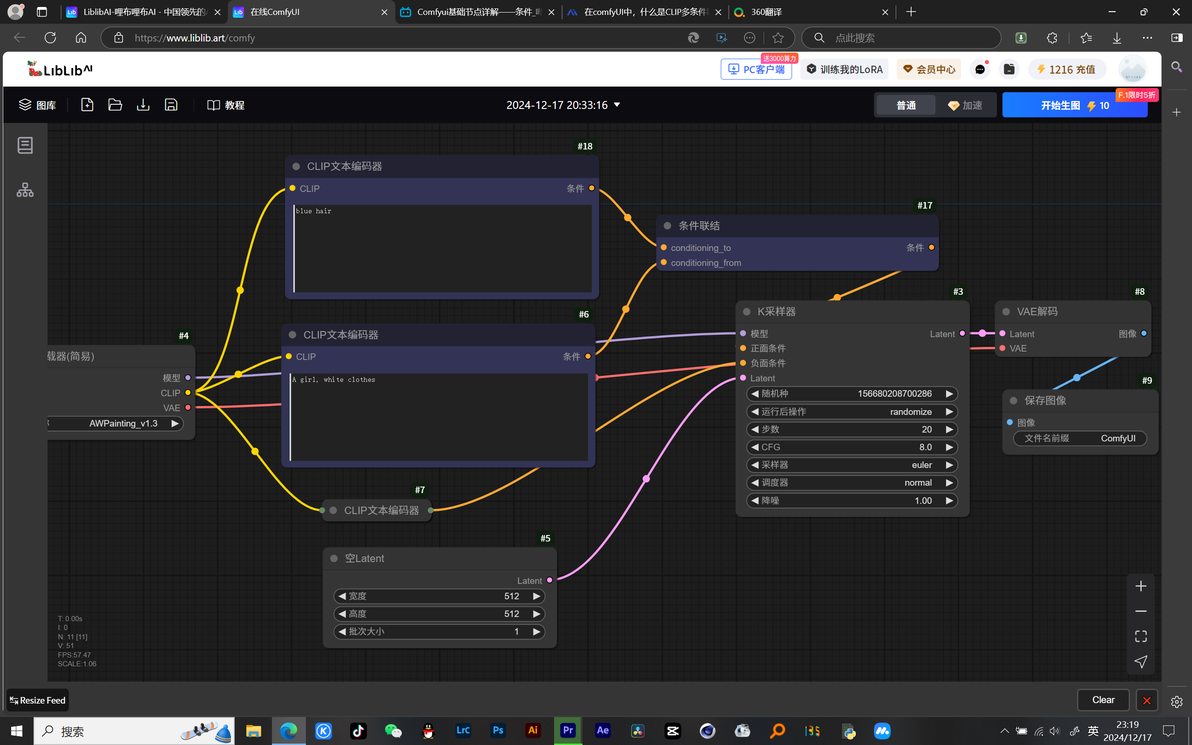
所以这时候我们可以把正向提示词复制一份,把新增的蓝色头发提示词单独放在这个新的提示词CLIP文本编码器上。
eg:两个正向提示词连接到条件联结上,输出联结到k采样器上。这样就可以让这两个提示词联合在一起同时生效了。
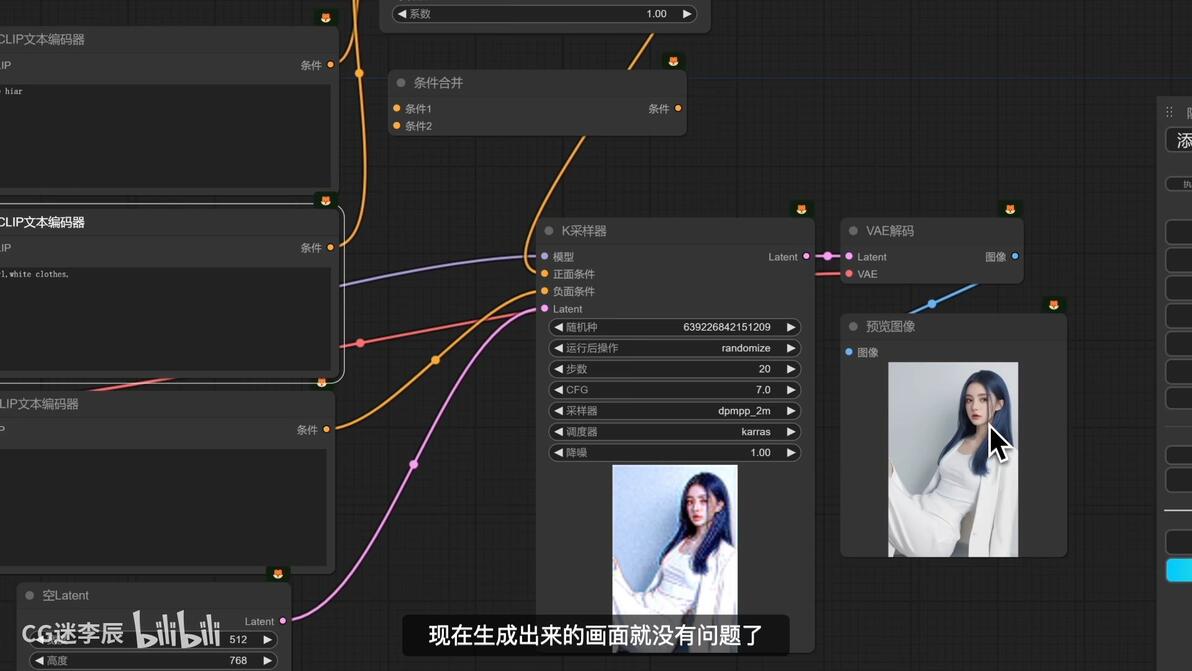
现在生成出来的画面就没有问题了。
2、Average(条件平均)节点:
功能:通过比例控制每个部分的权重,实现更精细的风格控制。此节点适用于在主体图片不变的情况下调整局部风格,如同一女孩从悲伤到开心的不同比例。
应用场景:在多个条件输入需要整合时特别有用,如将多条文本提示或其他控制信号组合起来,生成具有混合特征的图像。
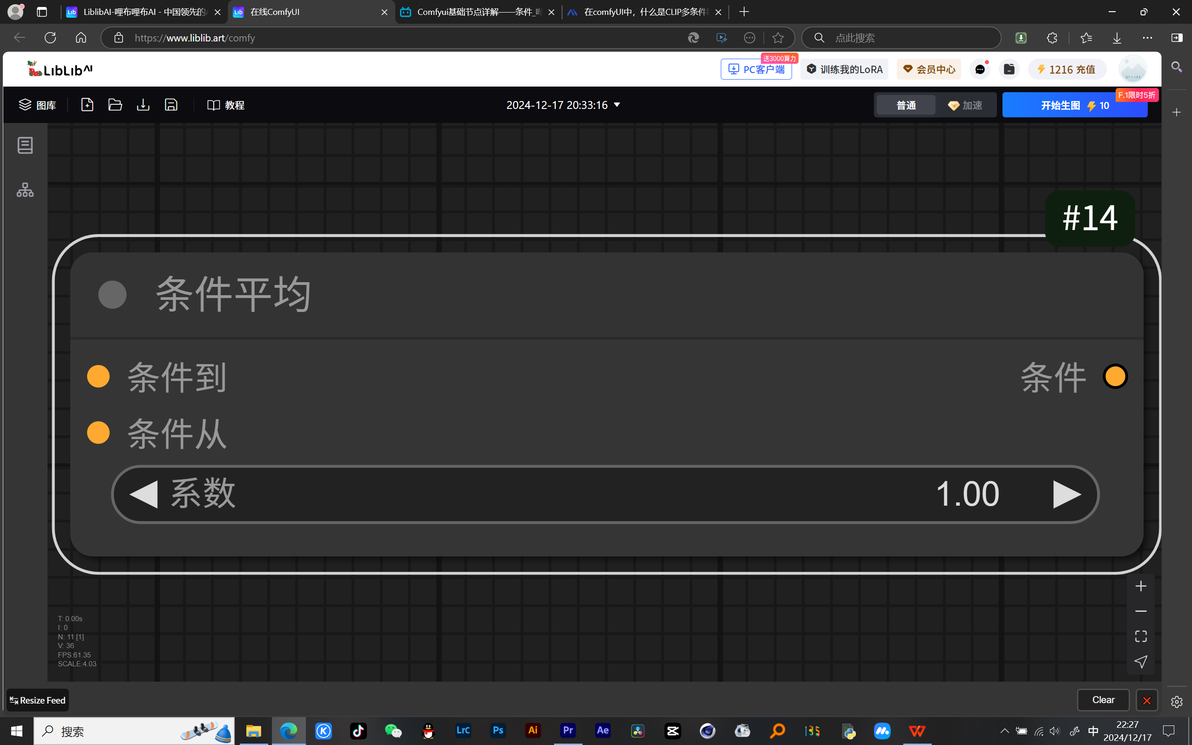
eg:两个正向提示词,一个写着穿着白色T恤的女孩,另一个写着蓝色头发。与条件联结同样的连接方式连接工作流。(具体请看条件联结那里)
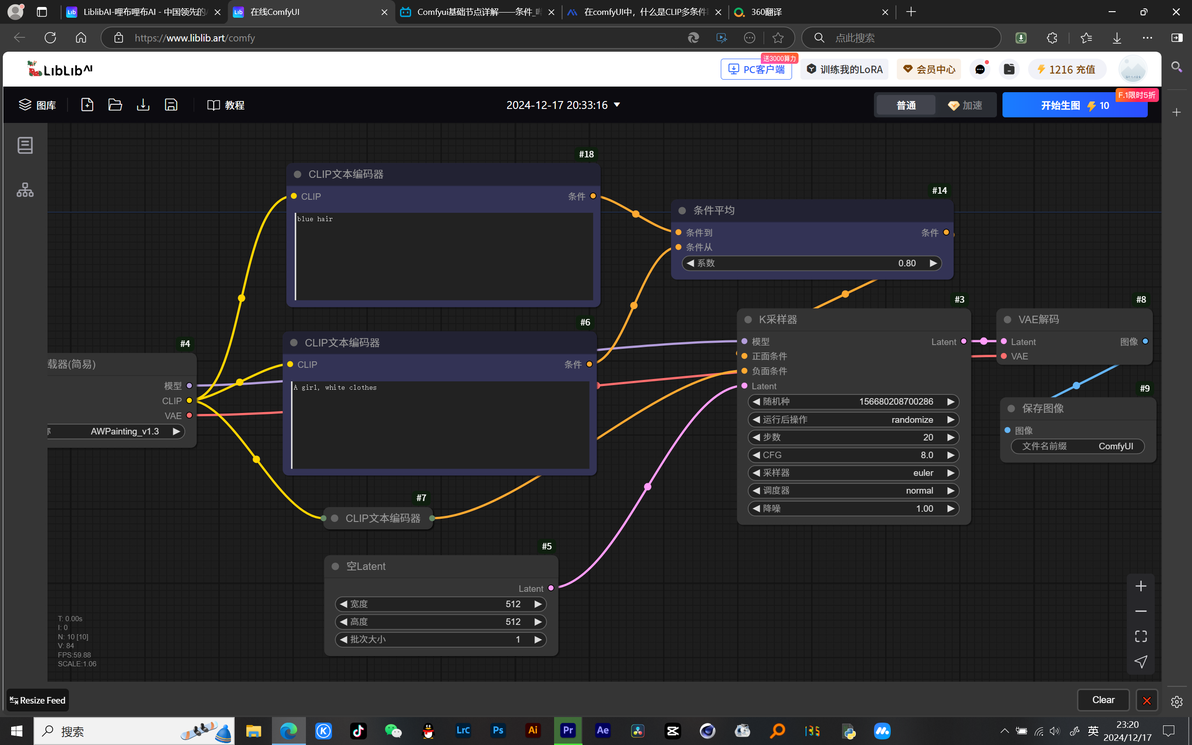
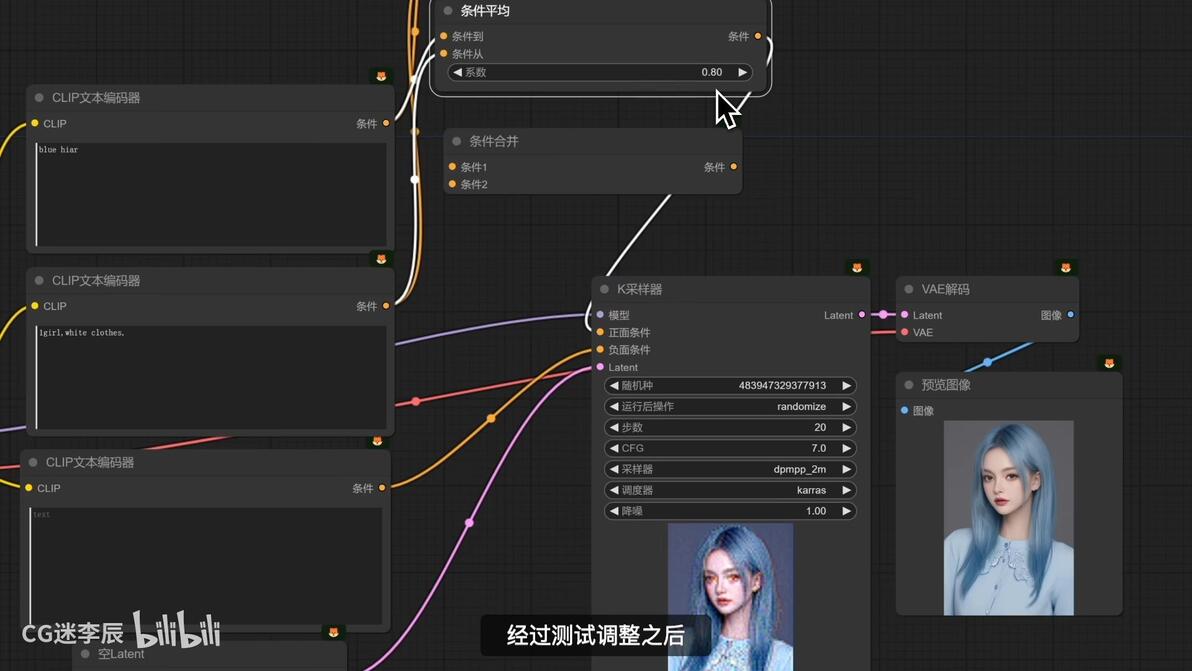
现在我们可以通过这个参数来调整合并之后,哪个提示词会起到更多的作用了。
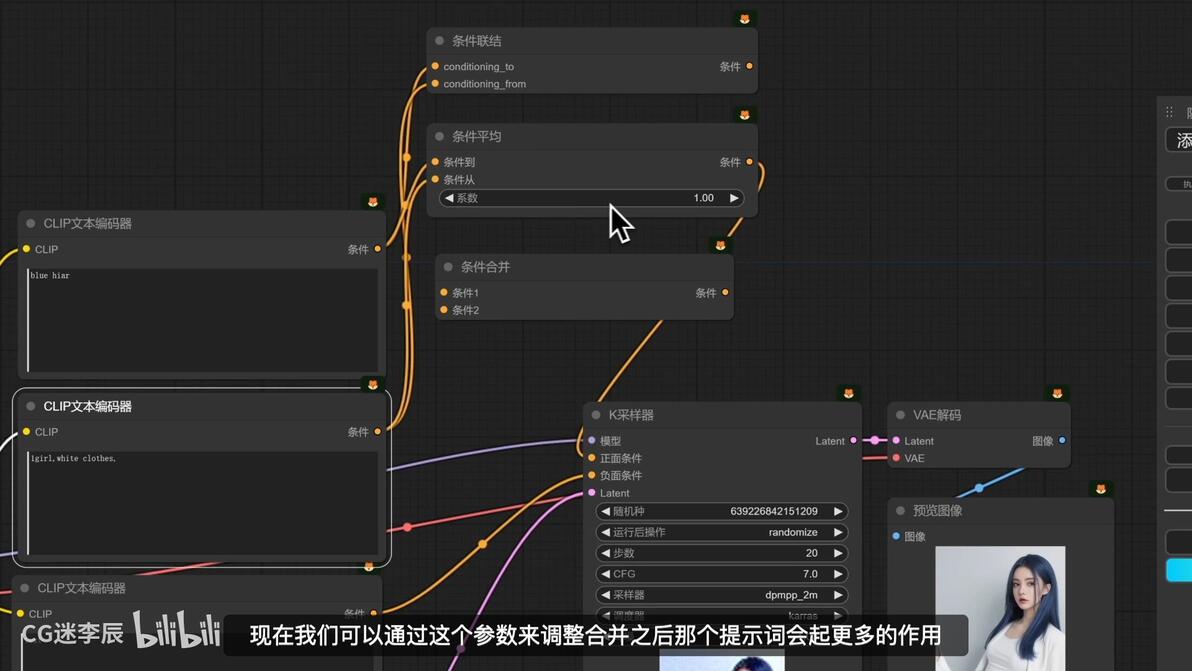
条件到——连接的是上面的正向提示词(蓝色的头发)
条件从——连接的是下面的正向提示词(一个穿着白T恤的女孩)
例如默认值是1,意味着上面这个提示词起到100%的作用。
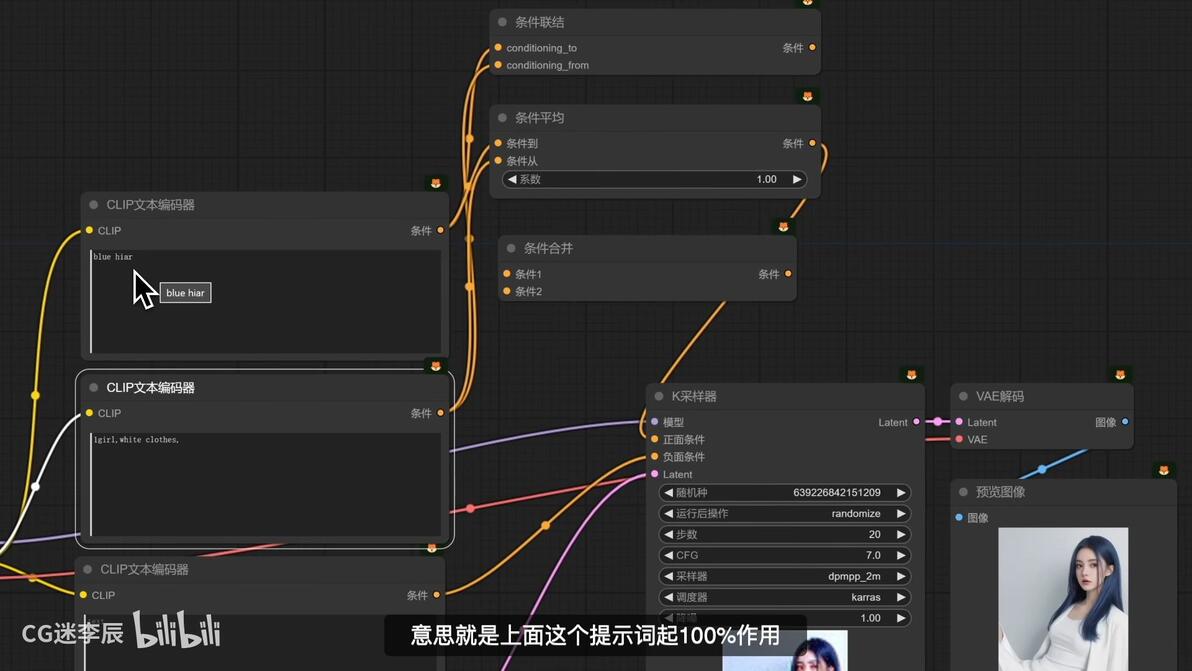
点击生成,那么现在就只会生成蓝色头发的女生了,而白色T恤的提示词就不管用了。
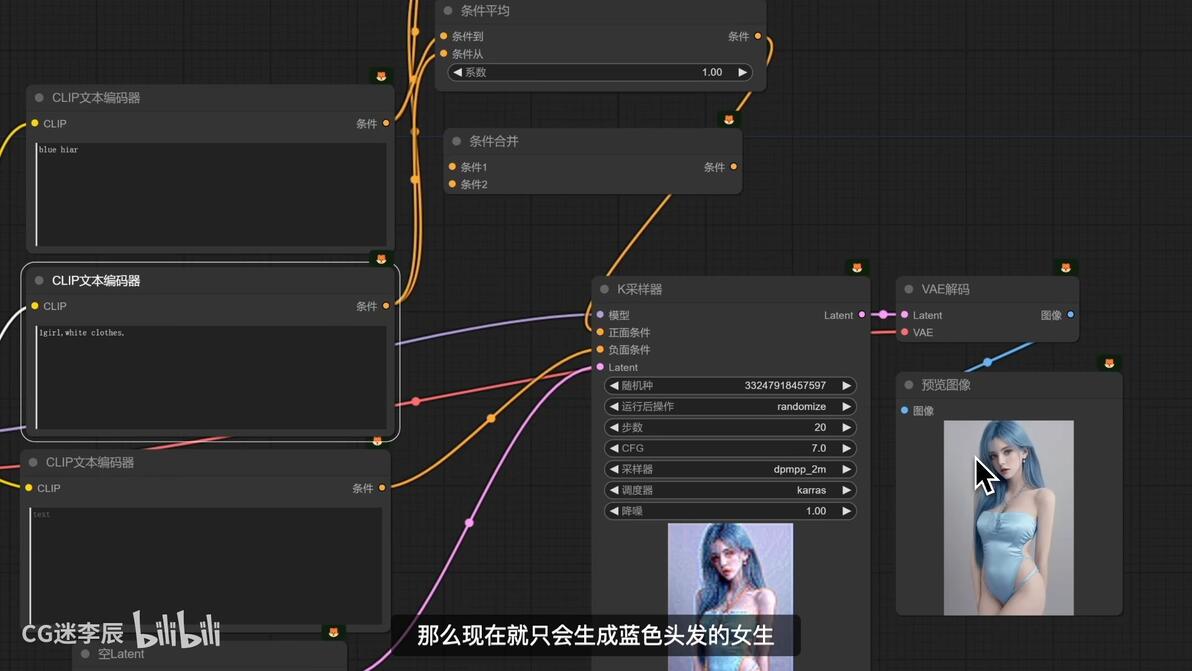
条件到——连接的是上面的正向提示词(蓝色的头发)
条件从——连接的是下面的正向提示词(一个穿着白T恤的女孩)
如果条件平均的参数改为0,意味着下面白色T恤的提示词起100%的作用。
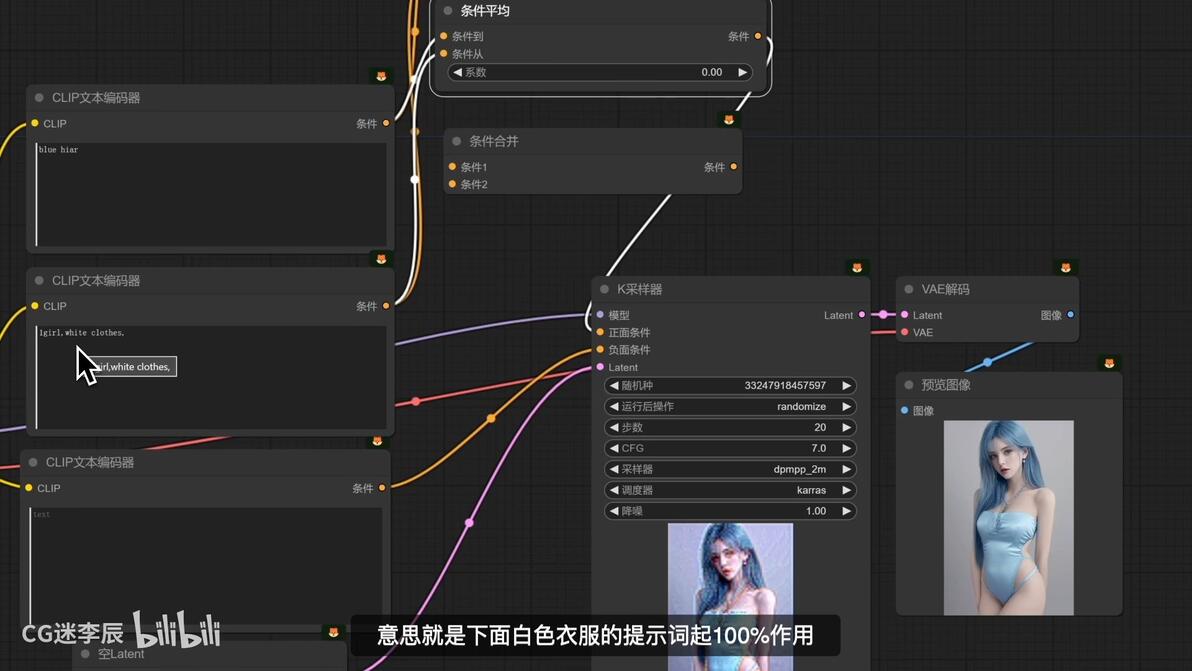
所以蓝色头发就没有效果了。
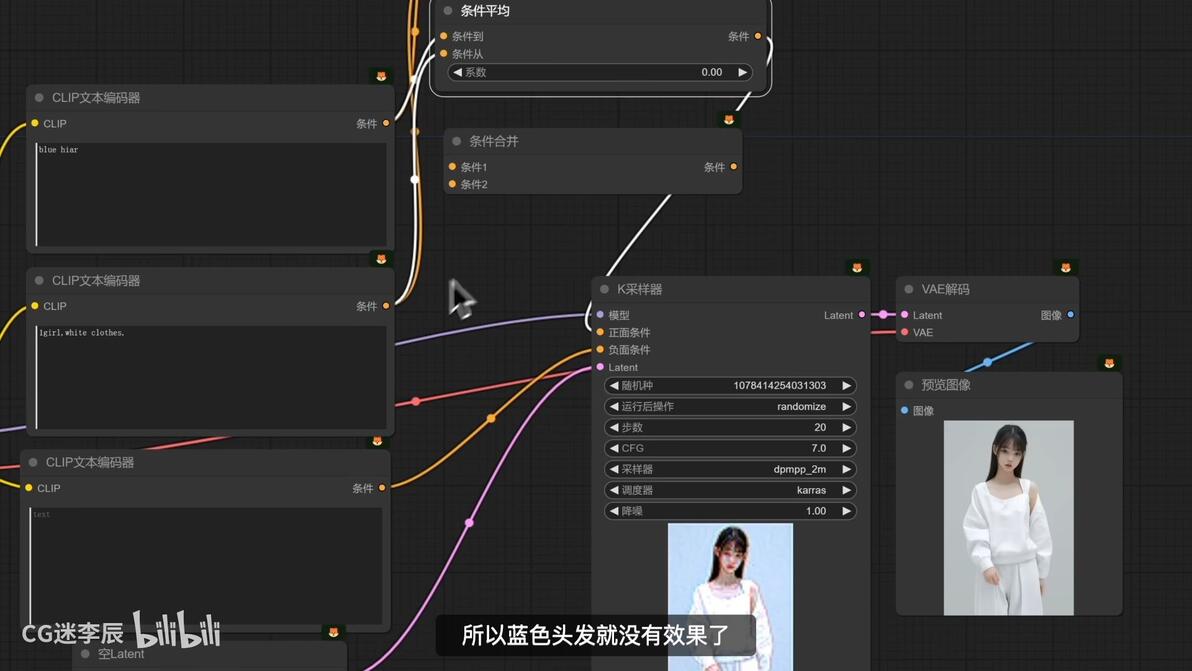
所以,我们可以通过调整这个数值的大小,来平衡画面的效果。
3、Combine(条件合并)节点:
功能:通过混合两个条件信息流,生成一个综合了两者特征的新条件信息流。此节点适合于融合提示中的不同风格特征,如红色外套与白色外套的混合,生成不男不女的人物形象。
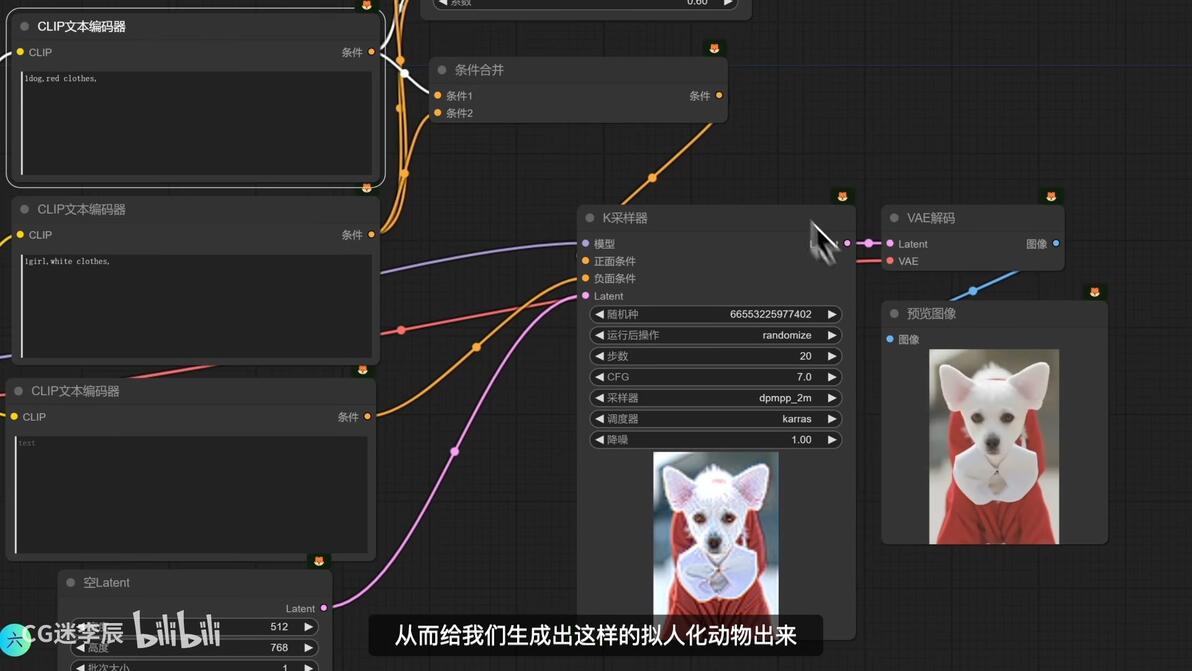
应用场景:当两个提示词框输入的提示词为同一角色的不同元素时,如“一个女孩”和“红色头发”,生成的效果与条件联结类似;但如果提示词框为不同角色元素,则会生成拟人化动物。
eg:两个正向提示词,一个写着穿着白色T恤的女孩,另一个写着蓝色头发。与条件联结同样的连接方式连接工作流。(具体请看条件联结那里)
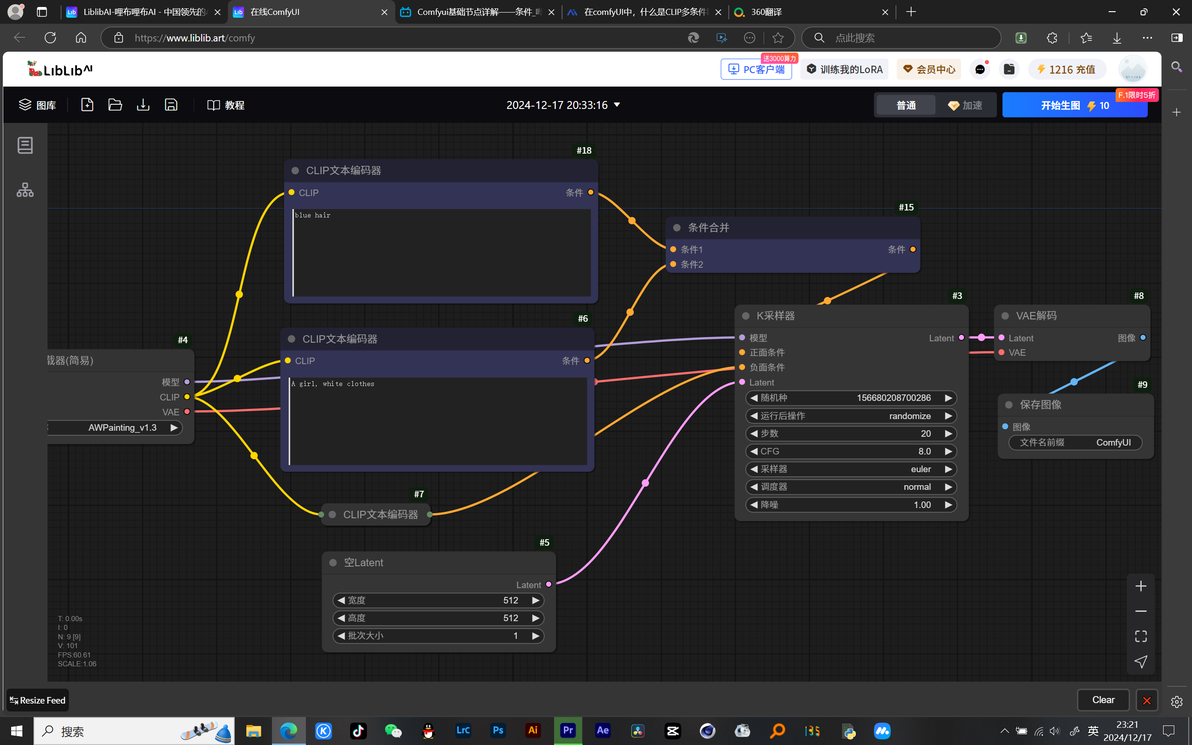
连接上后,点击生成,会发现生成出来的效果和条件联结没有什么区别。同样可以生成蓝色头发家白色T恤的画面。
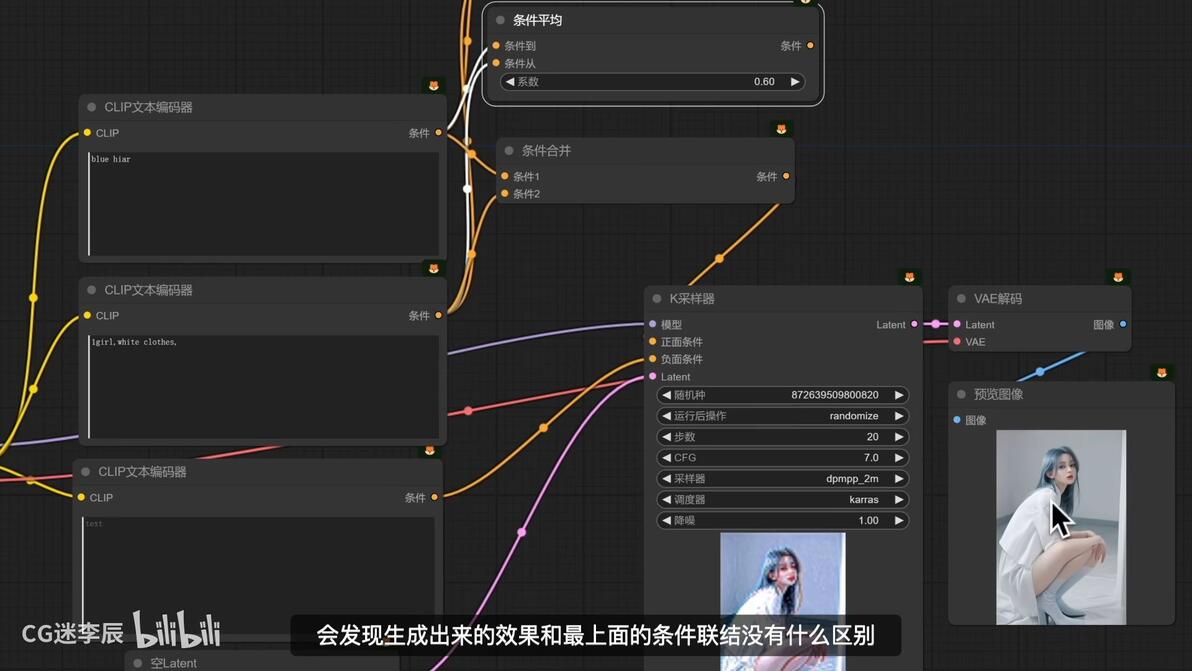
如果我们输入的提示词都是同一角色的独立的元素,那么这样两者确实没有什么区别。
eg:如果我们换个提示词,上面这个正向提示词修改成一只狗穿着红色衣服,下面这个正向提示词还是一个穿着白色衣服的女孩。
这时候上下提示词就不是同一个角色了。
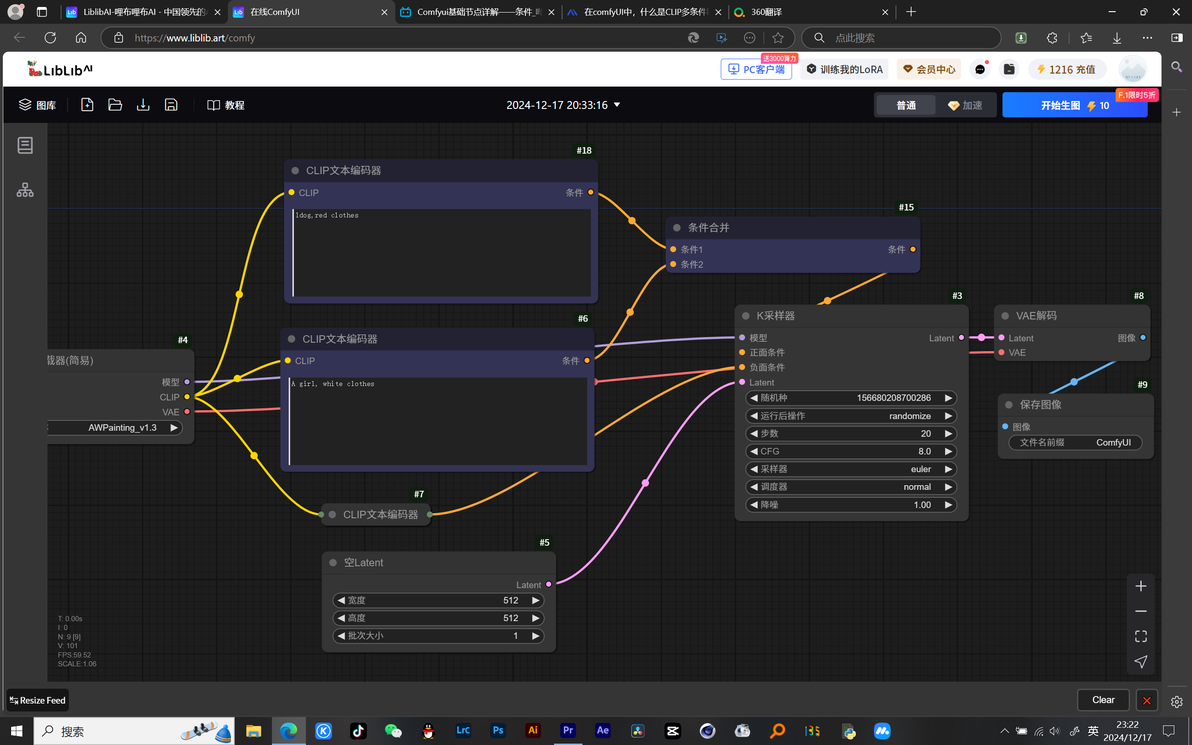
条件联结会从这两组提示里面随机抽取提示词进行组合来生成画面。
eg:从上面的提示词抽取了红色,从下面的提示词抽取了白色的衣服,从而生成了这样的画面。
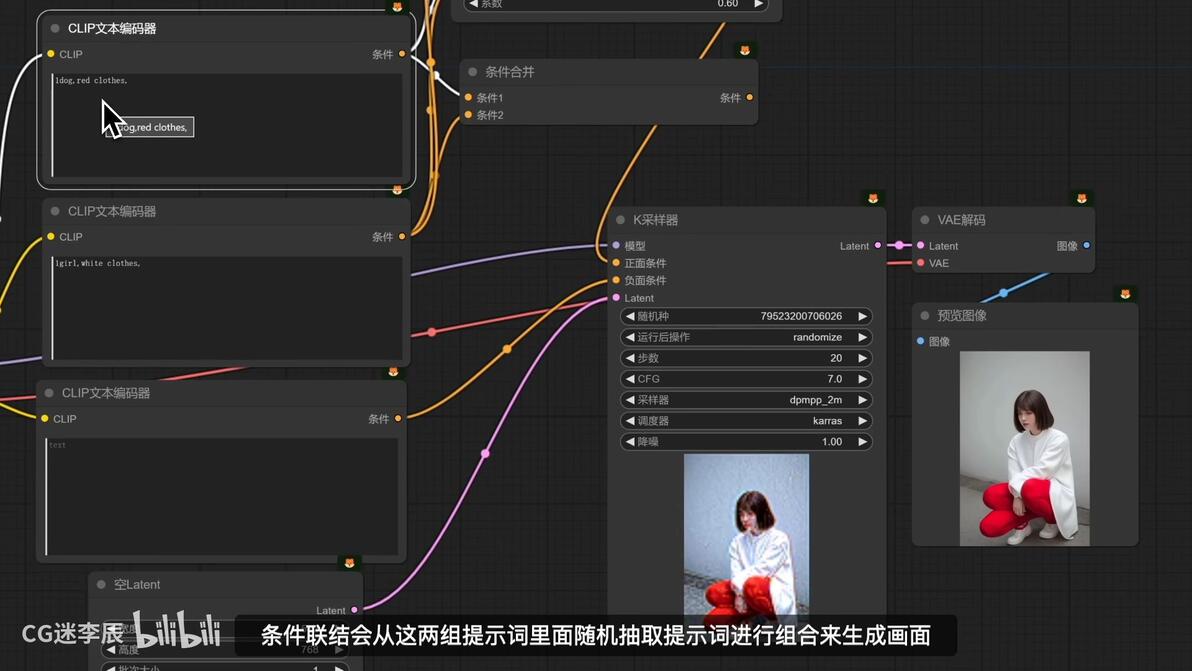
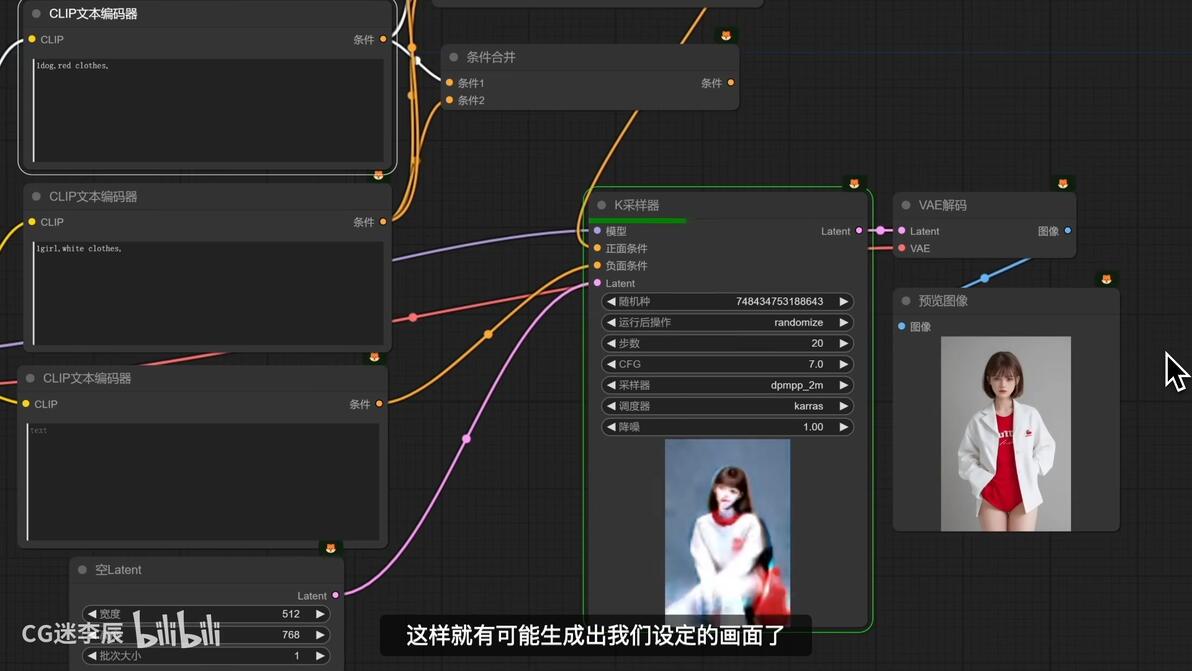
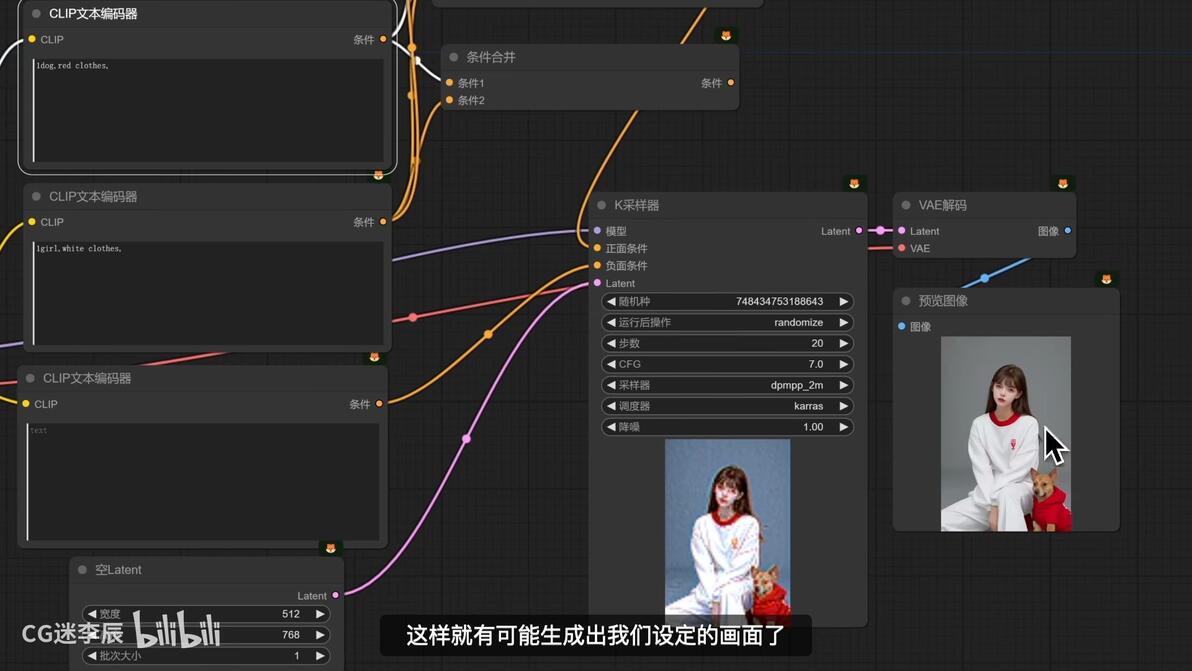
而条件合并则是直接把两组提示词完全混合在一起。
eg:上面是一只狗,下面是一个女孩,那么它就会把狗和女孩融合在一起,从而给我们生成出这样的拟人化动物出来。
十三、条件设置遮罩节点
条件设置遮罩节点(Conditioning (Set Mask))是一种用于修改生成模型条件的节点。该节点通过应用具有指定强度的遮罩来实现对特定区域的调整,从而对生成过程进行更精确的控制。
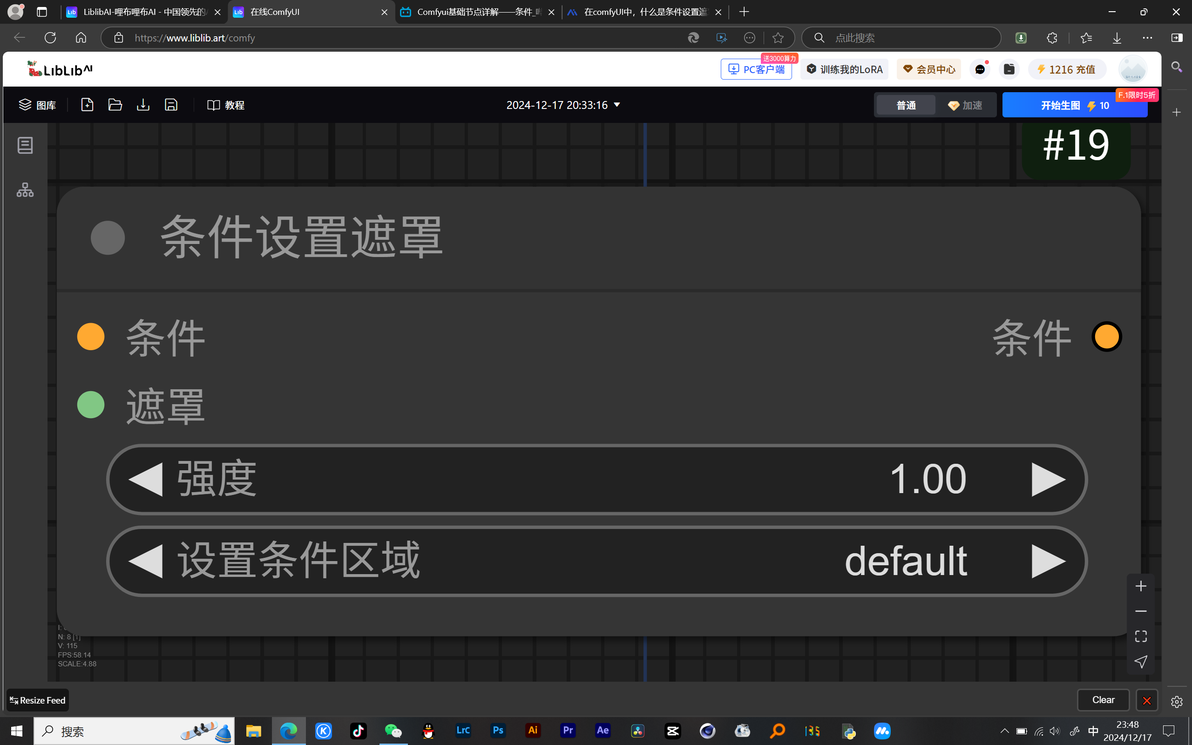
这个节点是用来设定提示词的起效区域的。
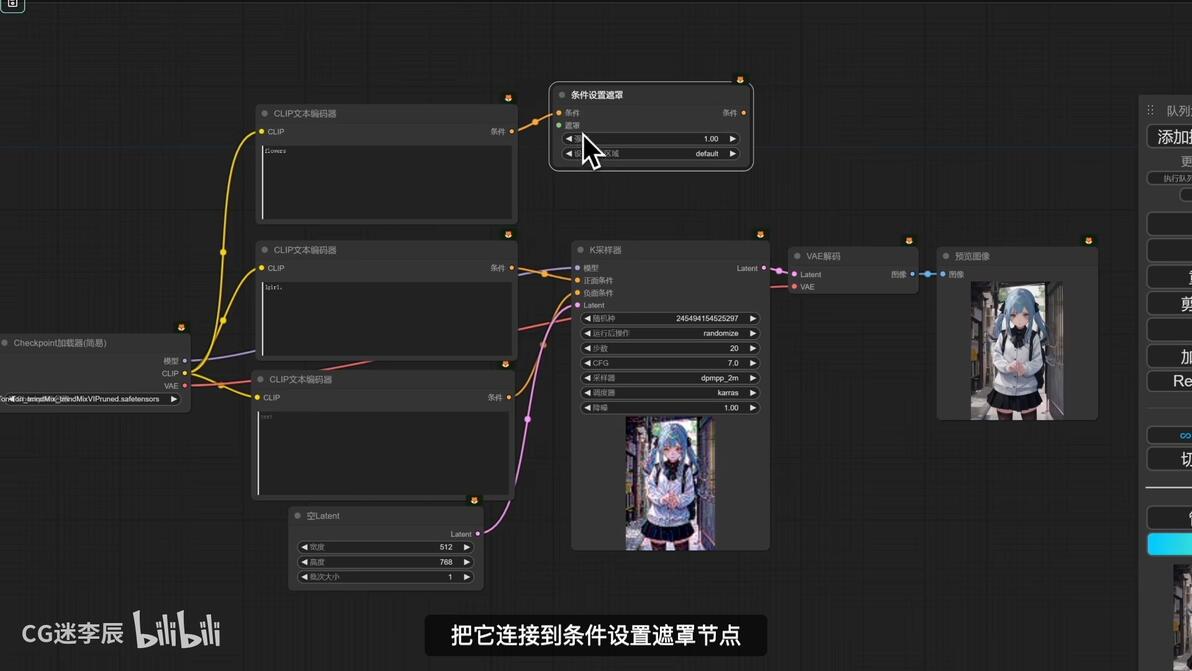
现在提示词输入一个女孩,复制一个正向提示词出来,在复制的正向提示词中输入鲜花,把它连接到条件设置遮罩节点中
连接一个条件合并节点,连接两个正向条件提示词,合并输入给k采样器
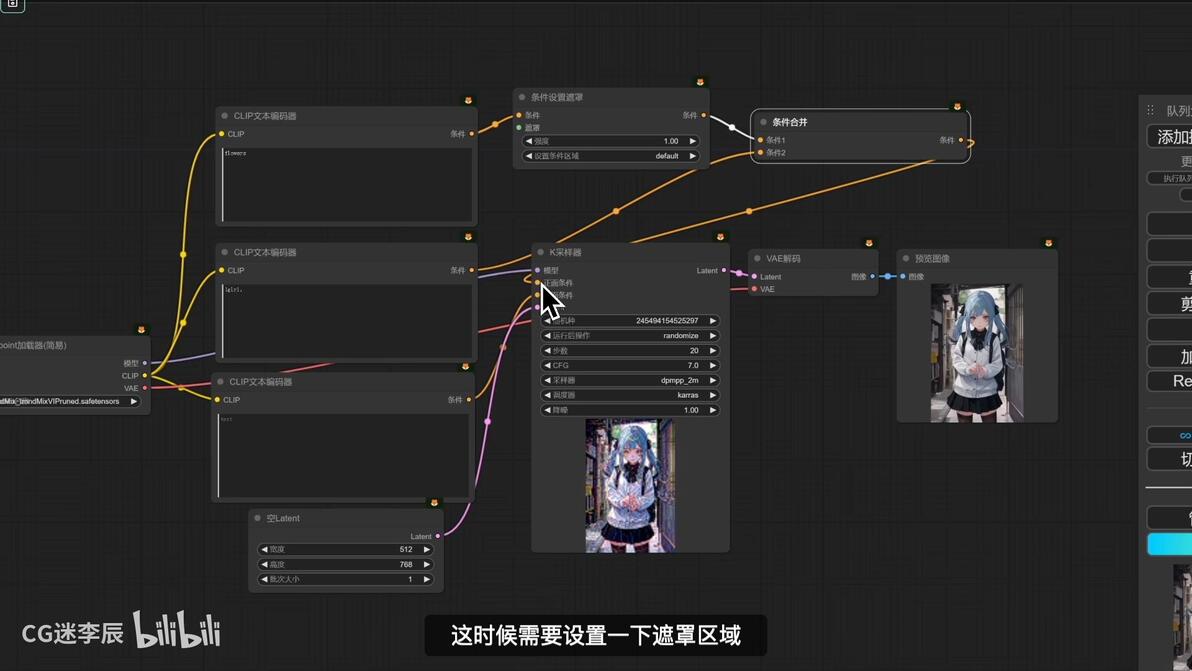
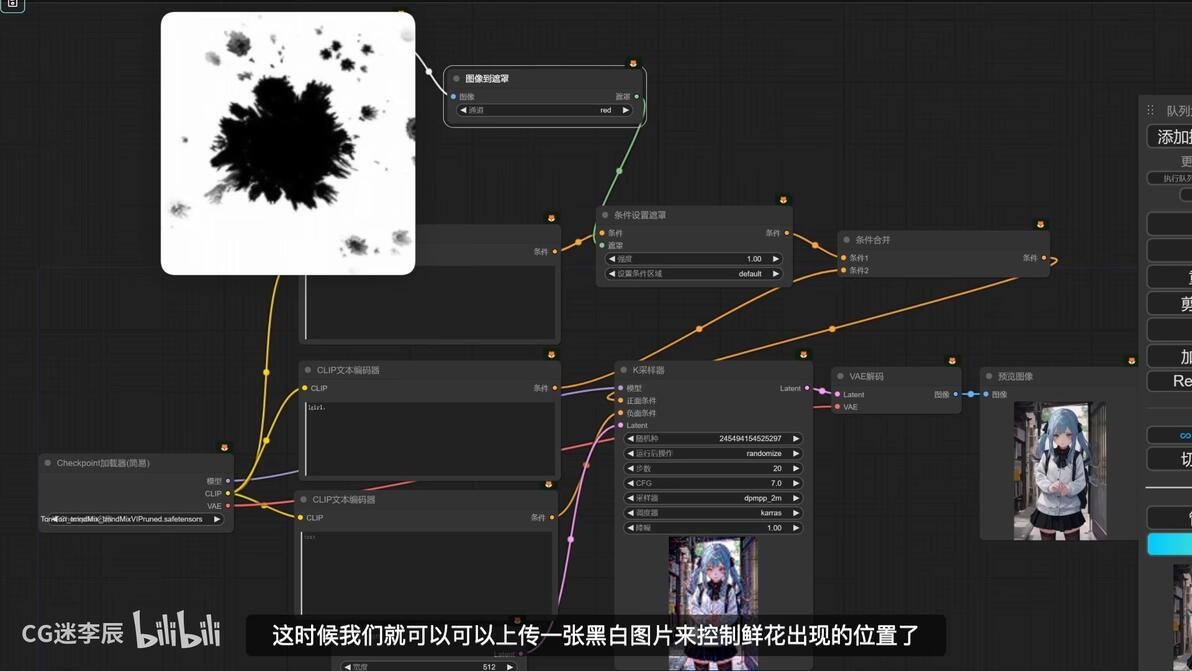
这个时候需要设置一下遮罩区域,用以控制生成鲜花在小女孩图片中出现的位置。
方法一:加载一个图片进来
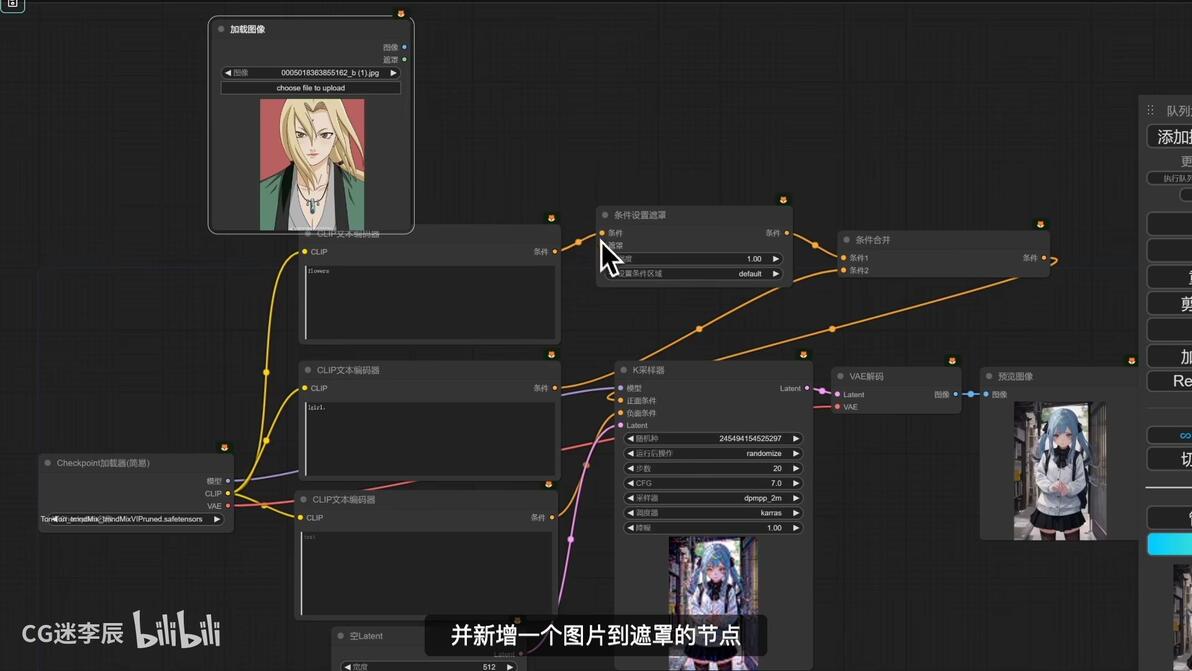
连接到图像到遮罩,把图片转成遮罩
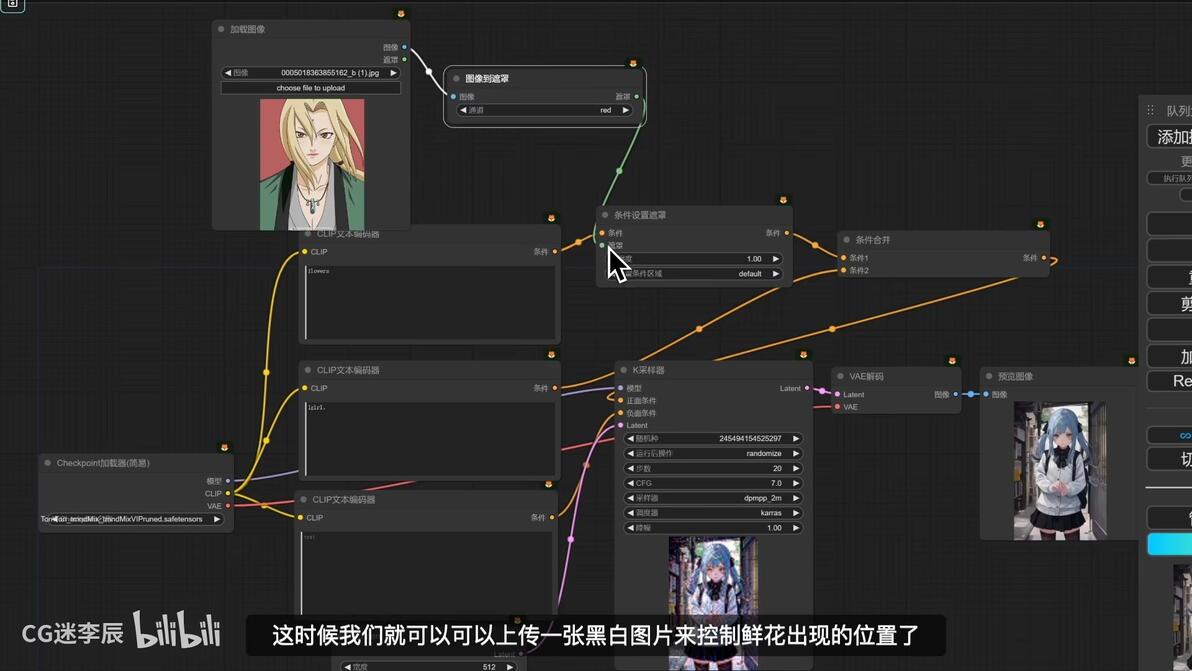
这时候我们就可以上传一张黑白图片来控制鲜花出现的位置了。
方法二:直接把图片的遮罩连接到条件设置遮罩上
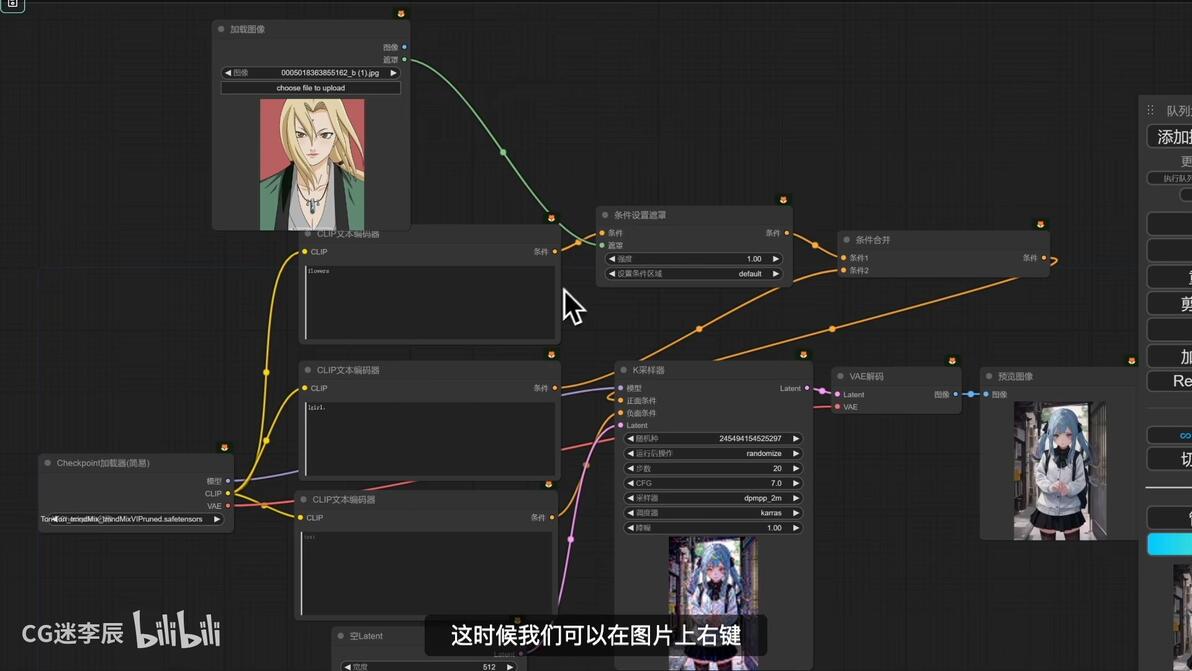
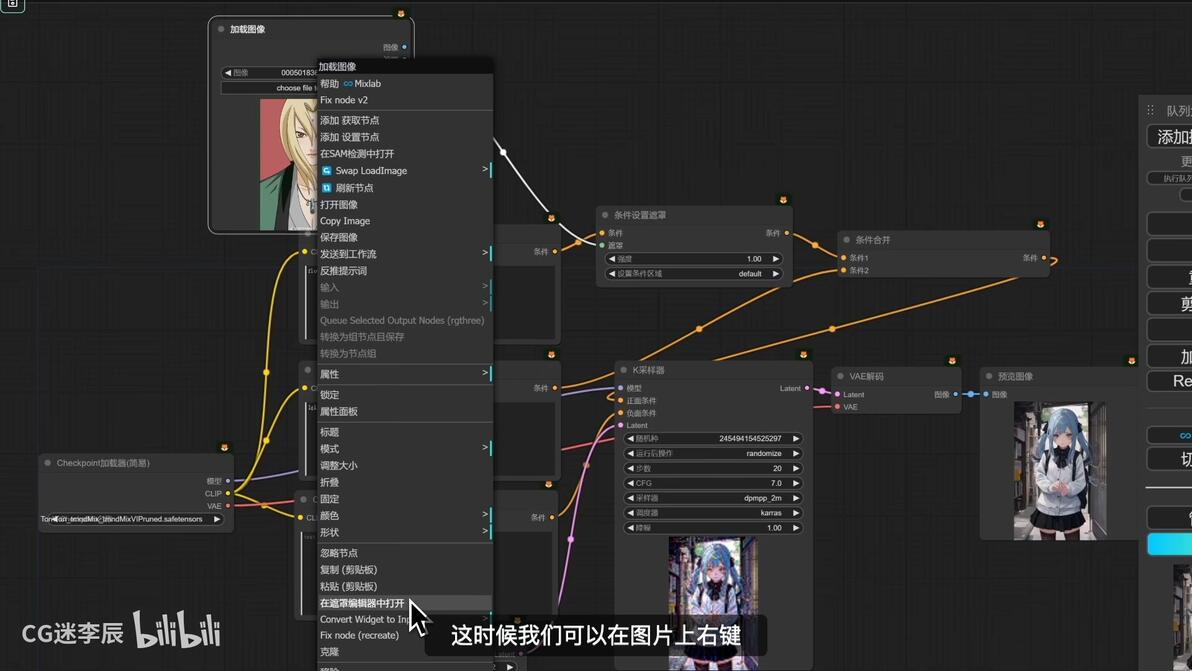
在图片上右键,选择在遮罩编辑器中打开。
这时候图片就可以忽略了,只需要涂抹出一块用于鲜花出现的遮罩区域即可。
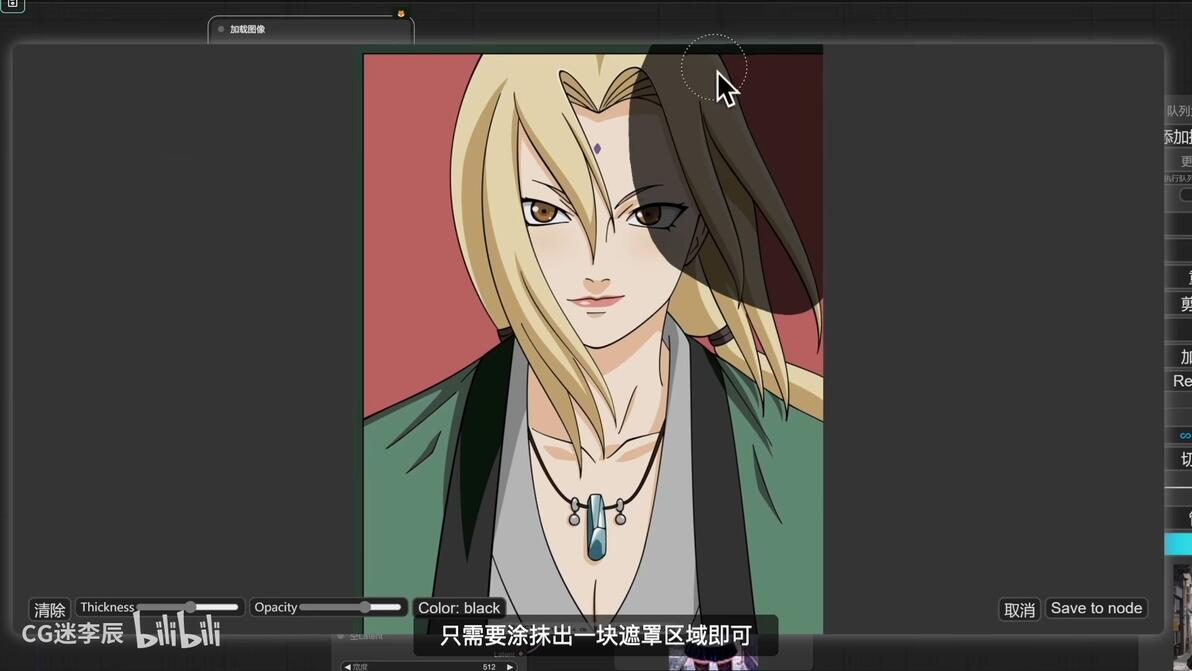
保存一下,这时候右上角的这块遮罩区域,在条件设置遮罩下直接生成出鲜花来。
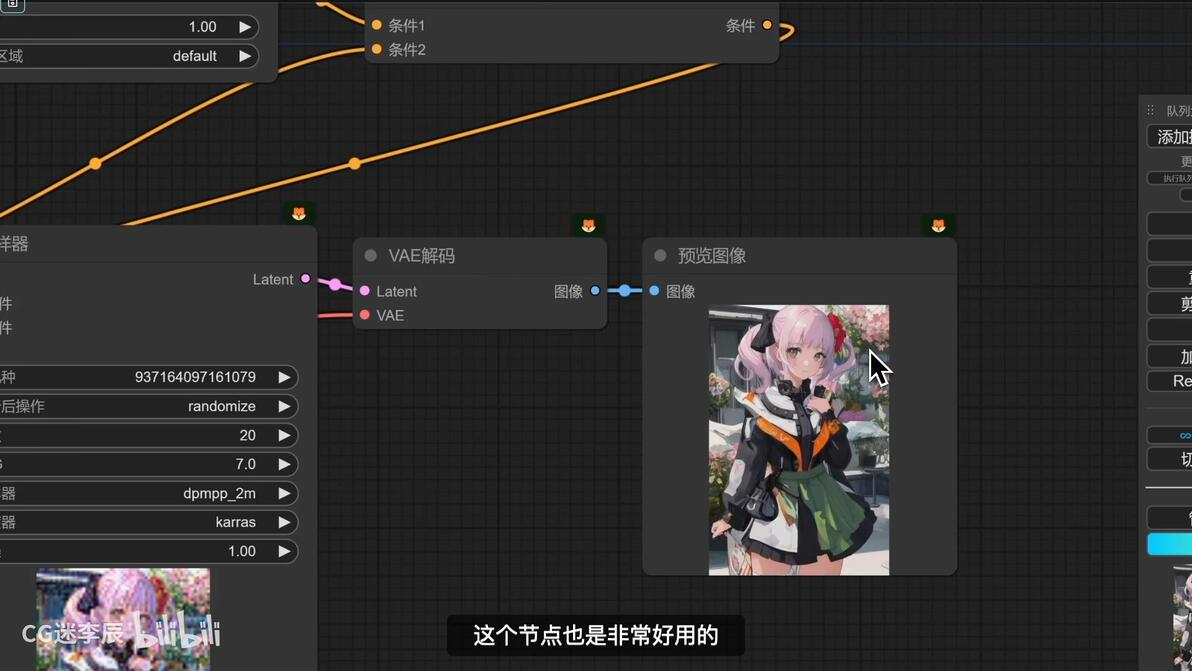
方法三:可以直接加载一张带有鲜花的黑白遮罩进来,直接连接到条件设置遮罩节点的遮罩输入端口上。
十四、CLIP视觉编码节点
CLIP视觉编码节点(CLIP Vision Encode Node)是一个用于将图像编码成嵌入的节点。这个嵌入可以用来指导unCLIP扩散模型,或者作为样式模型的输入。该节点的主要功能是使用CLIP视觉模型将输入的图片转化为嵌入表示,从而实现对图像的进一步处理或分析。
具体来说,CLIP视觉编码节点的输入包括两个部分:一是用于编码图片的CLIP视觉模型,二是需要被编码的图片。通过这个节点处理后,输出的是编码后的图片嵌入,这些嵌入可以用于指导后续的图像生成或分析任务。
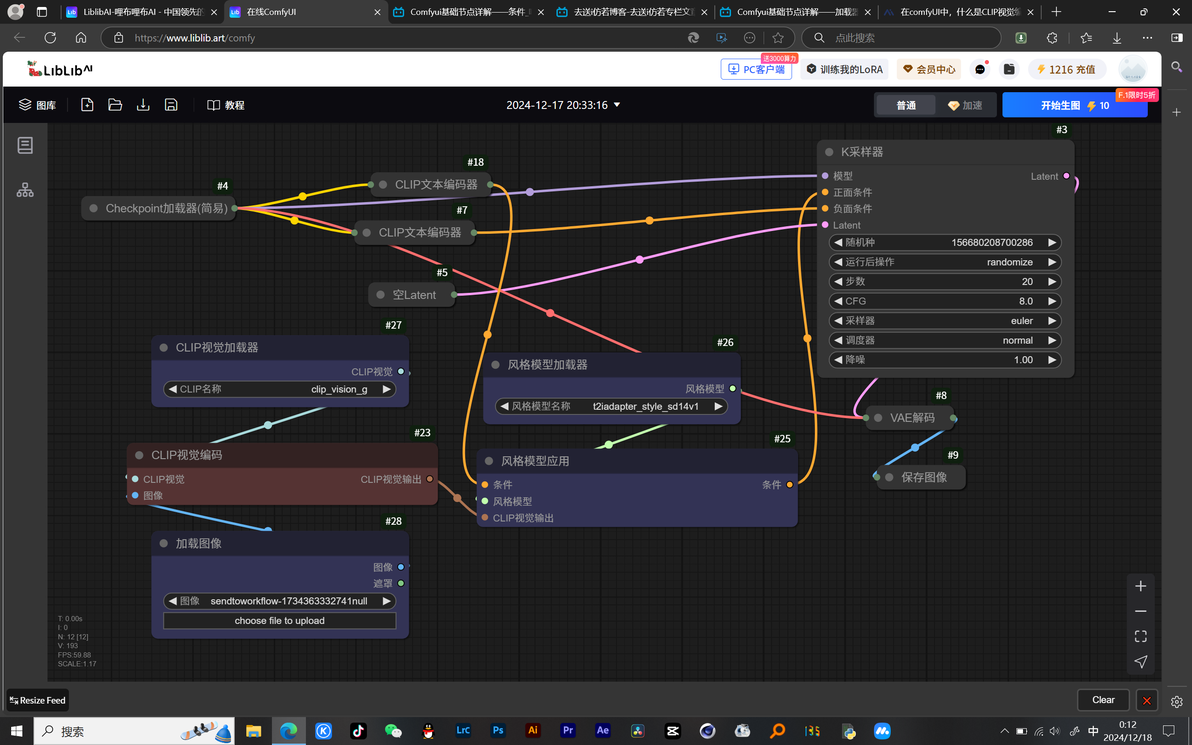
上节课已经讲过了,在第十点中有,这是工作流:
十五、unCLIP条件节点
unCLIP条件节点(unCLIP Conditioning node)是一个用于为unCLIP模型提供额外视觉指导的节点。unCLIP模型是一种升级版的扩散模型,能够接收文本提示和图像概念作为输入,并通过CLIP视觉模型对图像进行编码,从而在生成过程中传递提取的概念。
unCLIP条件节点的主要功能是将由CLIP视觉模型编码的图像整合到条件过程中,根据指定的强度和噪声增强参数调整这些输出的影响。这个节点可以串联多个图像作为视觉引导,以丰富生成过程中的视觉上下文。
具体来说,unCLIP条件节点的输入包括基础条件数据、由CLIP视觉模型编码的图像(clip_vision_output)、unCLIP扩散模型应该受到图像多大的引导(strength)以及噪声增强(noise_augmentation)。噪声增强用于引导unCLIP扩散模型在原始CLIP视觉嵌入的邻域内随机移动,从而提供与编码图像密切相关的生成图像的额外变化。
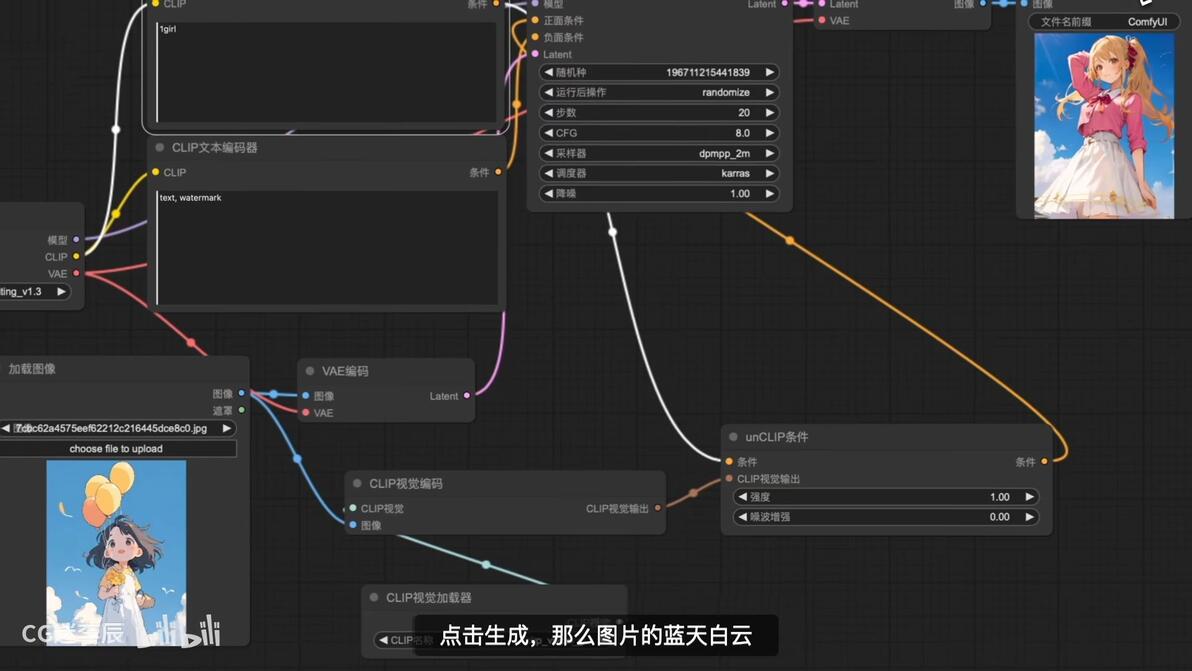
eg:正常的图生图工作流就是会根据我们上传的图片,来生成相似的效果。但很多时候我们只想comfyUI参考图片的风格来生成画面。
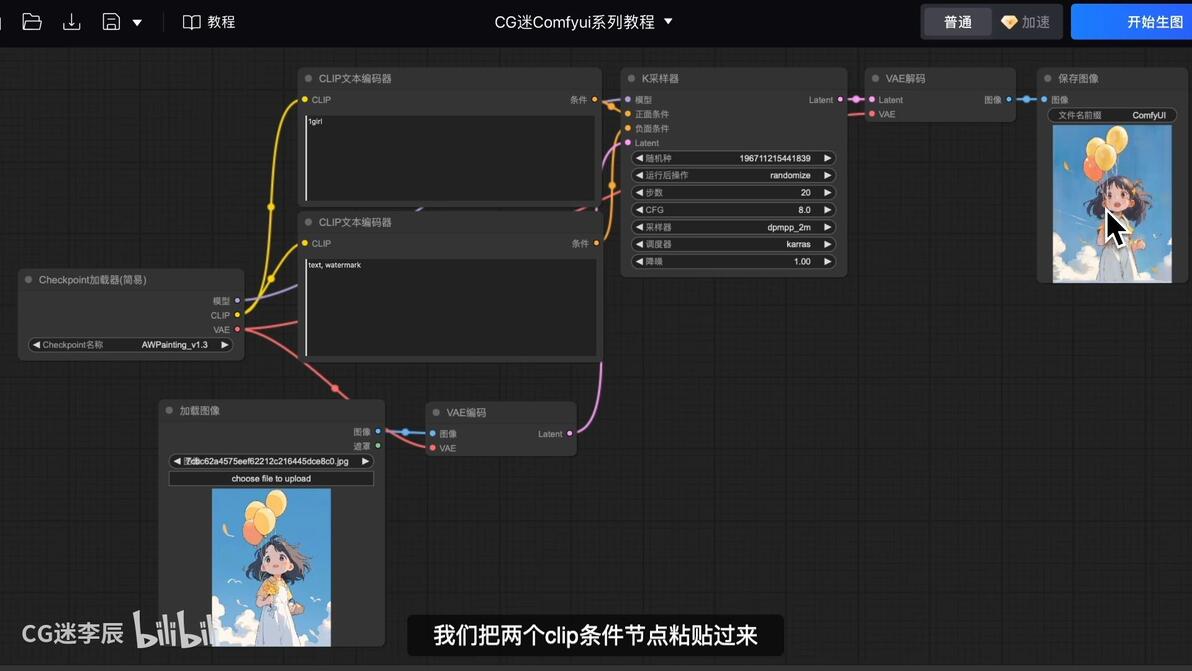
添加CLIP视觉编码和unCLIP条件节点出来,

给CLIP视觉编码加载一个CLIP视觉加载器,接着把图片输入过来。
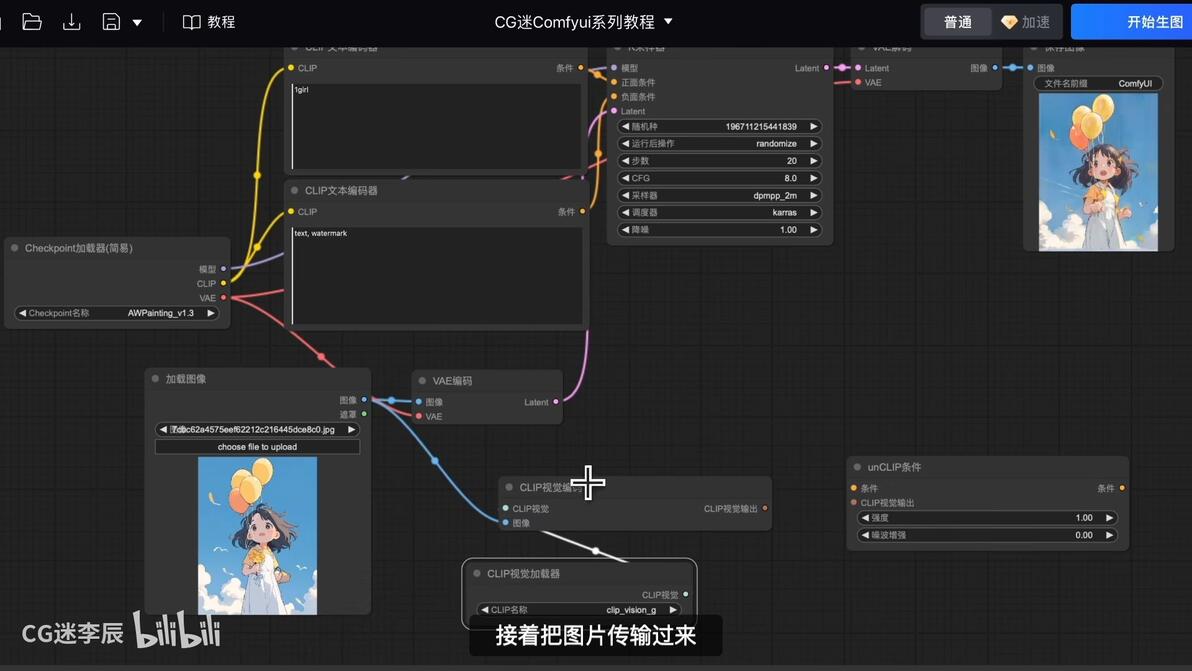
这样,CLIP视觉模型就会学习这张图片的特点来给我们生成画面了。
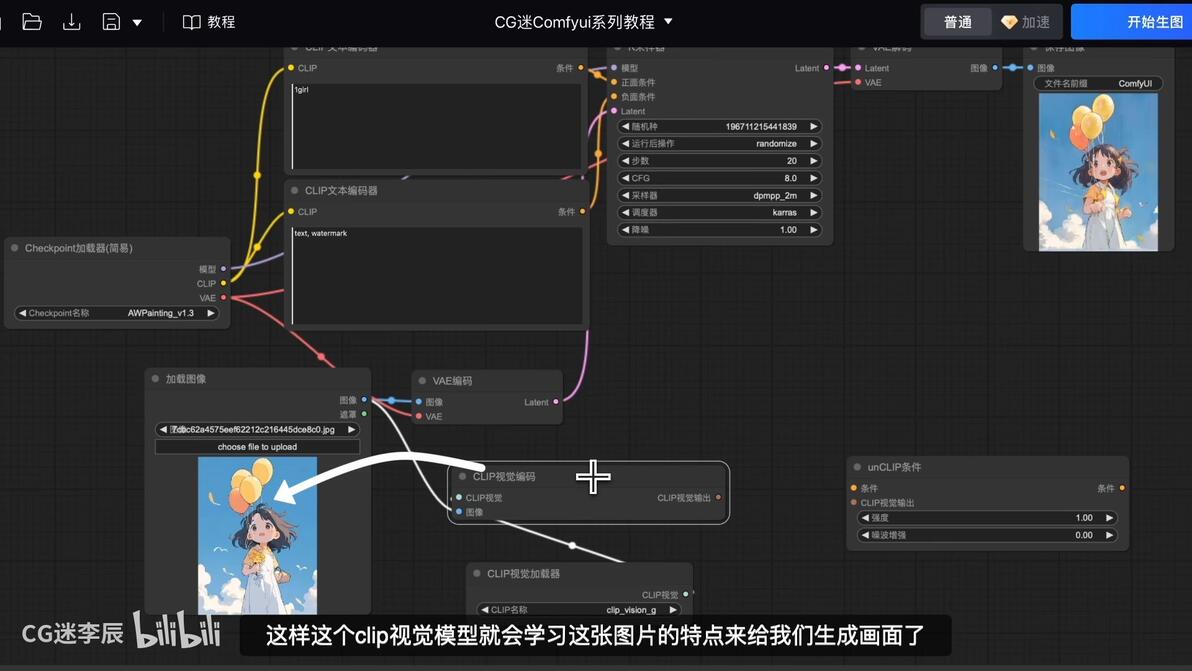
但现在怎么才能让它传输给k采样器呢?这个时候就需要用到unCLIP条件节点了。

把CLIP视觉编码连接到unCLIP条件上,把正向条件连接到unCLIP条件上,这样,unCLIP条件就能连接到k采样器上了。
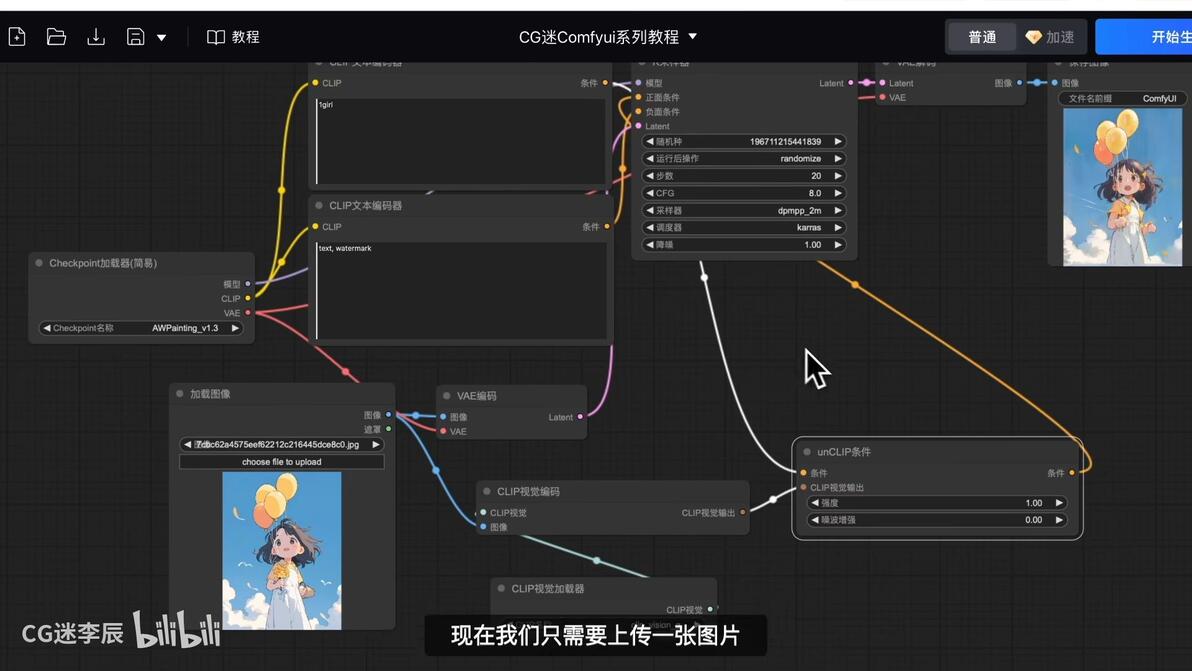
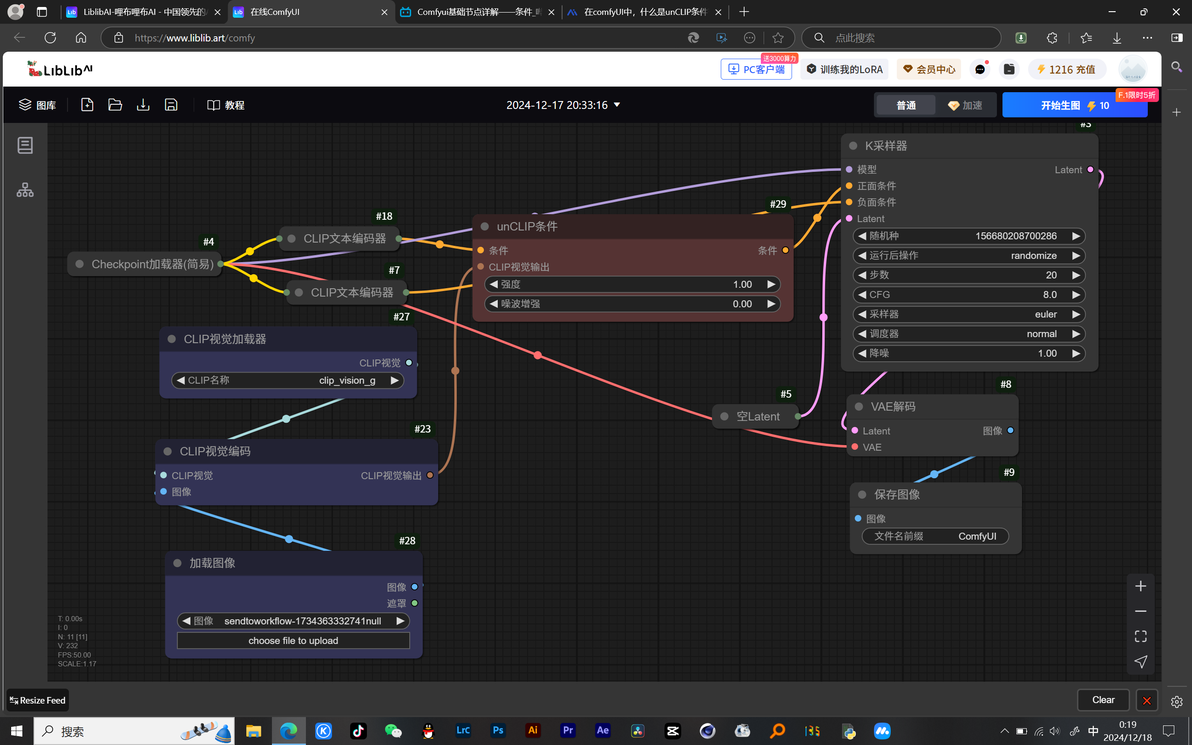
这样,提示词完全不需要输入对应的描述,点击生成,那么图片的蓝天白云,阳光明媚小清晰的风格特点就直接生成出来了。