comfyUI基础节点详解——加载器
在ComfyUI中,加载器是一种用于加载和管理各种模型和资源的工具节点。这些加载器在图像生成工作流中扮演着至关重要的角色,因为它们负责将所需的模型和数据导入系统,以便进行进一步的处理和生成任务。
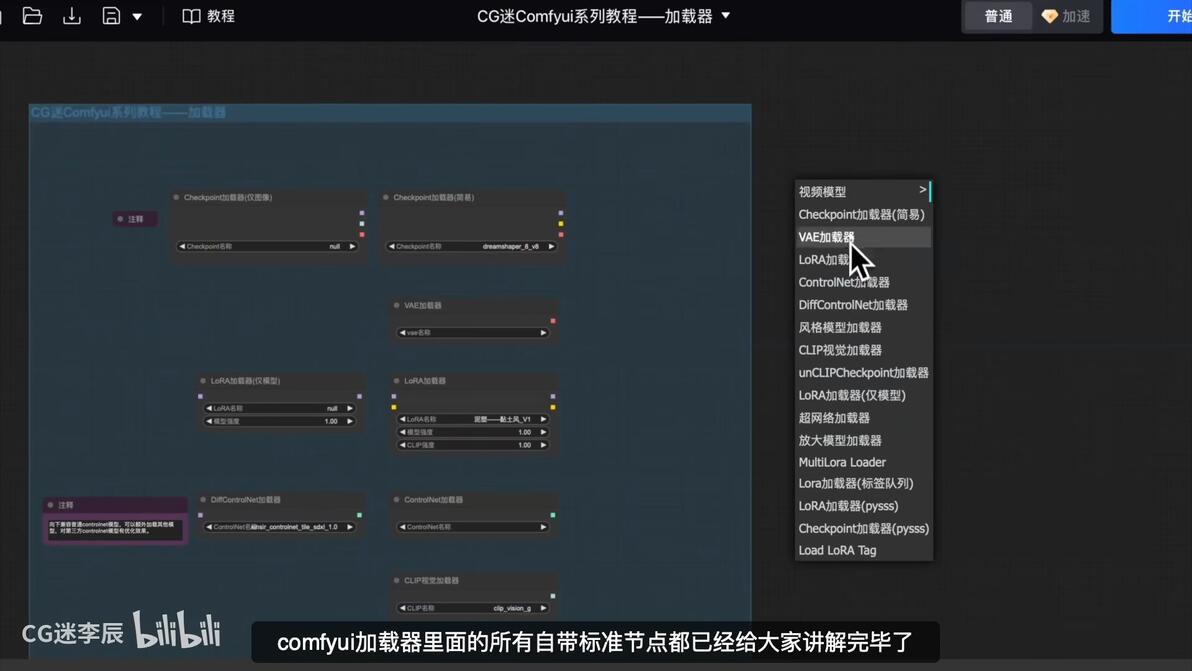
这里的基础节点指的是comfyUI自带的节点,而不是扩展节点。
一、Checkpoint加载器
Checkpoint加载器是一个用于加载和处理深度学习模型权重文件的重要工具节点,这是图像生成的核心,决定了生成图像的风格和质量。
1、Checkpoint加载器(简易)
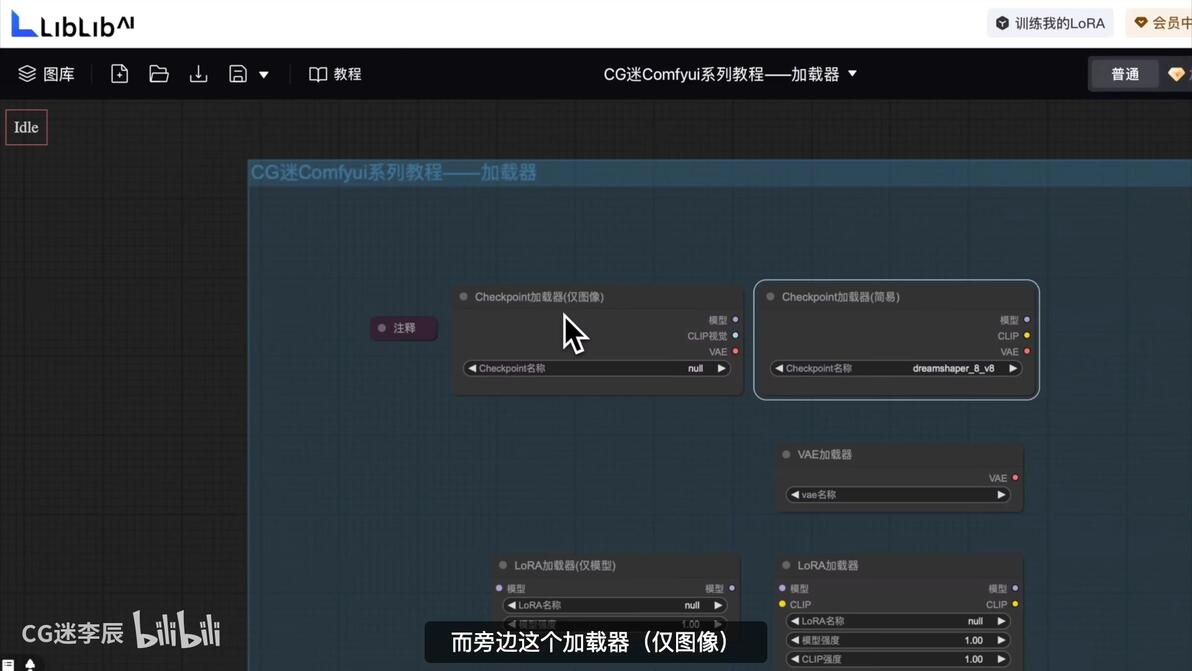
这也是最常见的加载大模型的方式
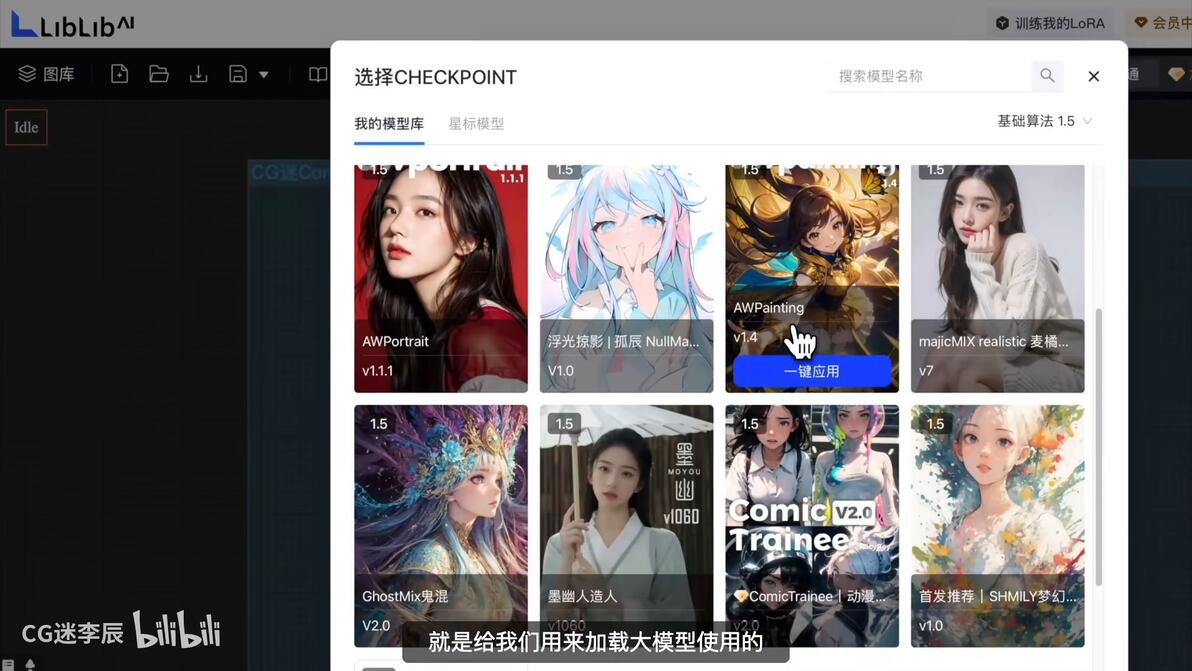
2、Checkpoint加载器(仅图像)
与Checkpoint加载器(简易)不同的是,它是专门用来作为视频输入使用的。
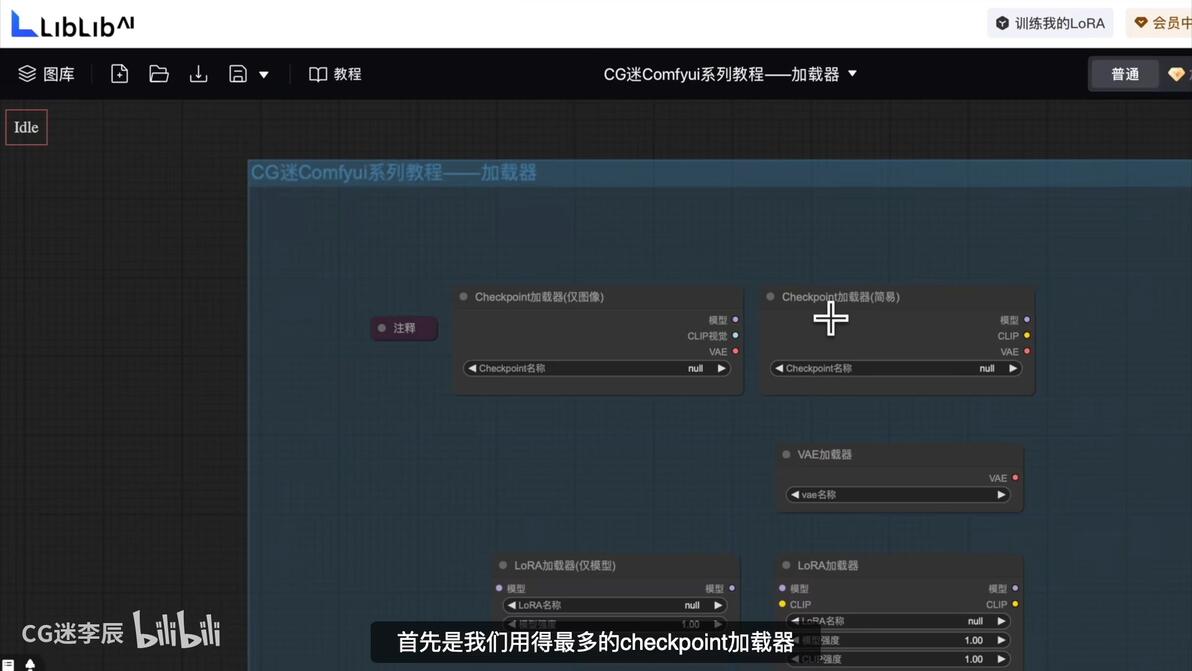
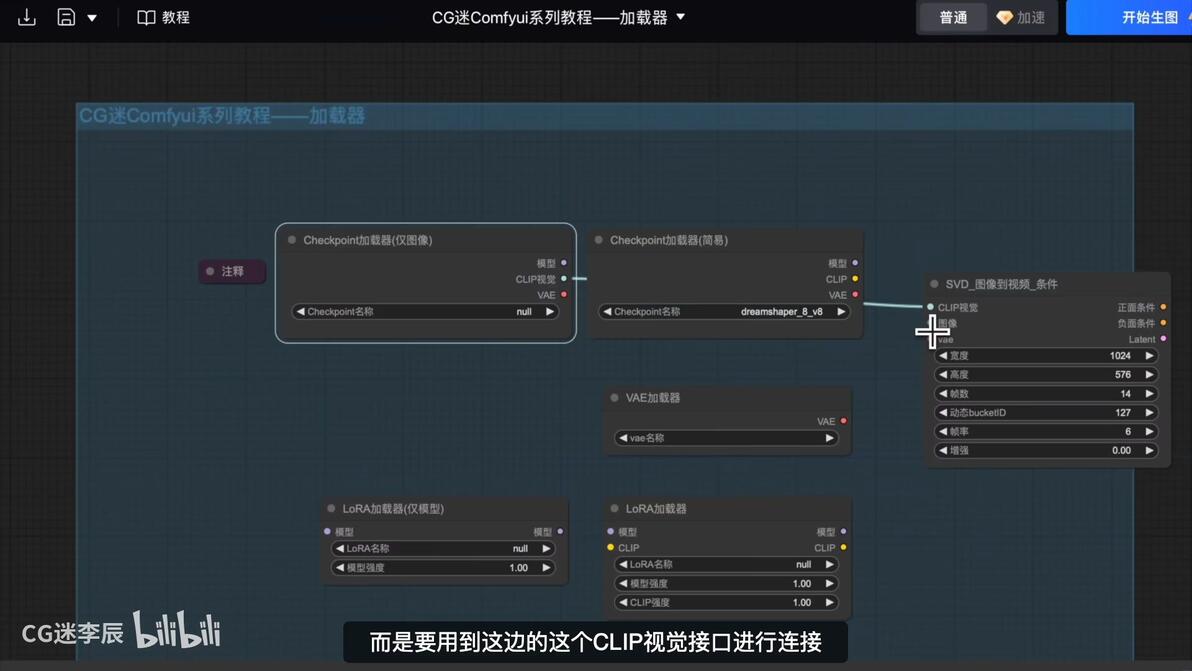
因为是作为图像输出的,所以ta有【CLIP视觉】输出端口,用以加载视觉输出节点的。
eg:使用SVD图像到视频条件节点
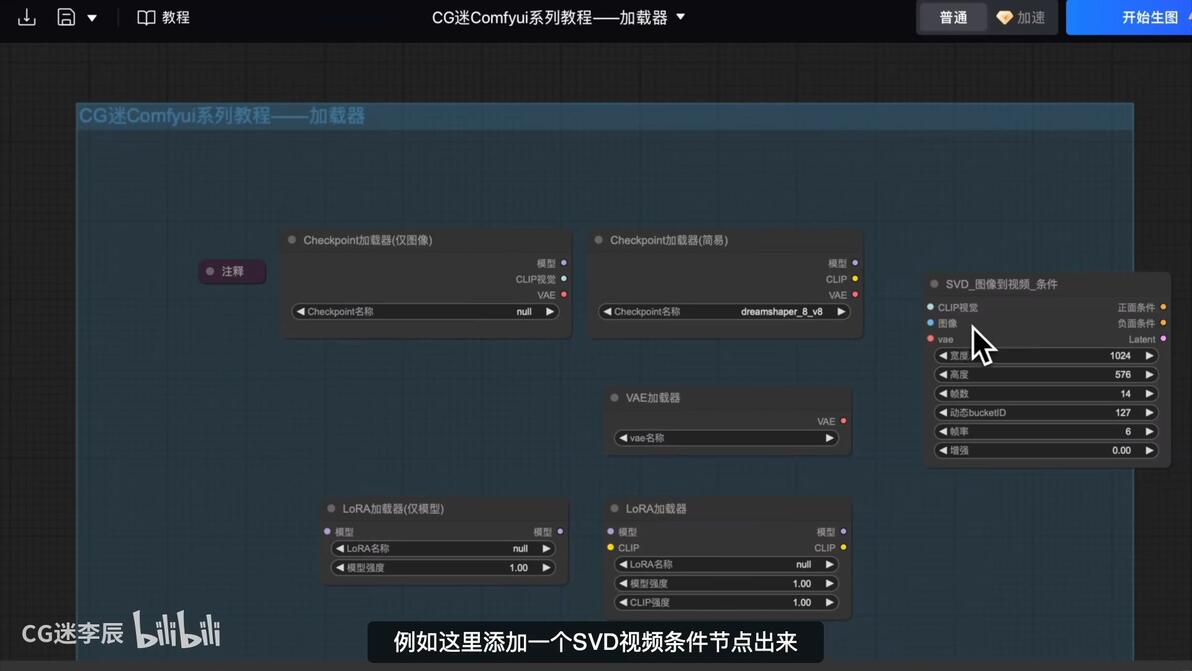
而SVD图像到视频条件节点需要加载【CLIP视觉】输入端口,这个时候就需要加载Checkpoint加载器(仅图像)这个节点了。
二、VAE加载器
VAE加载器的作用是将图像从像素空间编码到潜在空间,再从潜在空间解码回像素空间。这一过程通过编码器和解码器的协同工作实现,其中编码器将图像压缩为低维的潜在表示,而解码器则从这些潜在表示中重建图像。这种转换对于图像生成和处理非常重要,因为它能够帮助模型学习图像的本质特征,提高图量像质,保持风格一致性,并降低计算复杂度。
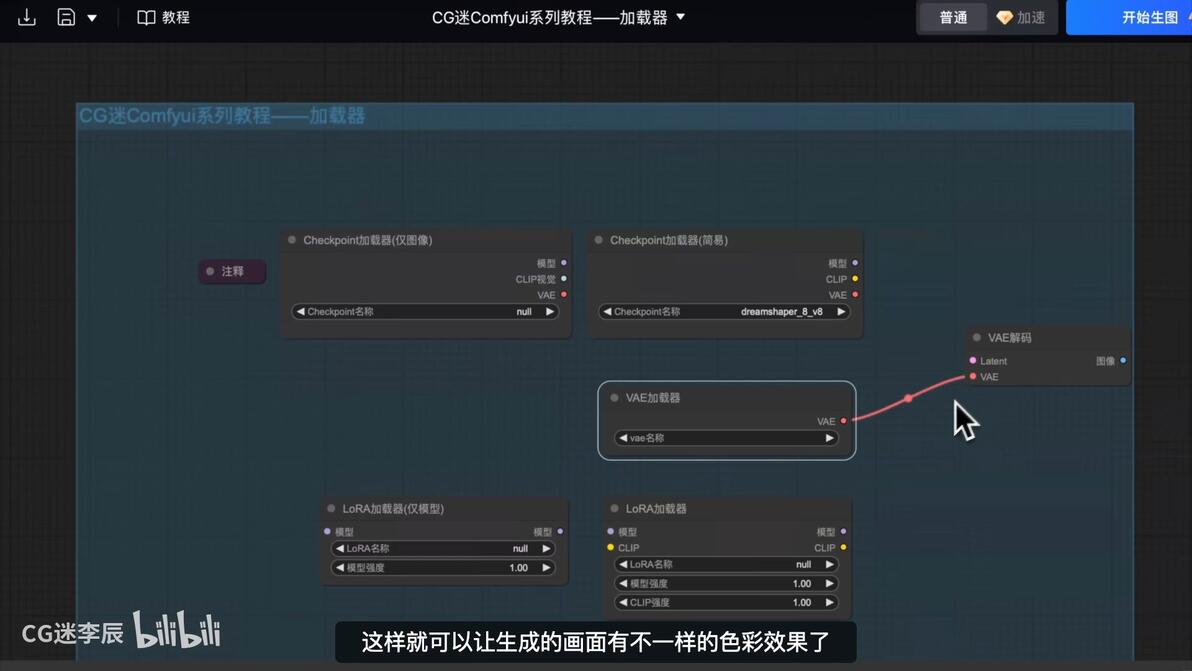
而在这里,你可以简单的理解为VAE模型是用来控制生成图片的画面色调的。

通常情况下我们是直接引用大模型的VAE的,但有些时候我们不想用大模型的VAE色调文件。

那我们就可以创建一个VAE加载器,自定义一个VAE模型,这样就可以让生成的画面又不一样的色彩效果了。
eg:使用VAE解码器节点
三、Lora加载器
Lora加载器是一种用于动态加载和应用LoRA(Low-Rank Adaptation)调整的节点。LoRA是一种轻量级的微调技术,通过在不改变基础模型参数的情况下增强生成模型的特定功能或风格。Lora加载器的主要功能是将预训练的LoRA模型应用到潜在空间图像生成过程中,从而定制模型的行为。
你可以简单的理解为,是一种可以对大模型进行微调的模型,可以实现不同的风格创作。
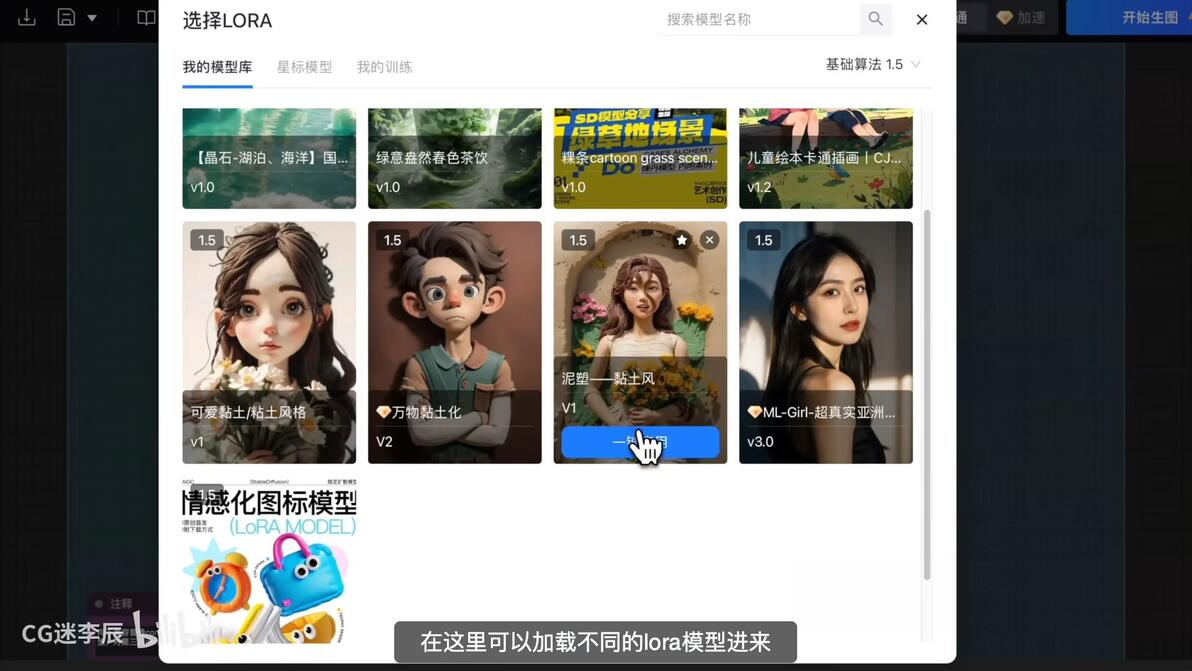
1、Lora加载器
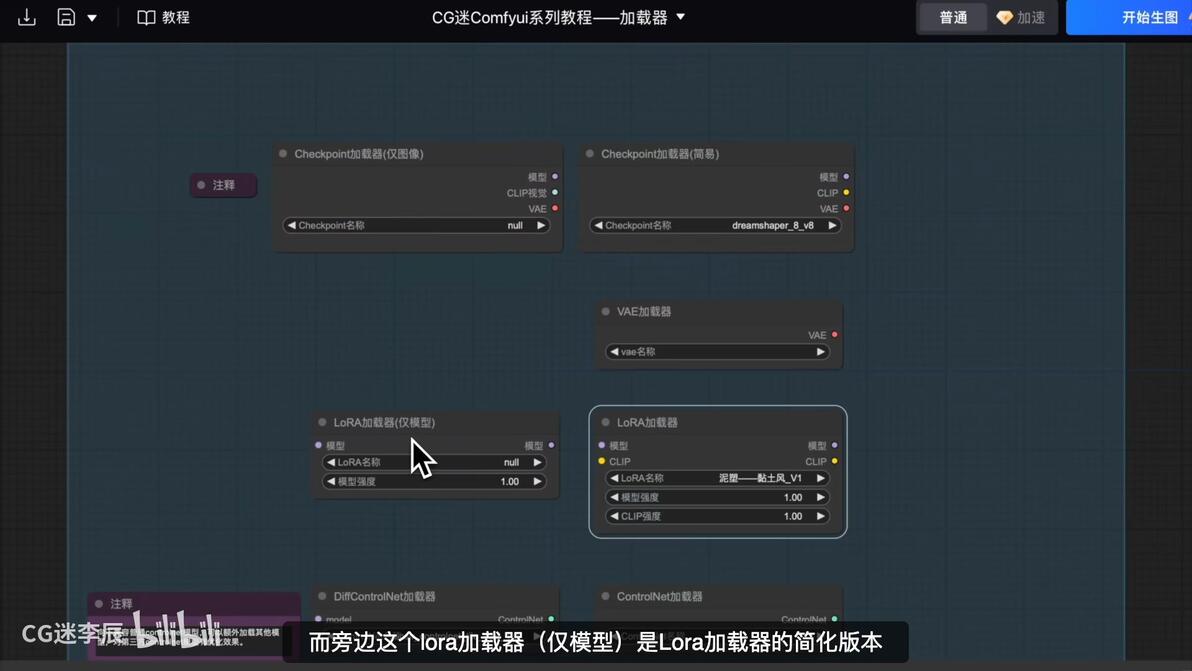
这个也是常用的Lora加载器。
eg:使用标准文生图工作流
正常加载Lora模型,需要是需要串联大模型和CLIP两个接口的。
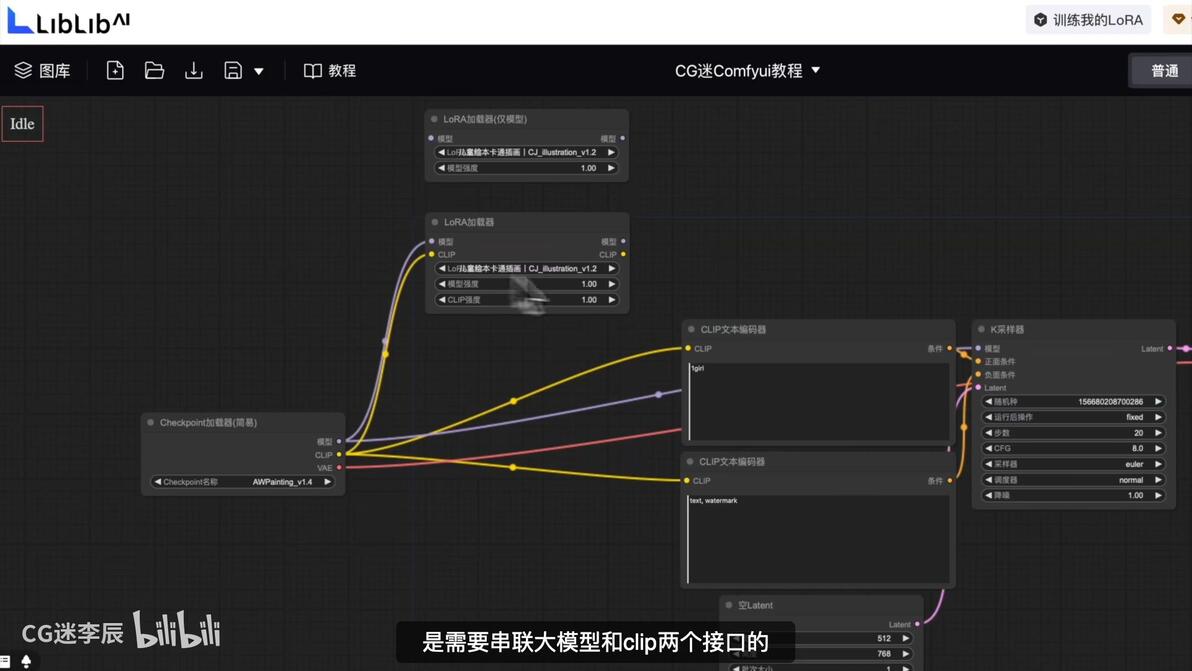
同时Lora加载器把模型输出到k采样器。
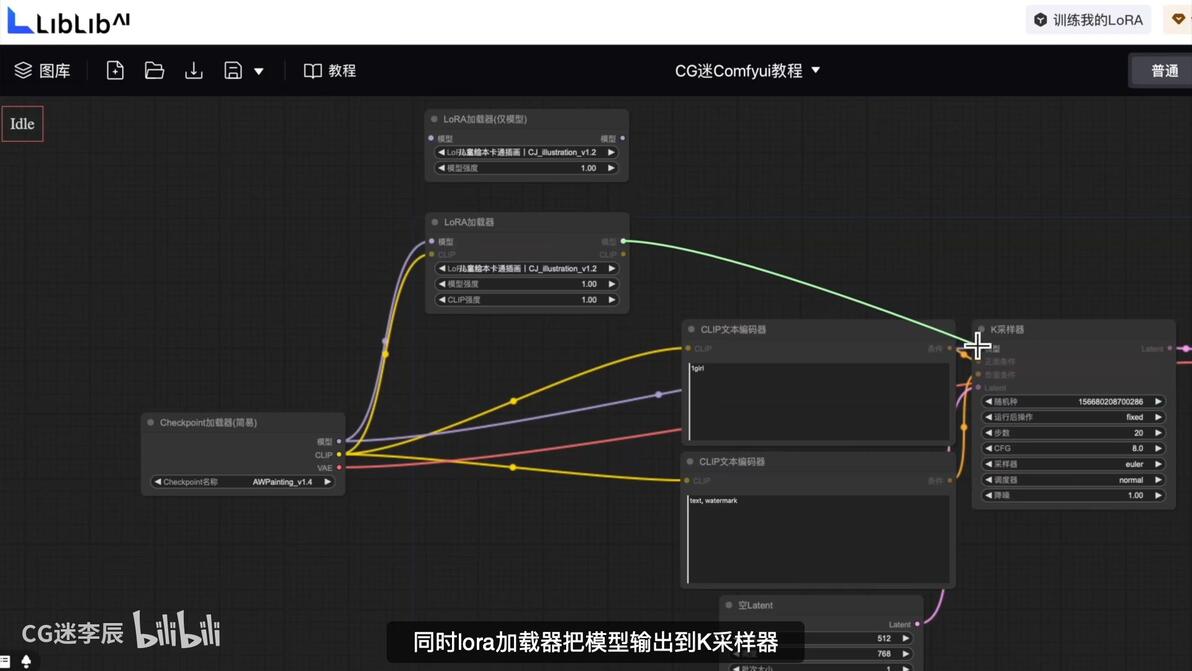
并把CLIP连接到正向提示词上。
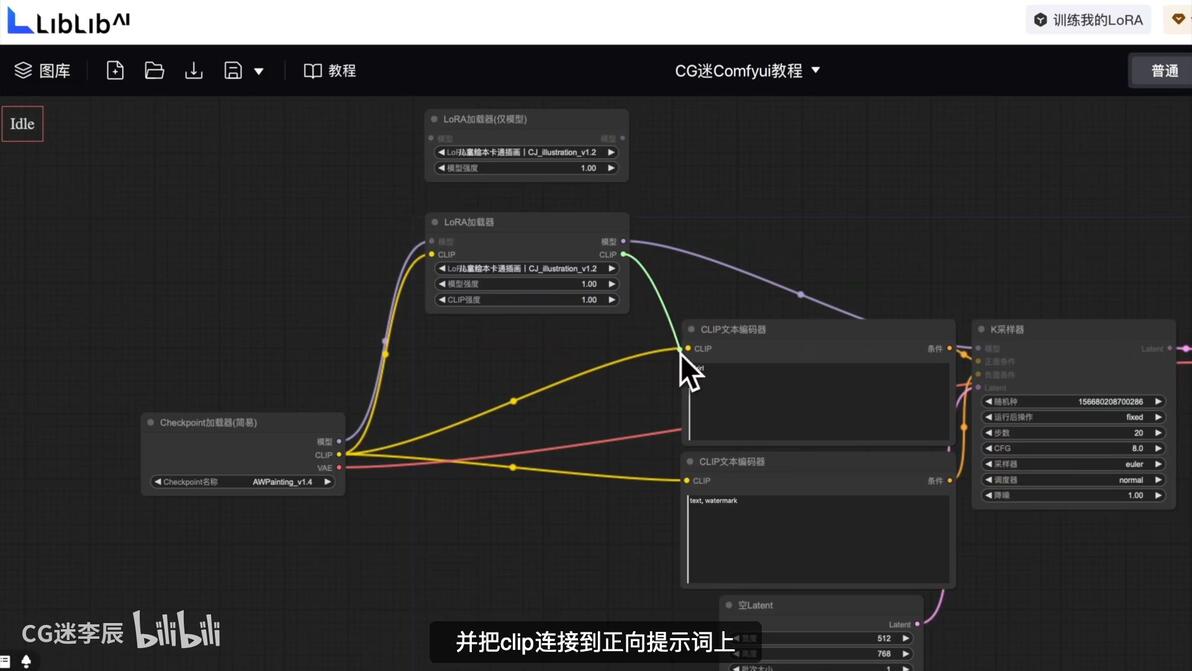
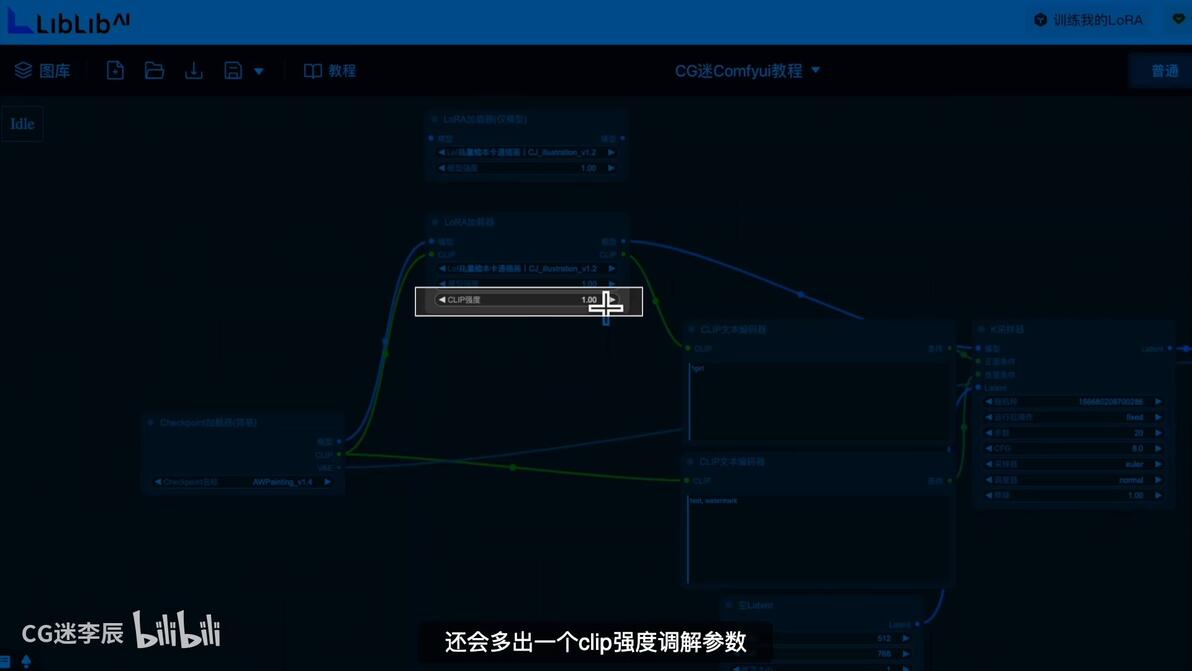
这样Lora模型就会经过正向提示词再到k采样器。所以,Lora加载器中除了Lora模型本身的强度参数可以调整外。还会多出一个CLIP强度调节参数。
2、Lora加载器(仅模型)
相当于Lora加载器的简化版本
eg:标准的文生图工作流
而Lora加载器(仅模型)就不会连接CLIP文本编码器上,直接串联到大模型上。
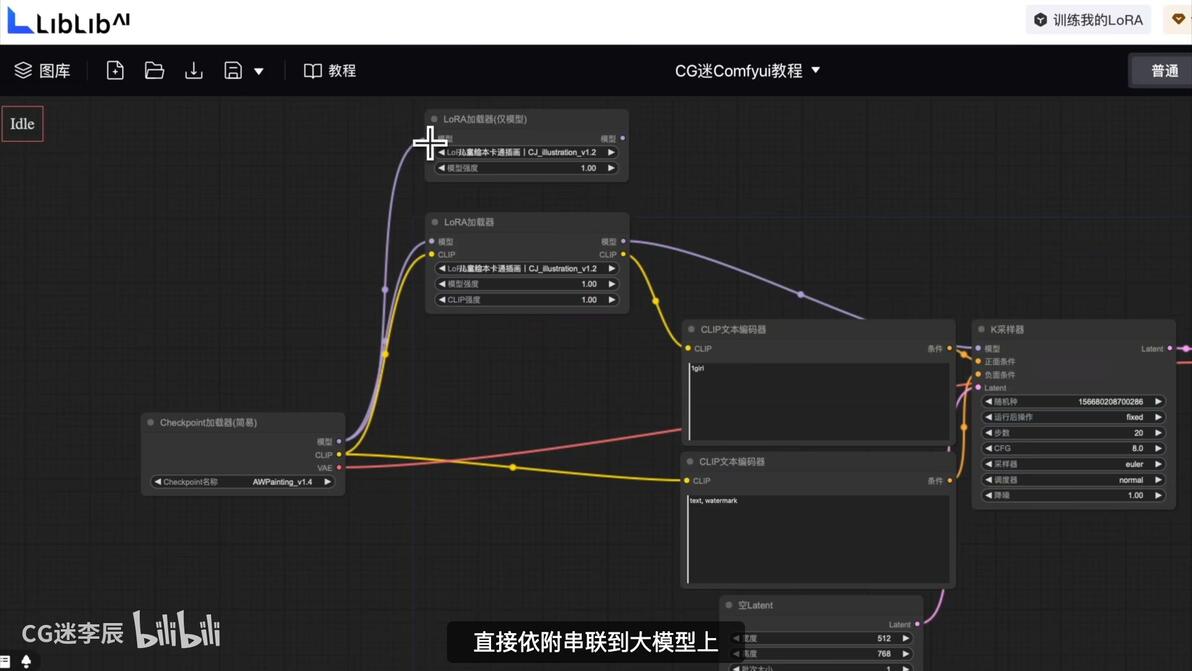
同时输出给到k采样器就可以了。
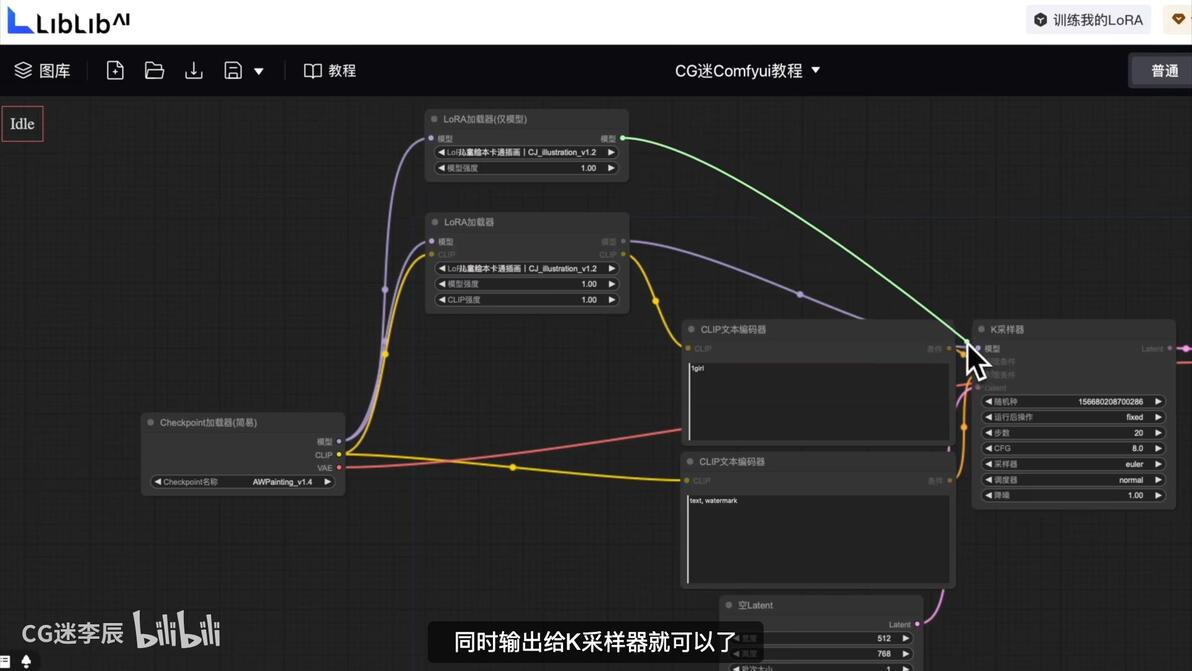
正向提示词的CLIP直接交给大模型来连接。
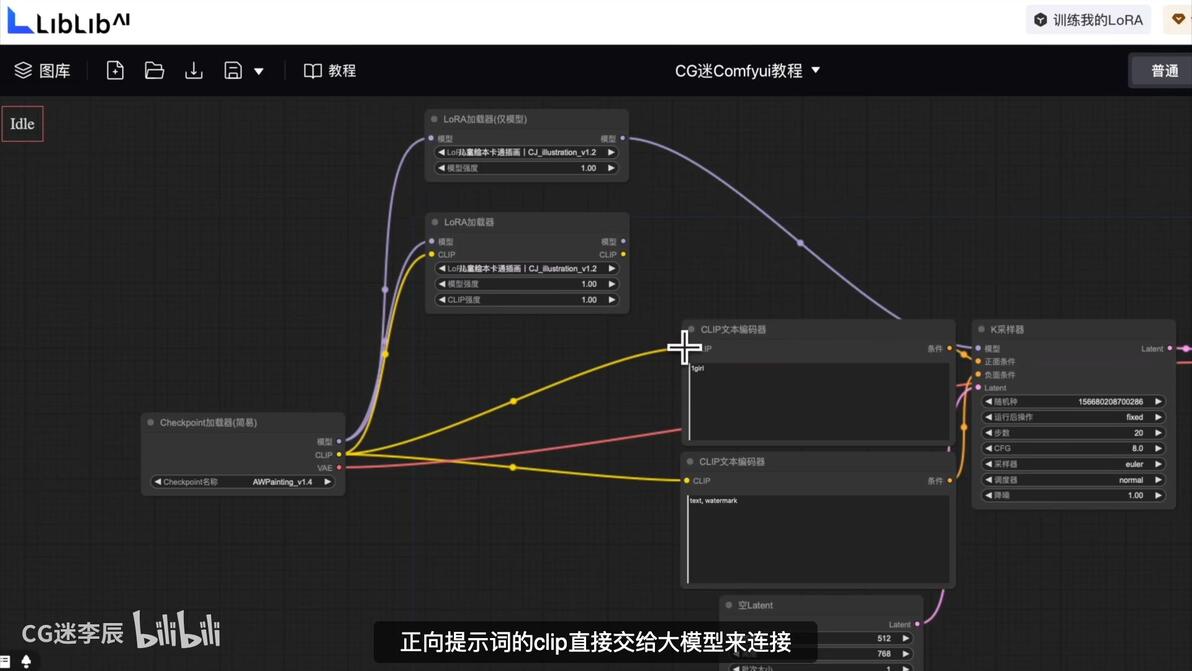
所以这个节点仅仅只有自身的模型强度一个参数。
四、ControlNet加载器
ControlNet加载器(ControlNet Loader)是一个节点,用于加载ControlNet模型。ControlNet是一种神经网络结构,通过添加额外的条件来控制扩散模型,从而增强模型的性能和可控性。
ControlNet加载器通常需要与ControlNet预处理器配合使用,这些预处理器可以对输入图像进行处理,提取出ControlNet模型所需的条件信息,如边缘检测、深度图生成等。(注意:使用预处理器的同时,也需要相同的ControlNet加载器模型)
ComfyUI内置了两种类型的ControlNet加载器:一种是普通的ControlNet加载器,另一种是DiffControlNet加载器。DiffControlNet加载器不仅支持普通的ControlNet模型,还支持diffusers格式的ControlNet模型,因此更为通用。使用时,需要根据所选择的基础模型(如SD1.5或SDXL)来匹配相应的ControlNet模型,以确保兼容性。
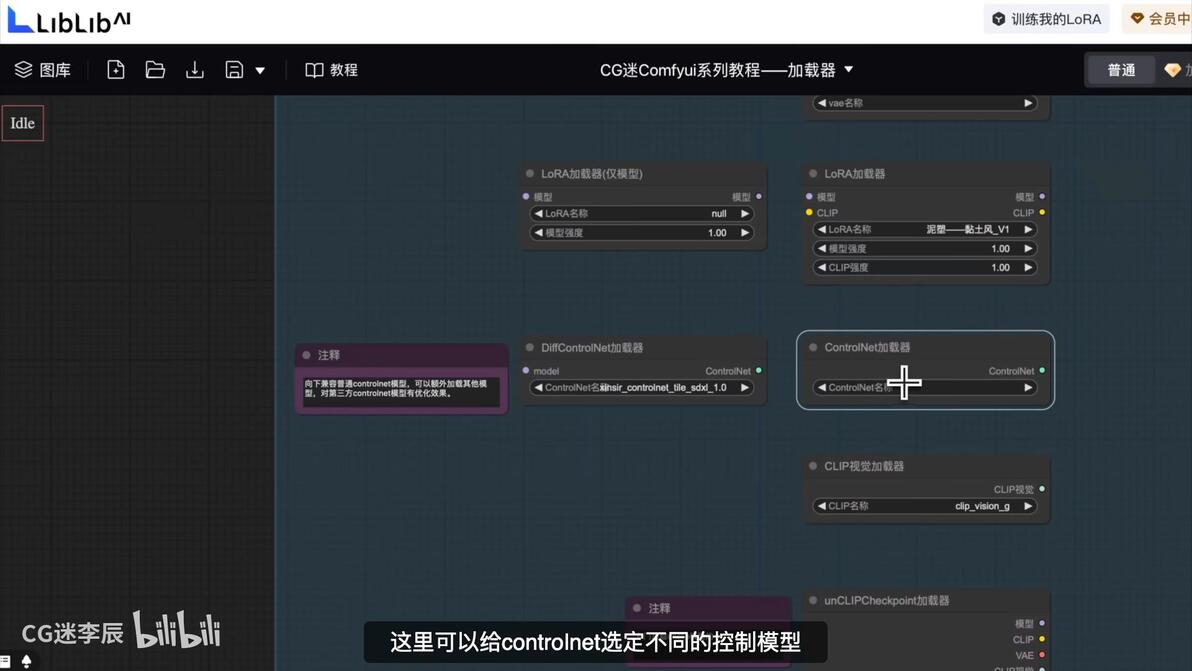
1、ControlNet加载器
eg:文生图工作流加载好一个ControlNet的深度模块。
(注意:这里是没有加载器的)
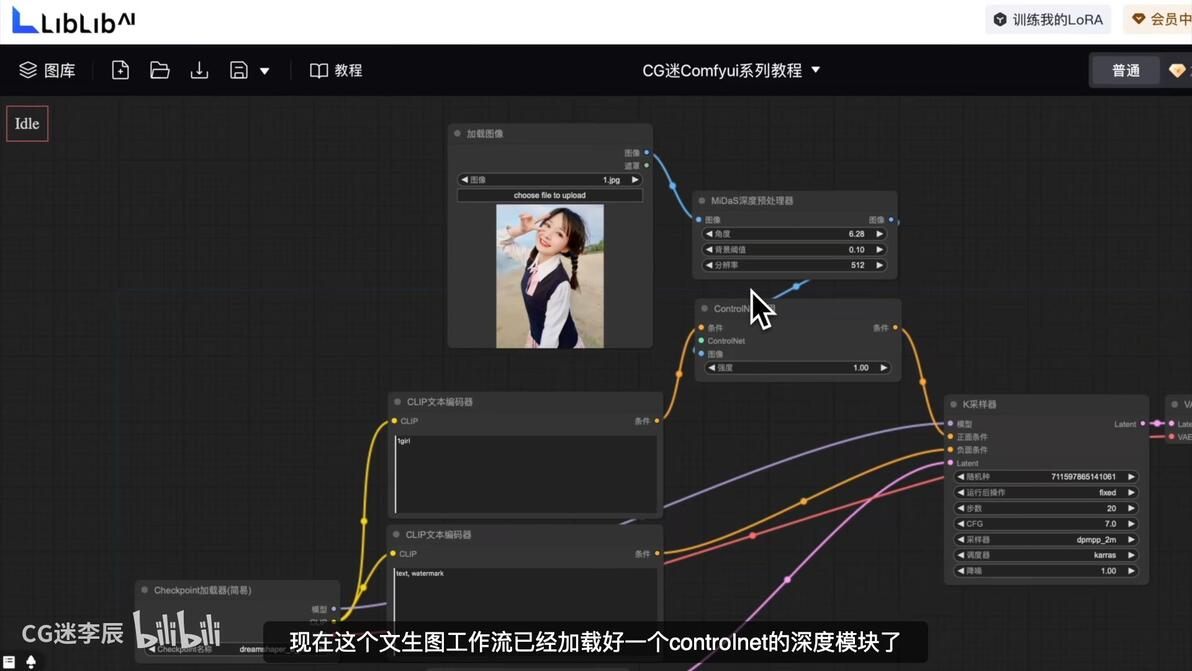
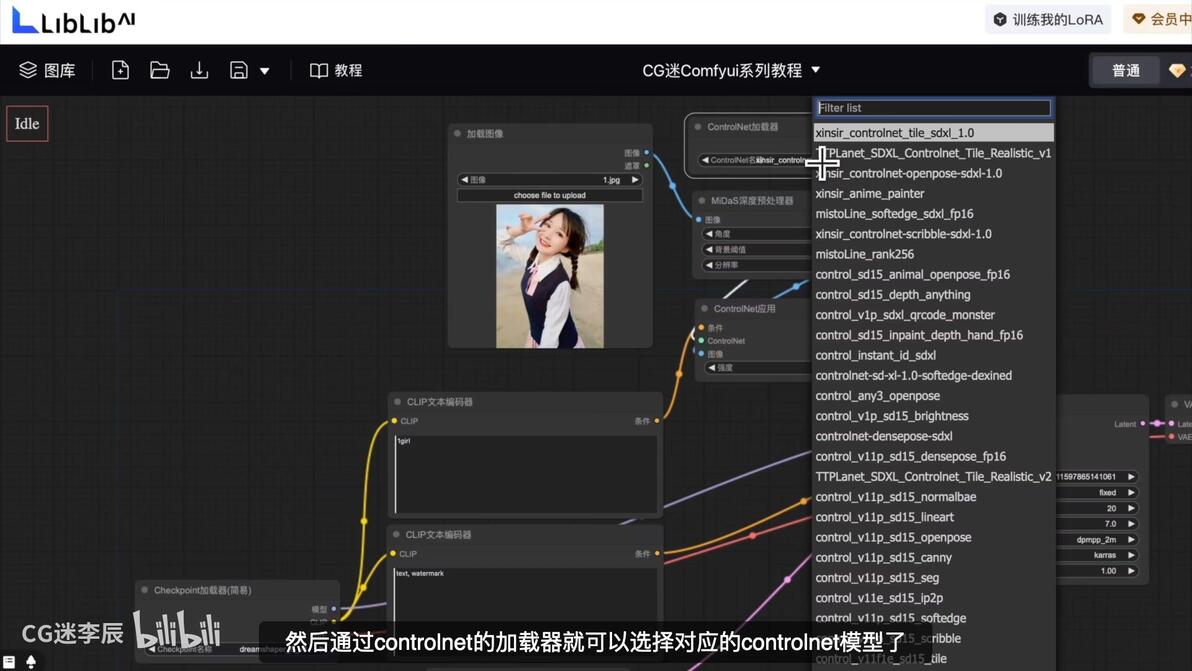
通过拖动ControlNet应用节点中的【ControlNet】,加载一个ControlNet加载器进来。
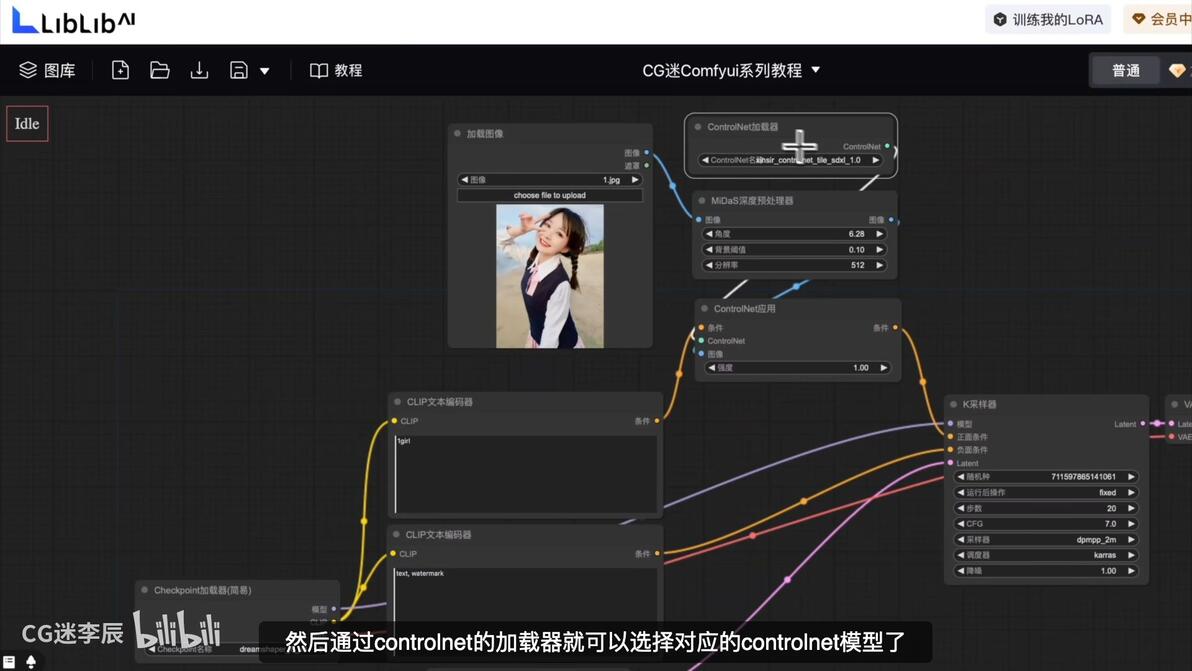
然后再ControlNet加载器中选择对应的ControlNet模型了。
2、DiffControlNet加载器
可以把DiffControlNet加载器看作ControlNet加载器的进阶版本。
它比ControlNet加载器多出了一个【modle】模型输入接口,可以额外指定模型的输入,对于部分第三方开发的ControlNet模型有一定的优化效果。
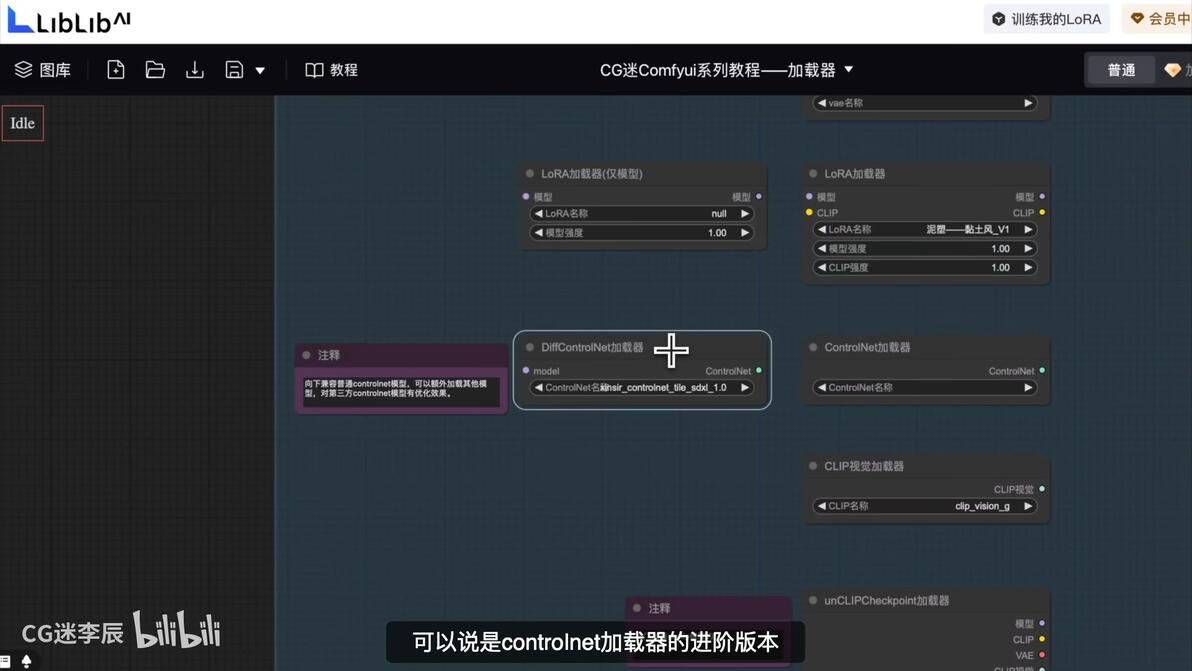
eg:文生图工作流加载好一个ControlNet的深度模块。
(注意:这里是没有加载器的)
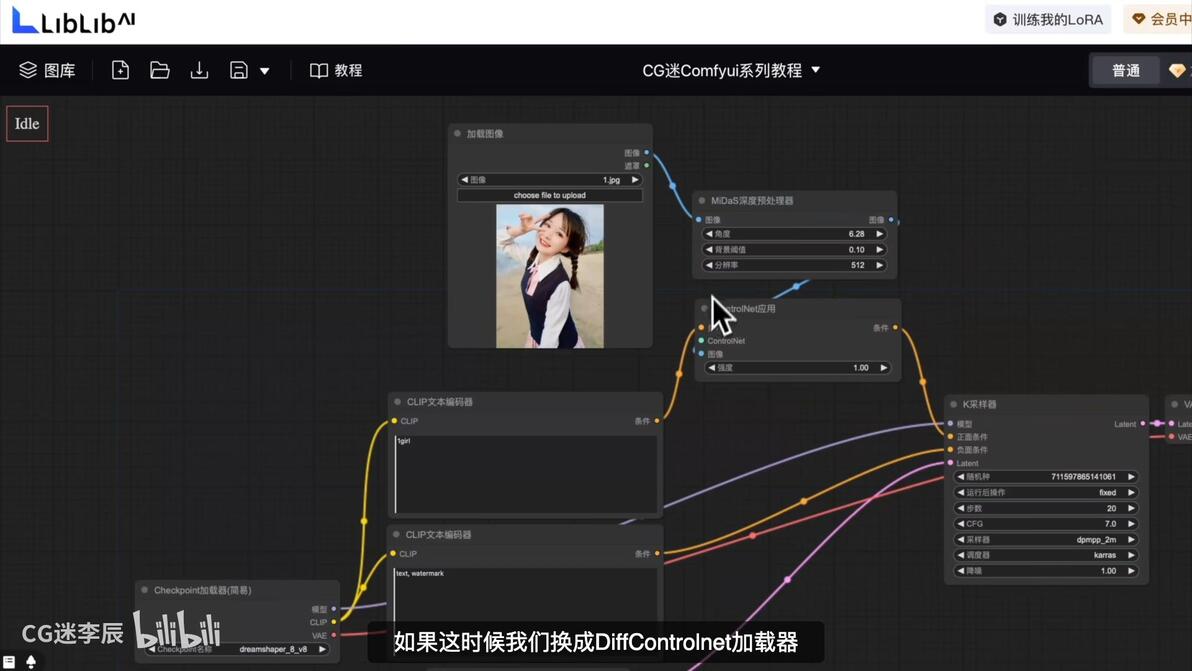
通过拖动加载DiffControlNet加载器
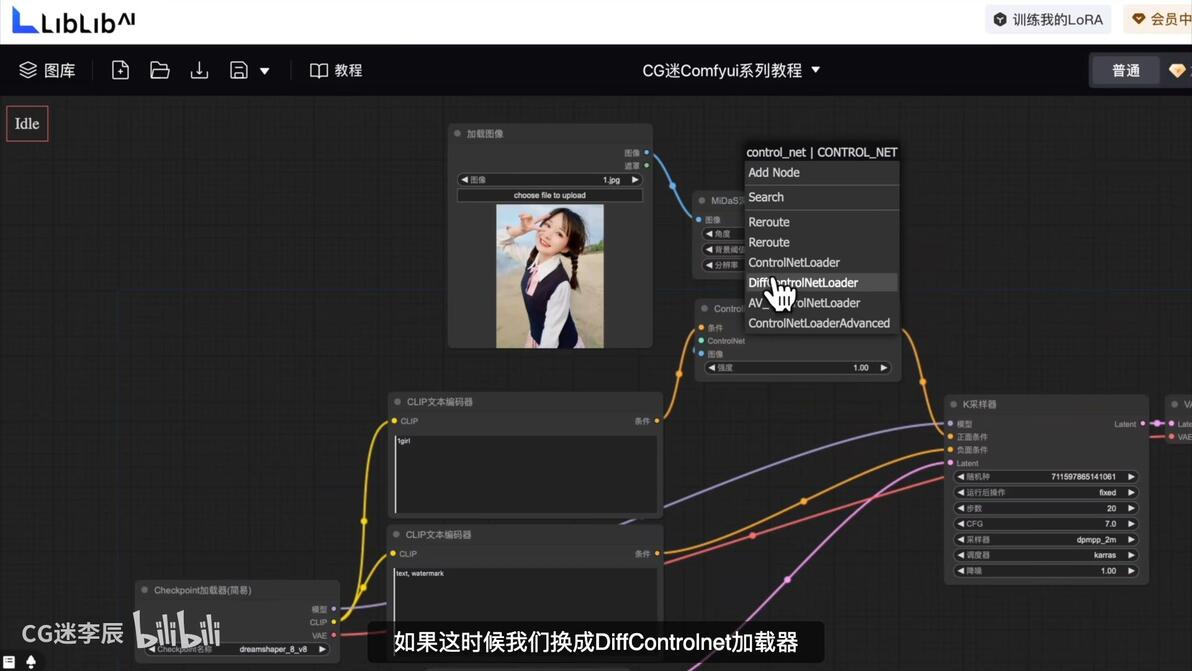
选择与预处理器相对应的模型。
由于第三方开发的模型,使用Dif发ControlNet加载器加载其模型会更好些,比如:腾讯开发的T2i深度控制器。
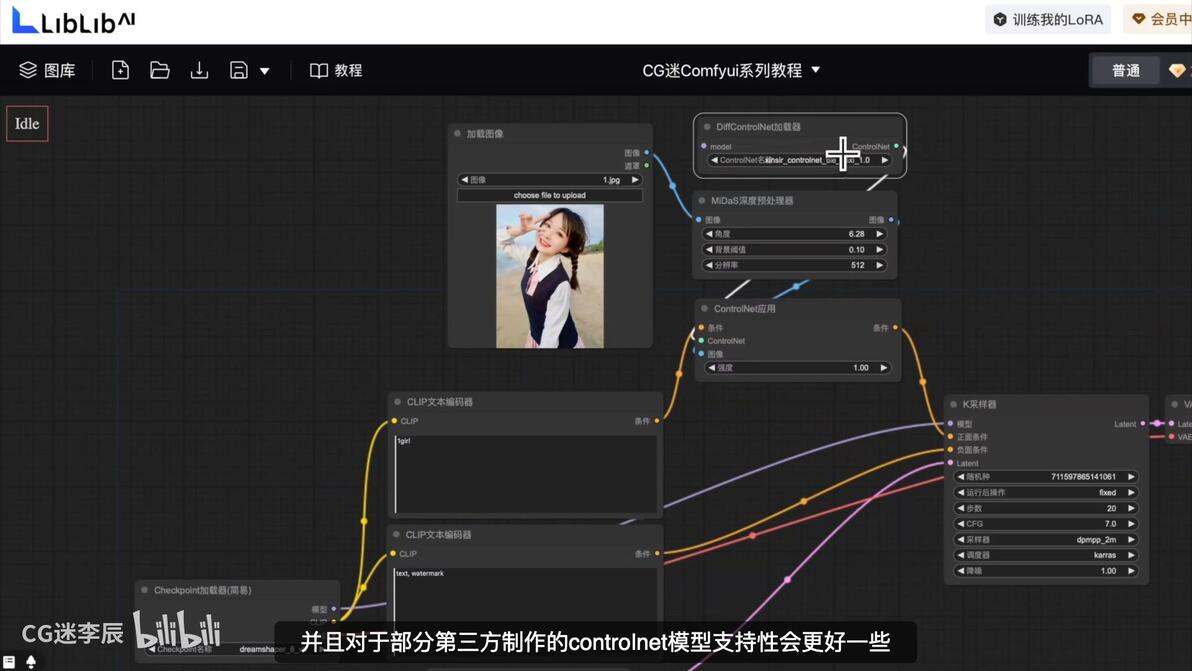
因为Dif发ControlNet加载器需要加载模型,把这个端口串联到大模型上就OK了。
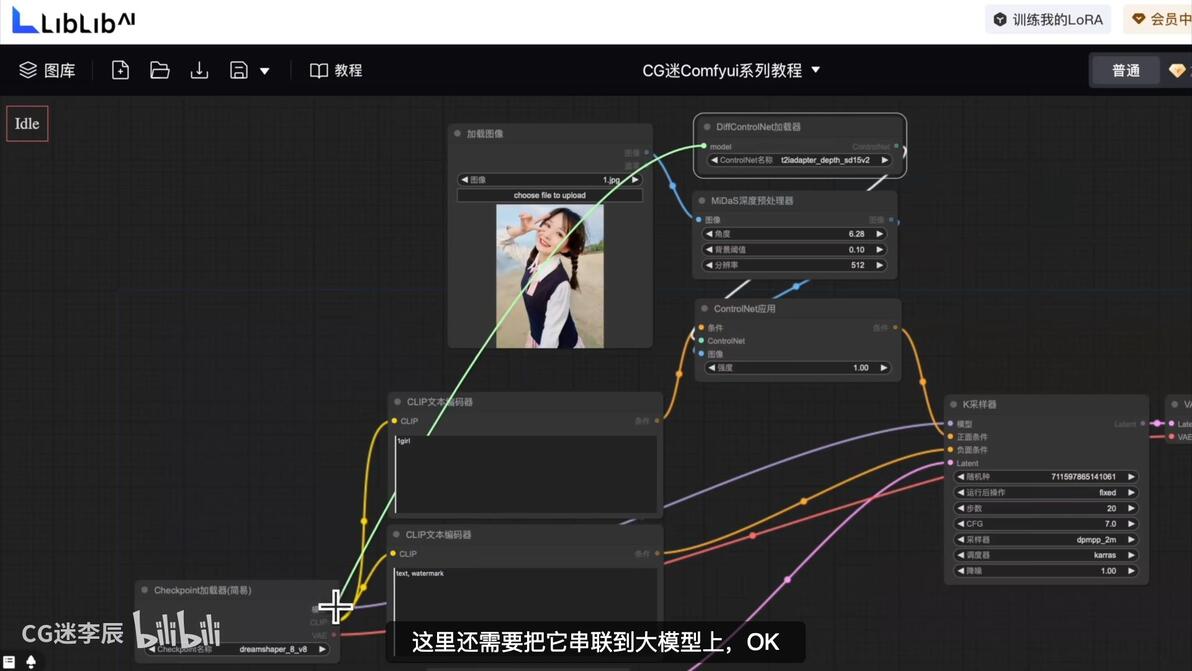
最后点击生成……
五、CLIP视觉加载器
CLIP视觉加载器(CLIPLoader)是一种高级加载器,用于简化和自动化CLIP模型的加载与配置过程。它通过抽象化模型加载和配置的复杂性,为用户提供了一种便捷的方式来访问和使用不同类型的CLIP模型,例如稳定扩散(stable diffusion)和稳定级联(stable cascade)。
CLIPLoader的主要功能是允许用户选择并加载特定的CLIP模型,这些模型对于各种AI艺术和图像生成任务至关重要。通过利用CLIPLoader,用户可以无缝地将强大的CLIP模型集成到他们的工作流程中,从而实现高级的文本到图像和图像到文本的能力。
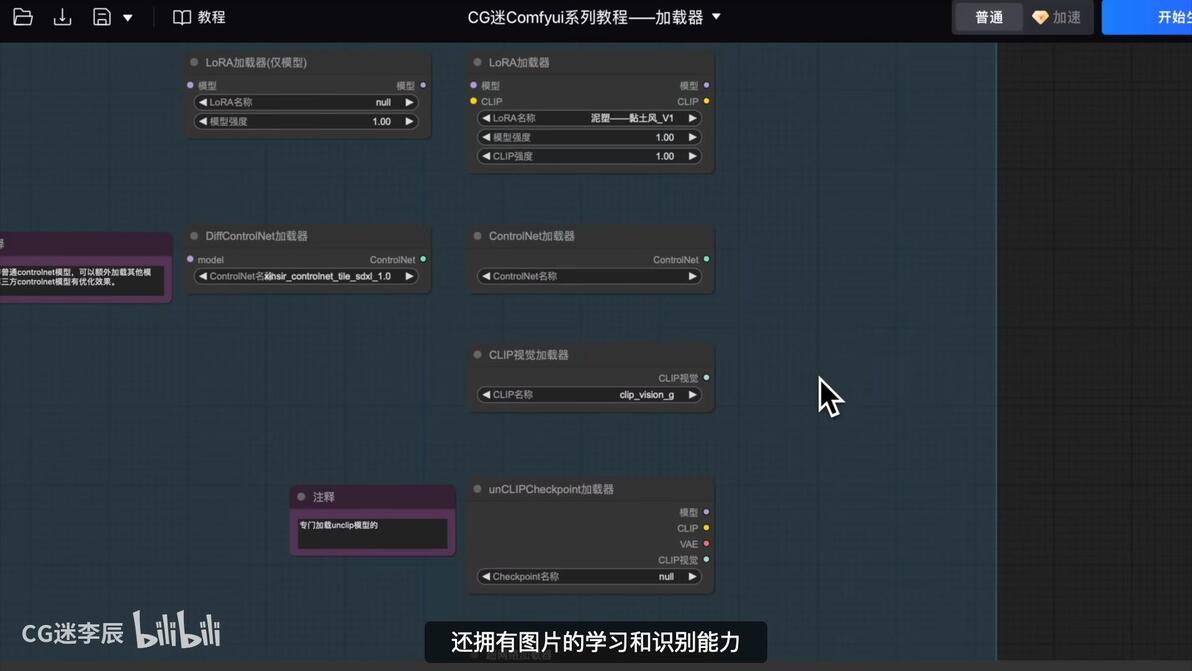
它除了可以连接视频接口外,还拥有图片的学习和识别能力。
eg:连接CLIP视觉编码
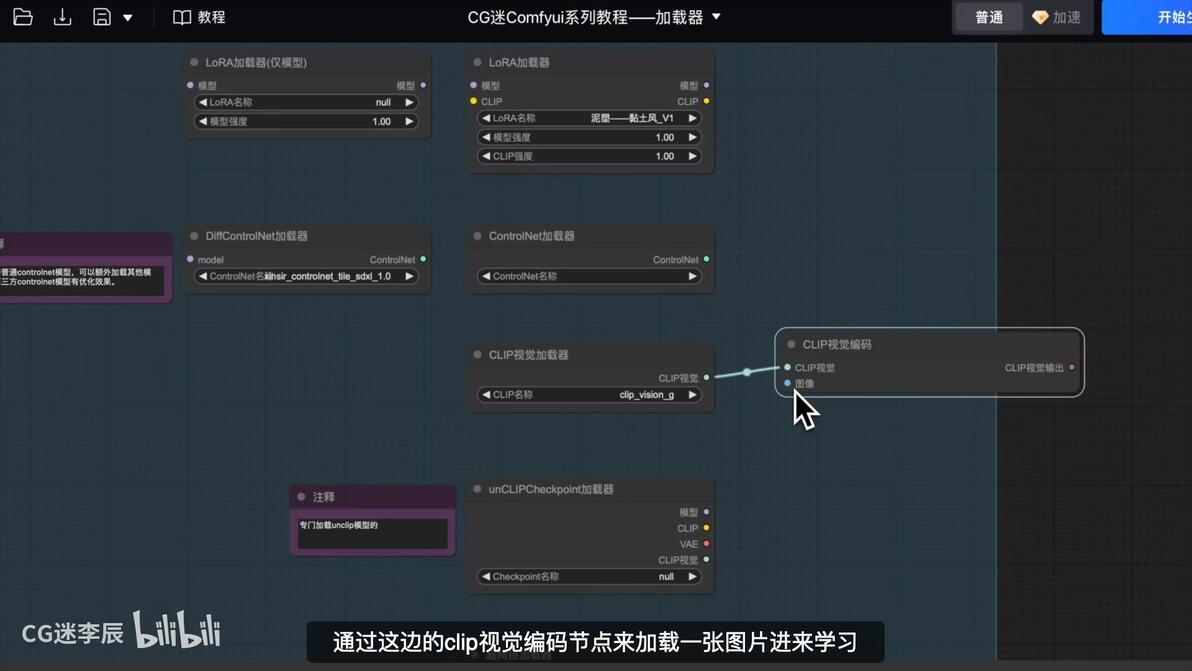
通过CLIP视觉编码节点来加载一张图片进来学习。
(后面第十点风格模型加载器中需要用到CLIP视觉加载器)
六、unCLIPCheckpoint加载器
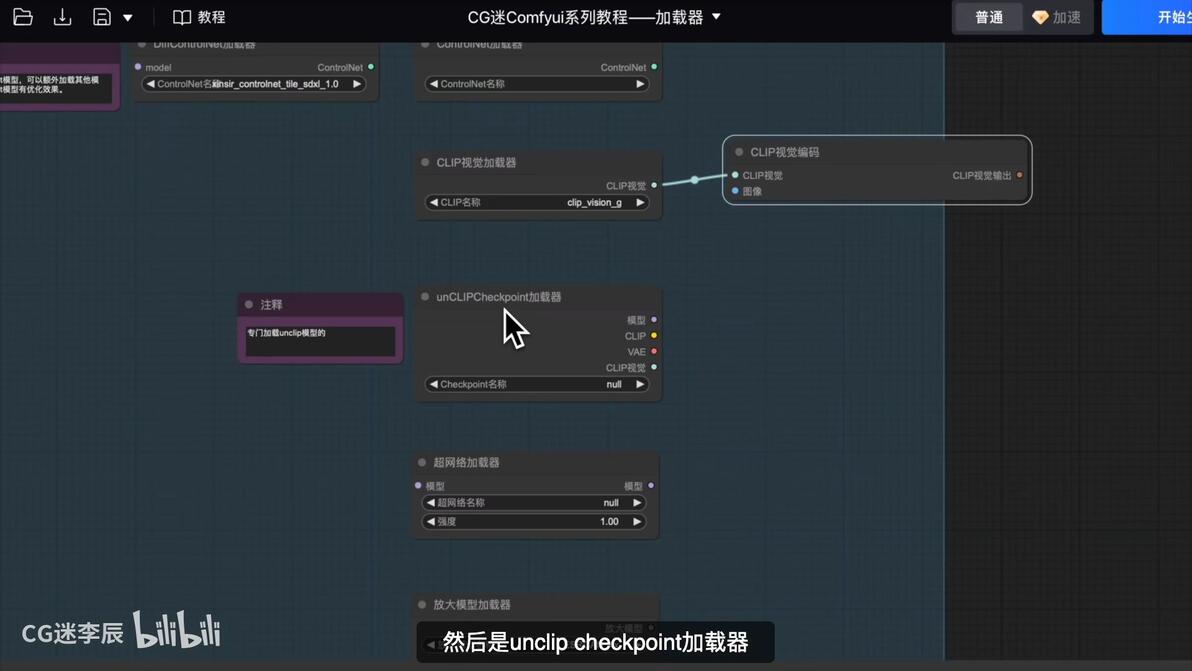
unCLIPCheckpoint加载器(unCLIPCheckpointLoader)是一个专门用于加载和初始化unCLIP模型的检查点的节点。这个节点的主要功能是简化unCLIP模型的初始化和分析过程,使得用户可以轻松地从指定的检查点中检索和初始化模型、CLIP视觉模块和变分自编码器(VAE)。
unCLIP模型是一种经过特殊调整的扩散模型版本,它不仅能够接收文本提示,还能通过CLIPVision编码接收图像概念作为输入。在采样时,模型会从图像中提取概念并传递给主模型,使用户能够在提示中直接使用图像。unCLIPCheckpointLoader节点正是为了支持这种功能而设计的,它允许用户在AI艺术生成任务中利用这些能力,提高生成图像的质量和多样性。
需要注意的是,并非所有扩散模型都与unCLIP兼容。
你也可以简单的理解为,一个可以学习(视觉模型)图像的大模型,通过图像概念去输出相应的模型数据,而不用输入晦涩难懂提示词使机器误判。
潜空间大模型通过将复杂数据压缩到低维空间,简化了数据处理和分析过程,提高了AI系统的效率和性能。
在Stable Diffusion模型中,潜空间用于将图像压缩到一个低维空间,从而减少计算复杂度和内存消耗。例如,一个512x512像素的图像可以被压缩成更小的维度,如(4,64,64),从而极大地减少了数据体积和内存占用26。这种方法不仅提高了运算速度,还降低了硬件要求5。
此外,潜空间在AI绘画和其他生成任务中也发挥着关键作用。通过将图片和文本数据压缩成关键特征的表示,并将文本标签转化为计算机能理解的形式,模型能够在潜空间中建立内部存储和处理这些数据的空间6。这种技术使得模型能够基于文本描述生成或理解图像内容。
我们平时用的大模型都是属于Latent Diffusion潜空间扩散大模型。
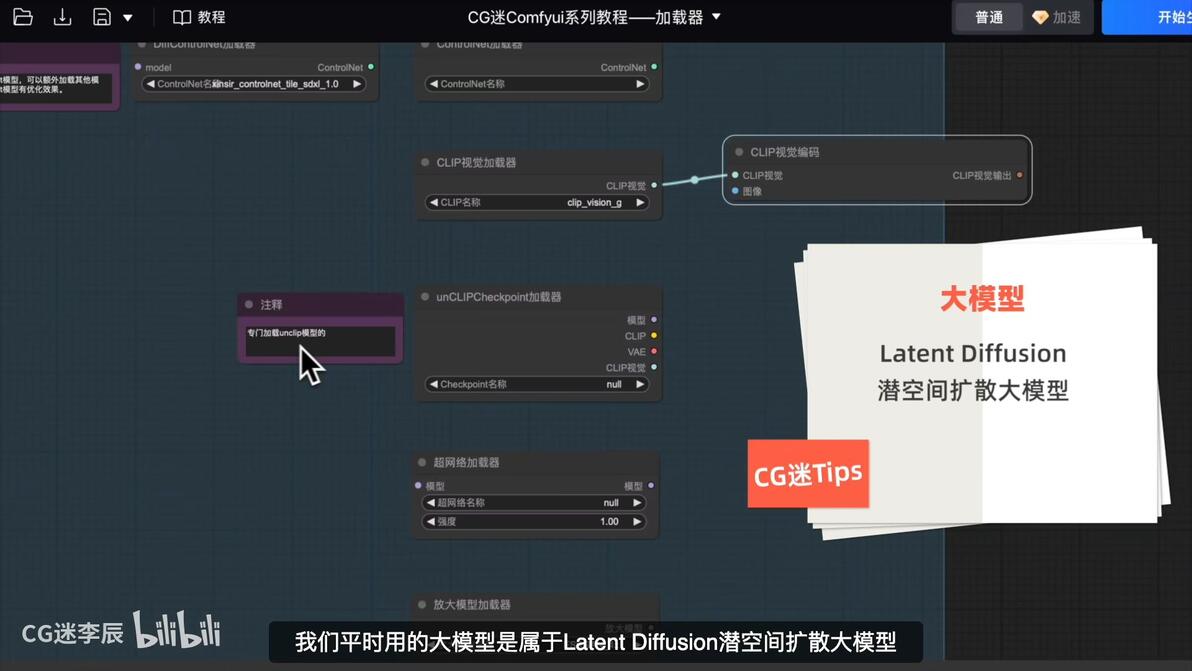
而还有一种大模型是unCLIP大模型
unCLIP大模型是一种基于CLIP(对比语言-图像预训练)和扩散模型的文本到图像生成系统。它由两个主要部分组成:一个先验模型和一个解码器。先验模型负责将文本特征转换为图像特征,而解码器则利用这些图像特征生成最终的图像。
七、GLIGEN加载器
GLIGEN加载器(GLIGEN Loader)是一个专门用于加载GLIGEN模型的节点。
GLIGEN模型在图像生成中的应用非常灵活,它允许用户通过文本提示精确控制图像中对象的位置和大小。
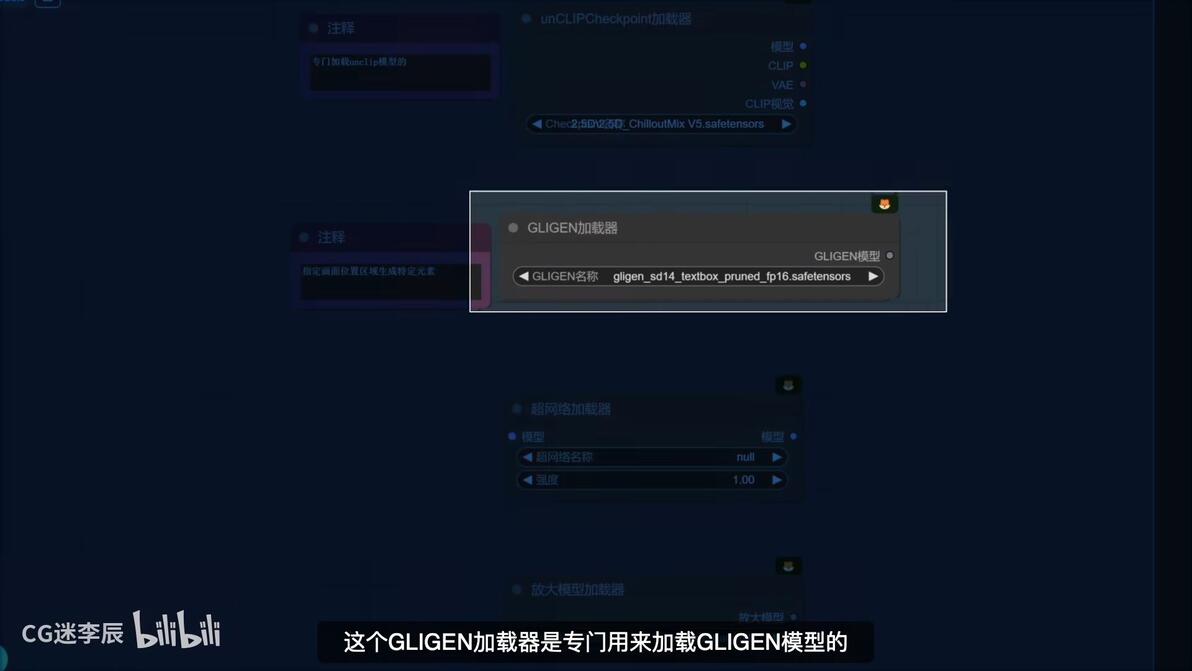
它可以指定画面的某个区域生成特定的内容。
eg:在文生图里面加入两个CLIGEN文本框应用节点。
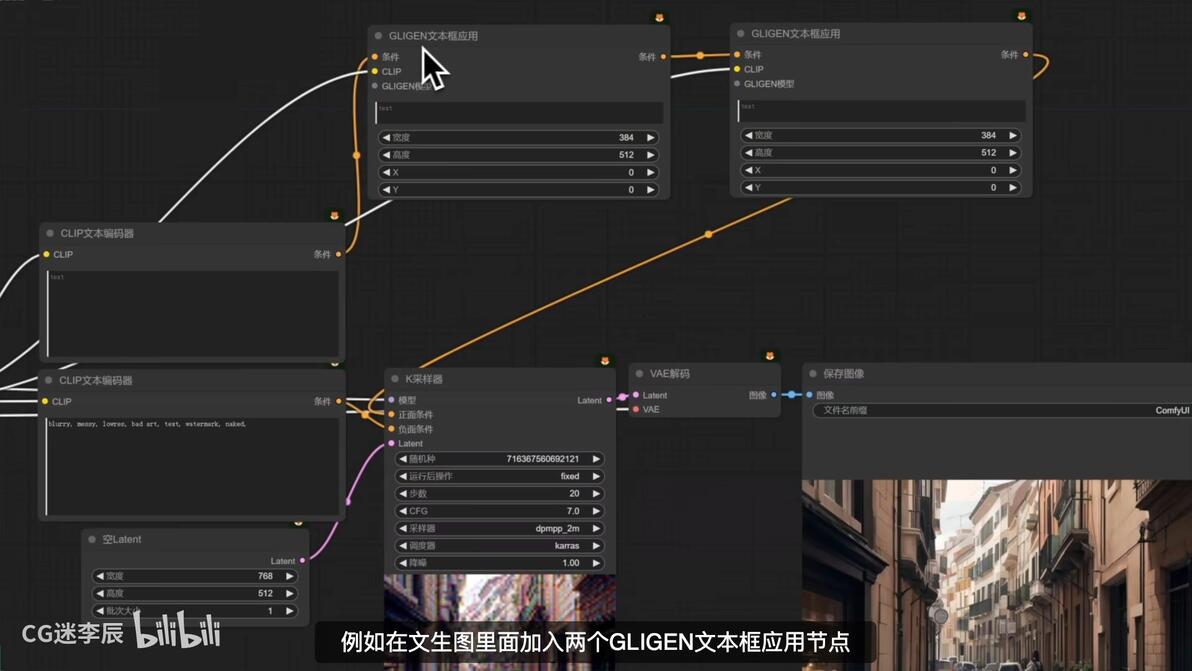
这两个文本框节点的宽度都设置为图像一半的大小。(原本图像大小:768*512,文本框节点的大小:384*512)
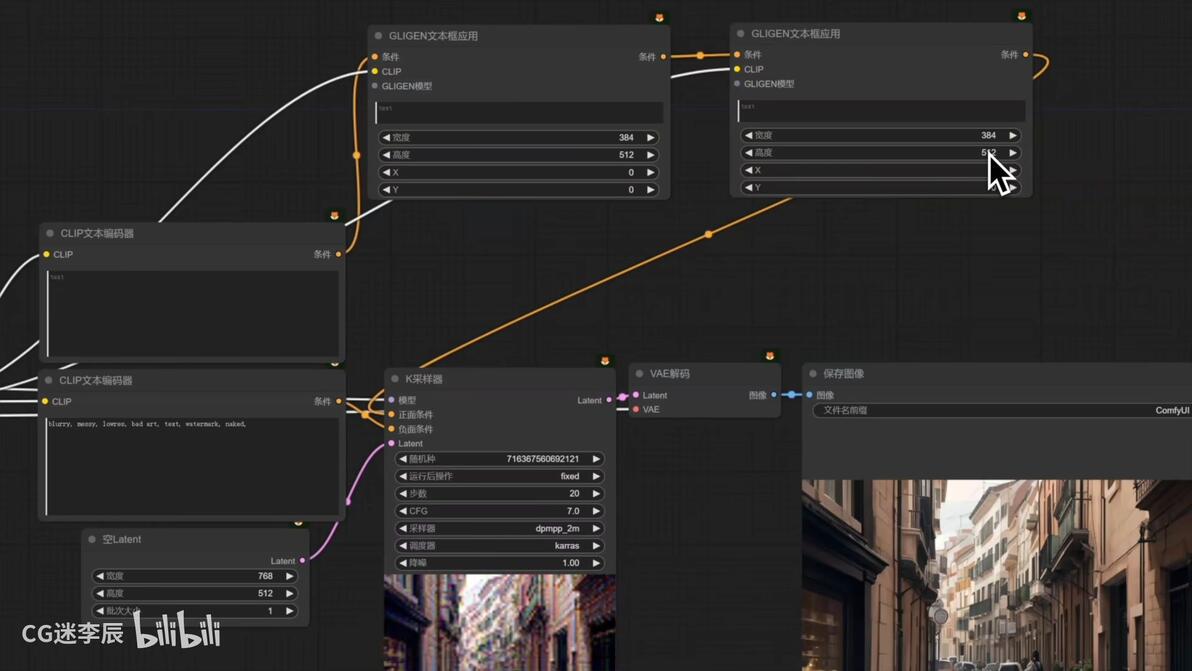
现在需要最终生成一张,左侧生成一个人,右侧生成一只猫。
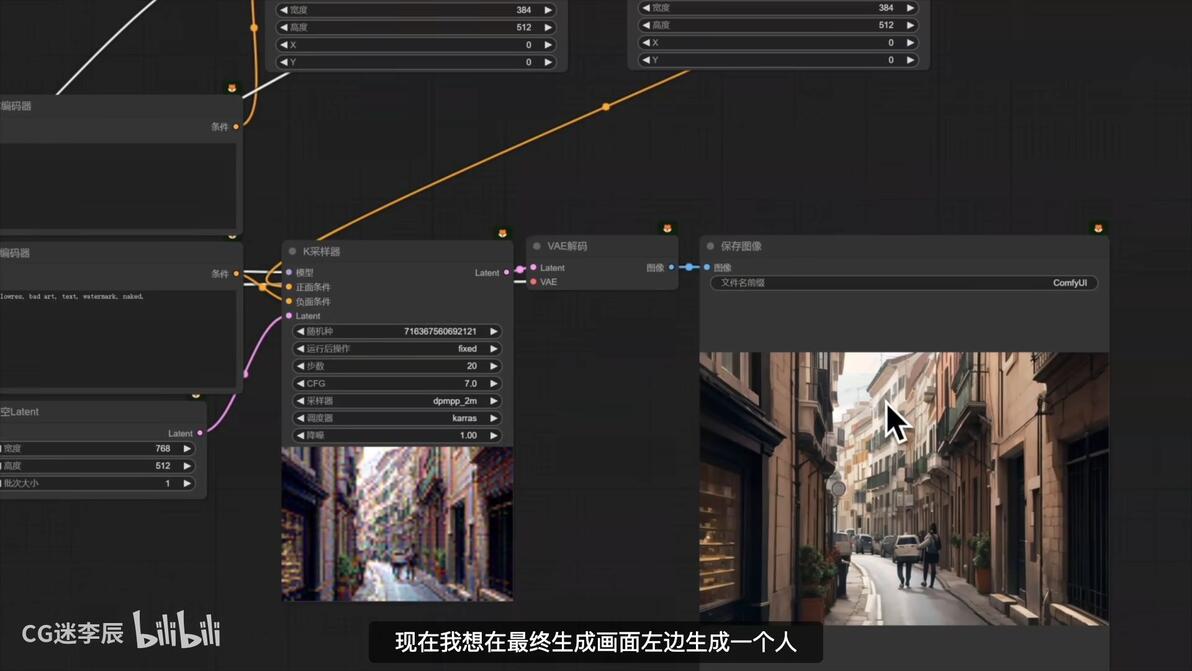
那么我们就需要在正向提示词中输入一个共同的场景提示词。例如街道。也就是先确定了最终生成画面的背景。
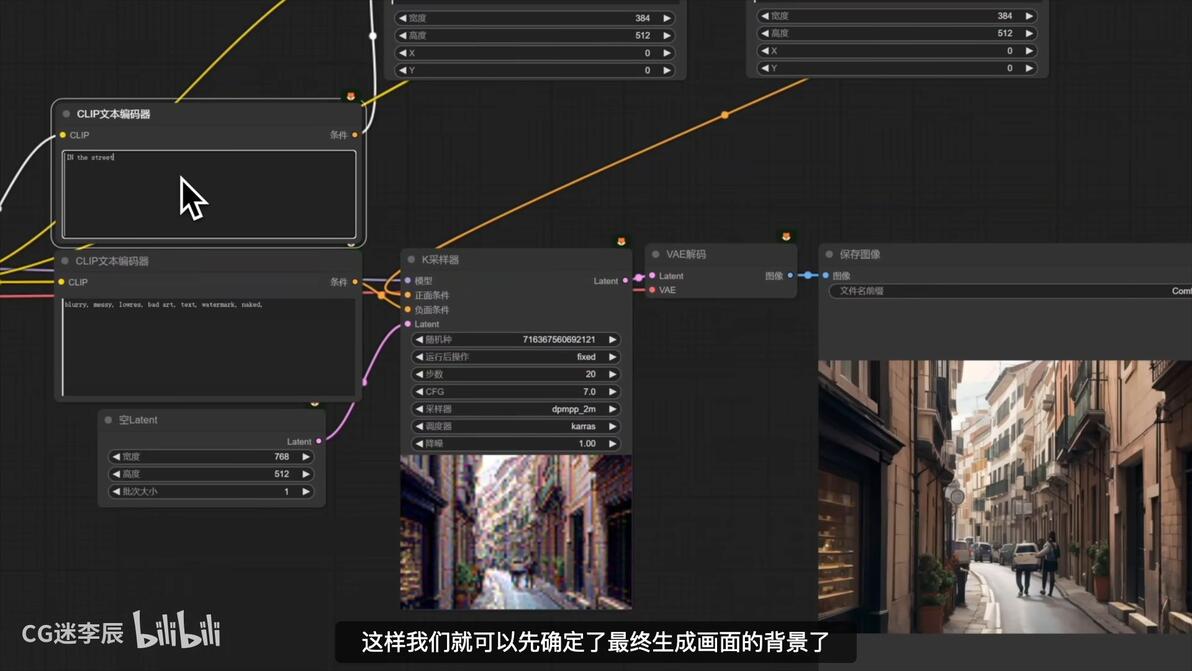
然后再左边这个GLIGEN文本框应用节点中输入1个女孩。右边GLIGEN文本应用节点中输入1只猫。
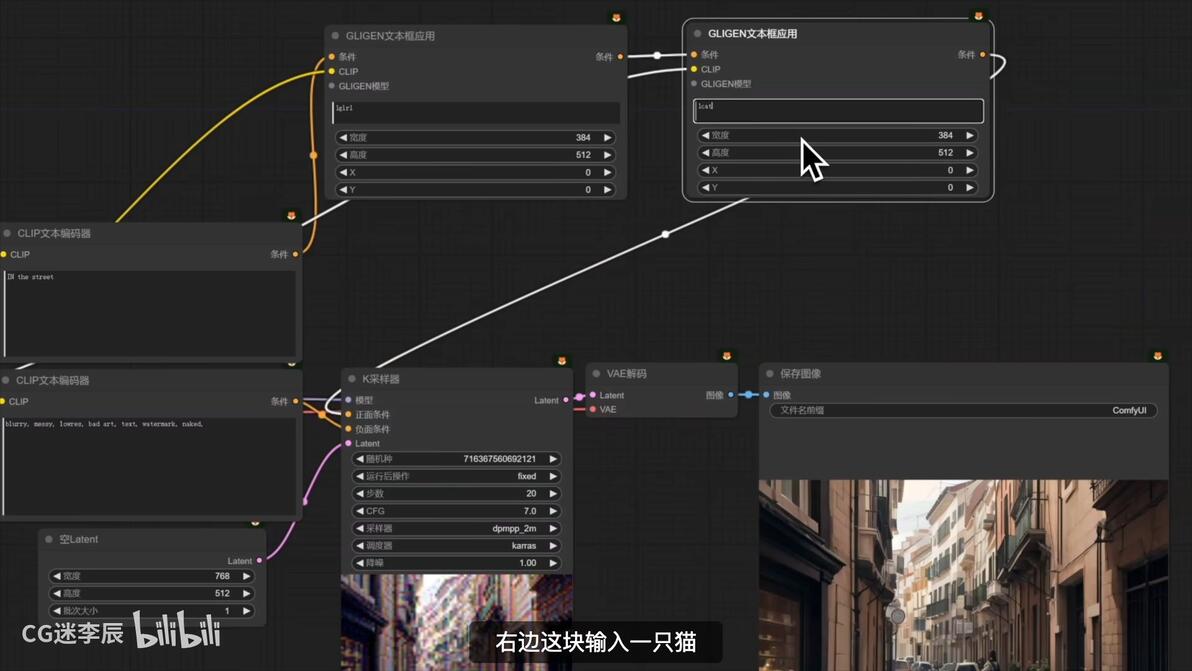
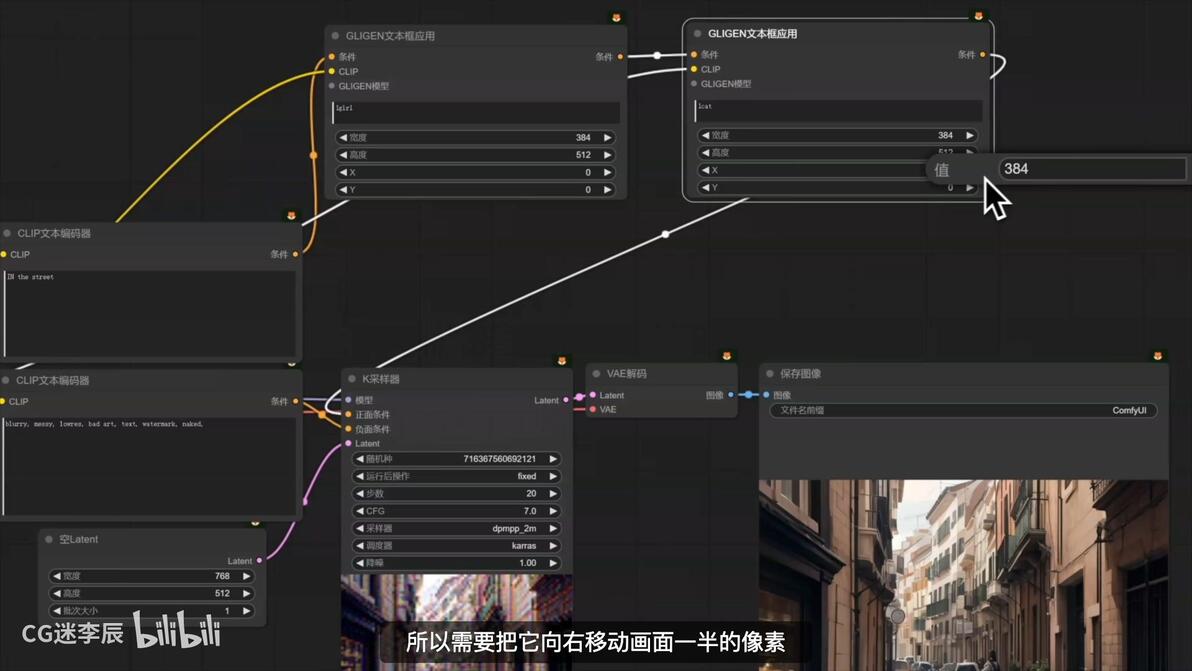
为了让这只猫去到右半边区域,就需要设置GLIGEN文本框应用节点的x,y值。所以需要设置x的值,向右移动画面一半的像素值。也就是384。
之后还需要加载GLIGEN加载器,连接到GLIGEN文本框应用节点中。选择相应的分区控制模型。(两个GLIGEN文本框应用节点都要连接。)

最终生成的效果图:

八、超网络加载器(hypernetwork模型)
在ComfyUI中,Hypernetwork模型是一种用于增强图像生成效果的工具。它通过在扩散模型的基础上新建一个神经网络来调整模型参数,从而控制图像的风格和细节。Hypernetwork模型可以应用于主模型上,起到类似于补丁的作用,因此需要将其放置在特定目录下,并通过Hypernetwork Loader节点进行加载和应用。
尽管Hypernetwork模型在效果上与LoRA类似,但由于其训练难度较大,应用范围相对较小,因此逐渐被LoRA所替代。

现在很少能使用到了。

九、放大模型加载器
放大模型加载器(Load Upscale Model)是一个用于从指定目录加载放大模型的节点。这个节点的主要功能是检索和准备放大模型,以便用于图像放大任务。
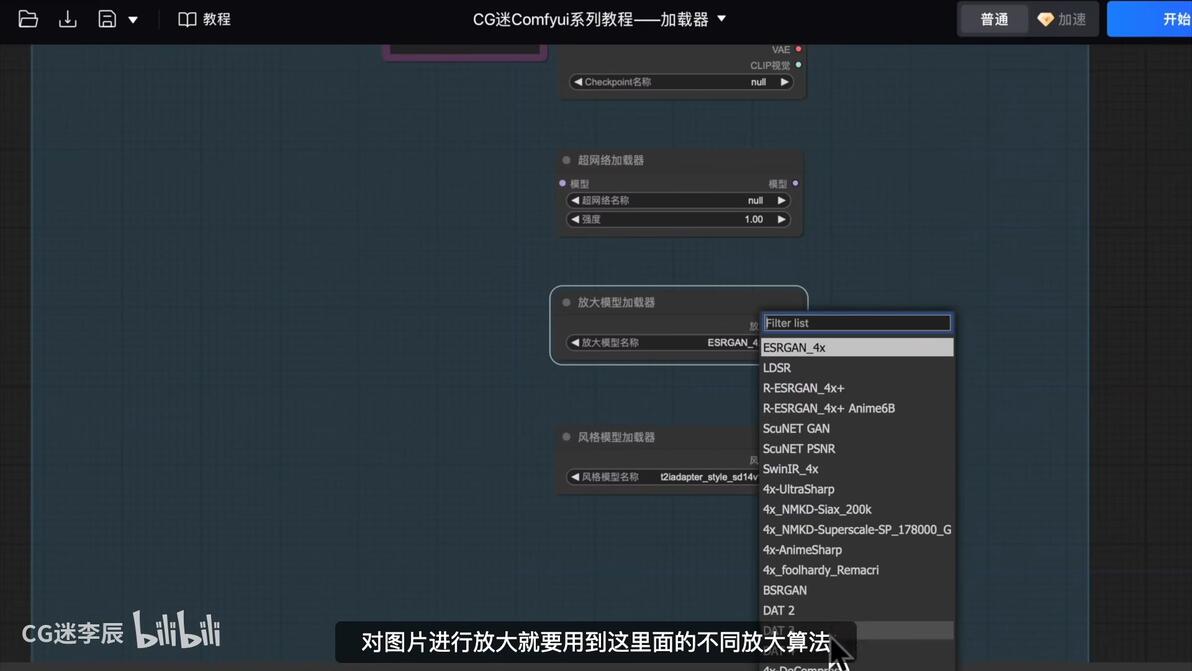
而放大模型是一种用于图像放大的技术,通过使用深度学习算法来增强图像的细节和清晰度。放大模型通常被用于将低分辨率的图像转换为高分辨率的图像,同时尽量保留或增强图像的细节。
根据提供的信息,ComfyUI中的放大模型可以分为几种类型:
1. 模型放大(Model Upscale) :这种方法直接在图像空间中应用放大算法,通过增加像素点来扩大图像尺寸。虽然这种方法简单快速,但可能会导致细节损失和图像质量下降。例如,使用BSRGAN、ESRGAN等模型进行放大,这些模型能够提升图像的分辨率并增强细节。
2. 潜在空间放大(Upscale Latent) :这种方法在图像的潜在空间中进行操作,通过缩放潜在特征并重新采样来增加细节。这种方法通常比模型放大更复杂,但能更好地保持图像质量。
3. 分块放大(Block Upscale) :这种方法将图像分割成小块,分别进行放大处理,然后重新组合成完整的高分辨率图像。这种方法适用于大尺寸图像,可以有效利用有限的显存。
4. UltimateSDUpscale插件:这是一个集成解决方案,结合了模型放大和分块放大的优点,简化了细节修复和放大过程。
十、风格模型加载器
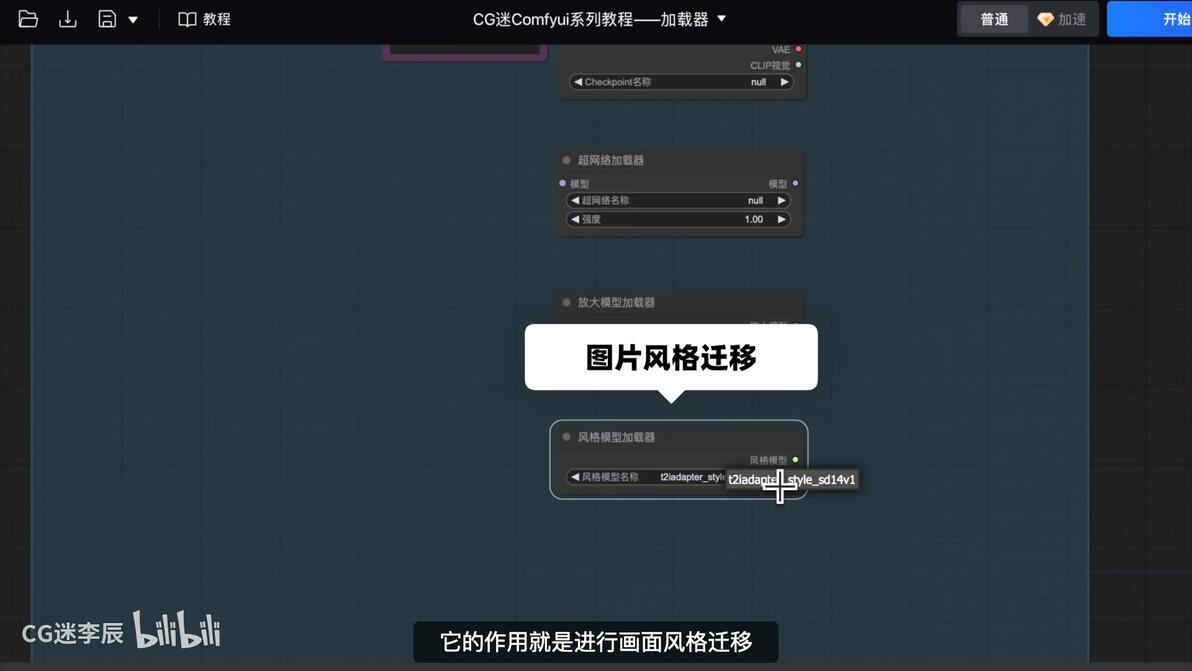
风格模型加载器是一种用于从指定路径加载和初始化风格模型的工具。其主要功能是检索和初始化特定艺术风格的模型,允许用户根据需求动态加载不同的风格模型,以便将这些风格应用于图像,从而实现视觉输出的定制。
使用风格模型加载器可以简化风格迁移的过程。例如,通过加载特定的风格模型,用户可以在生成图像时应用该模型所定义的艺术风格,从而实现更加丰富和多样化的视觉效果。此外,该加载器还支持与CLIP视觉模型结合使用,以提供更精确的视觉指导,帮助扩散模型生成符合预期风格的图像。
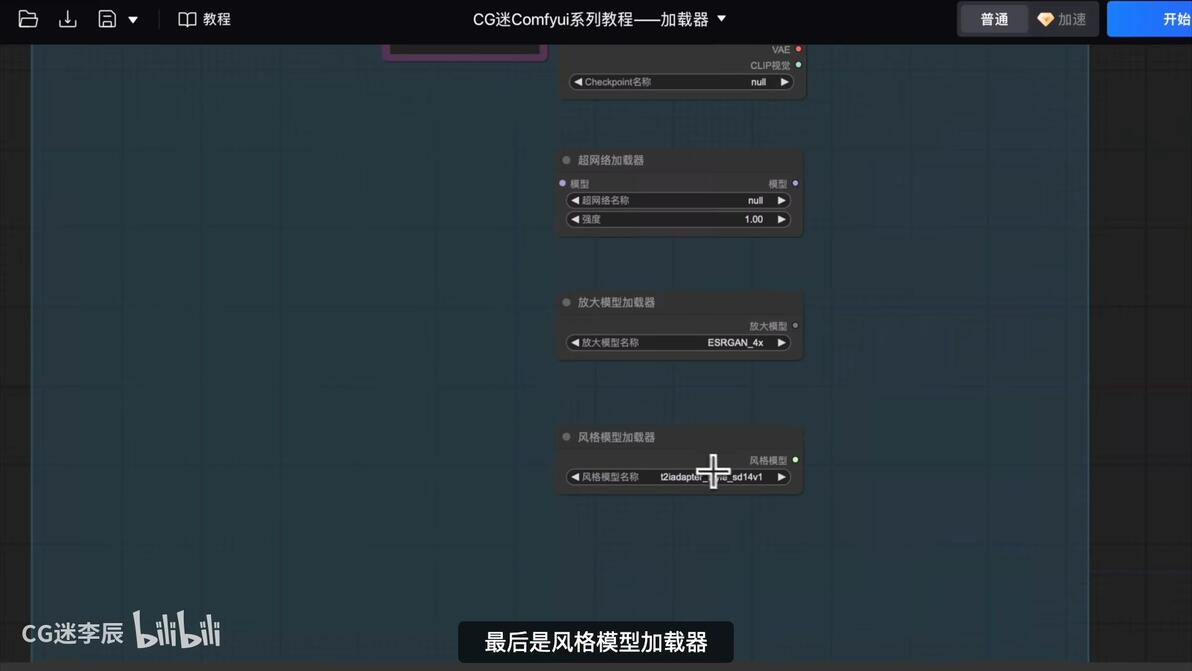
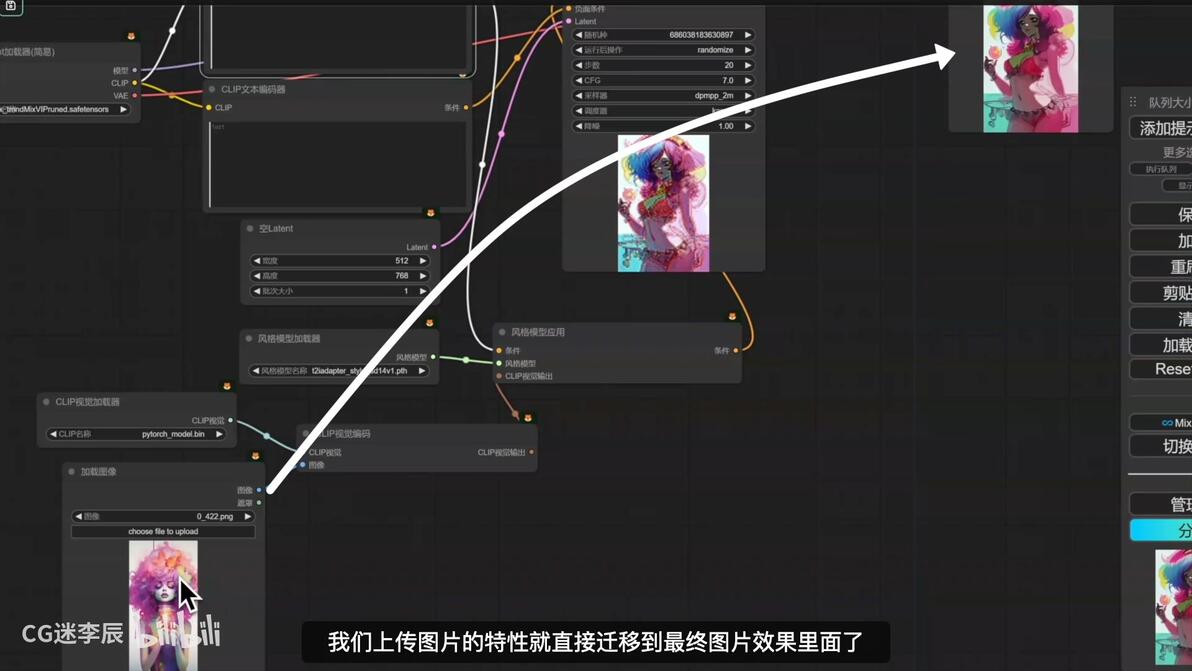
风格模型加载器的作用就是进行画面风格迁移。
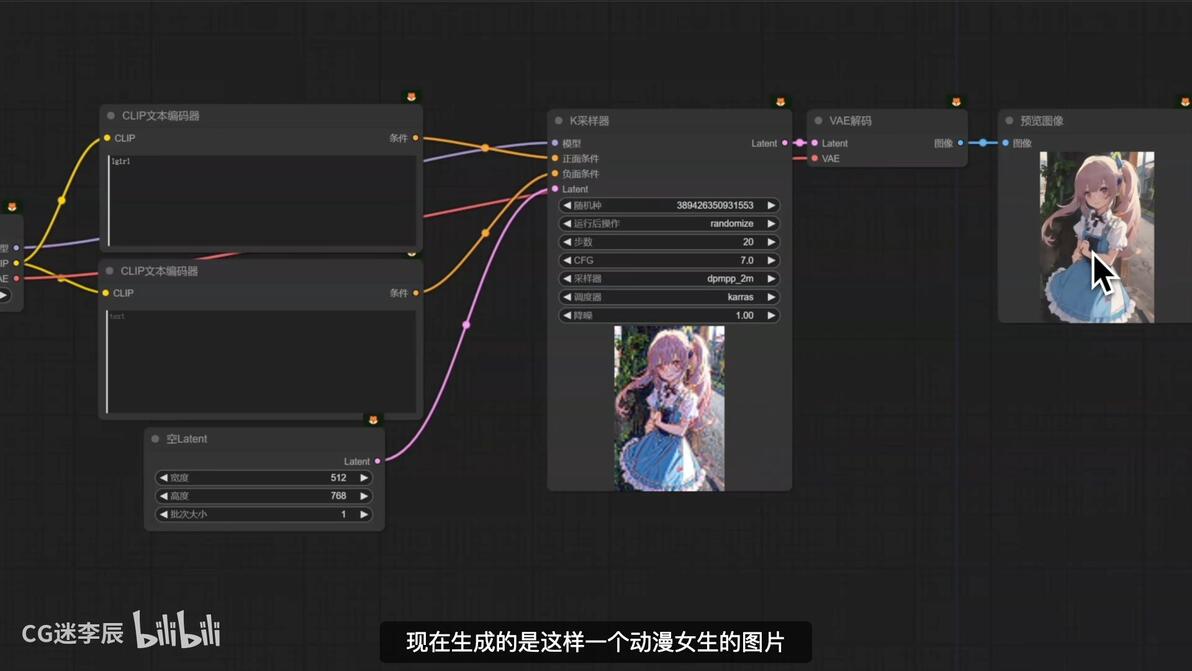
eg:在标准的文生图工作流中添加一个带有风格模型加载器的工作流。
现在生成的是这样一个动漫女生的图片。
先添加一个风格模型应用节点出来
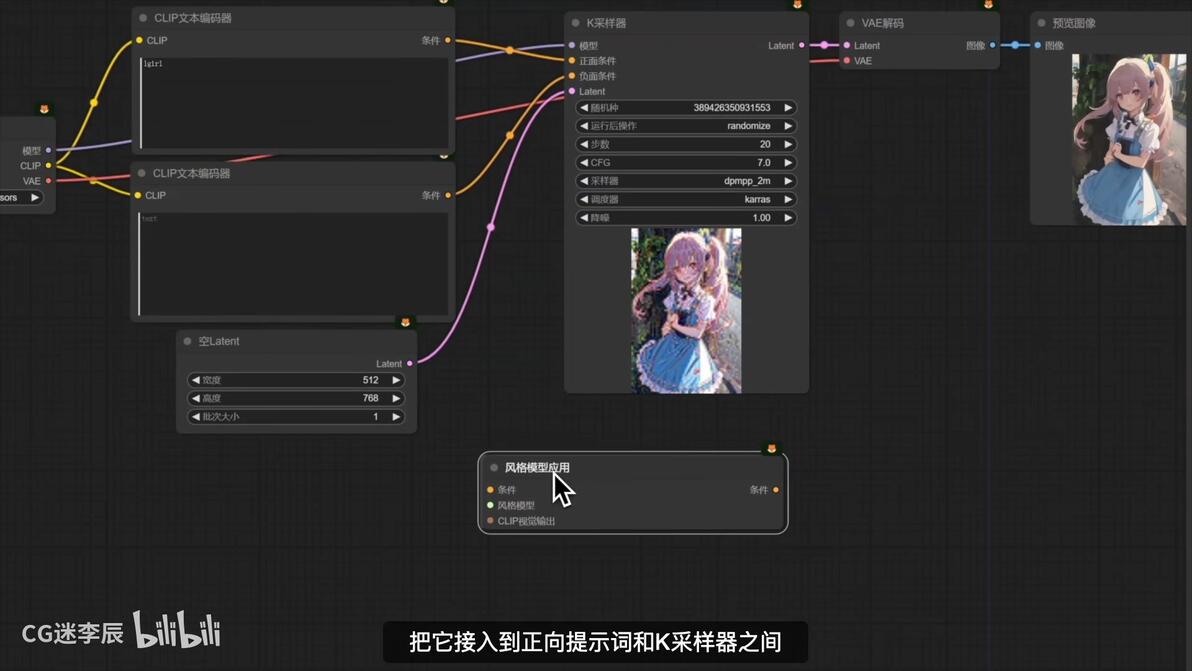
把它接入到正向提示词和k采样器之间
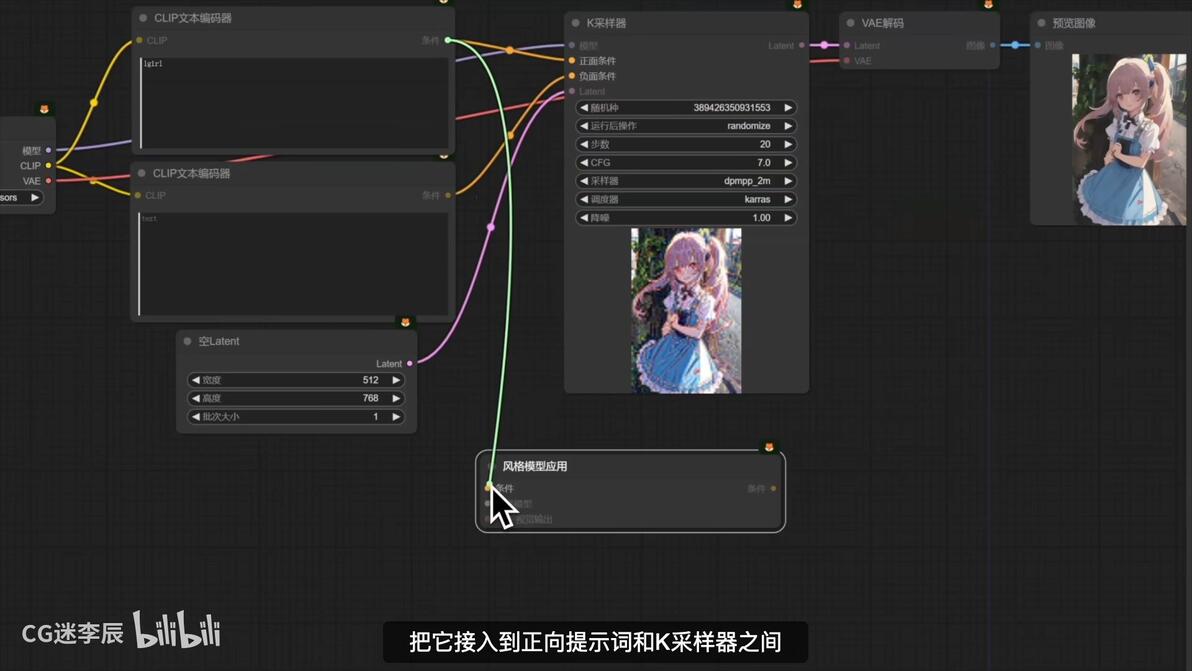
然后【风格模型】端口就需要连接风格模型加载器了。
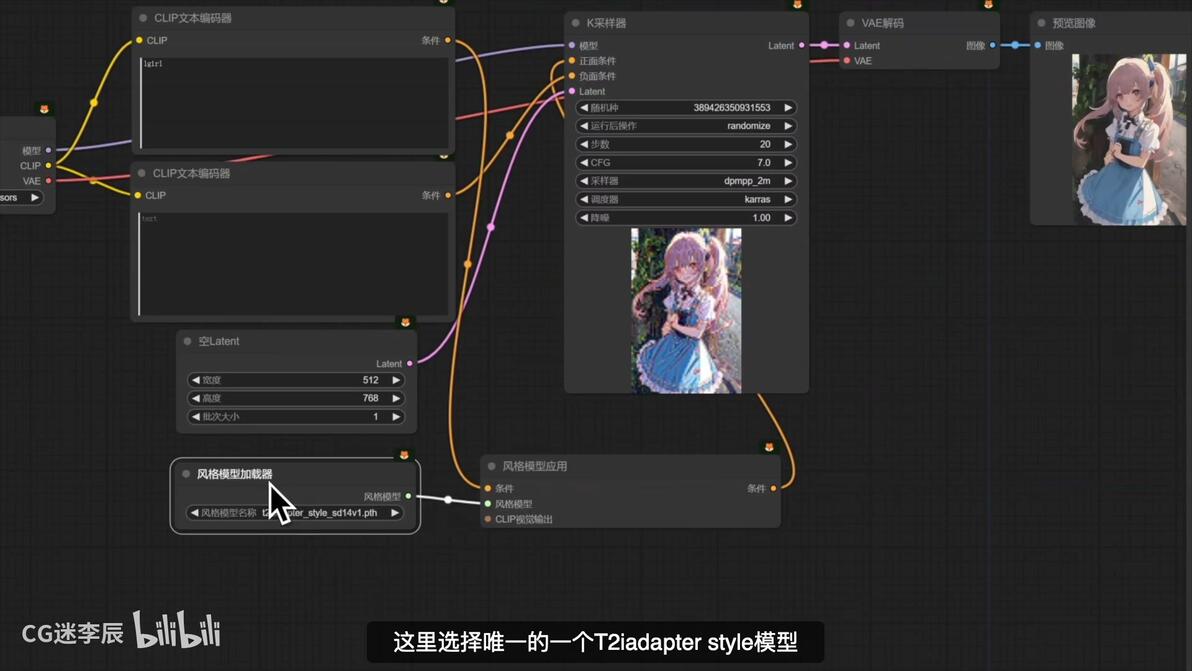
在【CLIP视觉输出】端口接入一个CLIP视觉编码节点。
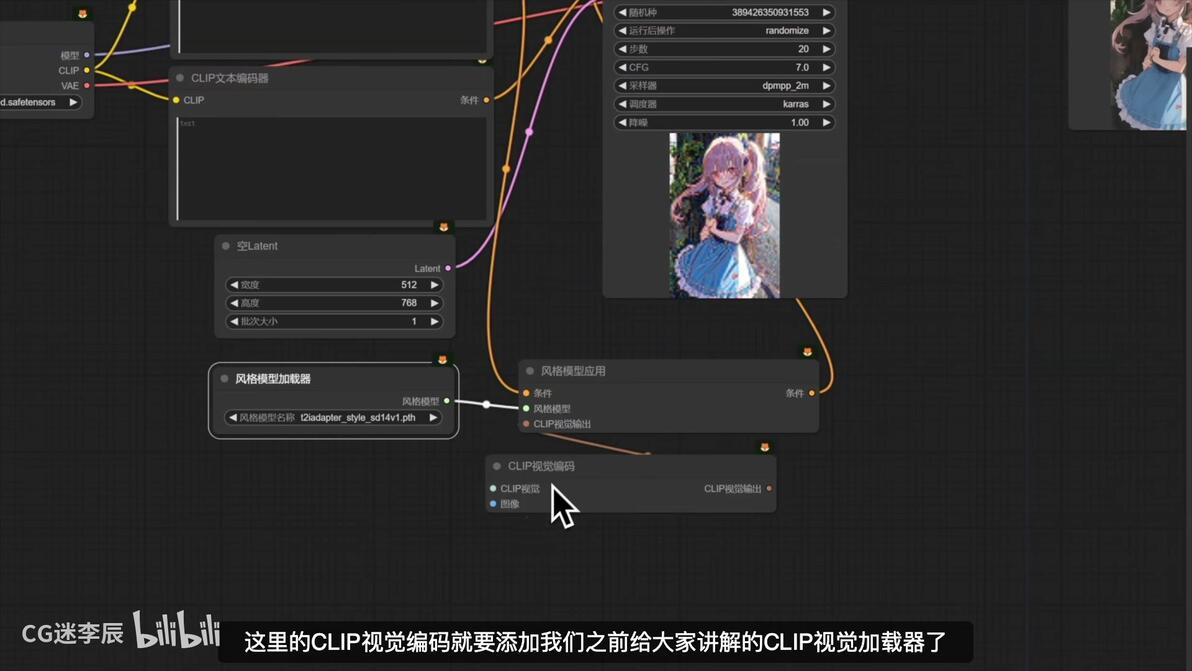
而这里的CLIP视觉编码就要添加CLIP视觉加载器了。
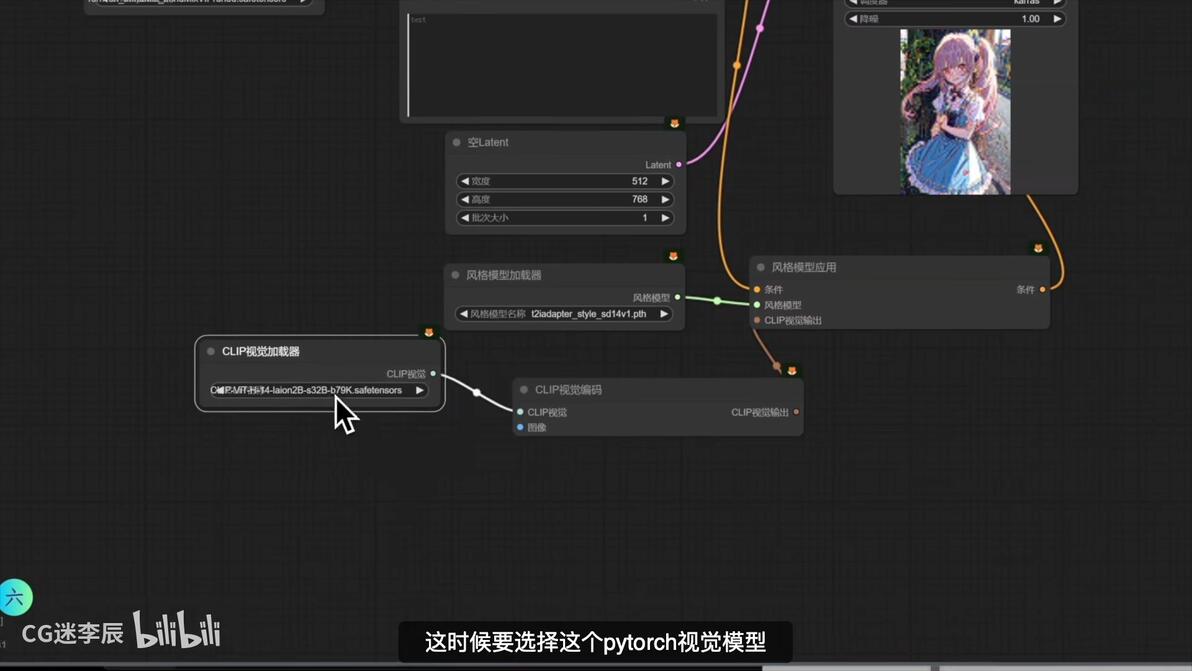
然后选择视觉模型,通过这个视觉模型来学习图片的特征。
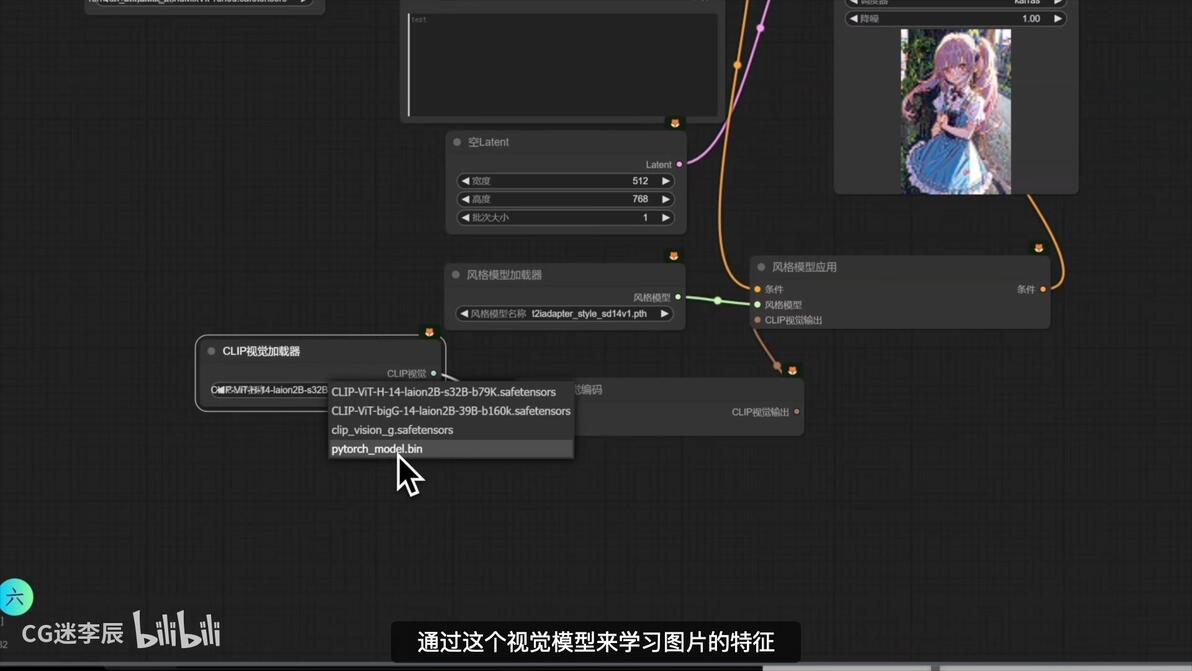
所以在图像节点加载一张图片进来,去学习这张图片的特征。
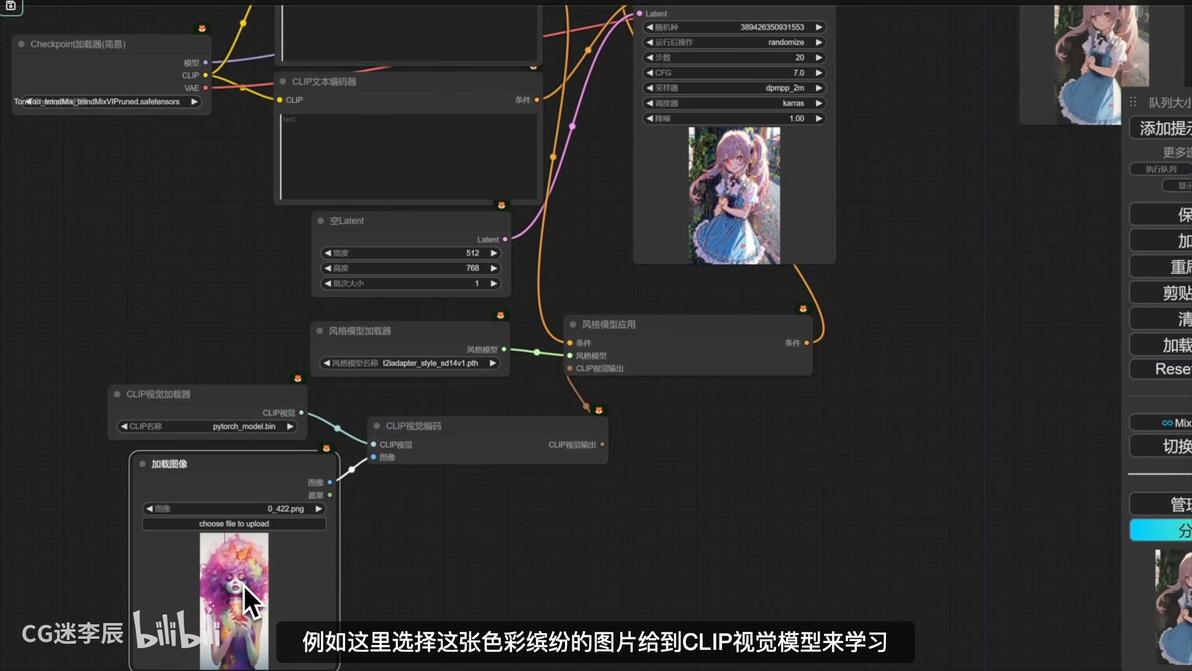
CLIP视觉编码通过学习了图片的特征,然后风格模型把这个图片的特征传输到k采样器来生成图片,从而应用到最终生成的图片上。
(而且这个时候提示词仅仅只有一个1girl,没有其他的提示词了)
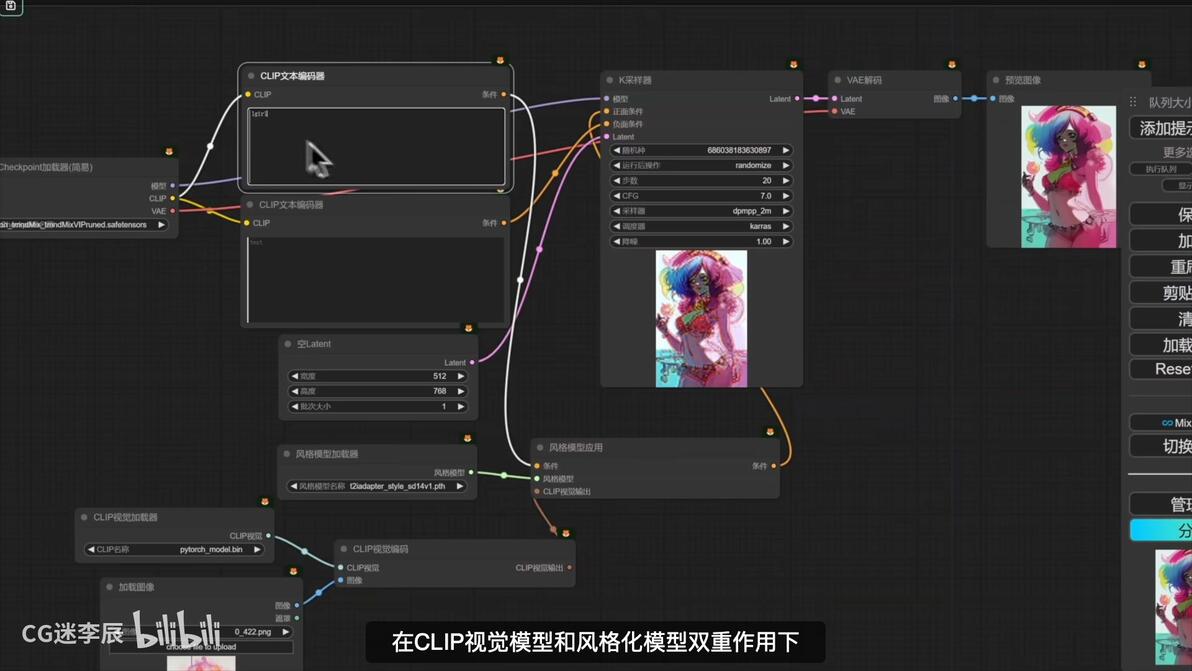
在CLIP视觉模型和风格化模型双重作用下,我们上传图片的特征就直接迁移到最终图片效果里面了。