


作者简介:程昌茂,旷视科技上海研究院算法研究员,硕士毕业于复旦大学。研究方向为深度特征表示学习。
深度特征学习一直受到学术界的广泛关注,研究者们使用了众多的损失函数来学习好的特征表示。例如,用于分类学习的 softmax cross entropy loss 及其变种 AM-Softmax(CosFace)、ArcFace 等,用于样本对距离优化的 contrastive loss 和 triplet loss 等。
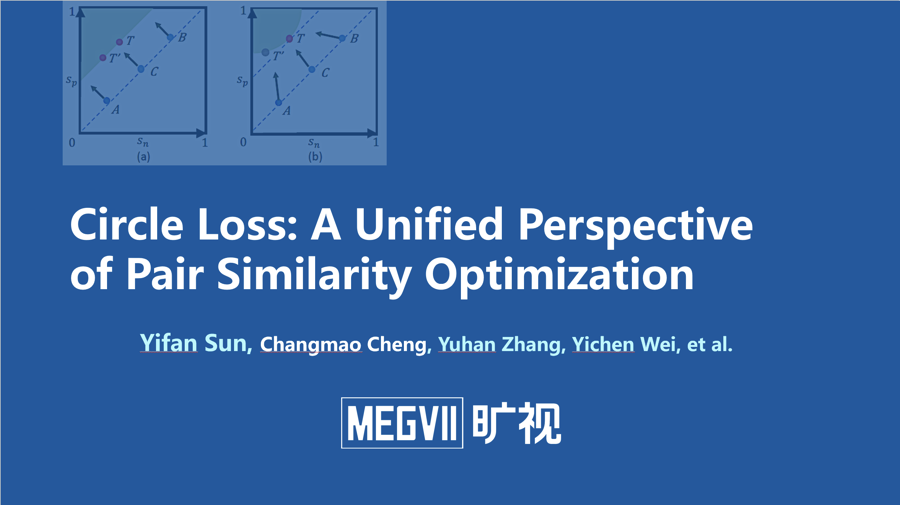
本文讲解了作者所在团队在这一问题上的研究工作 Circle Loss: A Unified Perspective of Pair Similarity Optimization (CVPR2020 Oral)。该工作从对相似性优化的统一视角解读深度特征学习:当前的多数损失函数(包括 softmax cross entropy loss 和 triplet loss)将类内相似性 Sp
和类间相似性 Sn配对并减小二者的差值 Sn-Sp。进一步,这样的优化方式是不够灵活的,每个相似度应当根据其当前优化状态给予不同的优化权重。Circle Loss 以简洁的形式实现了灵活的优化方式和明确的收敛状态,在多项任务上取得了极具竞争力的性能。
本文将依次讲解如下三块内容:
深度特征学习经典范式
基于统一视角泛化损失函数表达
Circle Loss的技术贡献和性能分析
一、深度特征学习经典范式
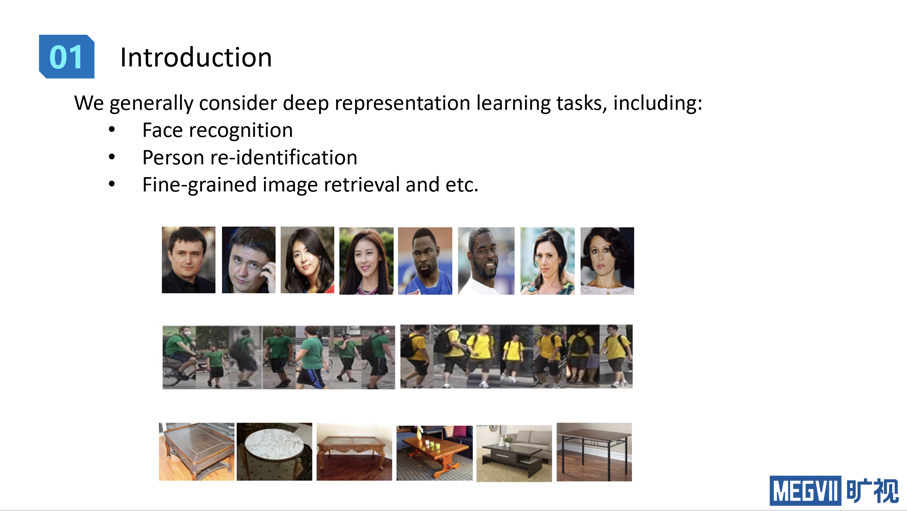
首先从通用的角度来考虑深度特征学习任务,包括人脸识别、行人再识别、细粒度图像检索等。当给定一个查询图像时,无论图像内容是什么,都希望在库图像中找到一张最相似的候选图像与之匹配。
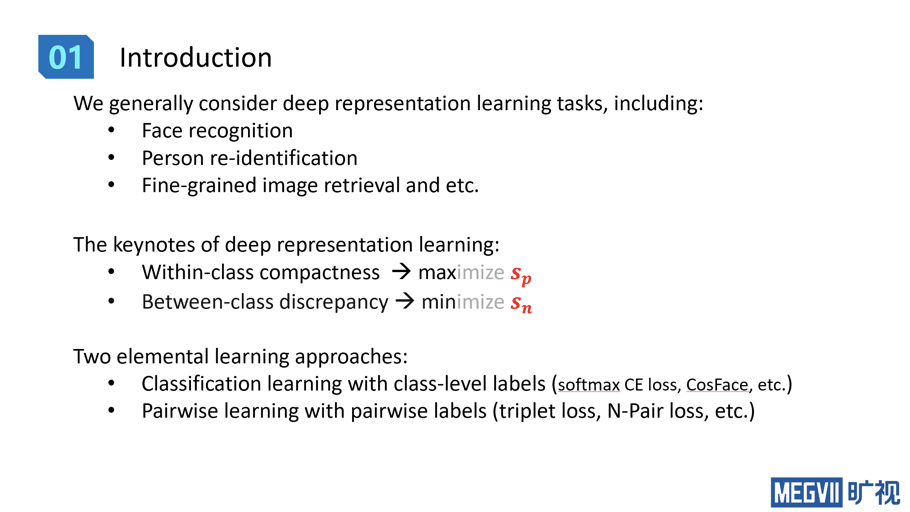
如上图所列,这些特征学习任务具有两个关键要素,分别是特征的类内紧凑度和类间分离度。在特征学习任务中,我们希望优化目标能够最大化类内相似性Sp,同时最小化类间相似性Sn。深度特征学习有两种经典的学习范式。第一种,当拥有类别标签时,可以通过使用分类器和分类损失函数来进行训练,从而学习到一个深度特征空间。这些用于分类的损失函数包括softmax cross entropy loss及其变种CosFace(AM-Softmax)、ArcFace等。第二种,当仅仅使用正负样本对标签时,采用triplet loss、N-pair loss,Lifted Struct loss等损失函数来进行pairwise学习。虽然这两种学习方法存在一定的联系,但依然缺少一个正式的解读。通常还是比较割裂的考虑二者。
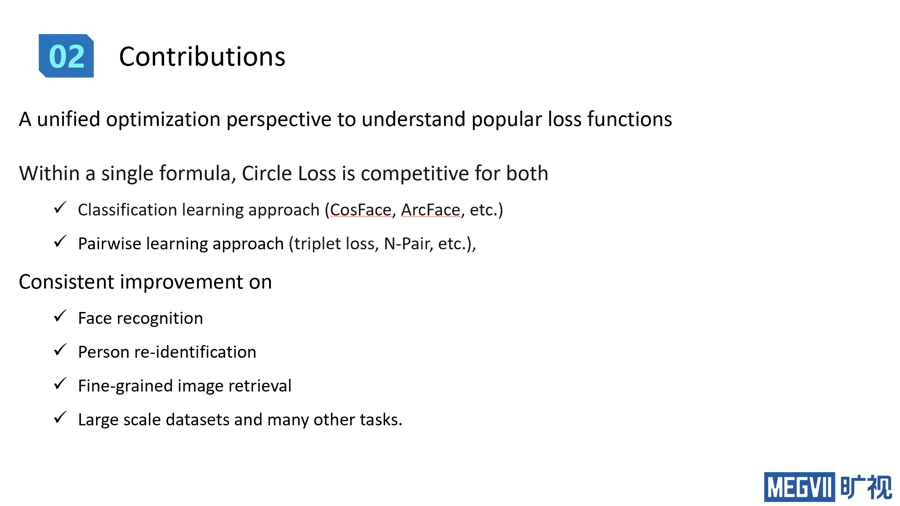
在我们的工作中,主要作出了以下三个方面的贡献:
第一,提供了一个统一的优化视角来理解当前主流的损失函数。从内在和形式上对分类和pairwise两种学习方式给出了一个统一的解读。
第二,提出了一个新的损失函数,叫做Circle Loss。它使用一个完全一样的公式表达,在两种学习方式下都取得了非常有竞争力的表现。例如,在分类学习方式下,它的性能媲美了CosFace、ArcFace;在样本对学习方式下,它的性能媲美了最新的Multi-Similarity。
第三,在3个任务,10个benchmarks上都取得了极具竞争力的表现;在大规模业务数据集上也取得了显著的效果提升。
二、基于统一视角泛化损失函数表达
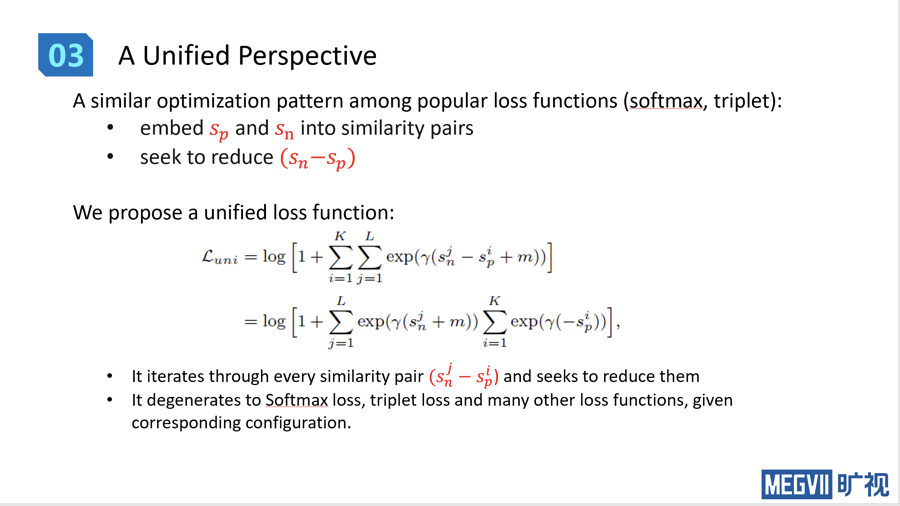
下面就对统一的优化视角做详细的介绍。主流的损失函数中,无论是分类损失函数还是pairwise损失函数,它们实际上展现出一个相似的优化模式。它们会把类内相似性Sp和类间相似性Sn嵌入到相似性对中,并尝试减少Sn-Sp。根据这个结论,提出了如下的统一损失函数。这个公式非常直观,假设给定一个样本x,能够找到K个Sp和L个Sn与之相关,则将会获得K*L个相似性对。我们希望任一的类间相似性小于任一的类内相似性,因此遍历所有的相似性对,并使用Log-Sum-Exp的形式来减小,进一步得到了统一损失函数。Log-Sum-Exp是max函数的光滑近似,具有hard-mining的效果,因此这个公式着重优化的是最大的类间相似性小于最小的类内相似性。
值得注意的是,这个统一的损失函数在相应的条件下,只需轻微的调整,就能退化成softmax loss,triplet loss以及其他常见的损失函数。
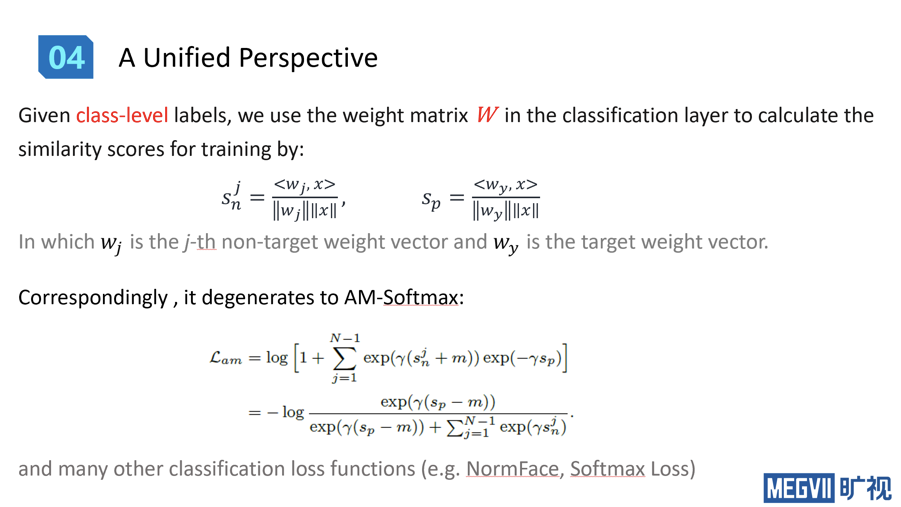
具体地,对于分类学习方式,当拥有类别标签并进行分类训练时,使用最后分类层的权重向量w与样本x来计算相似性得分。当使用cos相似性时,相似性得分可以由如下的两个公式得到,其中Wj是第j个非目标类的权重向量,Wy是目标类的权重向量。显然分类学习中目标相似性分数只有一个,即前述的公式的K=1,此时损失函数就直接退化成了AM-softmax loss,这里的N为总类别数。
进一步,若将m设置为0,则公式退化成NormFace。再进一步,若将γ(scale系数)设置为1,并将cos相似性换成dot product,则公式退化成标准的softmax。统一损失函数的公式也可以理解成softmax cross entropy loss在有多个目标分数情况下的自然推广,它可能适用于多标签的分类任务。
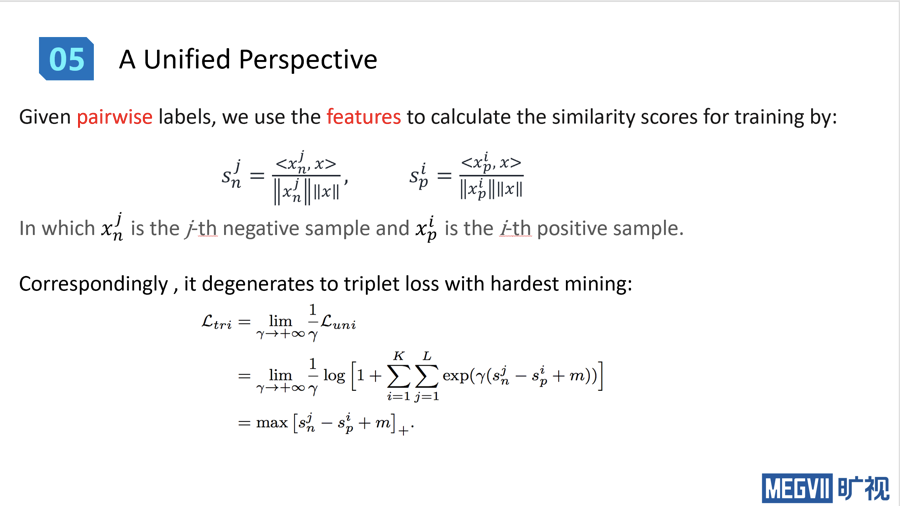
在pairwise learning情况下,如果给定样本对标签,则仅仅使用样本特征进行相似性得分的计算。这个计算方式非常简单,其中

是x的第j个负样本,

是x的第i个正样本,这里的x通常被称为anchor。
若将统一公式中的scale系数趋近无穷大,相应的circle loss就退化成了带hardest mining的triplet loss。另一方面,circle loss本身也可以看成软化版本的带hard mining的triplet loss。
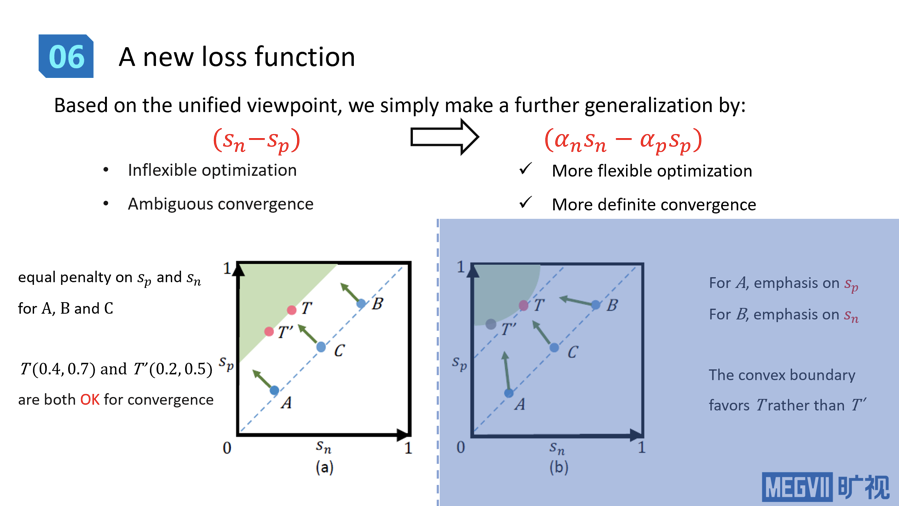
基于统一的优化视角,进一步地,这里做了一个简单的泛化。在统一的损失函数中,Sn-Sp
是一个基本的优化单元。现在,把Sn-Sp泛化成

,即给每个相似性得分一个独立的权重系数,这样就得到了一个新的损失函数。这个做法背后的动机是优化Sn-Sp容易产生不灵活的优化,以及模棱两可的收敛状态。
为了说明这两点,可以看一下左边的图a,它的横坐标是Sn,纵坐标是Sp。假设有三个状态A、B和C,可以看到A点的Sn已经很接近于理想状态0了,而B则相反,它的Sp趋近于理想状态1。可是无论对A还是B,loss对Sp和Sn的梯度却是一样的,因此这是一种不灵活的优化。
此外来看绿色区域边界所代表的收敛边界。在这样一个边界上,达到任意两点的难度是一样的,因为它到Sn=Sp这样一个混沌状态的距离相等。假设有两个状态T和T′,它们Sp与Sn
的gap达到0.3,将二者一起对比后,发现Sp和Sn之间的实际gap只有0.1,从而降低了特征空间的鉴别能力。因此,这是一个模棱两可的收敛状态。当进行泛化得到circle loss之后,情况发生了变化。对于A点会更加强调增大Sp,对于B点会强调减少Sn,从而获得一个灵活的优化。并且circle loss的分界面是圆形,在这样一个凸的分界面上,T点比其他任意一点更容易到达。因为它到Sn=Sp这样一个混沌状态的距离最近,因此它的收敛目标是更加明确的。
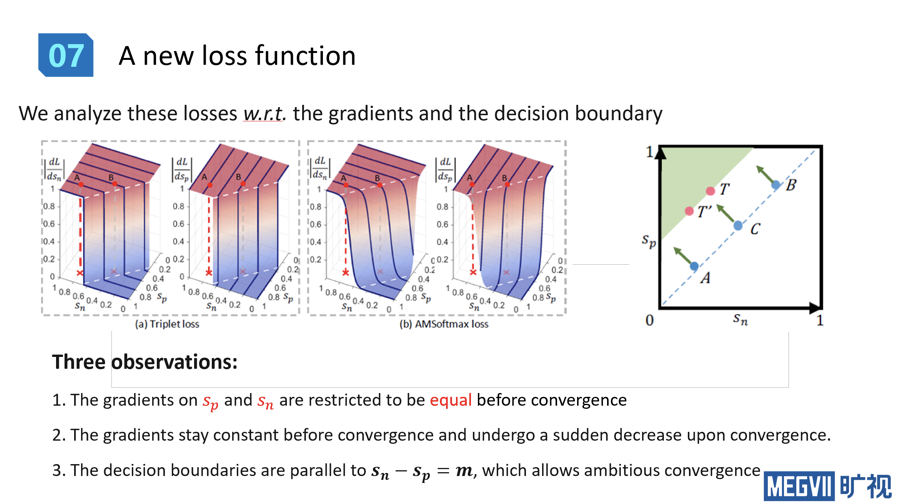
为了更准确的说明这一点,对传统的triplet loss和AMSoftmax的梯度进行了可视化,得到的观察与之前的分析是一致的。
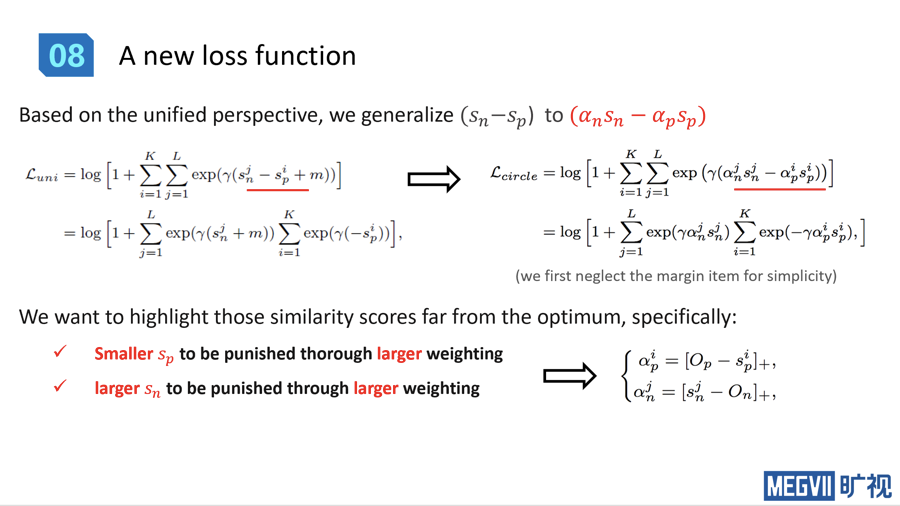
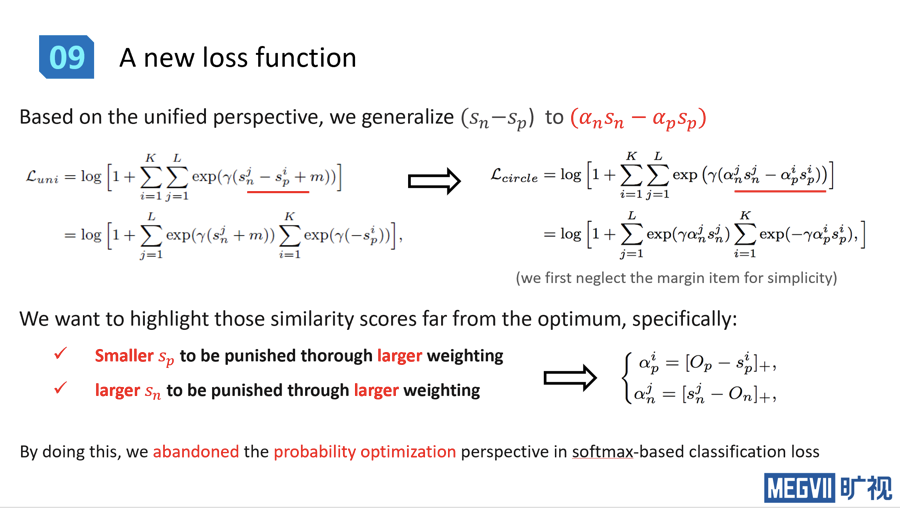
当进行了Sn-Sp向AnSn-ApSp的泛化后,就得到了circle loss。通过自适应的加权,我们希望突出那些欠优化的相似性得分。具体地,希望能够对较小的Sp和较大的Sn进行更加严厉的惩罚。因此需要给这些相似性得分加以更大的权重系数。那么通过采用线性函数Op-Sp和Sn-On来定义Ap和An这两个系数。
当进行这样的处理时,有一个数学意义上的改变是非常显著的,即分类损失函数会被解读成优化一个样本属于目标类的概率,这个概率正是softmax函数来表达的。然而在circle loss中,每个相似性得分的系数不再相同,它们无法形成公平对比,不再具有优化概率这样一个解读。无论是分类学习还是pairwise学习,在circle loss中的解读角度是最大化类内相似性,最小化类间相似性。
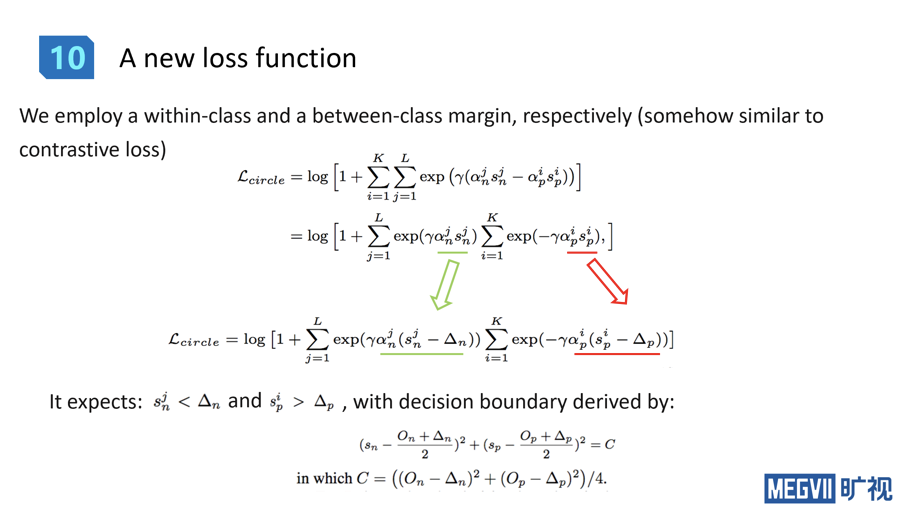
进一步,为circle loss添加相似性margin。Circle loss 在margin问题上表现出了与contrast loss相近的性质,它需要一个类内和类间margin,不同于AM-softmax相对的margin。在这一部分,期望An大于△n,Sp大于△P。通过计算它的分界面,发现在一定的限制下,它的分界面是一段圆弧,这就是称它为circle loss的原因。除了scale系数γ,circle loss有额外的4个超参数,On、△n、Op、△p,这4个超参数在具体的实现过程中可以缩减成1个超参数。
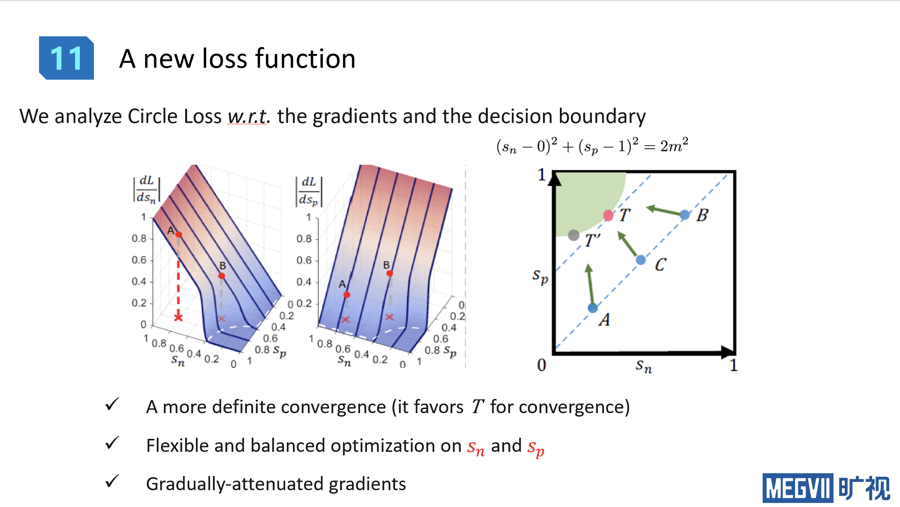
如上面右图所示,circle loss拥有一个圆形收敛分界面,它的圆心是Sn=0,Sp=1,半径为
√2m,其中m是缩减后的一个超参数。因此在优化过程中,它倾向于以切点T为最终的收敛状态,这个特点将在后面的实验中进行验证。通过观察左边的梯度图,可以看到有圆心的分界面,并且对A点来说,它的Sn比较大,那么在Sn上的梯度会更加强烈,也就是更灵活、更平衡的优化。
相比于传统的triplet loss和AM-softmax,Sn和Sp的梯度大小在收敛前基本上是恒定且相等的,在达到线性分界面时会出现一个骤降。而circle loss在优化过程中,Sn和Sp逐渐靠近理想值,梯度也会随之逐渐减小。这样的优化方式是较为平滑和温和的,和之前的loss是完全不一样的。在实验中也发现circle loss的性能对scale系数和margin设置不敏感,我们认为这一调参的方便性可能归功于这种灵活、自适应的优化过程。
三、Circle Loss的技术贡献和性能分析
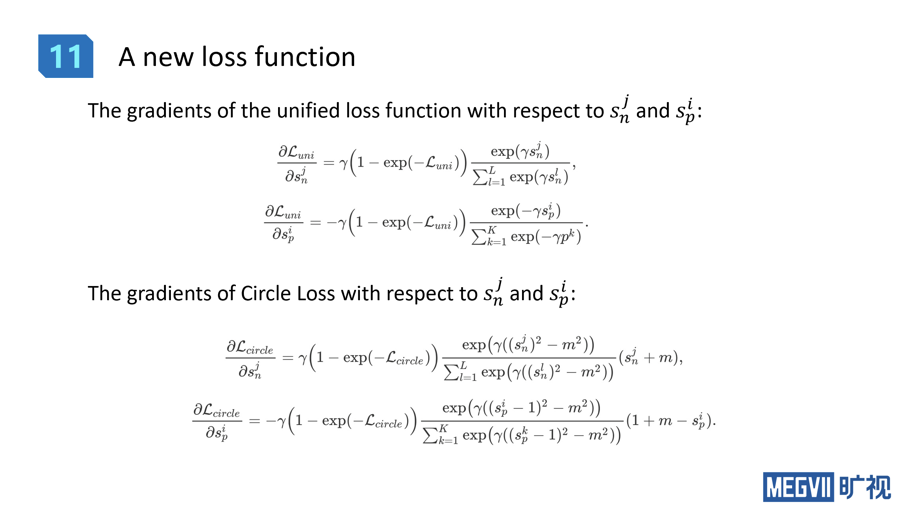
这一部分将从统一的损失函数和circle loss的梯度公式上,对二者进行对比,从而来理解circle loss 的技术贡献。
如上面的公式显示,统一的损失函数对Sn、Sp和Sp的梯度绝对值之和是相等的,对K和L的具体取值实际上不是很敏感,而且它们的梯度方向是相反的,即该loss对Sn和Sp的优化强度是相等的。而circle loss进一步考虑了每一个Sn和Sp的优化状态,多了一项显式的、独立的惩罚权重,梯度大小会随Sn和Sp的优化状态的变化随之调整,实现了更加灵活的优化。
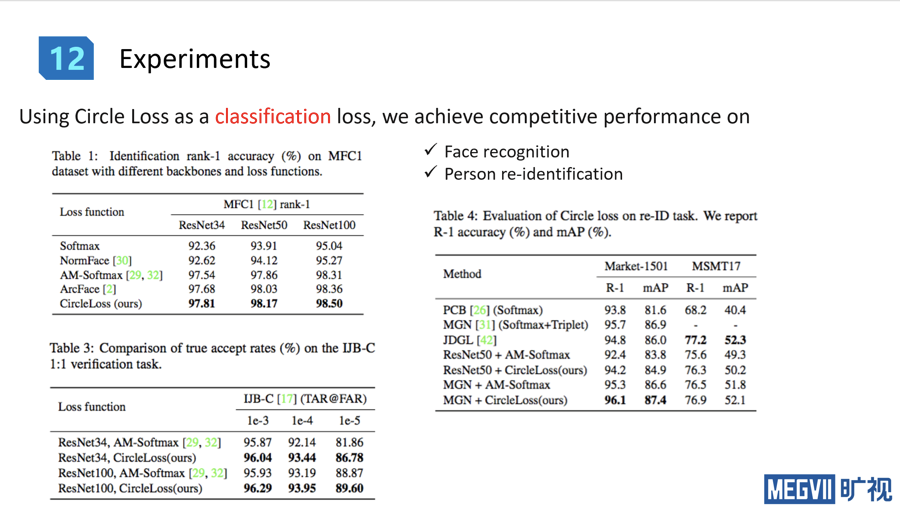
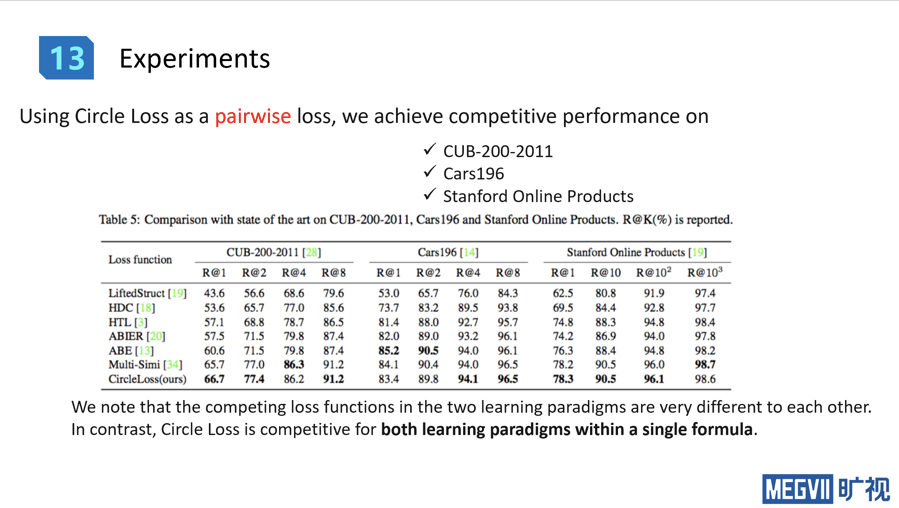
上图的实验结果表明,当使用circle loss作为分类损失函数时,在人脸和行人再识别任务上取得了 state of the art 的性能;而当使用 circle loss 作为 pairwise loss 时,它在 cub200 等细粒度检索数据集上取得了非常有竞争力的表现。使用Circle Loss 一种公式分别去跟两个领域各自的王者进行PK,并刷新了各自 state of the art 性能,这一点是难能可贵的。值得一提的是,在 extension 版本中,我们会对分类学习和 pairwise 学习两种范式进行更深入的讨论,二者的界限会进一步被打破。
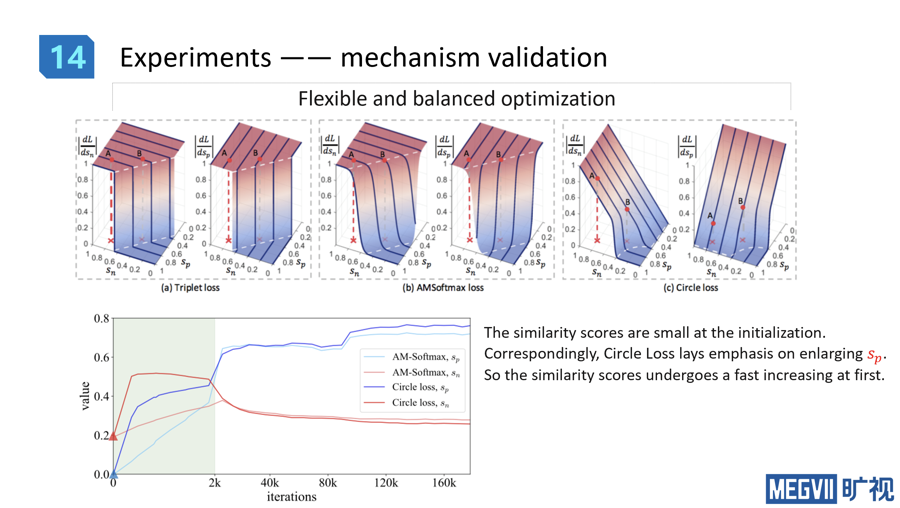
这两个实验与 circle loss 的机理相关。Circle loss具有灵活优化的特点,因此这部分实验将分析类内相似性和类间相似性在优化过程中的变化规律。上图展现的是Circle Loss在优化刚开始时,由于相似性得分初始值比较低,接近于0,那么会侧重增大Sp,从而使得相似性得分迅速增大。而如图所示的浅色的AM-softmax,它的loss规律是很不一样的。最终收敛状态下Circle Loss取得了更大的Sp和更小的Sn,这意味着Circle Loss具有更好的类内紧凑度和类间分离度。
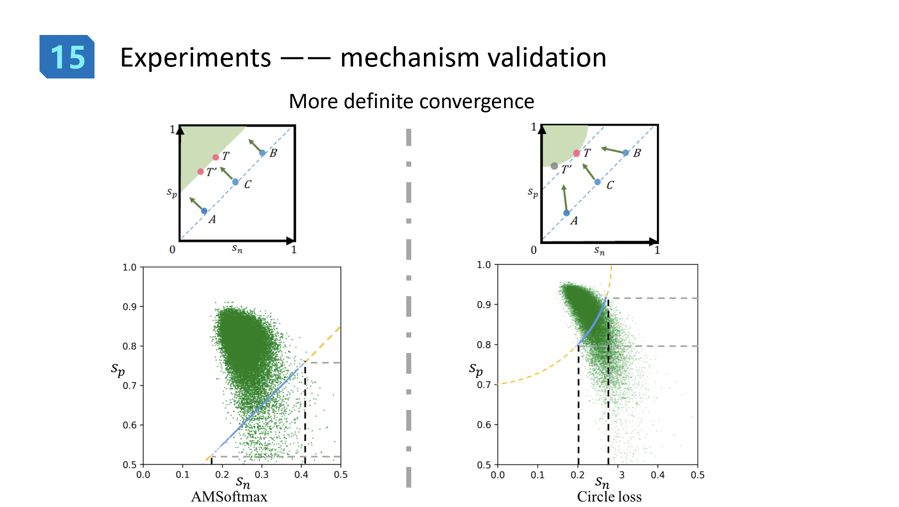
这张图则验证了 Circle Loss 具有更加明确的收敛状态。这里横坐标是类间相似性Sn,纵坐标是类内相似性Sp,绿色的散点是相似性得分在收敛后的分布状况,而蓝色的线则记录了相似性得分。在通过决策面瞬间的位置,通过比较Circle Loss和AM-softmax,可以看到Circle Loss具有更加紧凑的相似性得分,以及更狭窄的收敛通道,这与最初的猜测是非常吻合的。
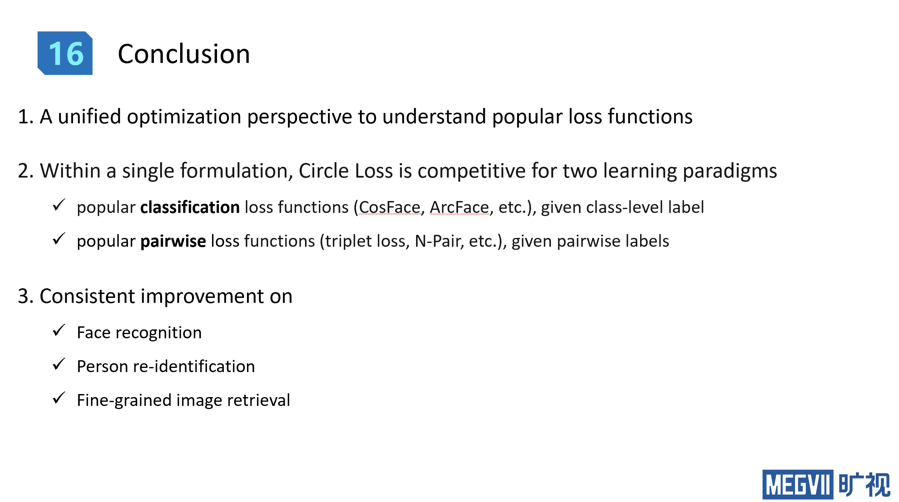
最后,关于Circle Loss 可以总结为三点:
第一,提出了一个统一的优化视角,来理解主流的损失函数;
第二,Circle Loss使用完全相同的公式,在两种基本学习方式中都获得了极具竞争力的表现。
第三,在一系列常见任务中,Circle Loss取得了稳定的提升。
Q&A
本文内容整理自 PaperWeekly 和 biendata 在B站组织的直播回顾,QA 环节的部分内容或许您也会感兴趣,整理如下。
Q: 能不能开源人脸代码?
A: 关于开源问题还需要走一些流程。Circle Loss的实现是很简单的,网上有很多较为流行的人脸识别代码库如insightface,可以尝试修改loss。并且Circle Loss有很多第三方的实现,跟我们的实现实际上是差不多的。
Q: Circle Loss能否用在无监督领域? A: 无监督领域的 contrastive learning,它们的形式非常像triplet loss.比如noise contrastive estimation,它的形式就是softmax分类损失函数转变为pairwise loss一个很自然的形式。如果对于multi-view这样一个无监督instance discrimination任务来说,是完全可以使用Circle Loss的。
Q: Circle Loss能否用在检测任务上?
A: 检测任务的分类子任务实际上也可以理解成一个特征表示学习,所以Circle Loss作为一个泛化的统一的形式,是可以用来优化检测任务中的特征表示的。更好的特征表示对物体检测也是有好处的。
Q: Circle Loss能否用于分割任务上?
A: 分割是像素级别的分类,所以只要是分类任务,那么Circle Loss也是完全可以适用的。
Q: 如果对Circle Loss进行进一步的研究,可以从哪些方面考虑?
A: 虽然Circle Loss对分类和pairwise两种学习方式进行了一个统一的泛化表示,但是对这两种学习方式孰优孰劣还需要进行更深入的分析。在extension版本中,我们会更加深入的分析pairwise loss。通常认为pairwise learing是弱于分类Loss的,那么它的原因在哪,有没有什么方式可以改善这一点,我们会在extension上做更细致的探讨。
Q: 底库越大,参数必然越大,是一个必然趋势吗?
A: 这里的参数指的是模型的参数吗?如果想要取得更好的性能,那么模型参数是很重要的。可以看到即使Circle Loss相比于其他Loss取得了显著的性能提升,但是当把模型从ResNet 34换成Resnet50,以及更好的ResNet100,它的性能提升也是比较显著的,那么模型本身它的鉴别能力也很重要,即特征的抽取能力。
Q: 可以再细讲一下α和Δ吗?
A: Ap和An它是对于每一个相似性Sp和Sn的,这里只使用了关于Sp和Sn的线性函数。可以看到当Op可以理解成一个Sp的最佳值,那么On是Sn的最佳值,那么当Sp和Sn越接近于它们各自理想值,相应的权重系数也会逐渐衰减。Δ可以理解成margin,它是一种比较绝对的margin。
Q: Circle Loss适合几亿级别的人脸识别任务吗?
A: 实际上我们现在内部的业务数据量级至少是上亿的,所以Circle Loss是完全可以适用的。
Q: α和Δ是超参吗?
A:
和Δ是超参,但在论文中,我们对四个超参数做了简化处理,最终得到的超参就是一个m。它相比于AM-softmax是没有多的超参负担的。
Q: 类别多了参数会爆炸吗?
A: 这个问题应该指的是分类器的参数。如果类别非常庞大,那么gpu显存是塞不下的,这个时候其实适合用pairwise的方式。像我们的学术数据集MS-Celeb,它的类别数上万,显存是可以放得下的。
Q: pairones版和classification版哪个性能更好?
A: 这里就需要去考量二者真正的性能差异在哪。比如对于pairwise loss,它构造正负样本对,只限于当前batch,它的视野是非常局部的。但是如果采用诸如何恺明老师MoCo论文的做法,负样本对采样还可以来自于历史batch中。或者将视野扩大,那么当这个视野达到了与classification分类的相同的量级时,它们性能之间的差异可能是非常小的,甚至pairwise learning的效果比classification learning的效果更好。
关于设计损失函数的原则和方法。这个更多的是来自于一些直觉和经验,通常来说我们会去观察Sn和Sp在训练过程中的变化,然后以此来做一些相应的设计,我们认为一个什么样的收敛状态是比较好的,无论是做Loss的改进以及调参,都是来自于实验观察,以及更多的是经验的积累。
Q: 设计损失函数的原则和方法?
A: 更多的是来自于一些直觉和经验,通常来说我们会去观察Sn和Sp在训练过程中的变化,然后以此来做一些相应的设计。我们认为一个什么样的收敛状态是比较好的,无论是做Loss的改进还是调参,都是来自于实验观察,以及更多的是经验的积累。
你们的数据量是多大?那么我们人脸识别训练是在MS-Celeb这样一个大约300万的数据量,然后像细粒度识别这些数据库,它的数据量相对小一些,然后实际我们业务中使用的数据量是非常庞大的。
Q: 数据量的大小?
A: 人脸识别是在MS-Celeb这样一个大约300万的数据量上进行训练的,细粒度识别的数据量相对小一点。而实际业务中的数据量是十分庞大的。
本文校对、编辑:包小玲儿、郑然
关于数据实战派
数据实战派希望用真实数据和行业实战案例,帮助读者提升业务能力,共建有趣的大数据社区。
扫描二维码 | 关注我们
