
包交换是路由器的功能核心,因而实现快速的包交换非常重要。Cisco IOS平台的交换机制从进程交换升级为快速交换,并最终升级为CEF交换。
3层设备使用了分布式的架构,其控制平面和数据平面是相对独立的,例如路由协议经过控制平面进行路由信息的交换,而数据包的转发是在数据平面由接口微编码处理器完成的。
Cisco交换机制
进程交换:此交换方式是三种方式中速度最慢的,每个数据包都由控制平台中的CPU进行检查,且所有的转发策略都是在软件中进行的。每个数据包都由CPU独立处理,当数据包到达入站口时,它会被转发给控制平面,此时CPU会使用路由表中的条目来匹配数据包的目的地址 CPU随后判断数据包的出站口,并转发数据包,进程交换是Cisco交换中最使用CPU的方式
快速转发:此交换方式比进程交换快,快速转发对流量的初始数据包进行进程转发,这表示数据包会在CPU中进行检查,而转发策略也会被储存在数据平面的硬件快速转发缓存中,当后续的流量到达时,设备可以在硬件的快速转发缓存中找到目的地址,因此帧也就会在不中断CPU的情况下,进行转发
Cisco快速转发:Cisco快速转发是最快的交换模式,这种方式比快速转发和进程转发交换使用更少的CPU,对于启用了CEF的路由器,其控制平面CPU会使用路由表和地址解析协议表中的3层和2层信息,来创建两个基于硬件的表,这两个表分别是转发信息表(FIB)和邻接表(ADJ),当网络收敛时,FIB和ADJ表中会包含路由器在转发数据包时会使用的所有信息,两个基于硬件的表会用来转发数据包中的所有数据帧,包括第一个帧,FIB包含预先算出来的逆向查找和下一跳信息(包括2层信息和接口)
上述的三种交换方式常常被比喻成,进程转发相当于用笔算解题,每一题都要手算,快速转发相当于第一次用笔算解题,在后面遇到相同的问题的时候,直接用之前手算的答案,Cisco快速转发相当于提前用计算机解决所有可能的问题
FIB信息是由路由表中获取到的,CEF IP目的前缀条目会按照从最详细到最不详细的顺序进行排序储存,路由器会按照3层目的地址来执行(最长匹配)FIB查询,当CEF FIB表满时,反掩码条目会将数据帧重定向给3层引擎,FIB表在每次网络变化后就会更新一次,其中会包含所有已知路由,路由器不需要通过集中处理每个数据流初始数据包的方式来构建路由缓存,IP路由表的每次变化都会触发FIB表中出现相类似的变化,因为IP路由表中包含了所有目的网络的对应的下一跳信息
邻接表信息取至于ARP表,其中FIB中的每一个下一跳的2层报头重写信息,如果网络中两个节点之间距离一跳之内,那么就称为邻接节点,邻接表维护所有FIB条目的2层下一跳地址和链路层报头信息,每发现一个邻接节点。路由器就会填充邻接表,每次创建一个链接条目,路由器就会预先算出邻接节点的链路层报头并将其储存在邻接表中
CEF通过FIB和ADJ表来以线速来转发数据包
那么既然CEF那么好,难道就没有什么缺点吗?
肯定不是啊!
在以下情况中就不适合通过CEF来转发
使用了IP头部可选字段
被转发到隧道接口的数据包
超过出站接口最大传输单元,这类数据包必须进行分片
讲完了理论之后,我们以一个环境来介绍Cisco快速转发
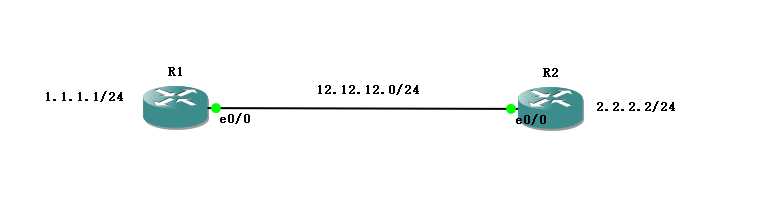
实验环境
以及基础配置
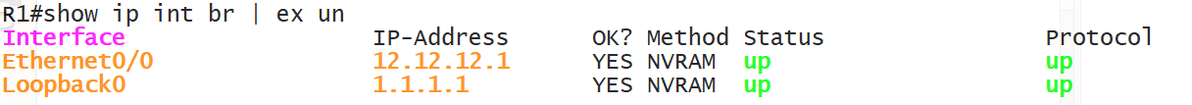
R1
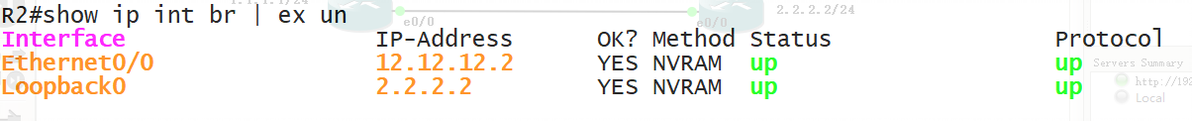
R2
IPv4的CEF可以在全局开启也可以在接口下开启,命令都为ip cef
IPv4的CEF默认开启,IPv6的CEF在开启了ipv6 unicast-routing之后默认开启
现在我们来看一下CEF表和ADJ表
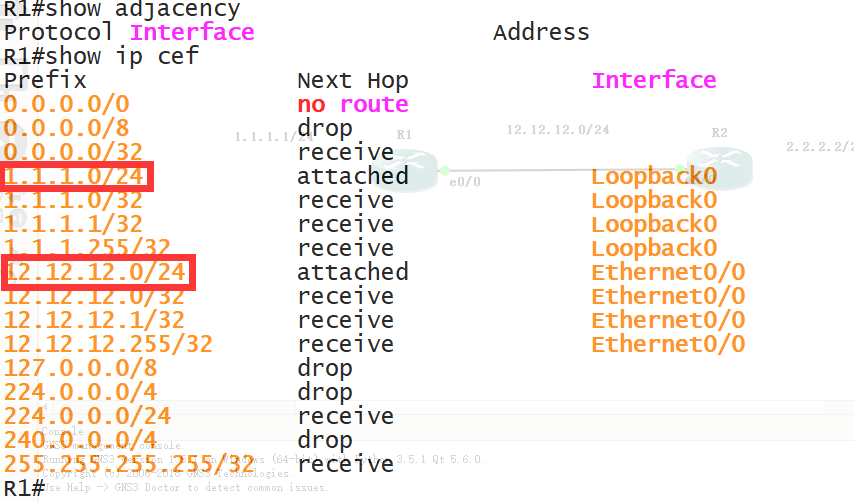
R1的CEF
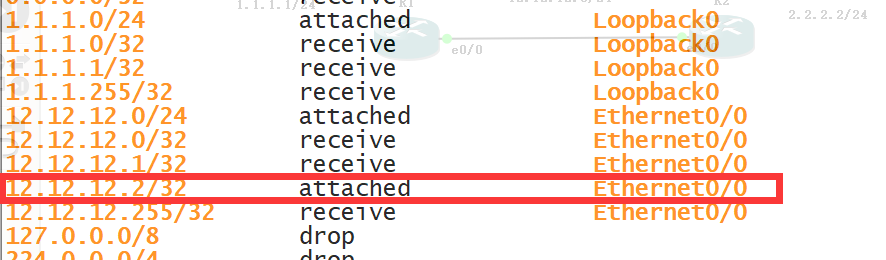
我们会发现CEF中都只有直连的网络前缀的信息
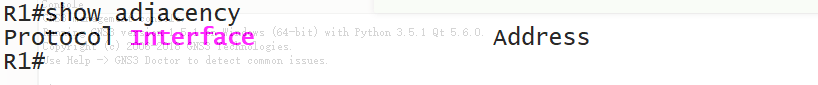
R1的ADJ表
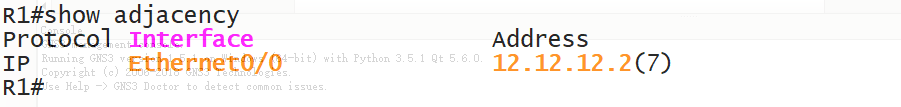
我们会发现现在的ADJ表示空的,因为ADJ表还没用从ARP表中构建信息,所以是空的,我们来ping一下R2的接口地址,来看看CEF表和ADJ表会发生什么
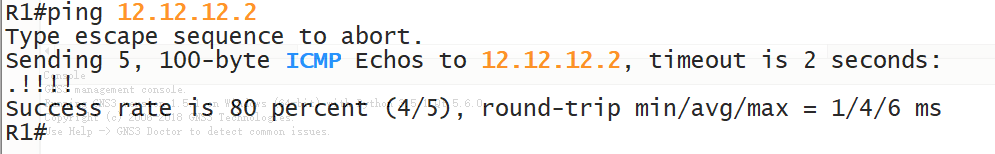
ping
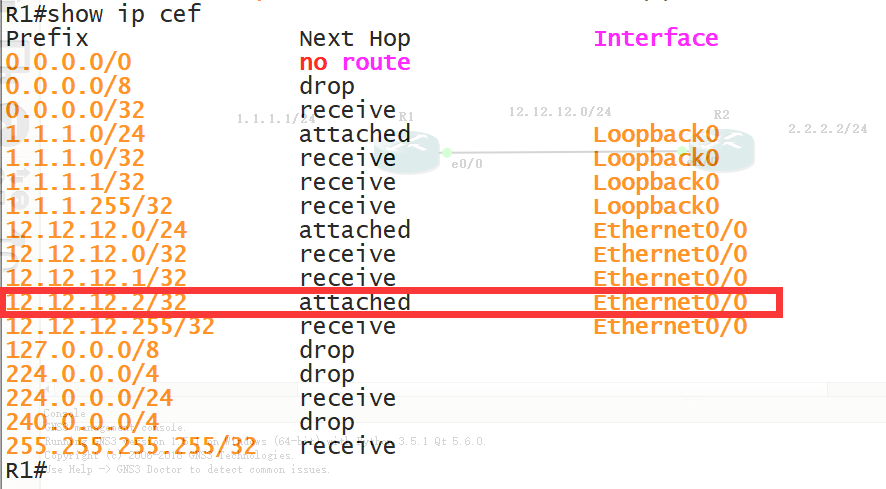
第一个包不通的原因是进行ARP解析,接下来ADJ表从ARP表中获取信息构建ADJ表
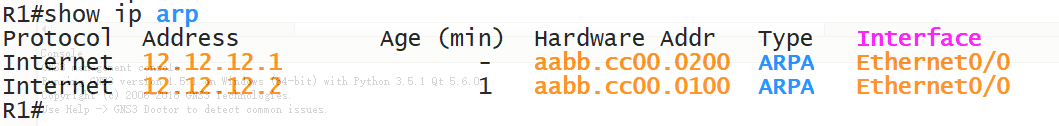
ARP表
ADJ表
CEF表
对比之前的CEF表和ADJ表,我们发现多出了一些内容,和之前理论相吻合
接下来我们在两台路由器之间运行路由协议OSPF
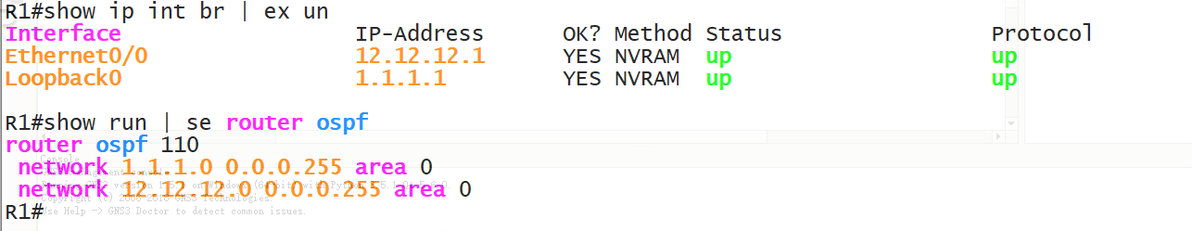
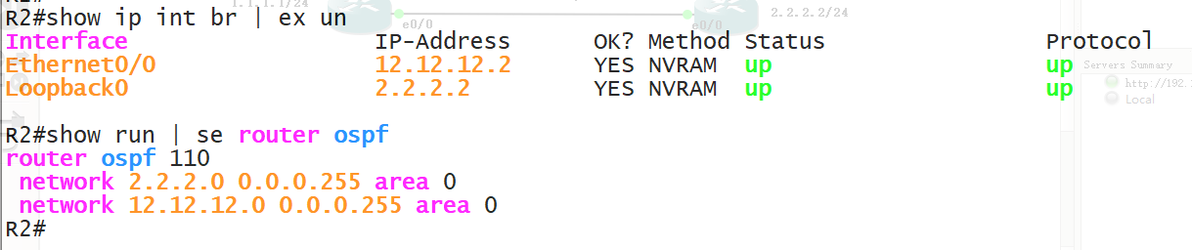
基础配置如下:
R1
R2
邻居正常建立(关于OSPF的配置可以参考我之前的文章 网页链接)
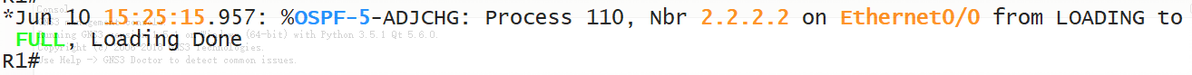
邻居建立
我们再来观察ADJ表和CEF表的变化
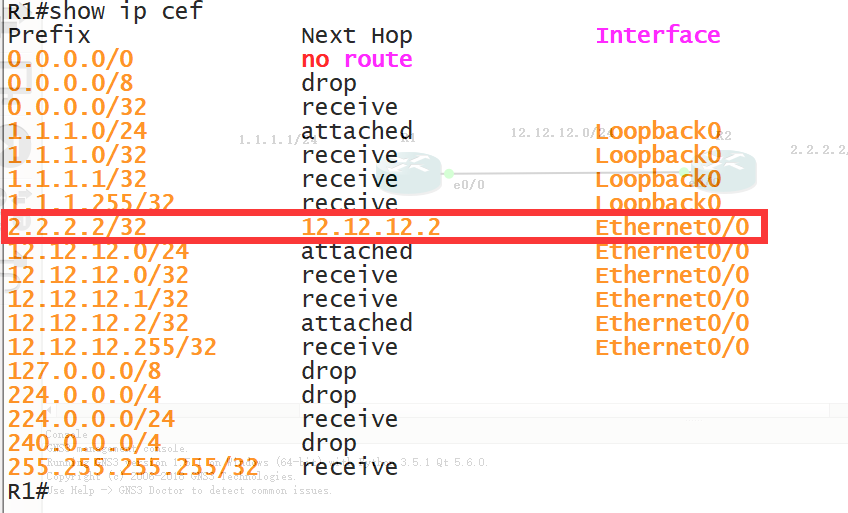
CEF表
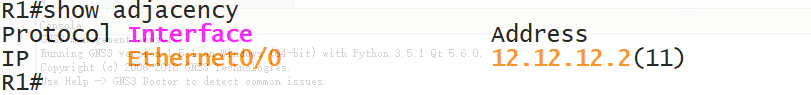
ADJ表
我们发现在没有进行额外的操作情况下,R1的CEF表中多出了一个关于2.2.2.0网络前缀的CEF条目,这是CEF预先计算出来的,ADJ表中的条目也由7变成了11
这也与我们之前的理论相吻合
Bingo!觉得讲得清楚的可以点赞投币收藏关注啊
