
一句话概括:上游 NInfer 把目标 SM 数硬编码成 128(只认 RTX 4090),我把它提成一个 CMake 选项,让我这张 80 SM 的 4080 SUPER 成为官方支持的第二档,并跑完了 Bonsai 2 27B 与 Qwen3.8-27B 的完整实测。
一、TL;DR
项目: 目标卡 | 结果: RTX 4080 SUPER(sm_89 / Ada / 80 SM)
项目: 核心改动 | 结果: NINFER_TARGET_SM_COUNT 一个 CMake 选项
项目: 运行环境 | 结果: 原生 Windows 11,无 WSL、无 Docker
项目: Ternary Bonsai 2 27B | 结果: decode 会话均值 176.6 tok/s、prefill 2,495 tok/s、MTP 接受率 58.9%
项目: Qwen3.8-27B(int8 产物) | 结果: decode 会话均值 96.3 tok/s、prefill 2,577 tok/s、MTP 接受率 59.3%
项目: 显存 | 结果: 27B 模型 + 262K 上下文塞进单卡,KV 池占用 20.2%
项目: 交付形态 | 结果: 一个 zip,解压双击 .bat 就能起服务
项目: 许可证 | 结果: Apache-2.0
需要先说明:下面所有"本机"数据都是我这张 4080 SUPER 实测的;引用的 4090 数据是上游作者 JGamboa 的,我会逐处标注来源。 这个区分很重要,因为两种数据的条件不同。
二、背景:为什么不继续用 llama.cpp
本地跑大模型,主流路线是 llama.cpp + GGUF,或者 Ollama / LM Studio 这类封装。它们的优势是通用:支持几百种模型架构,一套计算图适配所有情况。
NInfer 走的是完全相反的取舍:从零手写的 C++20 / CUDA 引擎,只服务一个模型架构家族(Qwen3.5/3.6/3.8,48 层 Gated DeltaNet 线性注意力 + 16 层全注意力)。
没有运行时计算图,每一层根据权重格式直接调手写的 kernel,每个 kernel 都有独立的 FP32/FP64 oracle 测试兜底。专用换来的就是性能。
对我这种只跑一两个 27B 模型的场景,这个取舍是划算的。
血统链
NInfer 不是凭空出现的,它是一串 fork 接力:
Neroued/ninfer                      引擎本体,为 RTX 5090(sm_120a)从零开发
  ↓
Don-Chad/ninfer-3090                sm_86 兼容层、ReplaySSM 集成
  ↓
sergiuszm / UDP / shantanu          4090 各支:Ada 注意力 prefill 调优、
                                    E8 格 2/4-bit KV、/metrics、/slots、timings
  ↓
JGamboa/ninfer-4090-windows         原生 Windows 构建、Ternary Bonsai 全链路、
                                    n-gram 投机、并发泳道
  ↓
zjwan461/ninfer-sm89-windows        ← 我这个 fork:SM 数变成构建选项
搞清楚这条链就知道我的定位:改动非常聚焦,就一个构建选项。
这条链上每个仓库的完整链接见文末「资源」一节。
三、问题定位:硬编码的 128 个 SM
我手里是 RTX 4080 SUPER,和 4090 同为 Ada 架构、同样叫 sm_89,但 SM 数量不一样:
SM 数 | RTX 4090: 128 | RTX 4080 SUPER: 80
架构 | RTX 4090: sm_89(Ada) | RTX 4080 SUPER: sm_89(Ada)
CUDA 源码 | RTX 4090: 同一份 | RTX 4080 SUPER: 同一份
问题出在引擎内部:attention 的 wave 几何是编译期常量 kTargetSmCount = 128,kernel 启动几何直接依赖这个数。
80 SM 的卡跑硬编码 128 的代码,会得到 1.6 个 wave —— 最后一个尾波填不满,occupancy 白白浪费。不会崩,但速度不对。
好消息是:架构相同,二进制能直接跑。所以这不是指令集不兼容,纯粹是调度几何没为这张卡标定。
四、解决方案:把目标 SM 数变成构建选项
改动就一条:把硬编码的 128 提成 CMake 选项 NINFER_TARGET_SM_COUNT。
rem 一次 configure 选定目标卡
cmake -S . -B build -G Ninja ^
  -DCMAKE_BUILD_TYPE=Release ^
  -DCMAKE_CUDA_ARCHITECTURES=89 ^
  -DNINFER_TARGET_SM_COUNT=80        rem 4090 用 128

cmake --build build -j
产物:
build\apps\ninfer.exe          rem CLI
build\apps\ninfer-serve.exe    rem HTTP 服务
80 SM 不是随便改个数字
这是我认为这个 fork 唯一值得讲的技术点。把 128 改成 80 之后,有两处编译期断言必须过:
SM 数必须是偶数
SM 数必须 ≥ 66
80 刚好合法。同时 wave 几何要重新标定(SmallTWaveSplits 40 / 80),256K 上下文能力不缩水。
如果当初是把断言删掉或者放宽,那就是"能编译"而不是"正确"了。保留断言、只参数化输入,是这个改动能站得住的原因。
五、编译与部署(可复现)
工具链
我的环境:
组件: 系统 | 版本: Windows 11 x64
组件: 编译器 | 版本: Visual Studio 2022(MSVC)
组件: CUDA | 版本: 13.1
组件: 构建 | 版本: CMake 3.28 + Ninja
组件: 依赖 | 版本: vcpkg(curl / ffmpeg / pkgconf)
组件: 驱动 | 版本: 595+
上游 4090 那批数据是在驱动 595.97 / CUDA 13.4 上测的,和我的环境不完全一致,这一点后面讲倍率时会提到。
不想自己编译的话,直接下 Releases 的 zip:ninfer-sm89-windows-x64-0.6.1.zip,约 1.6 GB —— CUDA 运行时已经静态内嵌进 exe,除驱动和 VC++ 运行库之外什么都不用装。
下载模型
hf download jgamboa/Qwen3.8-27B-NInfer-4090 qwen3_8_27b_a8.ninfer --local-dir E:\models
或者下 Bonsai 那个 6.4 GiB 的文件。
务必按 model card 校验 checksum。 权重不对不会报错,但结果会静默变差 —— 这是这种注册制模型格式的坑。
启动(4080 SUPER 保守档)
ninfer-serve.exe E:\models\qwen3_8_27b_a8.ninfer ^
  --host 127.0.0.1 --port 8080 ^
  --model-id qwen3.8-27b ^
  --max-context 131072 ^
  --kv-dtype rk4v4-e8 ^
  --max-concurrency 3 ^
  --prefill-chunk 1024 ^
  --spec mtp --draft-tokens 3 --ngram chain ^
  --kv-capacity auto
几个参数值得单独讲:
--prefill-chunk 1024:4090 档是 1408。80 SM 的 wave 更容易填满,所以调小 —— 这是真正按卡标定的参数,不是照抄。
--kv-dtype rk4v4-e8:keys 用 E8 格的 4-bit 编码、values 4-bit。这是能同时装下 131K 上下文和三条并发泳道的关键。
--kv-capacity auto:跟随实测空闲显存。
内存计划在 listen 之前就校验:配不下的组合直接启动失败,而不是跑到一半 OOM。这个设计对本地部署特别重要,因为你没法弹性扩容。
第一条请求
$body = @{ model="qwen3.8-27b"; max_tokens=512
  messages=@(@{ role="user"; content="用三句话解释 CUDA Graph" }) } | ConvertTo-Json -Depth 5

Invoke-RestMethod -Uri http://127.0.0.1:8080/v1/chat/completions -Method Post `
  -ContentType "application/json" -Body $body | Select -Expand choices
服务同时长成三种客户端期待的样子:OpenAI Chat Completions、OpenAI Responses、Anthropic Messages。Open WebUI、LiteLLM、Claude Code 走代理,改个 base URL 就能接。
浏览器打开 127.0.0.1:8080/monitor 有全套监控:decode / prefill 速度、MTP 草稿接受率、前缀缓存命中率、KV 占用。
六、实测(一):Ternary Bonsai 2 27B
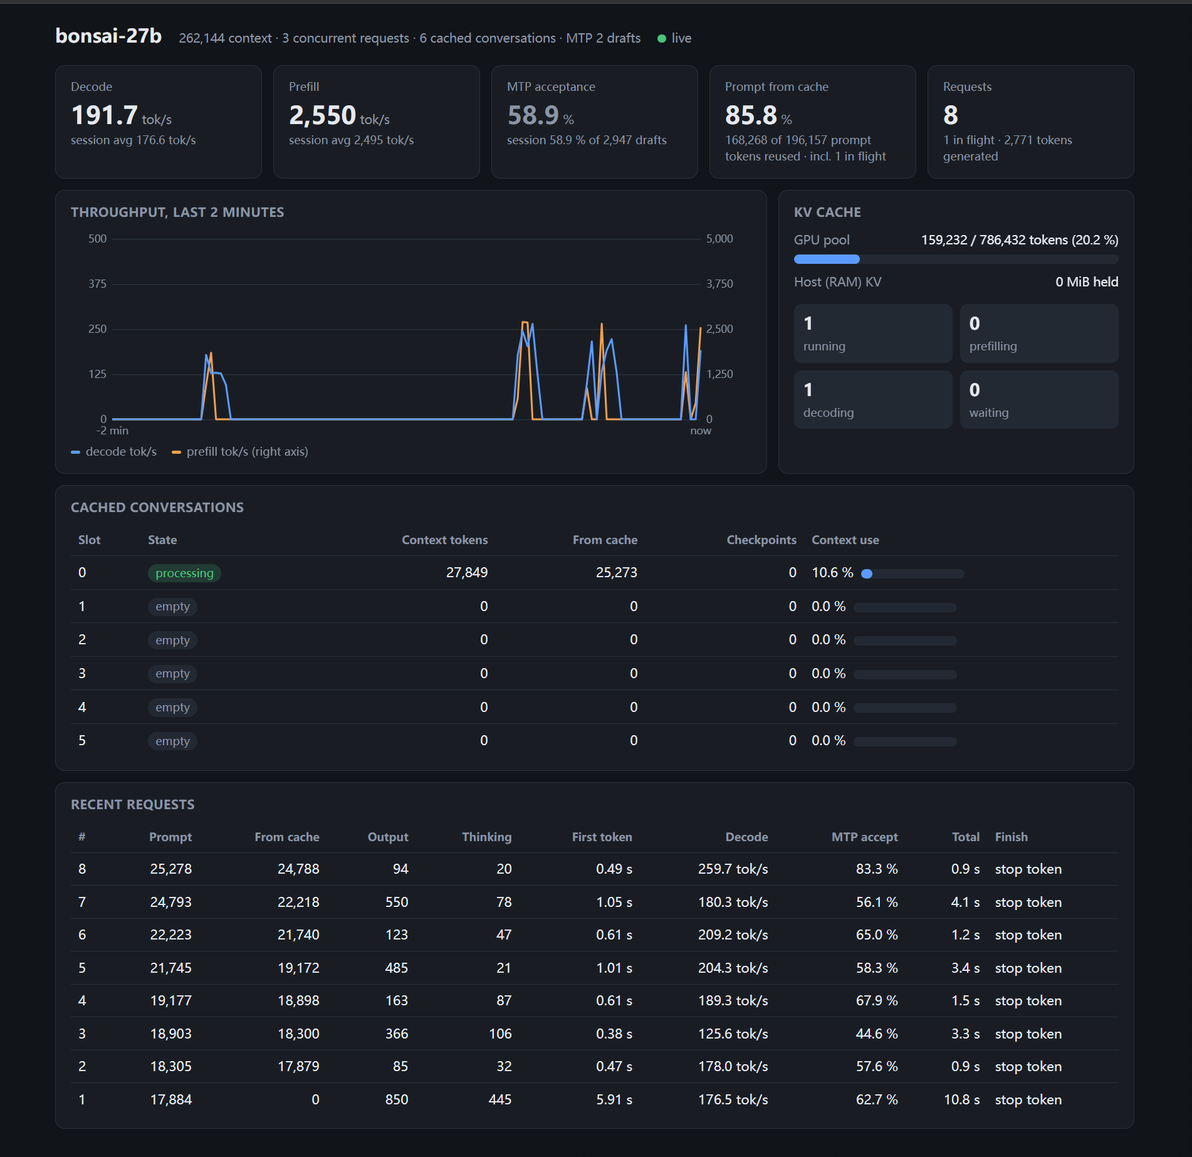
这是 NInfer 自带监控页的原始画面,条件:262,144 上下文、3 条并发、MTP 2 drafts、8 条请求。
指标: Decode 会话均值 | 数值: 176.6 tok/s
指标: Decode 窗口读数 | 数值: 191.7 tok/s
指标: 单请求区间 | 数值: 125.6 – 259.7 tok/s
指标: Prefill 会话均值 | 数值: 2,495 tok/s
指标: MTP 接受率 | 数值: 58.9%(2,947 草稿)
指标: Prompt 缓存命中 | 数值: 85.8%(168,268 / 196,157)
指标: 首 token | 数值: 0.38 – 5.91 s
指标: Prompt 规模 | 数值: 17,884 – 25,278 token
指标: KV 池占用 | 数值: 159,232 / 786,432(20.2%)
Bonsai 是 Prism ML 的三值权重模型,权重只有 -1 / 0 / +1 三个值,整个 27B 压到 6.4 GiB。
顺带一个观察:这里的 KV 池容量 786,432 = 262,144 × 3,正好是「上下文长度 × 并发泳道数」。Qwen 那边 393,216 = 131,072 × 3,同一套规则。所以 --max-context 和 --max-concurrency 是相乘关系,调参时两个要一起看。
七、实测(二):Qwen3.8-27B(int8 产物)
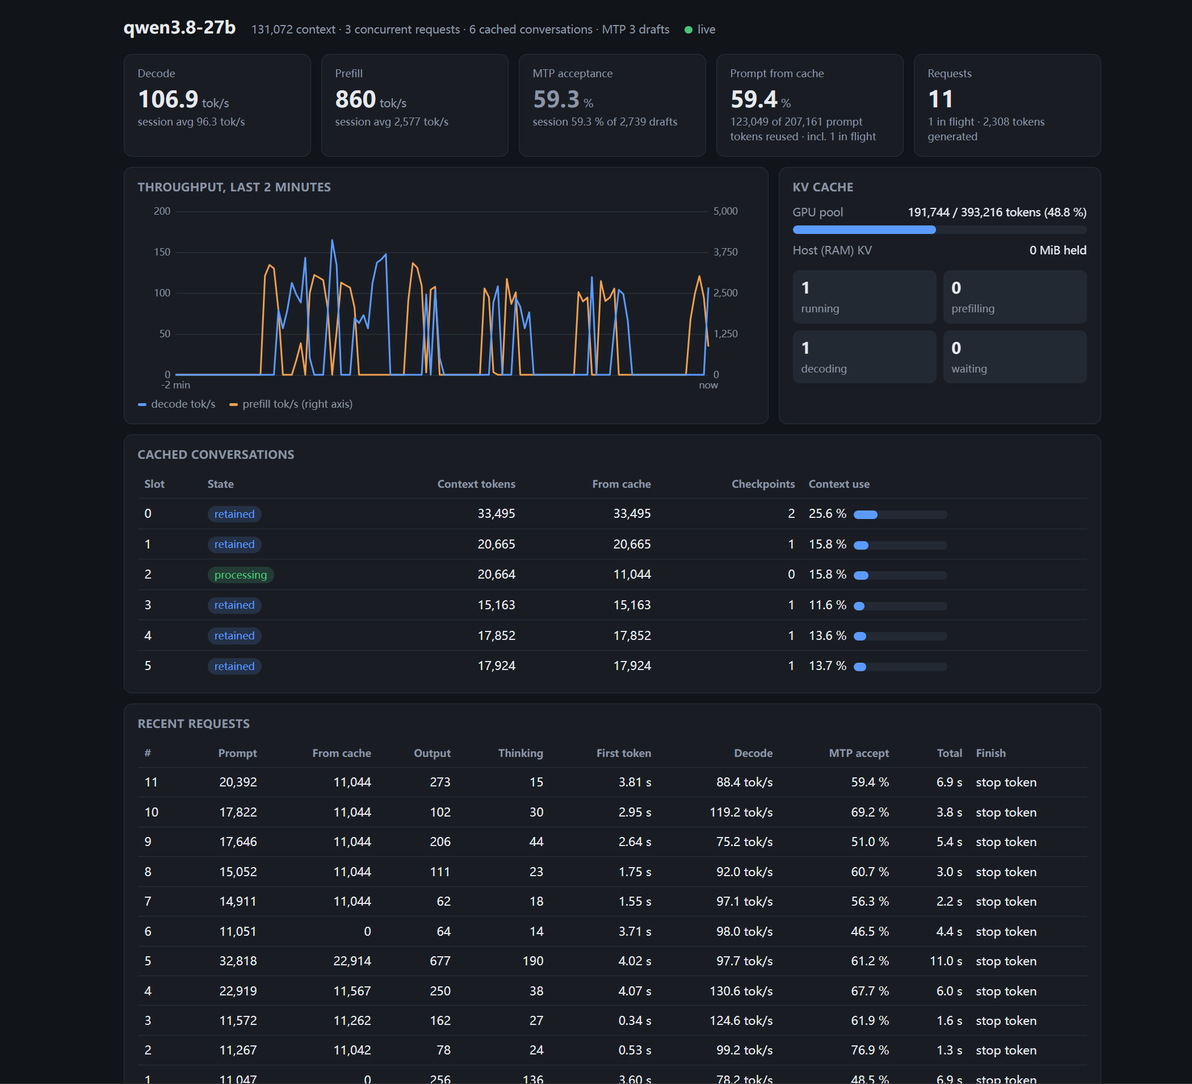
条件:131,072 上下文、3 条并发、MTP 3 drafts、11 条请求。
指标: Decode 会话均值 | 数值: 96.3 tok/s
指标: Decode 窗口读数 | 数值: 106.9 tok/s
指标: 单请求区间 | 数值: 75.2 – 130.6 tok/s
指标: Prefill 会话均值 | 数值: 2,577 tok/s
指标: MTP 接受率 | 数值: 59.3%(2,739 草稿)
指标: Prompt 缓存命中 | 数值: 59.4%(123,049 / 207,161)
指标: 首 token | 数值: 0.34 – 4.07 s
指标: Prompt 规模 | 数值: 11,042 – 32,818 token
指标: KV 池占用 | 数值: 191,744 / 393,216(48.8%)
关于 int8 产物
Qwen3.8-27B 有两个产物,权重逐字节相同,int8 版只是让 prefill GEMM 的激活也量化成 int8:
产物大小 | 官方产物(BF16 prefill): 19.0 GiB | int8 版(推荐): 19.0 GiB
Prefill pp2048 | 官方产物(BF16 prefill): 2,762 tok/s | int8 版(推荐): 5,790 tok/s
Decode | 官方产物(BF16 prefill): 120 tok/s | int8 版(推荐): 120 tok/s
上表是上游 4090 的数据(来源:JGamboa/ninfer-4090-windows),不是我的 4080S。
两边都 int8 就能进 tensor core,prefill 直接快 1.7–1.9 倍,decode 和 perplexity 都在噪声范围内。这个文件从官方产物几分钟就能转出来。
八、llama.cpp 对照与倍率的边界(重点章节)
这部分我要写得比结论更谨慎,因为它是整篇文章最容易误导人的地方。
同机同权重的对照数据
Bonsai 2 27B decode 会话均值 | llama.cpp: 65.14 tok/s | NInfer: 176.6 tok/s
Bonsai 投机解码 | llama.cpp: 未开(草稿 0) | NInfer: MTP 2 · 接受 58.9%
Bonsai max seq | llama.cpp: 522 | NInfer: 262,144
Qwen3.8-27B decode 会话均值 | llama.cpp: 57.59 tok/s(Q4_K_M) | NInfer: 96.3 tok/s(int8 产物)
Qwen 投机接受率 | llama.cpp: 45.3%(2.36 tok/verif) | NInfer: 59.3%
Qwen max seq | llama.cpp: 262 | NInfer: 131,072
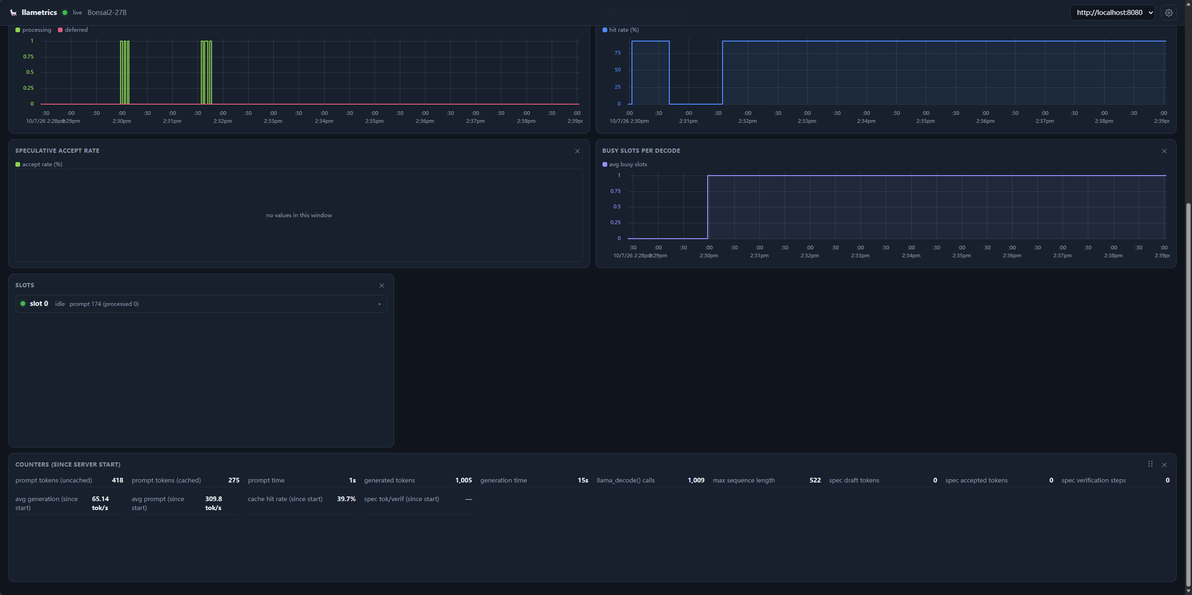
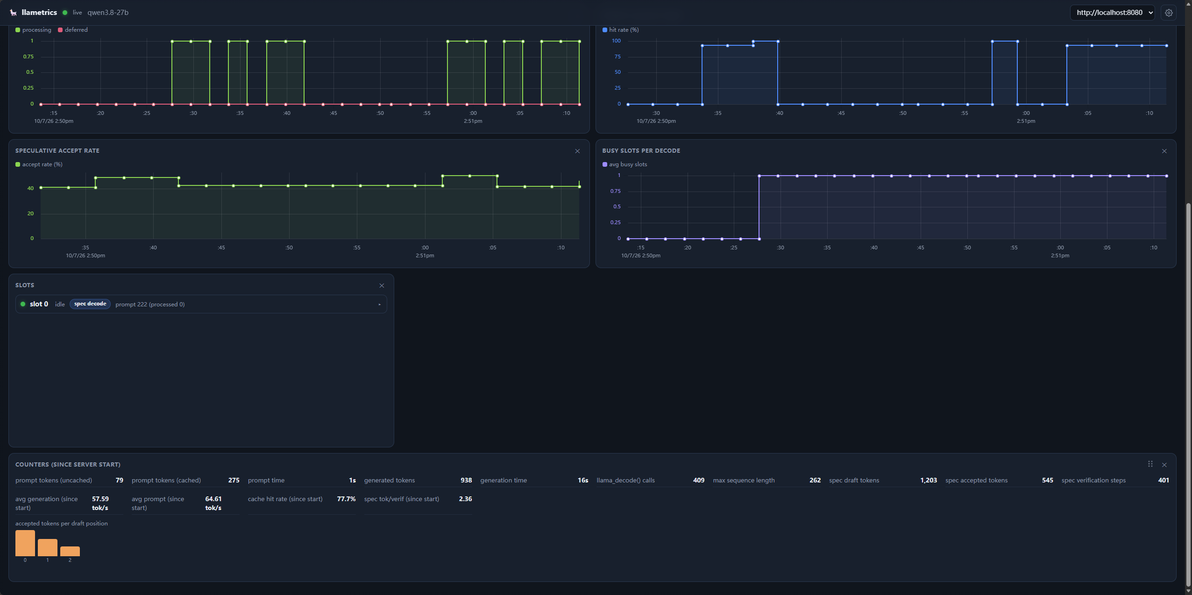
按会话均值算,倍率是 Bonsai 2.71×、Qwen3.8-27B 1.67×。
但这两个倍率都不是 kernel 对比
我必须把边界说清楚,否则上面那两个数字就是耍流氓:
Bonsai 那组,llama.cpp 根本没开投机。 监控页上 spec draft tokens = 0,而 NInfer 开了 MTP 2、接受率 58.9%。倍率里含一整套投机解码的贡献。
Qwen 那组,两边都开了投机,但接受率差了 14 个百分点(59.3% vs 45.3%)。这一截不是 kernel 的功劳,反而主要来自工作负载 —— 长上下文里的复述、总结、改文件类任务,草稿更容易被接受。
上下文规模完全不同。 我的 NInfer 会话跑的是 1.1 万–3.3 万 token 的长 prompt,llama.cpp 那两轮 max seq 只有 522 和 262。长上下文 decode 本来就更慢,所以这一点对 NInfer 是不利条件,方向上会压低倍率。
权重格式不同。 llama.cpp 侧是 Q4_K_M GGUF,NInfer 侧是自家 int8 产物,只能算同档量级。
所以正确的读法是:
2.71× / 1.67× 是"整机整体对比"——同一张卡、同一个模型权重、两套引擎各自的最佳实践配置下的实际体感差距。它不是纯 kernel 性能比。
要拿到干净的倍率,得把 llama.cpp 侧也用同样的长上下文、同样打开投机重测一轮,并且把接受率差异单独拆出来。这件事我还没做,所以文章里不把它当结论。
那为什么还要放这组数据?
因为它回答了一个更实际的问题:在你手上这张卡、你要跑的这个模型上,换成 NInfer 到底能快多少。 这是端到端的、可直接感知的差距 —— 只要你清楚它包含了哪些东西。
九、NInfer 为什么快:核心机制
1. 手写 kernel,没有通用计算图
每层按权重格式直接选手写 kernel。这个取舍是全部性能的来源,也是全部局限性的来源。
2. 三元权重(Bonsai)
三值码按 base-3 五权重/字节打包(t5_g128_fp16),加上每 128 权重一个 FP16 scale,平均 1.75 bit / 权重。
decode 是 memory-bound:激活量化到 int8,走 dp4a 指令
prefill 是 compute-bound:走 int8 tensor core(m16n8k32)
Prism 原版的 Hadamard 旋转被融合进激活量化,不单独跑 kernel
3. Groupwise 量化(Qwen3.8)
Q4/Q5 码 + 每 64 权重一个 FP16 scale,共享内存里反量化喂 BF16 GEMM。int8 产物则直接让码喂 int8 tensor core。
4. 投机解码:MTP + n-gram chain
关键性质:MTP 的每个草稿 token 都由模型本体验证,所以输出分布和不开投机完全一致。 投机只改变速度,不改变质量 —— 这是它敢当默认配置的原因。
n-gram chain 在此之上再叠一层:维护 16 MiB 的 n-gram 草稿池(8-token 键),把上下文里出现过的文本续进草稿。
什么时候收益最大?输出大量复述输入的时候 —— 改文件、生成 JSON、写 tool call,一轮能接受 10+ 个 token。这也解释了为什么上表里长上下文会话的接受率能到 59%。
5. 长上下文三件套
分页 KV:int8 或 E8 格 4-bit / 2-bit 编码
warp 特化 prompt attention:producer warps 打分 / worker warps 累加
每轮 decode 整层重放为一个 CUDA Graph
被拒 token 的线性注意力状态靠 ReplaySSM 回滚
6. 服务化与可观测性
/monitor 图形界面、/metrics(llama.cpp 兼容的 Prometheus 指标)、/slots + save/restore/erase(6.9K token 会话约 0.1s 恢复,重启不丢上下文)、前缀复用 + --auto-long-anchors。
十、踩坑清单
最大的坑:显卡同时接显示器,吃掉 15–18% 解码速度
这是我自己踩了很久的坑。
现象:同一个模型、同一批 prompt,测出来的解码速度比别人低一截。
原因:不是 CUDA、不是量化 —— Windows 桌面合成器每帧都在抢 GPU。桌面一动(动画、视频、拖窗口),CUDA 就得让路。
数字(来源:上游 4090 实测,但机制是 Windows 的,与显卡型号无关):
显示配置: 直驱 4K @ 120Hz | 每轮 MTP decode 损失: -18%
显示配置: 直驱 4K @ 60Hz | 每轮 MTP decode 损失: -15%
显示配置: 显示器接核显 / 静态 dummy plug 4K60 | 每轮 MTP decode 损失: 0%
对策:显示器插主板核显或第二块卡;退一步用 60Hz,并在生成时保持桌面静止。静态 dummy plug 4K60 实测零影响,无头跑完全没问题。
推论:跨 run 比较 tok/s,必须固定显示配置,否则数据不可比。这也是为什么所有对比数据都强调「同 session、同显示配置」。
长上下文 decode 会变慢
Bonsai 一轮 MTP 在 128K 深度是 18.5–20.8 ms,短上下文 12.8 ms —— 全部增量都在 attention。
零售 4080 SUPER 大多是 16GB
我这张是 32GB 版,所以 --max-context 131072 和 --max-concurrency 3 能这么配。如果你的是零售 16GB 版,这两个参数都要相应下调,别照抄。
十一、限制与适用边界
只讲优点不诚实,所以把限制也列全:
架构性限制
单卡 · 单进程 · 单模型:无多卡、无权重卸载、无请求抢占与优先级
prefill 串行执行 —— 一条长 prompt 会推迟其他泳道的首 token
硬件性限制
NVFP4 / W4A4 用不了:那是 Blackwell tensor core 的特性,sm_89 上没有这些指令。Ada 只能走 groupwise int8/int4 路线。这也是上游 5090 版和这个版本不能简单合并的原因。
DFlash2 不支持 Bonsai 三元输出头(Bonsai 用 MTP)
Linux 构建与 Dockerfile 继承自上游,本分支未复验
我的实测缺口(如实列出)
编辑类负载的峰值还没测(4090 上是 532 tok/s)
llama.cpp 侧同条件的重测还没做 —— 也就是第八节讲的倍率边界
十二、结论
同架构不等于同二进制。 4080 SUPER 和 4090 同为 sm_89,指令集完全兼容,但 wave 几何是按 SM 数标定的。把目标 SM 数做成构建选项,80 SM 就成了官方支持的第二档 —— 一个选项,两条编译期断言,一份源码出两个二进制。
原生 Windows 跑本地大模型,现在完全可行。 MSVC 直接编译、CUDA 运行时静态内嵌、.bat 启动器,交付形态是"解压即用"。门槛从"会配 Linux"降到"会双击",不需要 WSL2、不需要 Docker、不需要 GPU 直通。
专用引擎在单卡上确实有代差优势,但要诚实说明它的构成。我这张卡上 Bonsai 176.6 tok/s、Qwen3.8-27B 96.3 tok/s,都远高于同机 llama.cpp —— 而这个差距里既有 kernel 和 KV 路径的功劳,也有投机配置和工作负载的贡献。把两者混在一起报"快 2.71 倍",是不诚实的。
fork 要说得清、验得出。 改动只有一个 CMake 选项,但配上完整的构建手册、retarget 验证计划、编译期断言和实测数据,别人能复现、能验证。这比改个 README 署名的 fork 有意义。
资源
本项目
仓库(Apache-2.0):https://github.com/zjwan461/ninfer-sm89-windows
A C++20/CUDA inference engine specialized for one NVIDIA sm_89 card — RTX 4090 (128 SMs) or RTX 4080 SUPER (80 SMs), selected at build time with NINFER_TARGET_SM_COUNT
仓库内相关文档:
文档: ninfer-windows-build-manual.md | 内容: 中文构建手册,从零装 vcpkg 到打包两个变体
文档: ninfer-4080s-80sm-retarget-plan.md | 内容: 80 SM 重定向设计与验证计划
文档: WINDOWS_PORT.md | 内容: Windows 移植全记录 + 实测
文档: docs/llamacpp-comparison.md | 内容: 与 llama.cpp 的完整对比(方法学写得很细)
上游仓库(血统链,按时间顺序)
仓库: Neroued/ninfer | 链接: https://github.com/Neroued/ninfer | 贡献: 引擎本体,为 RTX 5090(sm_120a)从零开发
仓库: Don-Chad/ninfer-3090 | 链接: https://github.com/Don-Chad/ninfer-3090 | 贡献: sm_86 兼容层、ReplaySSM、MTP3、C1–C8 批处理
仓库: sergiuszm/ninfer-4090 | 链接: https://github.com/sergiuszm/ninfer-4090 | 贡献: Ada 注意力 prefill 重调、E8 格 4-bit KV、llama.cpp 兼容的 /metrics + /slots
仓库: UDPSendToFailed/ninfer-4090 | 链接: https://github.com/UDPSendToFailed/ninfer-4090 | 贡献: RTX 4090 上的 Qwen3.8-27B 移植
仓库: JGamboa/ninfer-4090-windows | 链接: https://github.com/JGamboa/ninfer-4090-windows | 贡献: 原生 Windows 构建、Ternary Bonsai 全链路、n-gram 投机、并发泳道
血统链里还有 shantanu 的 4090 分支(贡献 llama.cpp 风格的 timings),我没找到稳定的仓库地址,故未列入。
模型
模型: Ternary Bonsai 2 27B(6.4 GiB) | Hugging Face: https://huggingface.co/jgamboa/Ternary-Bonsai-2-27B-NInfer-4090
模型: Qwen3.8-27B · int8 产物(19.0 GiB) | Hugging Face: https://huggingface.co/jgamboa/Qwen3.8-27B-NInfer-4090
模型: Qwen3.8-27B · 上游原版 | Hugging Face: https://huggingface.co/neroued/Qwen3.8-27B-NInfer
数据说明
为避免混淆,本文所有速度数据的来源如下:
数据: Bonsai 176.6 / Qwen3.8-27B 96.3 tok/s 等 | 来源: 本机 RTX 4080 SUPER | 条件: Windows 11 / CUDA 13.1 / VS 2022
数据: llama.cpp 65.14 / 57.59 tok/s | 来源: 本机 RTX 4080 SUPER | 条件: 同上,llametrics 监控页
数据: 218 / 532 / 6,027 / 1.7–1.9× 等 | 来源: 上游 RTX 4090 | 条件: Windows 11 / 驱动 595.97 / CUDA 13.4
数据: 显示税 -18% / -15% | 来源: 上游 RTX 4090 | 条件: 4K 桌面,比例为机制性数据
跨来源的数字不能直接比较 —— 显卡、驱动、CUDA 版本、投机配置和上下文长度都不同。
