
面向城市交通治理的出行数据可视化分析
项目简介
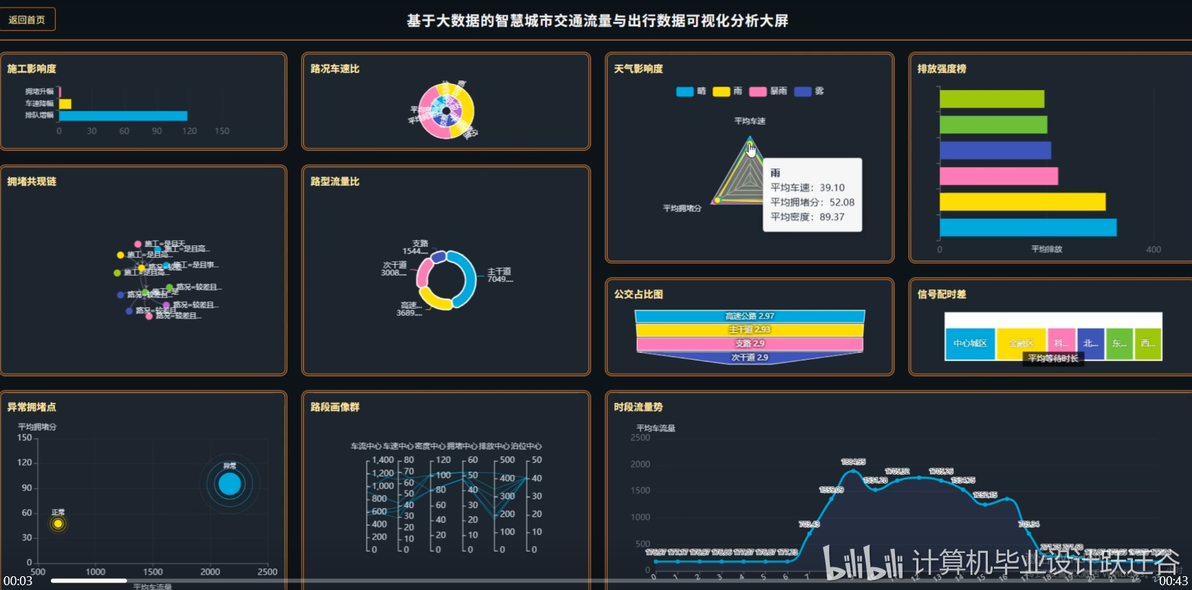
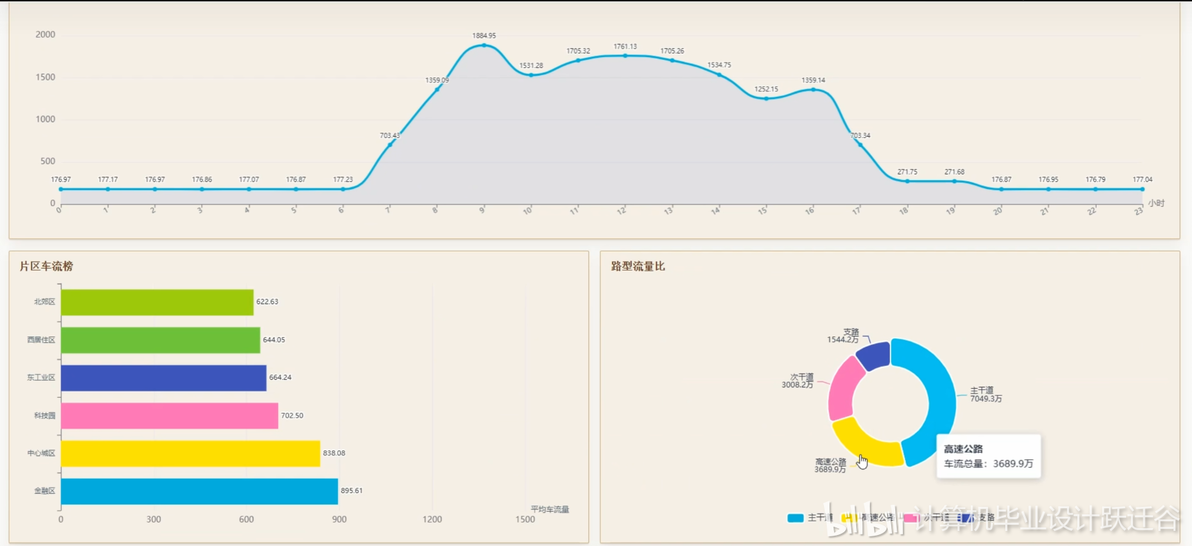
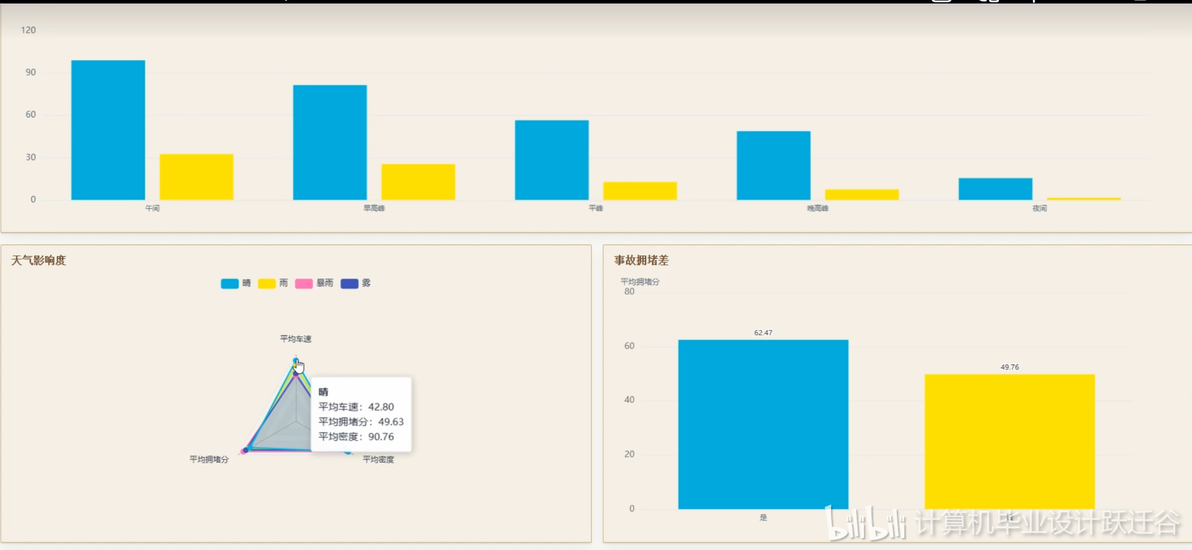
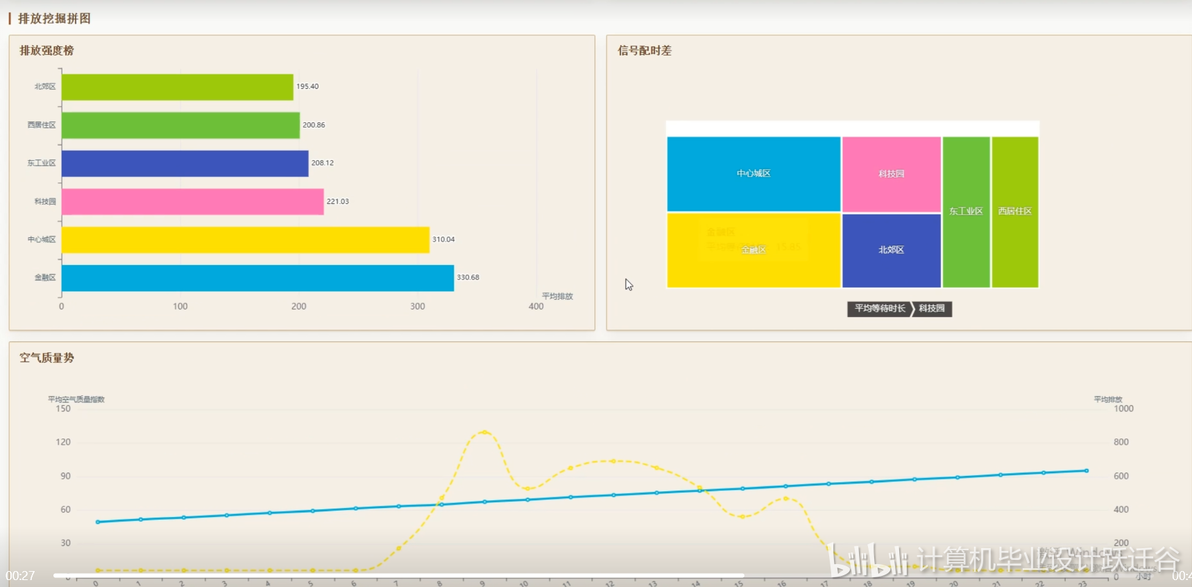
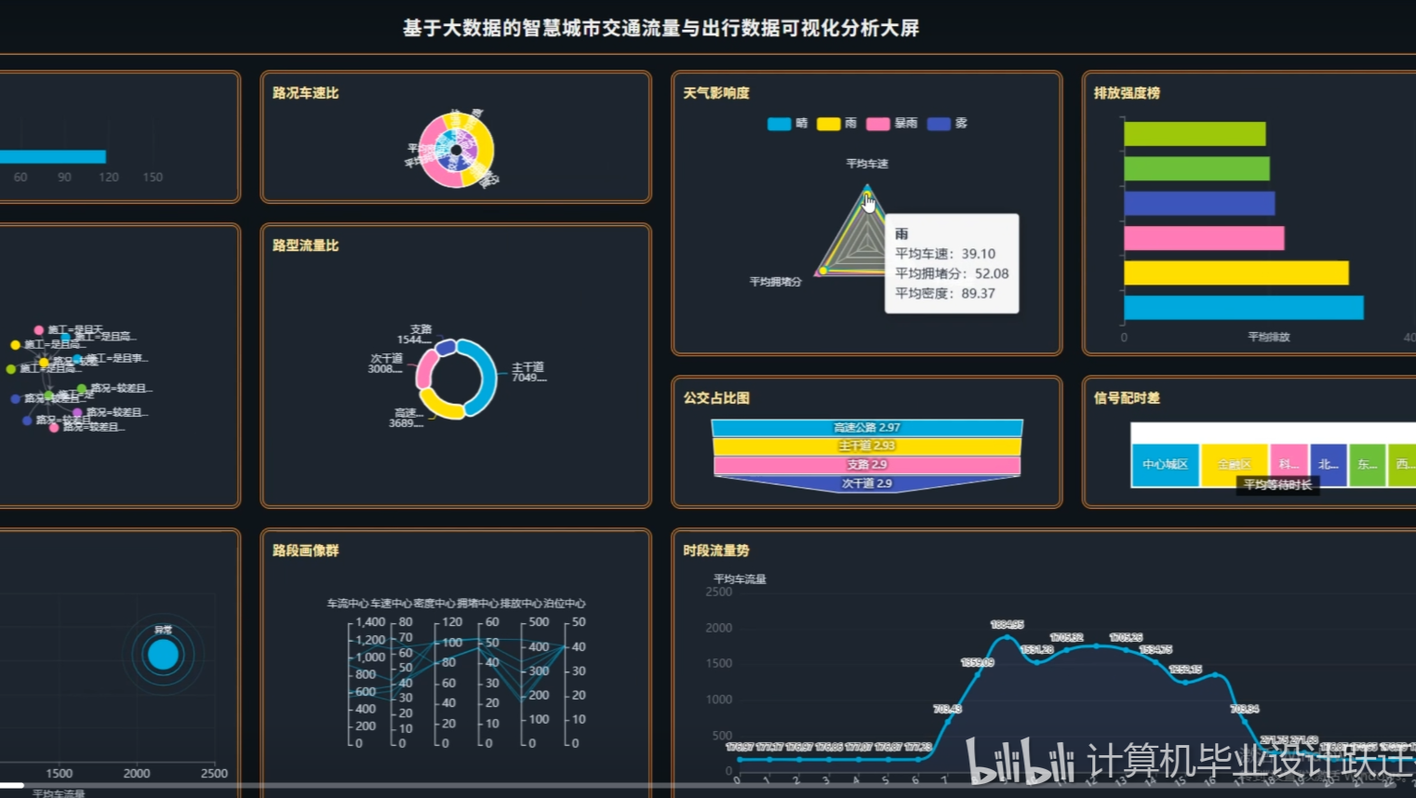
本项目面向智慧城市交通治理与出行服务场景,基于大数据技术构建了一套覆盖数据上传、预处理、分布式分析与结果输出的交通流量与出行数据分析系统。系统利用 Hadoop 分布式文件系统完成交通出行数据的存储与管理,借助 Spark 对大规模数据进行多维度计算,围绕片区车流、道路类型、时段趋势、高峰拥堵、天气影响、事故施工、停车占用、排放强度、公交占比、信号配时、空气质量、路段画像、拥堵关联规则和异常拥堵识别等方向展开分析,并将结果统一导出,为交通态势可视化展示、拥堵成因挖掘和智慧交通决策提供数据支撑。
核心亮点
全流程大数据处理:从数据上传、数据清洗到分布式分析,形成完整的数据处理链路。
多维度交通分析:覆盖时间、空间、天气、事故、施工、环境、公交等多个分析视角。
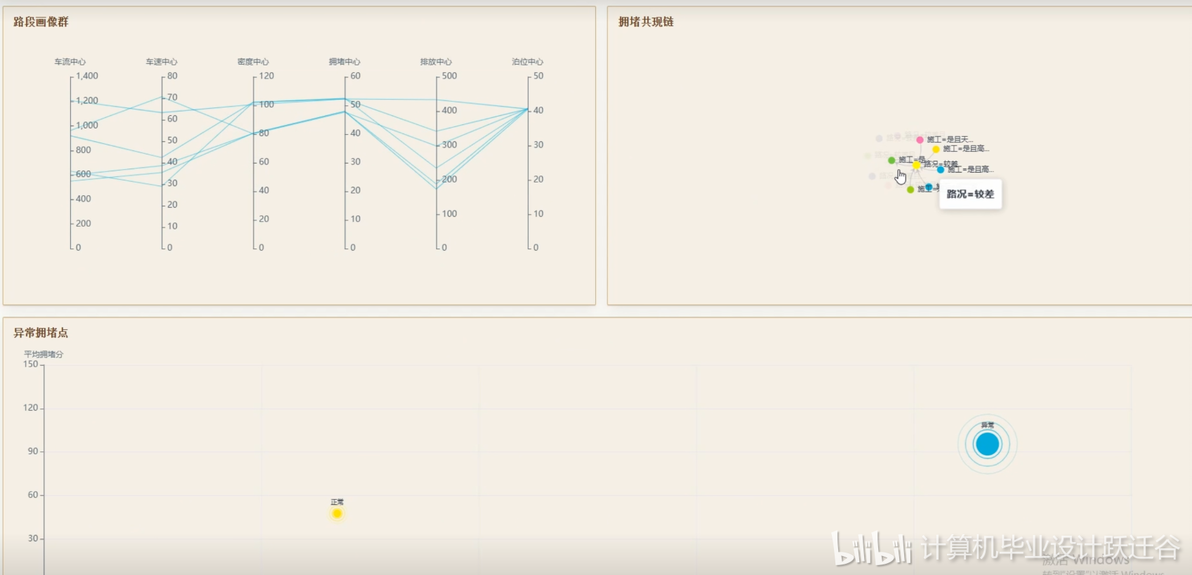
智能挖掘能力:引入聚类、关联规则挖掘和异常检测,发现路段画像与拥堵共现规律。
可视化友好输出:分析结果统一整理并导出,便于接入可视化大屏、图表和报告。
环境适应性强:支持分布式存储读取,也保留本地回退能力,便于不同环境部署演示。
业务价值明确:可辅助交通管理部门识别拥堵高发区域、优化信号配时、评估天气与施工影响。
系统功能
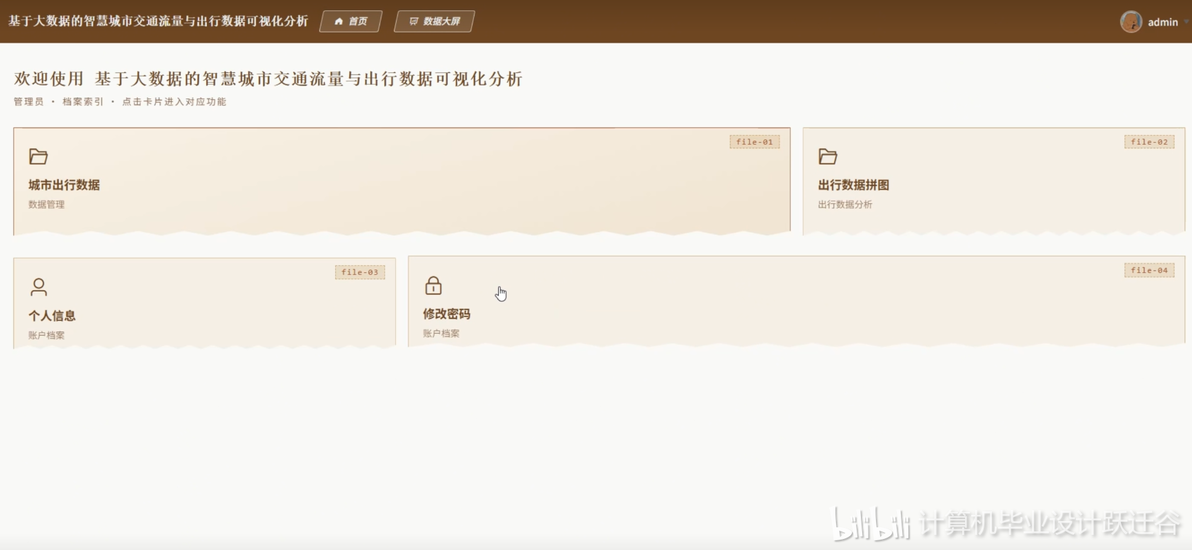
数据上传与存储:将城市交通出行数据集上传至分布式文件系统,并建立项目目录结构。
数据预处理:完成缺失检查、类别字段中文映射、布尔标志转换和数值规整。
交通流量分析:统计片区车流排名、道路类型流量占比和小时流量变化趋势。
拥堵态势分析:对比不同峰期的拥堵程度、等待时长和严重拥堵占比。
环境影响分析:分析天气、路况、事故、施工等因素对车速和拥堵的影响。
出行服务分析:评估停车占用率、公交出行占比、信号配时和空气质量变化。
智能挖掘分析:开展路段画像聚类、拥堵关联规则挖掘和异常拥堵识别。
结果输出展示:将各项分析结果导出为结构化文件,供可视化展示和报告使用。
技术环境
| 类别 | 技术/工具 |
| 分布式存储 | Hadoop HDFS |
| 分布式计算 | Apache Spark |
| 开发语言 | Python |
| 数据处理 | Pandas、Spark SQL |
| 机器学习 | scikit-learn、Spark MLlib |
| 挖掘算法 | K-Means、FP-Growth、Isolation Forest |
| 运行环境 | Linux、Java、Hadoop、Spark |
项目展示