
半年以前要是有人跟我聊"提示词工程",我大概会觉得那是研发工程师才碰的东西,跟我这个非技术岗的人没关系。那时候我手里的 AI,不过是"豆包"——用来查查明天天气、问问常识问题的聊天搭子。点开对话框,敲一句"今天会下雨吗",拿到答案就关掉,从没想过"怎么问"本身也是一门学问。
01 为什么写下来:给同样非技术的你
转变发生在过去这一个月。随着越来越多的跟 AI 打交道,我不再满足于"随便问问"。我开始自己摸索:看文章、找教程、翻指南、把同一个问题换着花样问上几十遍,对比哪一版回答更靠谱;也厚着脸皮,逮着身边的研发同事就请教——"为什么我这么问它听不懂?""这句话该怎么改?"在一遍遍试错和同事的点拨里,我慢慢揣摩出味道来:原来同样的模型,问法不同,出来的东西能差出一个档次;原来"提示词"不是什么玄学话术,而是把脑子里的需求讲清楚、讲明白的能力。
当我真正搞懂"提示词到底在起什么作用、又该怎么写好",回头看一个月前的自己,最大的落差不是记住了多少术语,而是终于知道"该怎样跟 AI 把话说清楚"。这也正是我把这段学习体会整理出来、分享给各位同事的原因——如果你也和我一样,没有研发背景、没有开发经验,却想真正用好大模型,希望这篇能帮你少走一点我走过的弯路。
提示:哪怕你完全不碰代码,这套方法也能直接用在日常工作里——写文案、整理纪要、改邮件,套路一模一样。
02 为什么提示词在大模型时代"身价上涨"
在传统的软件开发里,人与系统的交互靠的是严格的接口契约:字段类型、调用顺序、错误码,差一个字符就报错。大模型的出现把这套契约"软化"了——你用自然语言说话,模型去猜你的意图。这带来了前所未有的灵活,也带来了新的不确定性:同样一个问题,换种说法,结果可能天差地别。
于是“提示词工程”(Prompt Engineering)从一个边角技巧,变成了连接人与模型的核心工程能力。需要澄清一个常见误解:提示词不是"咒语",也不需要玄学式的措辞。它的本质是一种
接口协议——把模糊的人类意图,翻译成模型能够稳定执行的指令。
核心判断提示词解决的从来不是"模型会不会"的问题,而是"模型知不知道你此刻要它做什么、做成什么样子"。写好提示词,本质是把你的思考过程外化并结构化,它会反过来逼着你自己把需求想清楚。
这种能力之所以重要,有三个现实原因:
性价比。相比重新训练或微调一个模型,优化提示词几乎零成本,却常常能把同一底座模型从 60 分推到 90 分。
普适性。无论你用哪家模型(GPT、Claude、国内的文心/通义/混元等),提示词的基本原则是通用的;掌握它,迁移成本极低。
可逆、可迭代。改一句提示词比改一次模型训练便宜几个数量级,适合业务快速试错。
需要指出的是,提示词并非万能。当任务需要模型掌握其预训练中没有的私有知识、或需要稳定复现某种专属风格时,仅靠提示词会触到天花板——这正是下文要讨论的"边界"问题。但在绝大多数日常与工程场景中,提示词是第一道、也是最该先打磨的杠杆。
03 大模型究竟如何"读"提示词
要写好提示词,先要理解模型是怎么处理它的。下面用四条线索把黑盒拆开一点。
从"补全"到"遵循指令":指令微调改变了什么
早期的语言模型(如 GPT-2)本质上是"文本补全器":给它前半句,它预测后半句。你问"法国的首都是",它补"巴黎"。但如果你问"把下面这段话翻译成法语",它未必会照做——因为它没被训练去"理解指令"。
2022 年的InstructGPT
(Ouyang等)是转折点:研究者用"人类示范 + 排序反馈(RLHF)"对模型做了指令微调,让模型学会"按照指令行事",而不是单纯续写。这一步让"提示词"真正成立——因为模型被显式训练成把输入整体当作“任务说明书”来响应。后续的 T0(Sanh 等,2022)等多任务指令微调研究,进一步验证了"用自然语言描述任务"可以成为通用的任务接口。
上下文学习(In-Context Learning):示范即编程
2020年Brown等在《Language Models are Few-Shot Learners》中发现一个反直觉的现象:大模型不需要改权重,只要在提示词里给几个例子,就能学会新任务。这叫上下文学习(In-Context Learning, ICL)。
这意味着提示词本身就是一种"程序":你给的示例(few-shot)不是训练数据,而是运行时注入的上下文,模型在生成时临时"照着学"。这就是为什么"给例子"往往比"讲道理"更管用——例子直接定义了输入到输出的映射。
当你难以用文字说清格式要求时,直接给1至3个"输入→输出"样例。对代码生成、数据抽取这类强格式任务,few-shot 的性价比极高。
注意力机制的直觉:提示词是"软约束"
从模型内部看,提示词里的每个 token 都会通过自注意力(Self-Attention)与其他 token 交互。你写在提示里的"角色设定""格式要求""约束",会被模型在生成每一个字时"看见"并参考。它不像传统程序的硬规则那样绝对,而是一种软约束:写得好,约束力就强;写得含糊,模型就按自己的"默认偏好"自由发挥。
这也解释了两个经验法则:(1)重要指令放前面或用分隔符(如###、""")包起来,能减少被长上下文"稀释";(2)说“要做什么”比“不要做什么”更有效,因为前者给出了明确方向,后者只排除了一个错误选项,模型仍可能在剩余空间里乱跑。
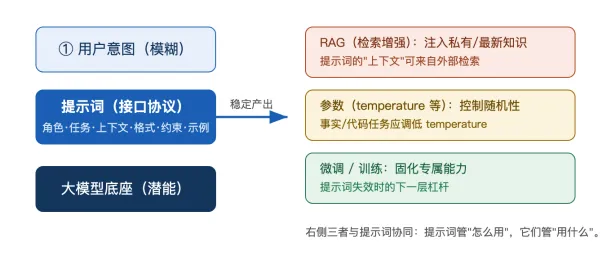
提示词在 AI 应用栈中的位置
把大模型应用想像成一个分层栈,提示词处在"用户意图"与"模型底座"之间,是唯一可由业务侧直接掌控、且零成本迭代的那一层。
04 提示词的五大作用(分维度拆解)
把"写好提示词"的目标拆开,它实际在承担五种功能。理解这五点,才知道该往提示里塞什么。
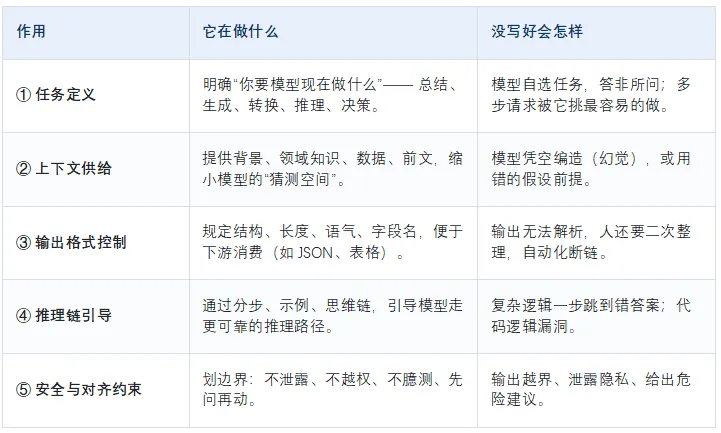
小白提示:"上下文供给"不是把公司文档全粘进去。给得越多越未必越好——要给和这个任务真正相关的那部分,并说明"从这段里取什么"。
05 如何写好提示词:方法论与框架
主流框架对比:CRISPE / CO-STAR / RTF
业界沉淀了若干"提示词模板"。它们名字不同,内核高度一致——都是为了不漏掉关键要素。下面横向对比,便于你挑一个顺手的。
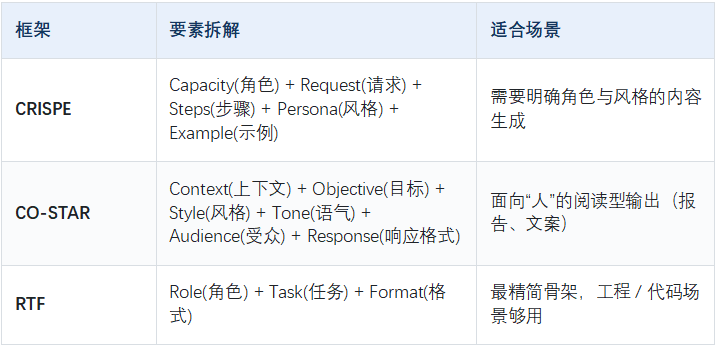
这些框架不是教条。实战中更常见的是取其交集、按任务裁剪。Anthropic 在官方指南里给了一条朴素却管用的"黄金法则":把你的提示词拿给一个对该任务几乎无背景的同事看,如果他看不懂,模型也会看不懂。
提示词"六要素"套路
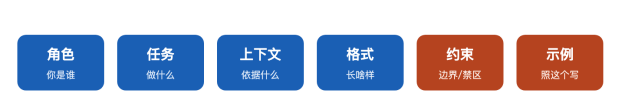
综合上述框架与一些实战经验,我们把它收敛为更容易记忆的六要素:角色、任务、上下文、格式、约束、示例。写提示时按这六格逐项填空,基本不会跑偏。
上篇小结:框架和要素都清楚了,但“听懂”和“会用”之间还差一组对照。下一篇,我们用四个真实工作流里的“烂提示 vs 好提示”,把这些方法落到能直接抄的清单上。
