
你有没有想过一个问题:
为什么 Claude Code 可以连续运行几个小时,甚至修改几十个文件,却不会因为 Context Window 爆炸而崩溃?
按照传统聊天机器人的逻辑,历史消息越积越多,Token 应该早就超过模型限制。
但实际上,Claude Code 并不是简单地把所有历史消息重新发送给模型:
你在界面看到的聊天记录,并不是模型真正收到的内容;
Claude Code 并没有“记住所有历史”;
它通过一套复杂的上下文管理机制,让 Agent 可以持续工作。
本文将深入解析 Claude Code 背后的核心机制:
Context Management(上下文管理)
Token Compression(上下文压缩)
Session Resume(会话恢复)
Agent Runtime State(Agent运行状态恢复)
上下文管理的本质,不是“记住一切”,而是让不同版本的历史各司其职,并且让每一次取舍都能被重放。
看懂这些机制,你也会理解未来 AI Agent 为什么能够长期自主运行。
本文主要内容:
Claude Code 为什么不会被 Context Window 撑爆?
一场会话为什么存在三个不同版本?
请求发送前,上下文经历了哪些处理?
Claude Code 如何在压缩上下文后继续保持工作状态?
Resume 为什么恢复的是完整运行环境?
AI Agent 长期运行背后的设计原则
一场会话,其实有三个版本
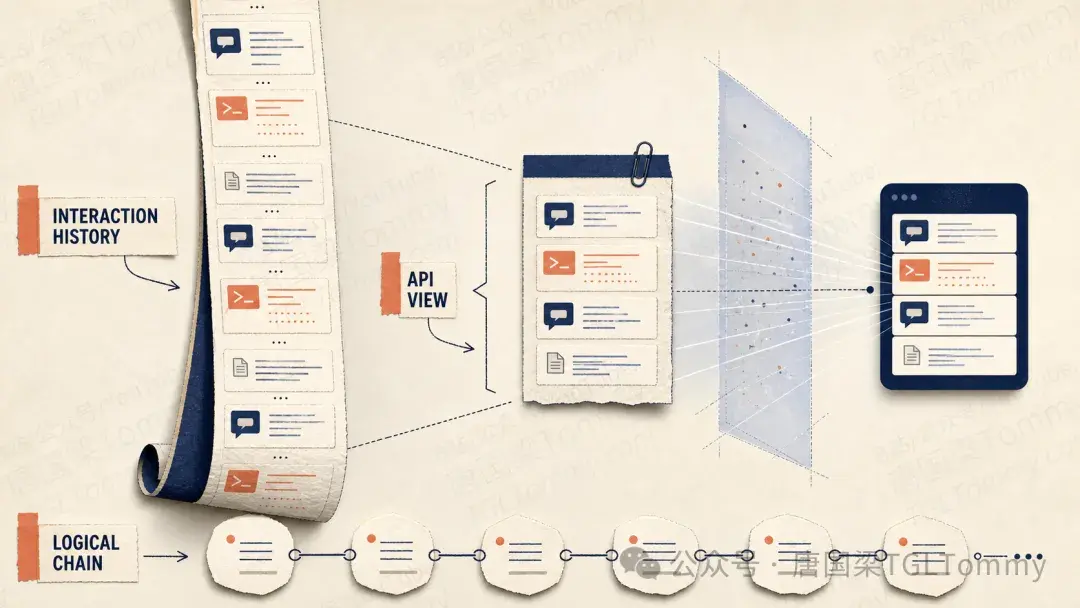
同一场会话里,至少并存着三份并不相同的历史。
交互历史是屏幕上可以回滚的聊天记录;接口视图是当前这一轮真正发给模型的消息。
逻辑链则是磁盘记录中决定“下一轮从哪里继续”的活动主线。
三者可以同时不同:界面里仍能看到的工具输出,可能早已从接口视图消失;接口里已经不再携带的旧消息,磁盘上却可能一个字都没少。
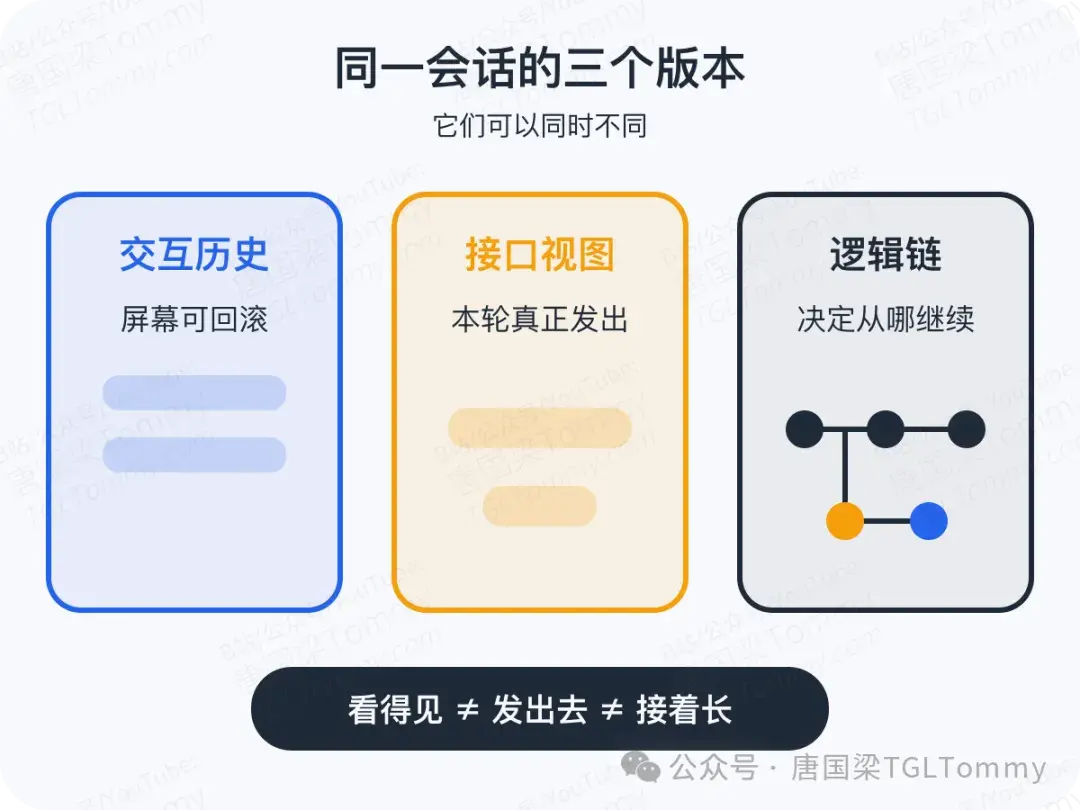
因此,分析任何压缩机制,都可以连续追问三件事:它改的是哪一个版本?什么时候触发?原始信息还能不能找回来?
真正挤满窗口的,往往不是对话
模型没有跨请求的天然记忆。每一轮调用,都要重新提交这次推理需要的上下文。聊天文字通常不算最重,大文件、全局搜索和命令输出才是 token 消耗大户。
例如,让工具读取一份五万行日志,一次结果就可能占去窗口的大块空间。几十轮排查之后,即使人的问题只有几句话,累积的工具结果也足以逼近上限。
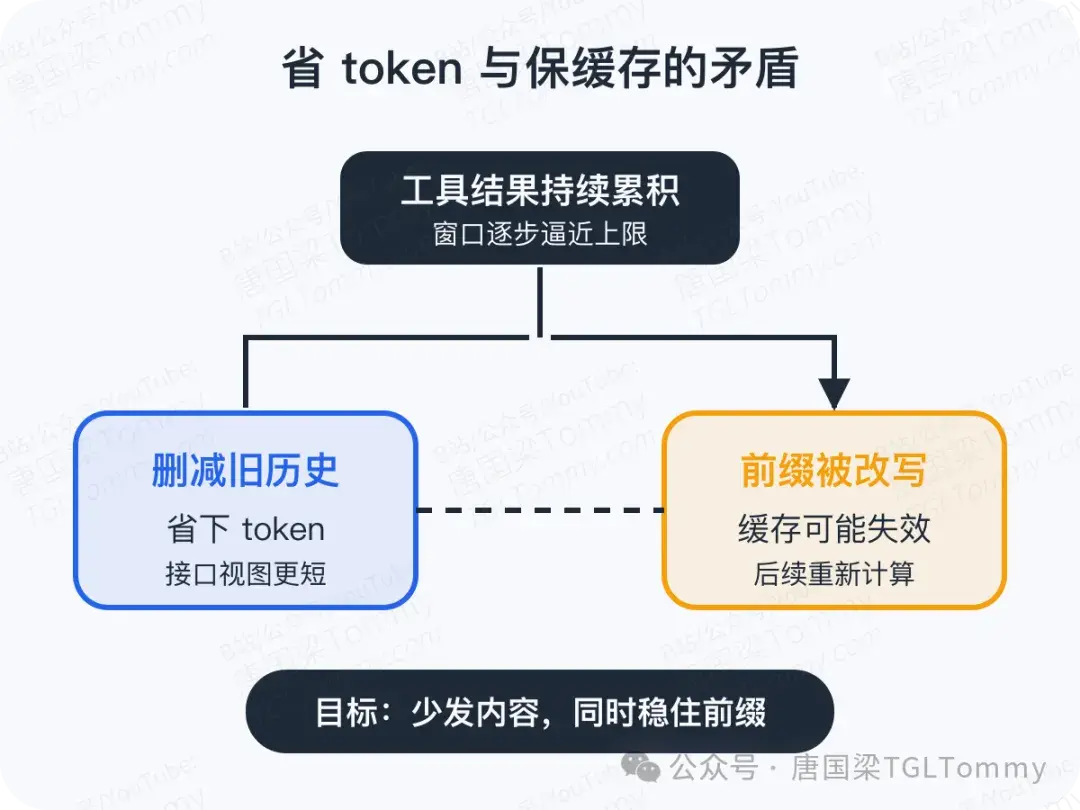
但历史又不能随便改。服务端的提示缓存按前缀逐字节匹配:这一轮开头与上一轮完全一致的部分,可以复用既有计算;前面哪怕改变一个字,后面的缓存也可能失效。
这就形成了核心矛盾:省 token 需要删历史,保缓存却需要前缀不变。 Claude Code 的许多反直觉取舍,都在平衡这两件事。
请求发出前,Claude Code 如何 重新组织上下文?
假设工具刚读完那份五万行日志。请求真正抵达模型前,历史会按次序经历多层处理,但大多数步骤只改“发出去的副本”,不会覆盖磁盘原件。这种做法可以称为投影。
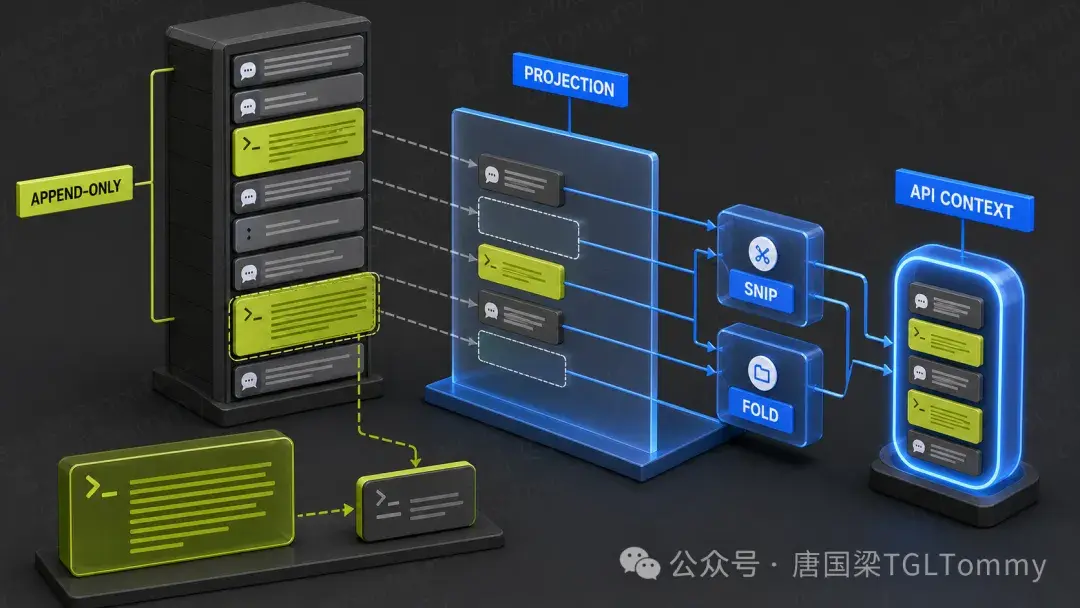
第一步是截取:只保留最近一个压缩边界之后的逻辑历史。随后,不同机制开始处理不同位置的冗余。
工具结果外置会把单个超大结果完整写入磁盘,在接口视图里只留下预览和文件位置;Snip 会移除一段确认无用的中间尝试;微压缩专门清理更早的工具结果;上下文折叠则把一整段旧消息替换为摘要占位符。
如果这些局部手段仍不够,系统才会进行全量压缩:把边界之前的历史总结成摘要,并建立新的逻辑起点。最后再做硬限制检查,确认请求可以安全发出。
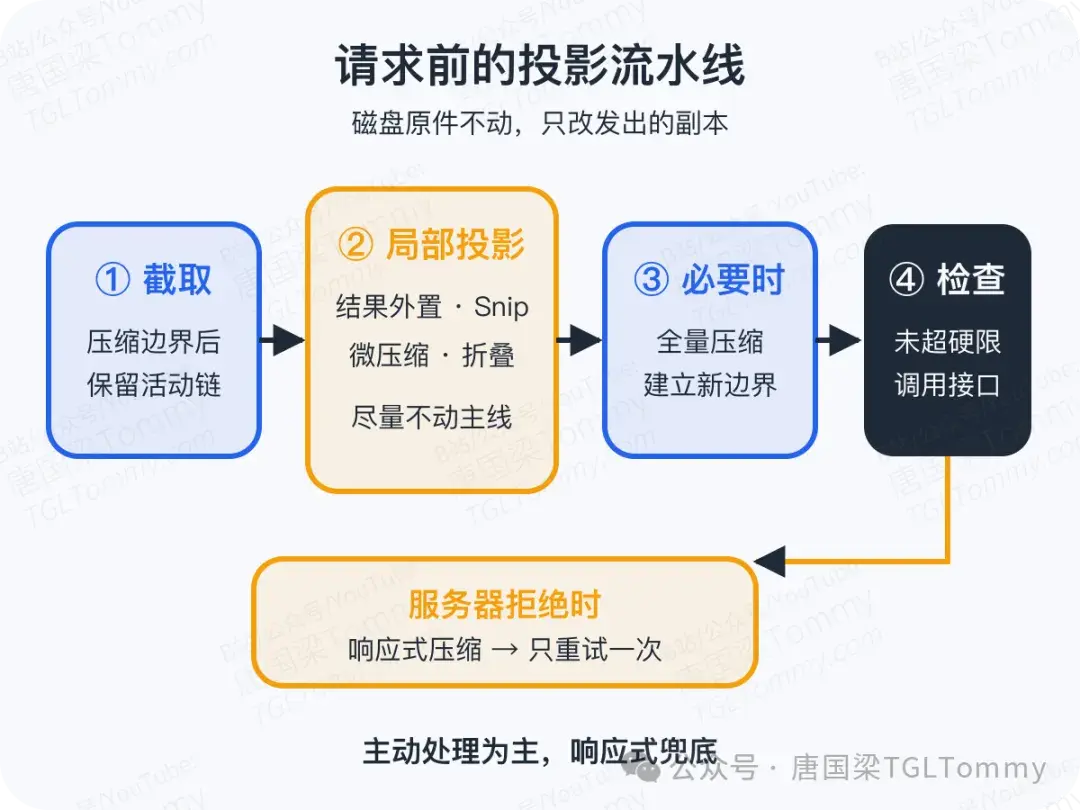
另有一种响应式压缩不在这条主动流水线上。它只在服务器真的拒绝请求后触发,压缩历史并重试一次,避免客户端 token 估算误差把会话直接卡死。
Claude Code 如何在不破坏历史的 情况下压缩上下文?
工具结果外置最适合处理“单条结果过大”。它不做语义概括,而是保存完整原文,仅给模型一小段稳定预览。模型需要细节时,可以按路径再次读取。已经进入请求前缀的预览会尽量保持原样,以免破坏缓存。
微压缩只清旧工具结果,不总结整段对话。缓存已经冷却时,可以直接把旧结果替换成占位文字;缓存仍热时,则可通过接口层的缓存编辑让服务器侧清理内容,本地消息前缀保持不变。
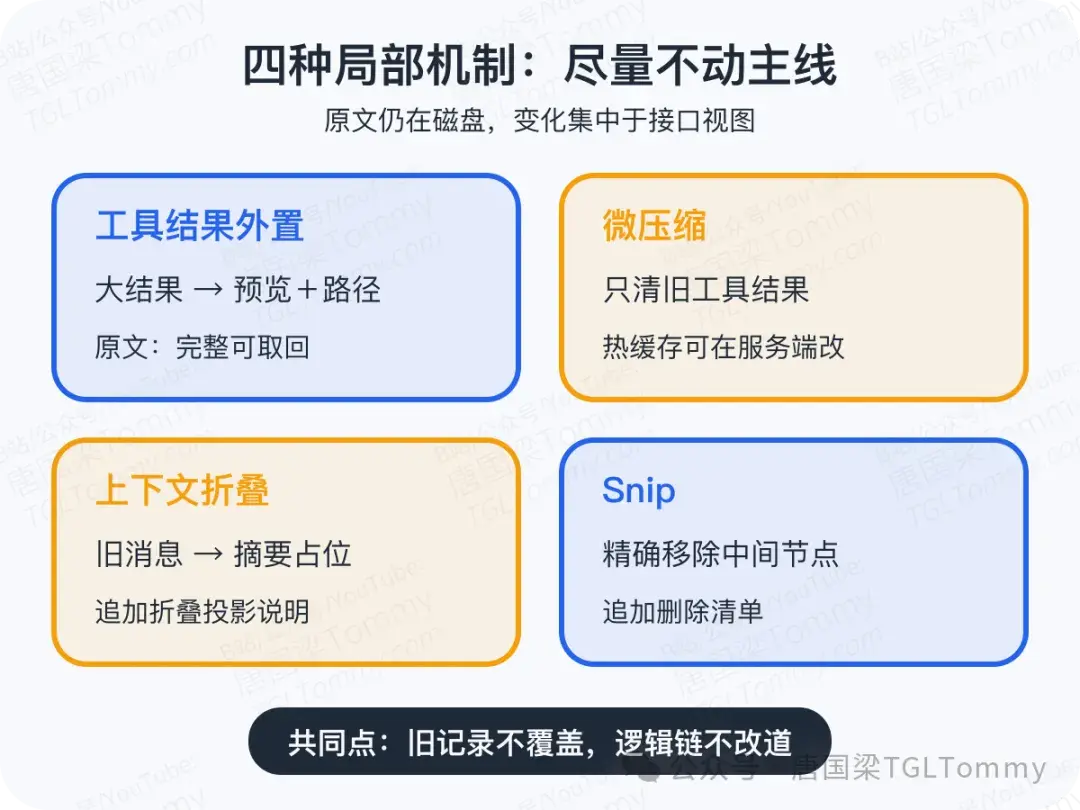
上下文折叠把一段旧历史折成摘要,但不另起会话主线。交互历史与旧消息仍然保留,磁盘只追加一条折叠说明,恢复时再应用同一投影。
Snip 更像一次精确剪除:把走错方向、已经确认无用的中间分支从接口视图移走,同时在磁盘追加被删节点的清单。以后恢复会话,系统仍能删除同一批节点,得到一致的上下文。
这四种机制共同遵守一个原则:不改旧记录,只追加“应该如何看待旧记录”的说明。
全量压缩为什么会改变逻辑链?
局部清理仍无法腾出足够空间时,系统会把较早历史总结成一条摘要。后续请求看到的不再是全部旧消息,而是压缩边界、摘要,以及按预算补回的近期工作状态,例如最近读过的文件与调用过的技能。
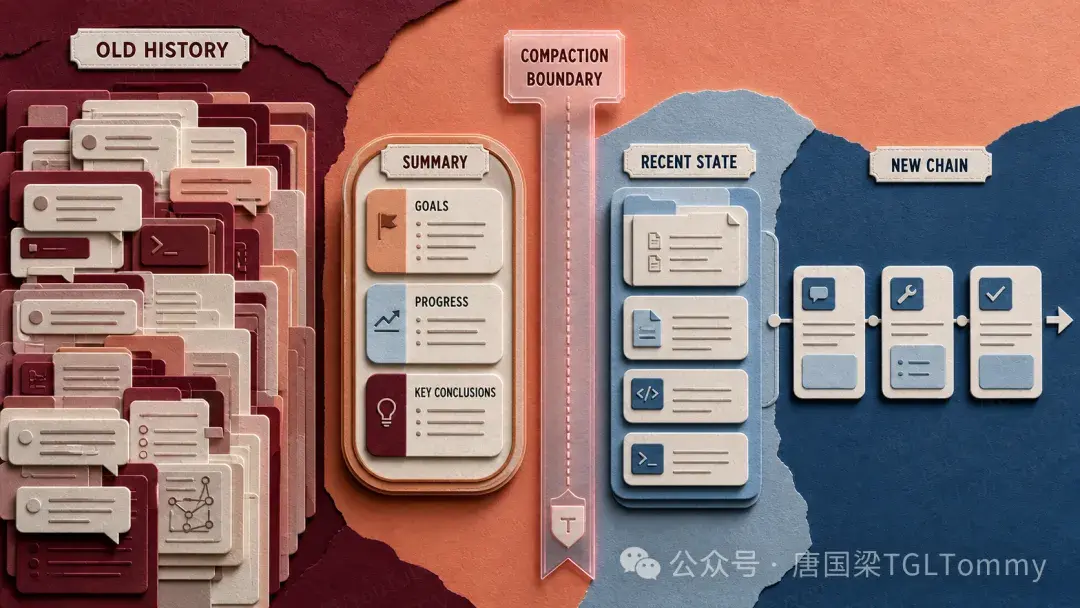
全量压缩与前面最大的区别,是它会在磁盘上写下新的逻辑边界。下一轮从边界之后继续生长,更早的历史仍在文件里,却不再自动进入请求。
摘要本身也需要模型生成。源稿揭示了一个很有意思的取舍:摘要任务可以从主对话分叉出子代理,并尽量沿用主线程配置,让请求前缀命中已有缓存。也就是说,系统宁可容忍摘要输出多消耗一点 token,也要复用已经计算过的大段前缀。
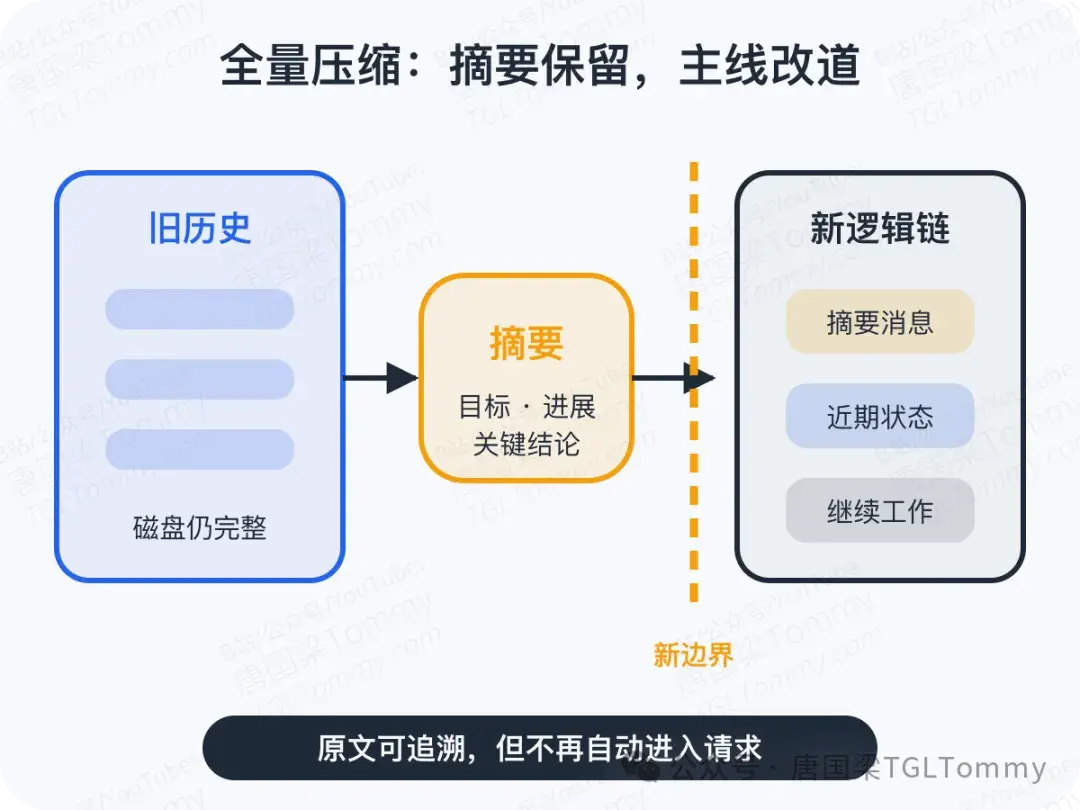
实验性的会话记忆压缩则提前维护结构化笔记,记录目标、进展和关键结论。压缩发生时,可以直接用这份笔记承接旧历史,同时保留最近一段原始消息,减少临场生成摘要的成本。
不过,任何裁切都不能破坏接口协议:工具调用必须和工具结果配对,同一条消息的思考片段不能被切散。 如果名义上的 token 上限与结构完整性冲突,系统宁可多保留一点,也不能提交非法消息。
磁盘记录不是数组,而是一张父指针图
会话文件看上去是一行接一行,逻辑上却不是简单数组。每条消息都指向自己的上一条逻辑消息;并行工具结果、回退和 Fork 都可能从同一个节点分出不同路径。
恢复时,系统先找到当前活动分支的末端,再沿父指针回溯,重建真正需要继续的那条链。全量压缩之所以能建立新起点,也依赖同一结构:新的边界没有父指针,回溯到这里便停止。
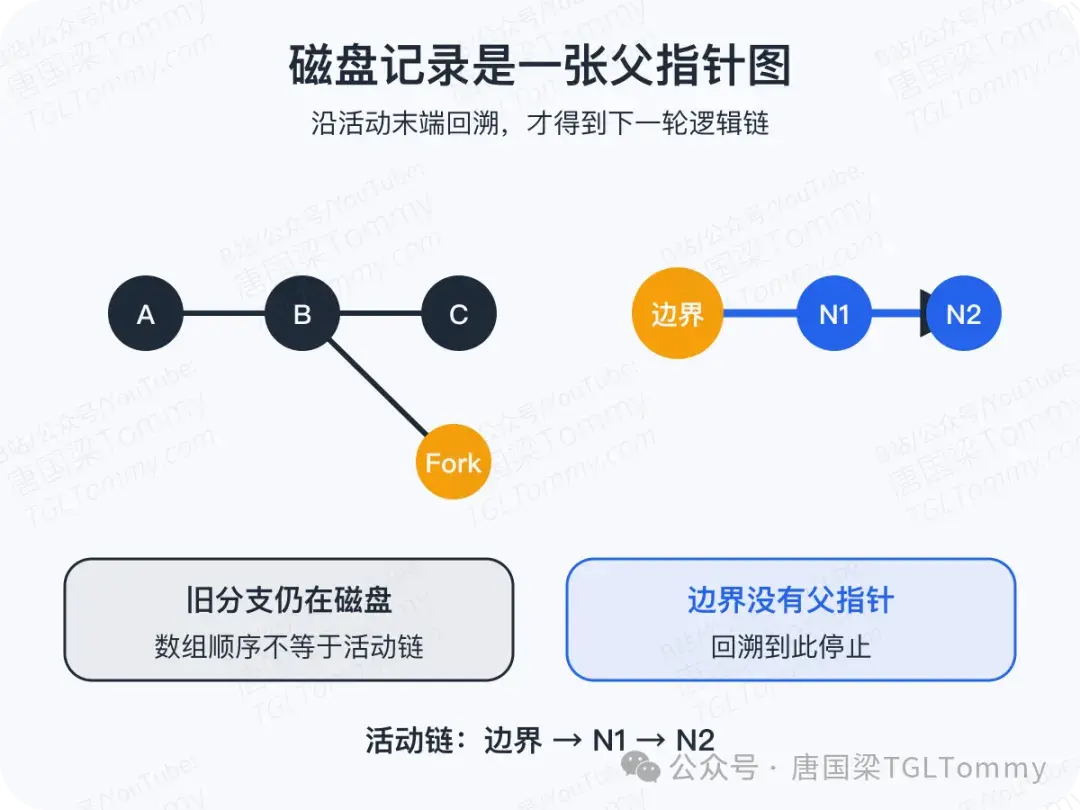
因此,磁盘可以一直保留完整事件,接口却只看到当前活动链经过投影后的结果。保存全部过去与只发送必要上下文,并不矛盾。
Resume 恢复的不是聊天,而是运行时
Resume 远不只是重新读取记录文件。活动消息链重建后,恢复器还要重放外置预览、Snip 清单和折叠说明,并恢复那些会影响下一轮行为的状态:近期文件、已用技能、Agent 模式,以及可能存在的独立 Worktree。
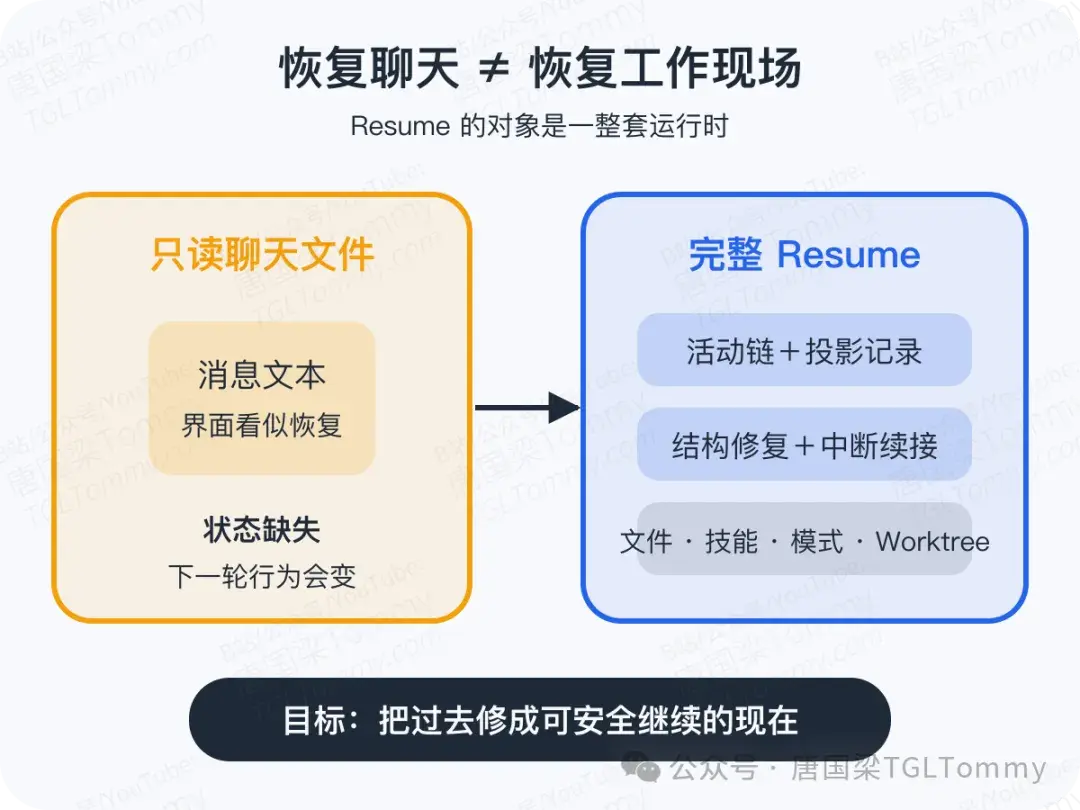
磁盘事件也未必天然合法。程序可能刚写入工具调用就被中断,尚未收到结果;流式输出可能留下孤立思考或空白消息。恢复器必须先修复这些不完整结构,重新保证角色顺序与调用配对,再决定是否补上一条继续执行的消息。
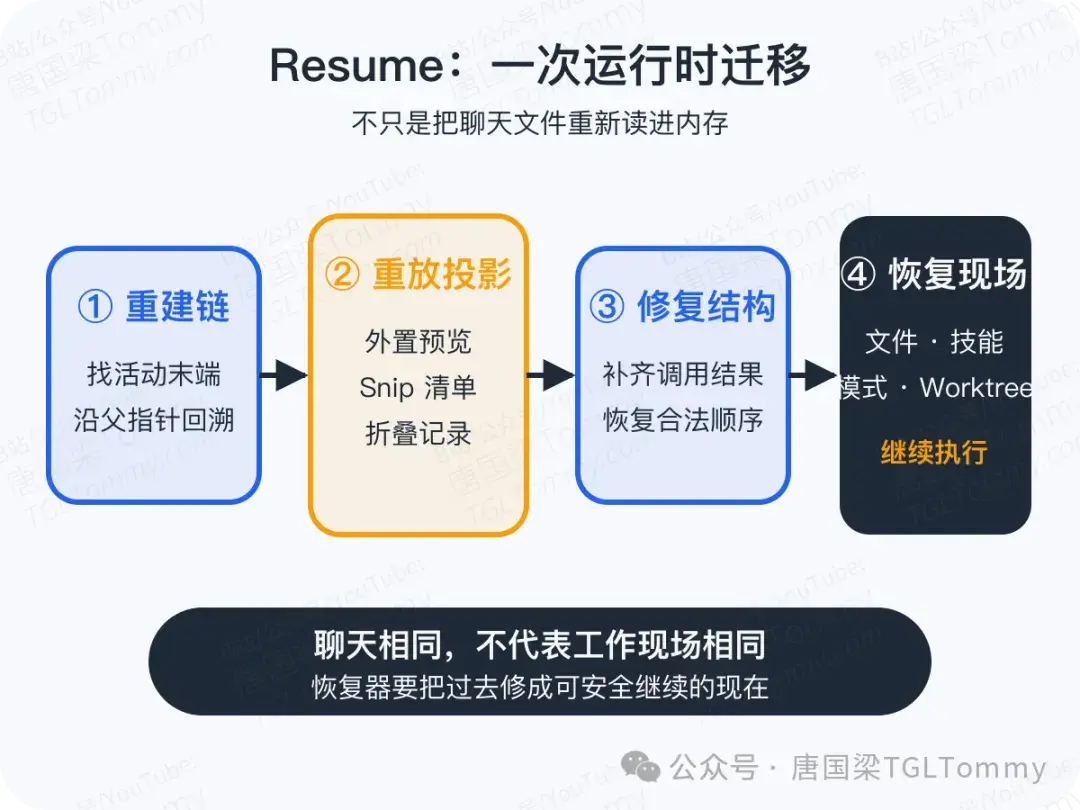
这也是 Resume 与 Fork 的根本区别。前者接管原会话的 ID、记录与工作现场,继续同一条主线;后者用新 ID 从旧会话分出另一条时间线。不过,旧会话已经做出的外置预览等决定仍要随上下文带过去,否则同一段前缀会突然发生变化。
更准确地说,Resume 是一次运行时迁移;回来的不只是聊天消息,而是一套可以安全继续执行的现场。
三条原则,串起全部机制
现在再回看那份五万行日志,整条路径就清楚了:大结果先被外置,过时工具输出再被微压缩清理;历史逼近上限时,全量压缩建立新边界;服务器仍然拒绝请求时,响应式压缩兜底一次。
界面上的消息没有消失,磁盘旧记录也没有被覆盖。变化主要发生在接口视图;只有全量压缩、会话记忆压缩和响应式压缩会建立新的逻辑起点。
支撑这一切的,是三条可以迁移到其他 Agent 系统的设计原则:
缓存决定必须可重复。 稳定预览、服务器侧缓存编辑和分叉摘要,都在保护请求前缀的一致性。
协议完整性优先于 token 预算。 不能拆散工具调用与结果,也不能破坏单条消息内部结构。
磁盘只追加,逻辑历史靠投影重建。 删除与压缩不是抹掉过去,而是记录以后应该怎样解释过去。
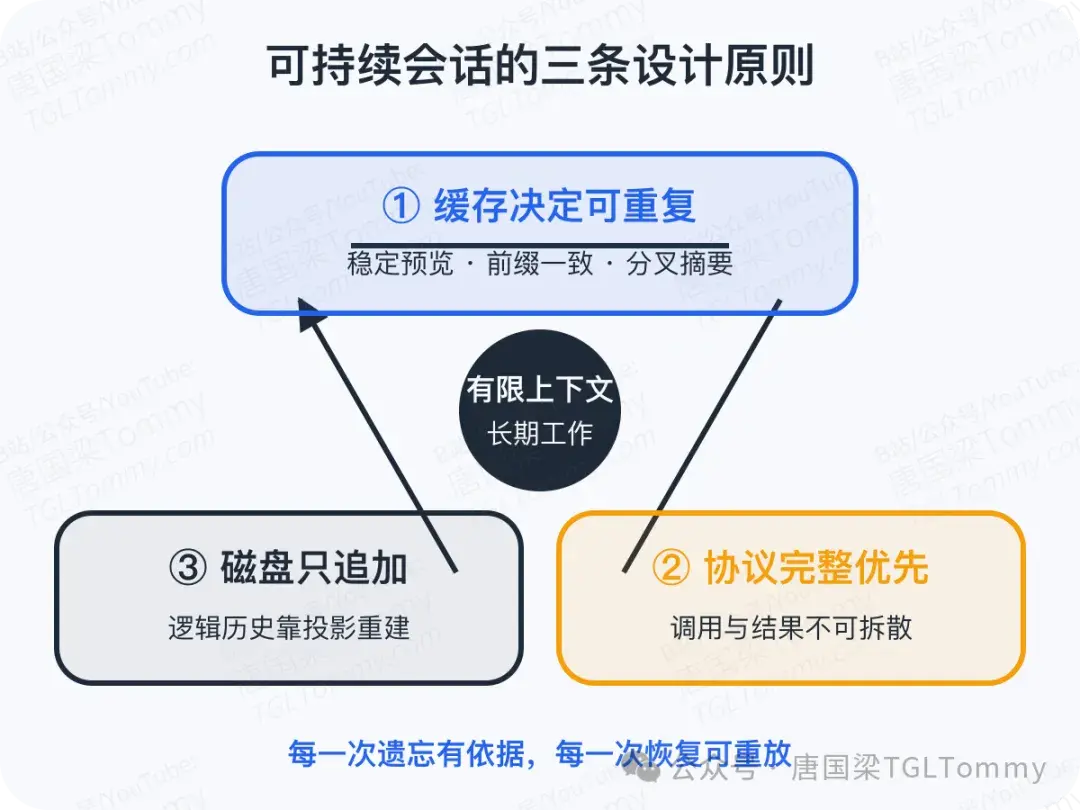
下次再听到“上下文压缩”,不要只问压缩率。先问它改的是交互历史、接口视图,还是逻辑链;再问原文是否仍在、恢复时能否重放。
成熟的 Agent 不需要把一切都塞进上下文。它真正需要的是:让每一次遗忘都有依据,让每一次恢复都回到同一个世界。
核心知识总结
Claude Code 能够长期运行,并不是因为模型拥有无限上下文,而是因为它设计了一套完整的上下文管理机制。
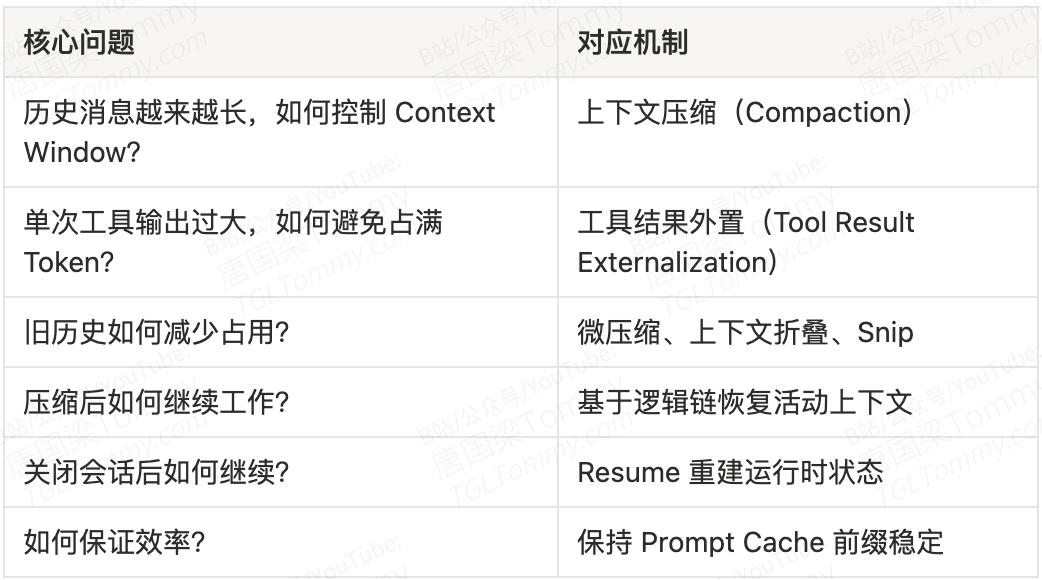
从更高层来看,Claude Code 的设计体现了三个核心原则:
保存全部历史,但不把全部历史发送给模型。
压缩不是删除过去,而是改变未来如何解释过去。
优秀的 Agent 不是拥有无限记忆,而是能够管理自己的上下文。
进阶学习
如果你正在关注大模型 Agent、强化学习后训练、RLHF、DPO、GRPO、RLVR 等前沿方向,欢迎学习我最新上线的精品课程:《大模型 Agent 强化学习实战》
这门课会系统讲解从 RLHF 到 Agentic RL 的完整演进,并结合 Verifiers、Reagent、VeRL、DeepAnalyze、OpenClaw-RL、Memento-Skills 等项目,把奖励设计、信用分配、训练系统和 Skill 自进化串成一条完整主线。
Agent RL 是当前大模型技术中非常关键的一条方向。它变化快、论文多、项目多,但也正因为如此,学习者更需要一套系统的学习框架。这门课程围绕当前大模型 Agent 强化学习的核心技术路线展开,旨在帮助学习者少走弯路,建立完整框架,跟上大模型后训练与 Agent RL 的前沿发展。
🎯课程官网:https://www.tgltommy.com/p/agent-rl(国内访问需科学上网) 📺B站课堂:《大模型 Agent 强化学习实战》
🌟更多精品课程请访问:
官方网站:TGLTommy.com(国内访问需科学上网)
B站课堂:
 TGLTommyAI(请在“课堂”下方查看)

🎯欢迎关注微信公众号:唐国梁TGLTommy
#ClaudeCode##AIAgent##大语言模型##LLM##人工智能# #Token##上下文窗口##Anthropic##唐国梁Tommy##AI智能体##AI前沿技术# #AI论文#
