
一、一个真实的选型困境
某SaaS平台负责人最近在群里问了一个问题:
“我们产品需要做发票识别,现在用的是某云厂商的OCR API,每个月调用量100万次,成本1万多。老板说太贵了,让我评估自建。我看网上说Tesseract免费,但识别率好像不高。到底该怎么选?”
这个问题下面跟了30多条回复,有说“自建坑太多”的,有说“云服务迟早被绑定”的。
这不是个例。OCR选型——自建开源方案 vs 第三方云服务,正在成为越来越多企业面临的技术决策。
这篇文章抛开厂商话术,从一线实践角度,对比两类方案的真实差异。
二、两类方案的技术架构差异
自建方案(以Tesseract/PaddleOCR为代表)
自建OCR的核心是:在自有服务器上部署开源OCR引擎,数据不出内网。
以Tesseract为例,部署流程包括:
安装Tesseract引擎和语言包(如中文简体)
结合OpenCV进行图像预处理(灰度化、二值化、降噪、倾斜校正)
调用识别接口获取文本,再自行后处理
代码示例(Python调用Tesseract):
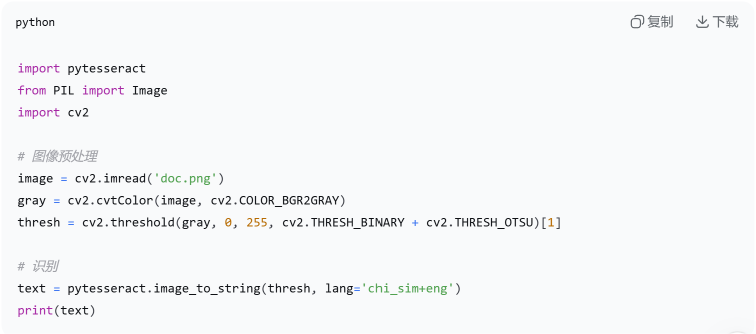
优势:完全可控,数据不出域,无调用费用。
短板:技术门槛高,需自行处理图像质量和模型优化。
云服务方案(以百度云/阿里云/Azure为代表)
云OCR的核心是:通过API调用云端服务,即开即用。
以百度云OCR为例,调用代码仅需几行:
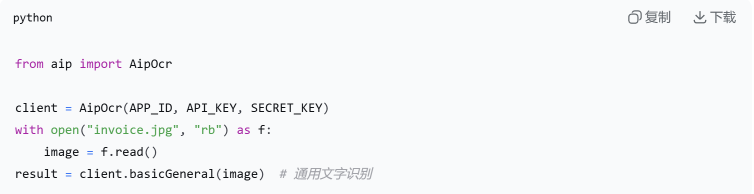
优势:开箱即用,自动处理图像质量,识别率高。
短板:数据需上传云端,长期调用成本高,功能黑盒。
三、数据安全:最大的变量
这是两类方案最本质的区别,没有之一。
自建方案:数据完全留在内网,满足等保2.0、GDPR等合规要求。对于医疗、金融、政务等场景,这是刚需。
云服务方案:数据需传输至第三方服务器。即便云厂商承诺“不存储”,以下问题依然存在:
数据传输路径不可控,可能经过跨境节点
客户数据是否被用于模型训练?虽然主流厂商承诺不训练,但合规审计时需要逐条确认
越来越多企业客户要求数据本地化处理,使用云OCR可能直接丢单
真实案例:某HR SaaS平台因使用公有云OCR解析员工身份证,被客户质疑违反数据保护法规,最终被迫紧急重构识别流程。
结论:如果你的业务涉及客户敏感数据、或目标客户是金融/医疗/政府,自建是唯一选择。
四、识别效果:差距正在缩小
这是很多人的认知误区:云服务一定比自建准。
实际情况:
通用场景(清晰印刷体)
Tesseract:准确率约82%-90%
百度云OCR:准确率约95%-98%
复杂场景(表格、手写体、低质量图片)
Tesseract:准确率约40%-65%,需大量预处理优化
百度云OCR:准确率约85%-92%,自带版面分析
测试数据对比(同一份含表格、多栏文字的扫描件):
但需要注意的是,自建方案可以通过定制化训练大幅提升准确率。
案例:某制造企业通过Tesseract定制训练,识别设备仪表盘数字,准确率从70%提升至90%,仅需200张标注图片。某财税SaaS通过自研OCR,将发票识别准确率从92%提升至98.5%。
结论:如果你需要识别通用文档(发票、身份证、合同),云服务省心省力。如果你的场景非常垂直(特定字体、特定格式),自建+微调的上限可能更高。
五、成本对比:短期vs长期
这是最容易被算错的一笔账。
云服务成本
以某云厂商通用识别API为例:
单价:约0.003元/次
免费额度:每月1000次
月调用100万次:约3000元/月,年3.6万
月调用1000万次:约3万元/月,年36万
Azure的定价模式类似,每1000页约1.5-10美元,视服务类型而定。
自建成本
以Tesseract为例:
软件成本:0元(开源)
服务器:4核8G,约200-500元/月
GPU服务器(如需训练):约2000-5000元/月
人力投入:1名工程师2-4周搭建+持续优化
盈亏平衡点:
月调用量低于5万次,云服务更划算
月调用量高于50万次,自建开始回本
月调用量千万级,自建成本远低于云服务
容易被忽略的隐性成本
云服务的隐性成本:长期依赖、议价能力弱、涨价风险、数据迁移成本。
自建的隐性成本:模型维护、版本升级、故障处理、人员培养。
观点:SaaS厂商不应长期依赖公有云OCR——当产品进入规模化阶段,OCR成本可能直接侵蚀10%-30%的毛利率。
六、完整对比表格
七、选型决策框架
三步走决策法:
第一步:数据安全是红线
如果业务涉及金融、医疗、政务数据,或目标客户要求数据不出域 → 自建。这一步不满足,其他不用谈。
第二步:算规模
预估月调用量:
<5万次/月 → 云服务(省心)
5-50万次/月 → 云服务起步,预留自建迁移路径
50万次/月 → 开始考虑自建
第三步:看场景复杂度
通用文档(发票、身份证、合同)→ 云服务效果已很好
垂直领域(特定字体、设备读数、专业术语)→ 自建+微调上限更高
混合架构是多数企业的务实选择
在具体实现上,有企业采用 ZGI 作为OCR服务的统一接入层,实现“核心业务走自建、非敏感业务走云服务”的混合路由,通过统一网关自动选择识别路径,兼顾数据安全、识别效果和成本。
典型配置:
敏感文档(合同、身份证)→ 路由到自建Tesseract集群
通用文档 → 路由到百度/阿里云OCR
低置信度结果 → 自动转发到云服务二次校验
这种架构下,某物流企业将识别准确率提升至98%,同时将服务器成本降低40%。
八、写在最后
OCR选型没有“最好”的方案,只有“最合适”的。
数据安全是红线,合规要求决定了你能不能走云端
成本是分水岭,小规模用云、大规模自建
效果是天平,通用场景云服务领先,垂直场景自建可反超
混合架构是趋势,把不同场景路由到最适合的识别引擎
如果你的月调用量还在五位数,云服务足够。如果已经在七位数,是时候评估自建了。
本文基于OCR选型实践与行业调研整理。
