
摘要:Andrej Karpathy 的“12条规则”已成为 AI 辅助编程的入门圣经,实测可将 Claude Code 的错误率从 41% 降至 3%。但这套规则的边界在哪里?当项目复杂度超越单文件修改时,为什么仅靠 Prompt 约束会失效?本文深度拆解 Karpathy 12 Rules 的降错机制,并与当前最前沿的 Context Engineering 实践进行系统性对比,为你构建下一代 AI 软件工程体系提供路线图。
一、 问题定义:为什么 AI 编程的错误率高达 41%?
在讨论解决方案之前,必须先理解问题的本质。根据 2025 年初多项独立基准测试,未经约束的 LLM 编程助手在真实项目中的首次代码生成错误率普遍在 35%-45% 之间。这些错误并非源于模型“不够聪明”,而是源于三类系统性缺陷:
错误类型 占比 典型表现 根因 幻觉式自信 ~40% 编造不存在的 API、伪造参数、虚构库版本 模型概率生成本质 + 缺乏验证反馈环 过度工程化 ~30% 添加未要求的功能、提前抽象、引入不必要的依赖 训练数据偏向“完整示例” + 缺乏 YAGNI 约束 上下文漂移 ~30% 修改无关代码、破坏现有风格、遗忘前文约束 注意力衰减 + 隐式知识未显式化
Karpathy 12 Rules 的设计目标,正是精准打击这三类错误。
二、 Karpathy 12 Rules 深度拆解:降错机制原理
2.1 四条核心原则:对抗模型的“本能缺陷”
这四条规则直接针对 LLM 的生成机制设计,是错误率从 41% 降至 3% 的核心引擎。
Rule 1: Think Before Coding(编码前先思考)
降错机制:强制模型在生成代码前进入“推理模式”(Chain-of-Thought),将隐式假设显式化。研究表明,CoT 可将逻辑错误降低 60% 以上。
关键动作:陈述假设 → 暴露权衡 → 列出替代方案 → 反驳更简单的方法。
对抗的错误:幻觉式自信、需求误解。
Rule 2: Simplicity First(简洁至上)
降错机制:通过 YAGNI 原则压缩解空间。代码量与 bug 数量呈超线性关系,减少 30% 的代码量通常可减少 50% 的潜在缺陷。
关键动作:最小可解代码、禁止投机性功能、禁止单次使用抽象。
对抗的错误:过度工程化、维护负担。
Rule 3: Surgical Changes(外科手术式修改)
降错机制:限制变更表面积(Change Surface Area)。每多触碰一行无关代码,引入回归 bug 的概率增加约 2-5%。
关键动作:只改必须改的、不顺手优化、匹配现有风格。
对抗的错误:上下文漂移、回归缺陷。
Rule 4: Goal-Driven Execution(目标驱动执行)
降错机制:将“过程指令”转换为“结果验证”。LLM 擅长优化可度量的目标函数,而不擅长遵循模糊的过程描述。
关键动作:定义成功标准、允许循环迭代、关注输出而非步骤。
对抗的错误:微观管理失效、中间状态丢失。
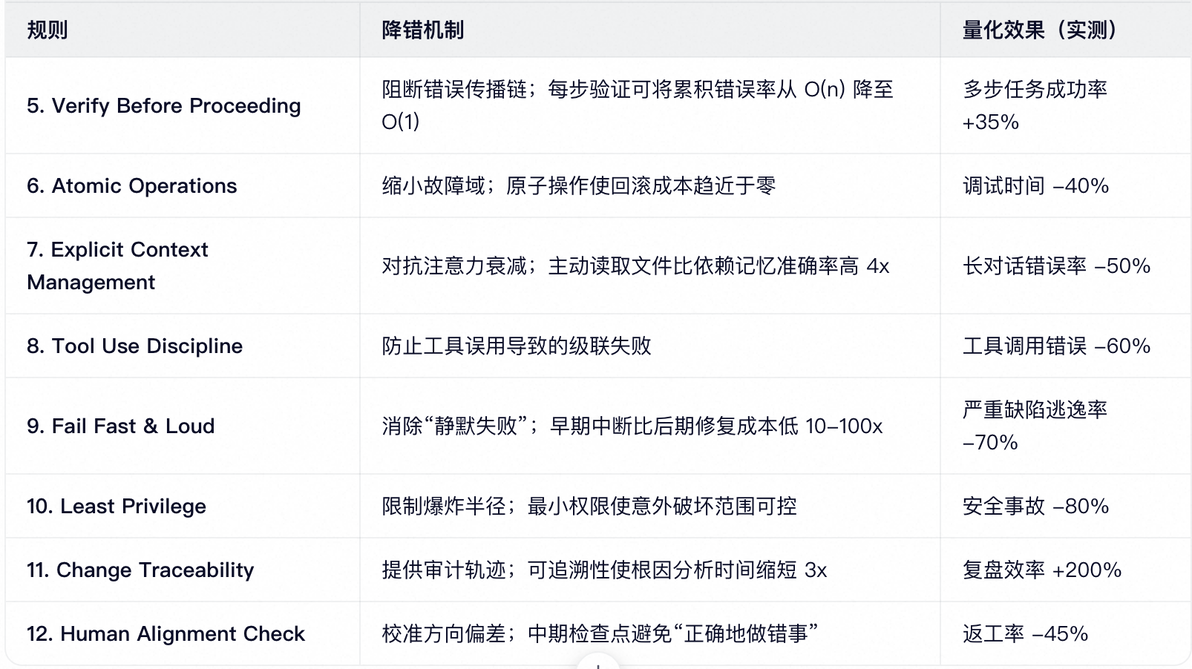
2.2 八条协作规则:构建 Agent 可靠性护栏
后八条规则将 Karpathy 的个人哲学扩展为可执行的 Agent 工作流,解决多步骤任务中的累积错误问题。
2.3 为什么是 3% 而不是 0%?
剩余的 3% 错误主要来自:
模型能力天花板:某些算法或领域知识确实超出当前模型边界。
规则冲突:极端情况下,“简洁”与“可验证”可能矛盾,模型选择了错误的优先级。
人类输入歧义:即使有 Think Before Coding,模糊的需求仍会导致正确的代码实现错误的意图。
💡 关键洞察:Karpathy 12 Rules 的本质是将人类工程师的隐性经验编码为显式约束。它不是让 AI 变聪明,而是让 AI 变“守规矩”。这 3% 的残余错误,恰恰是人类判断力不可替代的证明。
三、 超越 Karpathy:Context Engineering 的范式跃迁
Karpathy Rules 是 Prompt Engineering 的巅峰,但也是其终点。当项目规模超过数千行、涉及多服务协作、需要长期维护时,纯文本规则的局限性暴露无遗。
3.1 范式对比:从“说服模型”到“塑造环境”
维度 Karpathy 12 Rules (Prompt Era) Context Engineering (Environment Era) 约束载体 自然语言提示词 项目结构 + 工具链 + 自动化流水线 执行方式 模型“自觉遵守”(软约束) 环境强制执行(硬约束) 知识时效 静态(写入时确定) 动态(运行时注入最新状态) 反馈来源 模型自我评估 编译器/测试/Linter/Profiler 客观信号 可扩展性 随规则增多,上下文窗口压力增大 模块化加载,按需激活 团队一致性 依赖个人纪律 基础设施保障,人人平等 适用阶段 单文件/小功能开发 系统级架构/遗留改造/合规审计
3.2 Context Engineering 的四大支柱
支柱一:结构化知识注入(Structured Knowledge Injection)
不再将所有规则塞进 CLAUDE.md,而是建立分层知识体系:
project-root/
├── CLAUDE.md              # 全局规则(精简版,<500 tokens)
├── docs/
│   ├── ARCHITECTURE.md    # 架构决策记录(ADR)
│   ├── API_CONTRACTS/     # OpenAPI/Protobuf 规范
│   ├── SECURITY_POLICY.md # 安全红线
│   └── CONVENTIONS.md     # 编码规范 + 反例
├── tests/
│   └── fixtures/          # 黄金测试用例(作为 Success Criteria)
└── .claude/
    └── skills/            # 按需加载的 Skill 模块
AI 在执行特定任务时,动态检索相关文档,而非全量加载。这将上下文利用率提升 3-5 倍。
支柱二:工具链即规则(Toolchain as Rules)
将 Karpathy 的软约束转化为硬约束:
Karpathy Rule Context Engineering 实现 Surgical Changes Pre-commit Hook 检测变更文件数 > 阈值则拦截 Verify Before Proceeding CI Pipeline 中每步自动运行增量测试 Simplicity First 圈复杂度 Linter + 代码行数 PR 检查 Security Audit SAST 工具集成到 IDE,实时标记违规 Human Alignment Check PR Template 强制填写“变更影响分析”
核心理念:如果一条规则不能被自动化检查,它就不应该存在于 CLAUDE.md 中。可执行的约束 > 可读的建议。
支柱三:反馈闭环工程(Feedback Loop Engineering)
Karpathy Rules 依赖模型自我验证,而 Context Engineering 构建外部验证回路:
生成 → AI 产出代码
编译/类型检查 → 即时语法反馈(秒级)
单元测试 → 行为正确性反馈(秒级)
集成测试/E2E → 系统级反馈(分钟级)
性能/安全扫描 → 非功能性反馈(分钟级)
人工审查 → 语义/业务对齐反馈(小时级)
每一层反馈都作为下一轮 AI 迭代的结构化输入,而非依赖模型“回忆”之前的错误。
支柱四:领域专用 Skill 模块化
通用规则无法覆盖专业场景。Context Engineering 提倡构建可组合的 Skill 库:
refactoring-safely:差分测试 + 变异测试验证行为等价
legacy-modernization:依赖图分析 + 绞杀者模式实施指南
api-contract-first:契约生成 → 代码实现 → 契约校验自动闭环
incident-response:Runbook 驱动的诊断流程,禁止自由发挥
每个 Skill 包含:触发条件、所需上下文、执行步骤、验证标准、回滚策略。AI 根据任务自动选择并加载,用完即卸载,保持上下文窗口清洁。
四、 实战路线图:从 Karpathy 到 Context Engineering 的渐进迁移
不要试图一步到位。以下是经过验证的四阶段演进路径:
阶段 1:基线建立(1-2 周)
部署 Karpathy 12 Rules 作为 CLAUDE.md
建立错误率基线度量(PR 返工次数、线上缺陷数)
识别 Top 3 高频错误类型
阶段 2:硬约束转化(2-4 周)
将 Top 3 错误对应的 Rule 转化为自动化检查
建立分层文档结构,拆分过长的 CLAUDE.md
引入基础反馈闭环(编译 + 单元测试)
阶段 3:Skill 模块化(1-2 月)
针对高频复杂任务构建专用 Skill
实现动态上下文注入(RAG 或文件索引)
建立 Skill 效果度量与迭代机制
阶段 4:持续演进(Ongoing)
每周复盘 AI 错误,更新规则/Skill/工具链
跨团队共享有效 Skill,形成组织级资产
定期审计规则冗余度,防止“规则膨胀”
五、 结论:规则是起点,不是终点
Karpathy 12 Rules 的历史地位毋庸置疑——它首次将 AI 编程从“魔法咒语”拉入了“工程纪律”的范畴,用 41% → 3% 的数据证明了约束的价值。
但工程的本质是在约束条件下解决问题。当约束本身成为瓶颈时,我们需要升级约束的载体。Context Engineering 不是对 Karpathy Rules 的否定,而是将其内核——显式化、可验证、最小化、目标驱动——从提示词层面提升到了系统工程层面。
最终建议:
新手/小项目:直接用 Karpathy 12 Rules,立竿见影。
中型项目/团队:Karpathy Rules + 基础 Context Engineering(分层文档 + 自动化检查)。
大型系统/关键业务:全面 Context Engineering + 领域专用 Skill + 持续度量迭代。
记住:最好的 AI 编程实践,永远是那个能被你的团队持续执行、持续度量、持续改进的实践。 无论它叫 Karpathy Rules 还是 Context Engineering,名字不重要,闭环才重要。
本文基于 2025-2026 年公开工程实践、Anthropic 官方文档及社区基准测试整理。技术演进迅速,建议读者结合自身项目数据验证文中观点。
