
上个月,我接手了一个企业内部知识库RAG项目。客户的要求很简单:“你们准确率能做到多少?”
我习惯性地报了95%以上——毕竟在公开数据集上跑出来的数据确实漂亮。
结果项目上线第一周就被打脸了。销售团队问“上个月华东区的售后政策变更对哪些产品有影响”,系统吐出来的答案七零八落,明明知识库里文档都有,就是拼不出一个完整答案。
我们复盘了三天,发现问题不在检索精度,在评测体系。
公开数据集的评测只看“检索到的文档相关不相关”,但企业内部的知识场景,用户要的是“证据链是否完整、结论是否有冲突、信息是否最新”。
我这才意识到:RAG评测,早就不是“准不准”的问题了。
一、传统评测为什么不够用了?
聊RAG评测之前,得先说清楚一个问题:RAG评测到底难在哪?
2025年4月有一篇综述论文专门梳理过。RAG的评测之所以复杂,是因为它是一个“检索+生成”的双阶段系统,评价检索质量、评价生成质量、评价两者协同效应,三个维度各有各的标准。
传统信息检索时代,一套“查询-文档”相关性判断就够了。MRR看第一个正确答案的排名,NDCG看排序质量——搜索用户翻两页找不到就换关键词,排名靠前的文档价值大。
但RAG不一样。RAG的用户不自己翻文档,系统要把检索到的信息“合成”成一个答案。用户关心的是:你给我的答案,证据够不够全?有没有关键事实被遗漏?有没有矛盾信息没处理?
业内现在把这个问题总结得很清楚:传统指标评测的是“检索排名”,RAG真正需要评测的是“证据集覆盖”。
二、三个信号:RAG评测正在变成独立赛道
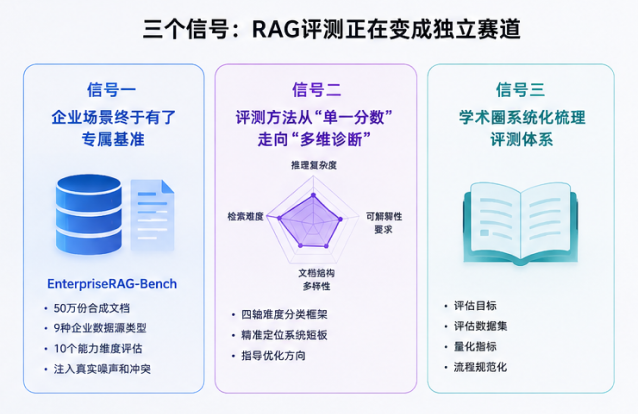
2026年上半年,RAG评测的热度明显上来了。我关注到三个关键信号:
信号一:企业场景终于有了专属基准
5月4日,arXiv上挂出了EnterpriseRAG-Bench。这个工作在我看来是个分水岭。
过去所有主流RAG评测数据集——Natural Questions、HotpotQA、FEVER——全在公开网络数据上做。企业内部知识库是什么样?Slack讨论记录、Jira工单、Confluence文档、Gmail邮件,格式不统一、内容有噪音、文档还经常放错文件夹。
EnterpriseRAG-Bench第一次系统性地做了这个事:50万份合成文档,覆盖9种企业数据源类型,还显式注入了“归档错误的文档”“近似重复文档”“相互矛盾的信息”三类真实噪声。
评测问题设计也从“单文档查找”一路升级到“多文档推理”“约束检索”“冲突消解”“识别信息缺失”等10个能力维度。
项目上线后被客户怼的场景,在这套评测体系里其实有对应的能力维度——“跨文档矛盾识别”和“缺失信息判断”。但在传统评测里,这两个维度连测都没测过。
信号二:评测方法从“单一分数”走向“多维诊断”
4月份,一篇被AAAI 2026 Workshop接收的论文提出了一套四轴难度分类框架,把RAG任务拆成“推理复杂度”“检索难度”“文档结构多样性”“可解释性要求”四个维度分别诊断。
这意味着什么?
以前我们看一个RAG系统,只能看到一个“综合准确率”。现在可以定位了:你的系统是在“多跳推理”环节不行,还是“检索噪音处理”环节有短板?这直接决定了优化方向是换检索模型还是加重排模块。
信号三:学术圈开始系统化梳理RAG评测体系
5月19日更新的RAG综述论文,把RAG评测单独列为一个章节,从评估目标、评估数据集、量化指标三个维度做了完整梳理。
更早的2024年arXiv论文提出的Auepora框架,也在强调同样的思路:RAG评测需要有统一的流程规范,不能每个团队自己拍脑门。
三、我亲身踩过的坑:新材料领域的“专家评审判定”
去年我参与过一个新材料领域的RAG项目评估,评估对象是在graphene合成场景下的RAG系统。我们同时用了四种评估方法:RAGAS自动评分、BERTScore、LLM-as-a-Judge、以及9位领域专家人工打分。
结果很有意思。
RAGAS——一个专门针对RAG设计的评估框架,用三个核心指标(事实正确性、上下文召回率、忠实度)来做评估——成功捕捉到了检索增强带来的性能提升:Qwen模型加了RAG之后,性能从5.68提升到6.68(专家10分制),提升了整整1分。
但RAGAS的绝对分值和专家打分差异很大——平均差了73.5%。这意味着自动评测框架能判断“哪个更好”,但给不出专家认可的“绝对分数”。
这件事教会我两课:第一,用自动评测做横向对比是可行的;第二,真正决定RAG系统能不能上线,还得让懂业务的人来判。尤其是在专业领域,RAGAS这种通用框架识别不了领域术语——我们在graphene场景实测,RAGAS的上下文召回率在某些问题上打了0分,但检索内容明明是正确且相关的,只是术语表达方式和评测框架的训练数据不一样。
四、新材料带来的启发
FreshStack这个针对技术文档的RAG评测基准给我启发很大。
它核心的创新是把“答案”拆解成原子化的“nuggets”。一个Stack Overflow问题的答案,被GPT-4o拆成几个关键事实nugget。然后检索到的每篇文档,逐一标注“支持了哪几个nugget”。
基于这套细粒度标注,FreshStack设计了三个评测维度:
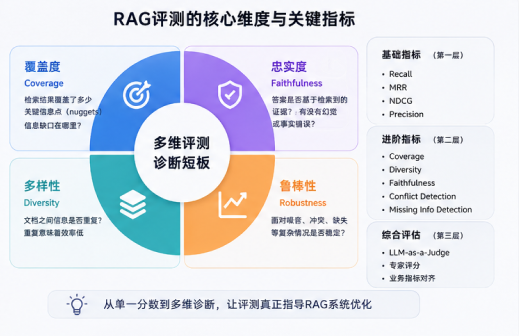
Coverage(覆盖度):检索到的文档覆盖了多少nugget?没覆盖到的就是信息缺口。
Diversity(多样性):文档之间有没有信息重复?重复意味着效率低。
Recall(召回率):基础的相关性检查。
实测发现,当前的主流检索模型在这三个维度上都表现不佳,而且没有哪个模型能在所有topic上全面领先。这说明RAG检索优化空间还很大。
FreshStack的思路可以迁移到企业内部知识场景:把业务流程的关键信息点预先拆解成原子化fact,然后看RAG系统能不能完整覆盖。这个工作量不小,但对高风险业务场景来说,这种细致评测的投资回报是值得的。
五、RAG评测的三个新趋势
综合这些信息,我看到RAG评测正从“辅助工具”升级为独立赛道,趋势有三个:
趋势一:从静态基准到动态生成
传统数据集标注成本高,一旦发布就固定了,容易被“刷榜”污染。新趋势是让LLM根据特定评测目标动态生成评测数据。RAGAS的WikiEval、MultiHop-RAG都采用这种方法,可以持续生成时效性强的新数据。
趋势二:从单一指标到多维诊断
不再只看“准确率”,而是拆成覆盖度、多样性、忠实度、鲁棒性等多个维度。这样能定位短板、指导优化。
趋势三:从通用场景到垂直深耕
EnterpriseRAG-Bench盯企业知识,FreshStack盯技术文档,材料科学、医疗等垂直领域也在建自己的RAG评测体系。不同场景的评测标准正在分化,“一个基准打天下”的思路该放下了。
六、落到实践:我们的RAG评测应该怎么做?
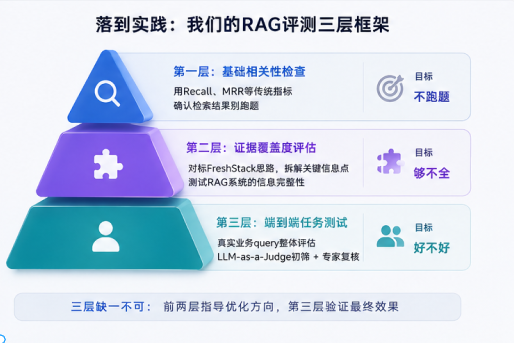
结合这些认知,我现在对RAG评测的思路是:
第一层:基础相关性检查 用Recall、MRR等传统指标确认检索结果别跑题。这一步过不了,后面不用测。
第二层:证据覆盖度评估 对标FreshStack的思路,针对核心业务场景拆解关键信息点,测试RAG系统的信息完整性。
第三层:端到端任务测试 用真实业务query做整体效果评估,用LLM-as-a-Judge做初筛,关键case请领域专家复核。
这三层缺一不可。前两层指导优化方向,第三层验证最终效果。
最后一个观察:RAG评测这个方向,现在有点像2018年的BERT——论文密集出现、框架陆续开源、但行业标准还没定型。对从业者来说,这可能是个技术红利期。谁先建立起适合自己业务的评测体系,谁就掌握了RAG优化的“方向盘”。
文末讨论问题
你们的RAG系统现在用什么指标评测?有没有遇到过“指标好看、效果翻车”的情况?
如果让你给企业知识库场景设计一套RAG评测体系,你会从哪几个维度入手?评论区分(p≧w≦q)
声明:图片由AI辅助生成
