
τ定律和逻辑折叠技术简单讲解
本人学识尚浅,可能总结的不好,请理解
大家应该都知道摩尔定律吧,就不绕弯子了,传统摩尔定律靠几何缩微,每个大节点更新晶体管特征尺寸约缩小至0.7倍(这里先教大家如何判断下一次台积电大节点更新,实际上就是从28nm往后逐渐乘以0.7五舍六入就是下一次大节点更新,如28*0.7=19.6~20nm,后续还有14nm,10,nm,7nm,5nm,3nm,2nm,14A,所以以后有人跟你说什么16A工艺,直接告诉他是2nm就行),随着密度日益增大 ,摩尔定律也已逼近两个极限,一个是物理极限,例如3nm以下量子隧穿、短沟道效应、光刻分辨率瓶颈日益严重。另一个就是经济极限,就比如3nm/2nm节点的设计成本超约10亿美元,只有极少厂商能负担。想必大家都知道今天开的那个会提出来的τ定律,总结来说就是以时间缩微替代几何缩微,通过系统性降低整个电子系统的时间常数 τ,在不依赖先进制程的前提下,持续提升等效晶体管密度和系统性能。
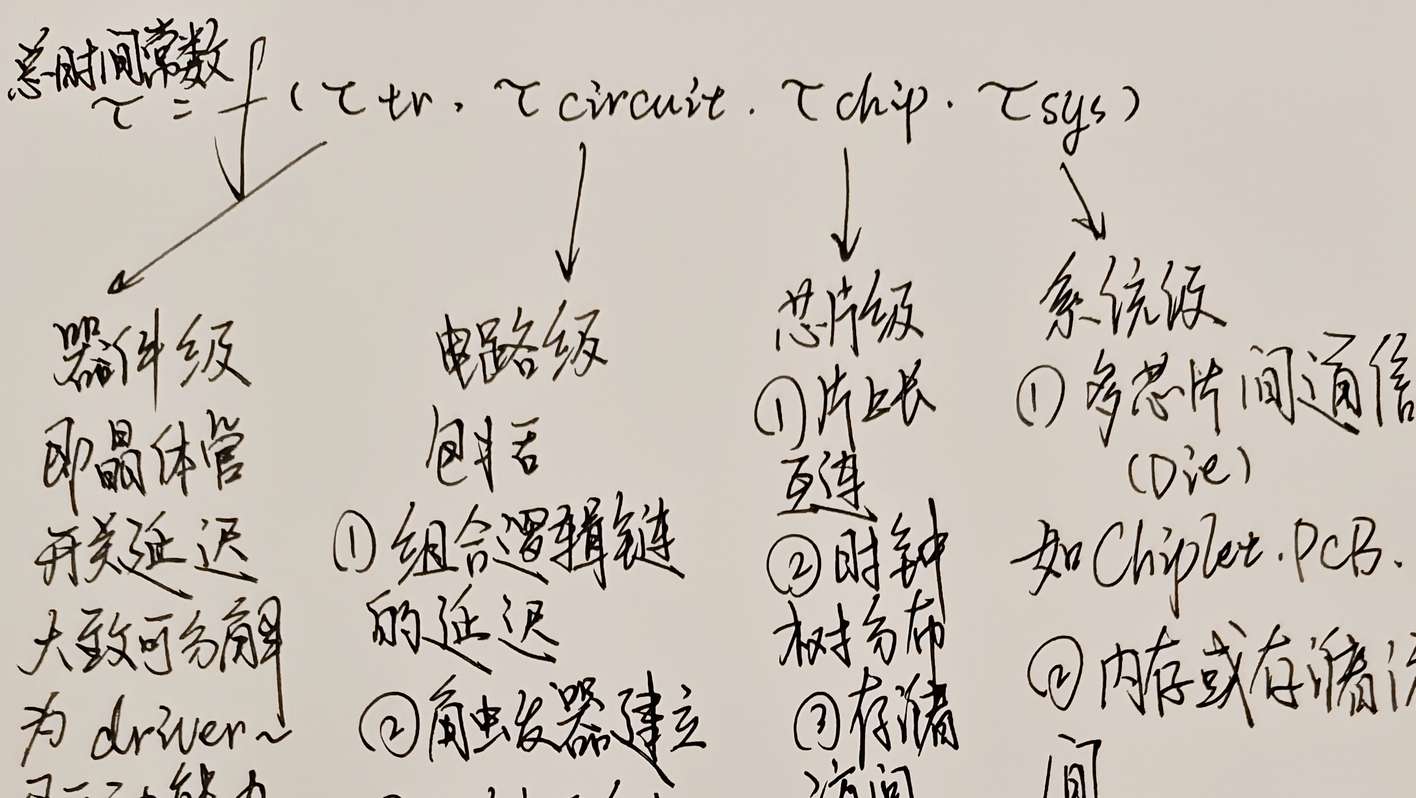
接下来带大家从公式方面慢慢理解,如图
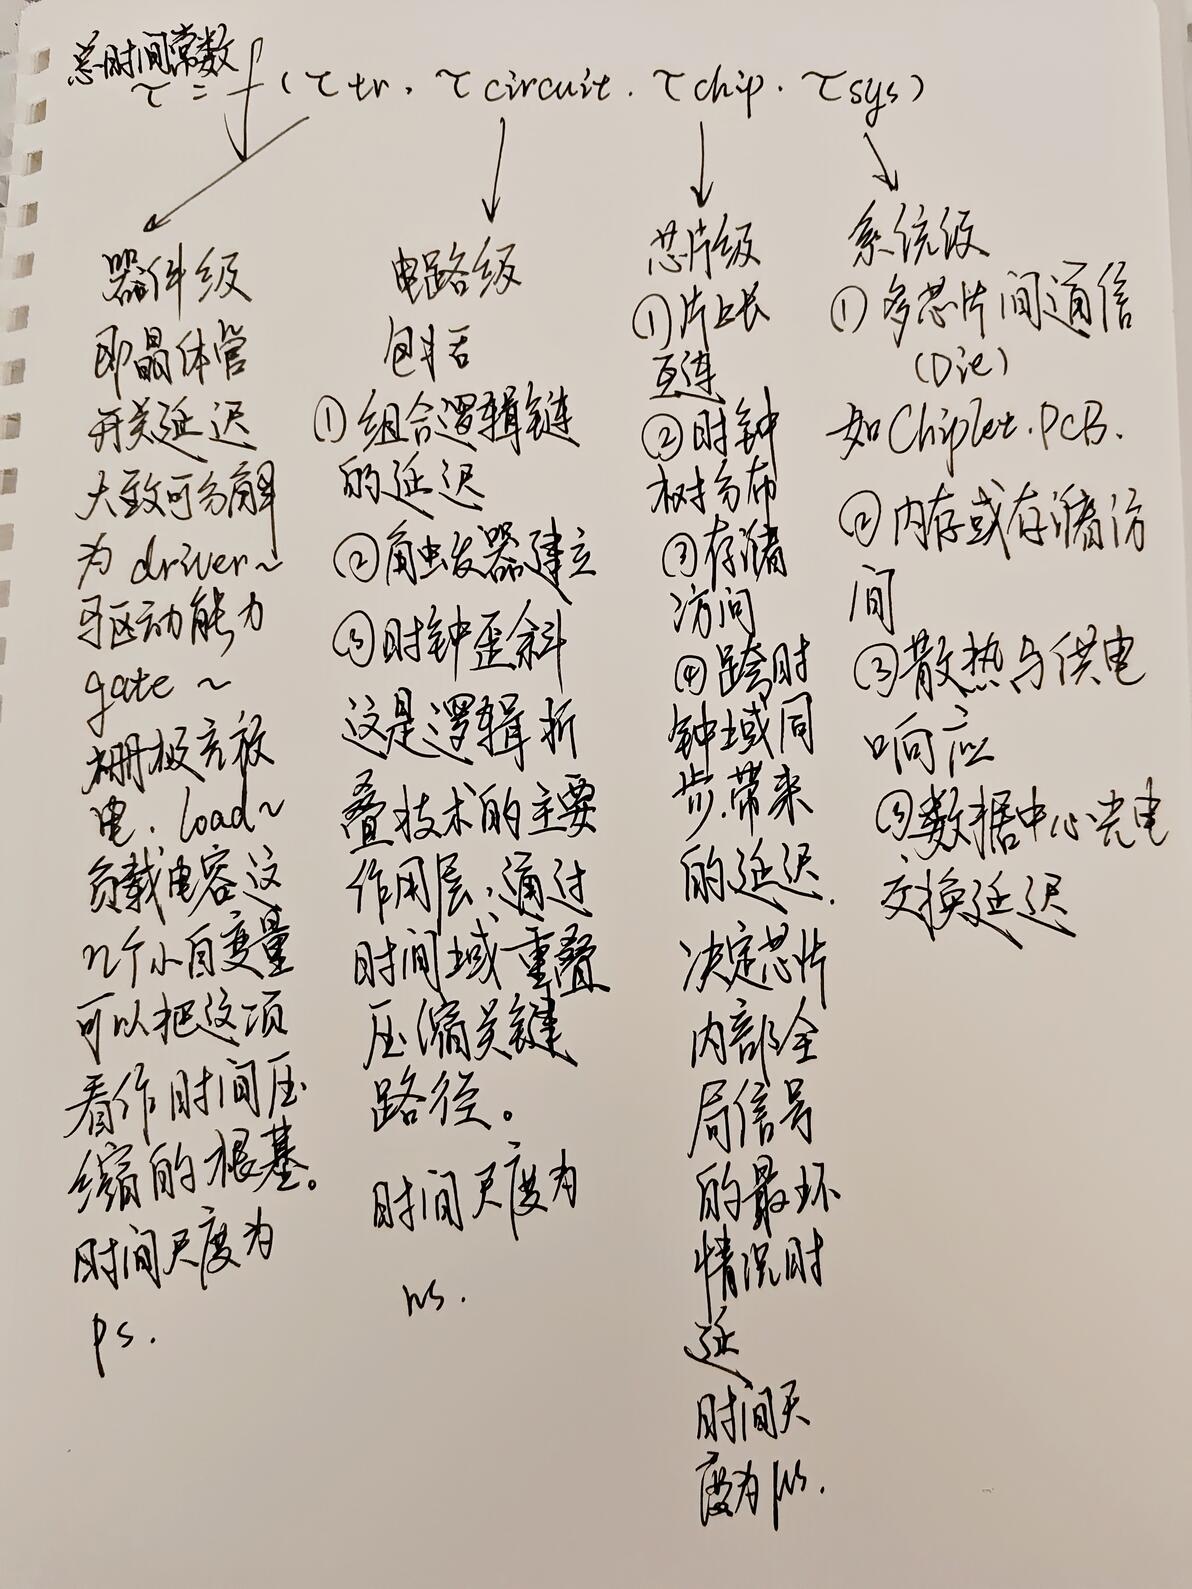
该公式把总时间常数τ拆分成四个层级并且每一层级都有相对应的公式,图中为简要说明,深入理解之后可以明白该公式(函数)中的每个层级有很强的关联性,约束性和可调优性。
例如,减小 τ~Circuit 可以使电路在更低电压下满足时序,从而降低功耗,功耗降低又减轻了散热时间常数(τ~sys内),进而允许进一步压缩 τ~Circuit。若只优化 τ~Tr 而忽略 τ~Chip,片上长互连会成为瓶颈,整体 τ 改善有限。因此,τ 定律的本质是跨层级协同设计,而非局部最优。
简单来说就是根据这个τ定律展示出来的公式,分别对公式里面的四项进行优化,特别是电路延迟那一项,就采用了逻辑折叠技术来进行优化。
(技术部分看不懂的,可以看后面的比喻)接下来再来讲讲这个逻辑折叠技术,这和传统的堆叠方式不太一样,物理上逻辑折叠就是把数字电路、模拟电路与存储电路划分排布在多层垂直堆叠的芯片层上,通过超细间距的混合键合实现互连,从而缩短信号传输路径,减少影响传输的寄生电容与电阻,从而使芯片能在相同制程下以更高效率运行。“时间上”,逻辑折叠即Logic Folding将传统串行计算的多个步骤在时间上重叠或压缩。包括时间域重叠,即重构电路,让后级在前级结果未完全稳定时提前开始计算。例如,一个三级组合逻辑原本需要3个周期,通过折叠可以压缩到1.5~2个周期,这个技术的实现原理有点类似于苹果 Family 10 GPU的第二代动态缓存技术。然后还有动态时延缩放,即根据信号质量动态调整驱动器的强度和门阈值,使信号在未满幅时就传递给下一级,省去等待时间。最后是空间到时间的映射,即用高速分时复用单个运算单元处理多个逻辑任务,从而减少物理面积,等效提高晶体管密度。传统流水线虽然也并行,但每级仍需完整时钟周期,逻辑折叠允许部分重叠,甚至跨时钟边界压缩。它更像是在时间轴上折叠一张纸,使原本顺序的点在时间上更靠近,哈哈哈,有点广义相对论的味道了。这可能会对LinXi(泰山)核心的流水线级数和分支预测失误率…有很大的帮助,然后频率提升也不是什么太难的事了。
来打个简单的比喻吧,传统电路可以看做三辆车(三个计算步骤)在单车道依次通过,每车1分钟,总3分钟。而逻辑折叠呢是通过精准的时间配合,第一辆车刚走完一半,第二辆车就紧贴起步,最后总耗时压缩到1.5分钟。物理车道未变(未缩小),但通行时间减半。
再然后就是逻辑折叠对功耗或者散热的影响,逻辑折叠在单位时间内完成更多计算,通常会导致功耗上升,可能也是前段时间爆出来,积热比较严重的大致原因吧,虽然平均功耗可控,但局部瞬时功率密度可能很高,对封装和散热提出更高要求,看华子怎么搞吧,但华子通过四个其他的技术实现了功耗的相对平衡,第一个是降压运行抵消动态功耗,根据动态功耗公式,P=α(常数)*C(电容)*V²(电压)*f(频率),逻辑折叠压缩了关键路径时延 τ,使得电路可以在更低电源电压 V 下仍满足时序。由于功耗与 V² 成正比,降压节省的功耗往往超过折叠带来的额外电容 C 增加。在相同性能下,动态功耗可能不增反降。第二个是“爆发”‑“休眠”两个模式迅速切换来降低平均功耗,逻辑折叠让计算在短时间内爆发出结果,之后电路进入“深度休眠”。占空比降低,平均动态与静态功耗都得到控制。这对移动端的麒麟芯片很关键,积热问题应该也能得到良好的改善。第三个是多阈值器件抑制漏电,时间压缩通常需要低阈值电压(V th)以实现快速开关,但低 V th 会指数级增加亚阈值漏电。韬定律不要求极致几何微缩,因此可以使用高 V th 器件或厚栅氧化层来抑制漏电,只在关键路径使用低 V th。第四个就是空间热扩散和时间热扩散,华子的空间热扩散就讲的是多线程调度让热点在不同逻辑块间轮转避免局部过热,时间热扩散讲的是根据温度和负载实时调整折叠深度即目标 τ,轻载时少折叠、高电压效率区运行,重载时深度折叠但主动降频,保持功耗在 TDP 以内。这也是不断堆核的原因,重载时,始终让所有核心保持在一个相对低的频率多核协同以实现降低功耗。
最后简单来说就是,在等效性能下,逻辑折叠芯片的功耗可以更低,在等效功耗下,性能可以大幅提升。
再然后拿τ定律和传统摩尔定律做个简单的对比。摩尔定律的核心指标为特征尺寸L,密度提升的方式公式表示为1/L²,提升很依赖euv光刻机,新材料,新器件…终究还是有物理极限的,就像上面提到的那样,成本每个大工艺节点也是指数级的上涨。而τ定律的核心指标为τ,密度提升的方式公式表示为1/τ,但为等效密度,很依靠工程师的设计能力,物理极限为光速,还有开关能量极限,然后成本依赖EDA和架构的创新,提升较平缓,符合现状,但可能依旧良率不太理想,所以τ定律并非彻底抛弃工艺,而是在不依赖先进节点的前提下,通过压缩时间常数释放性能红利。它特别适用于成熟工艺(如14nm++++++)的再升级。
9050 Pro前瞻总结
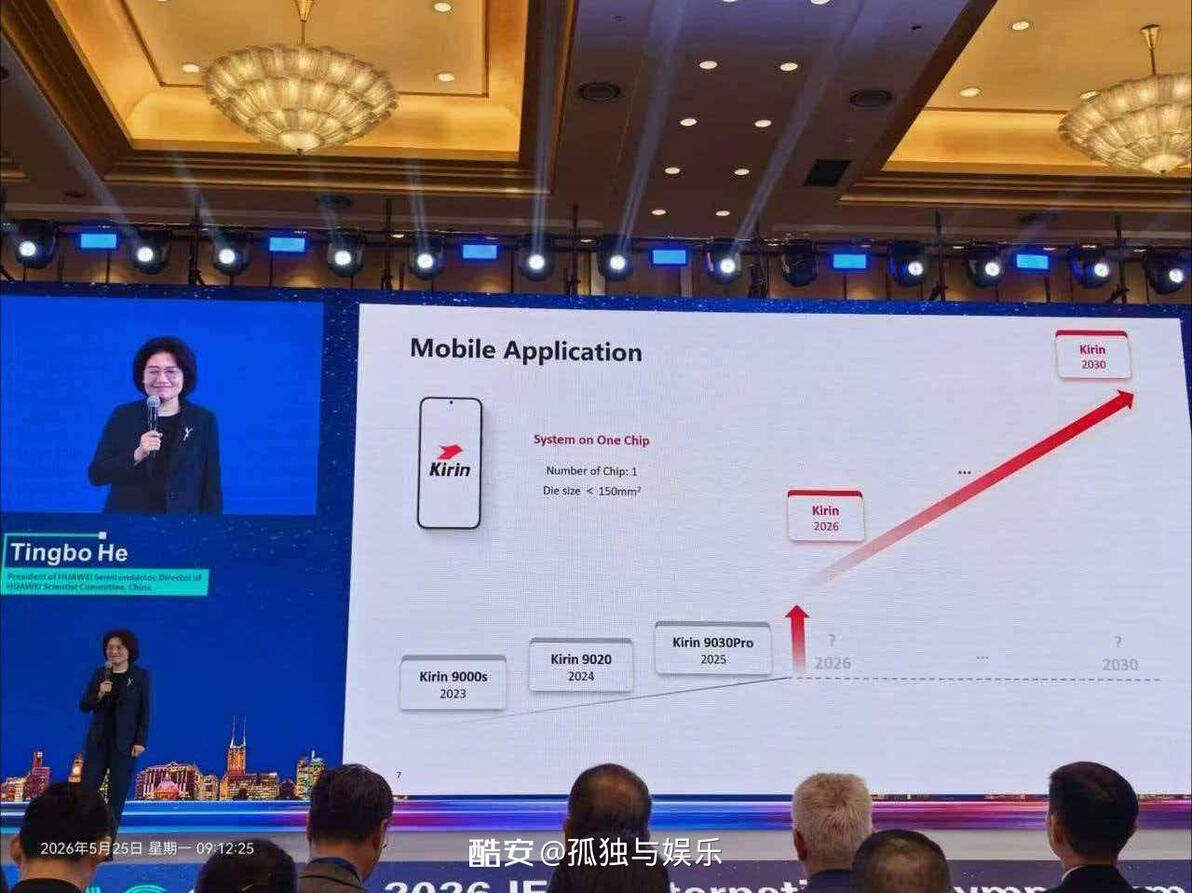
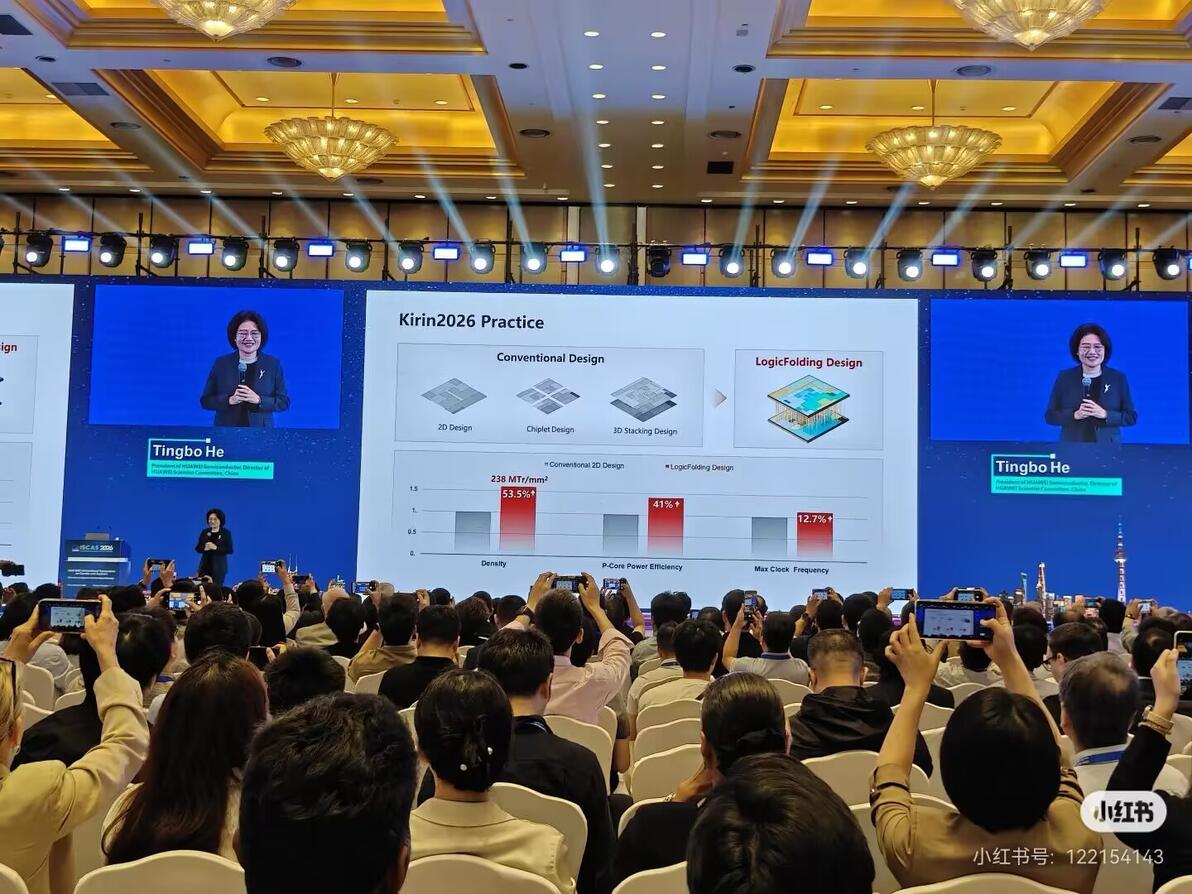
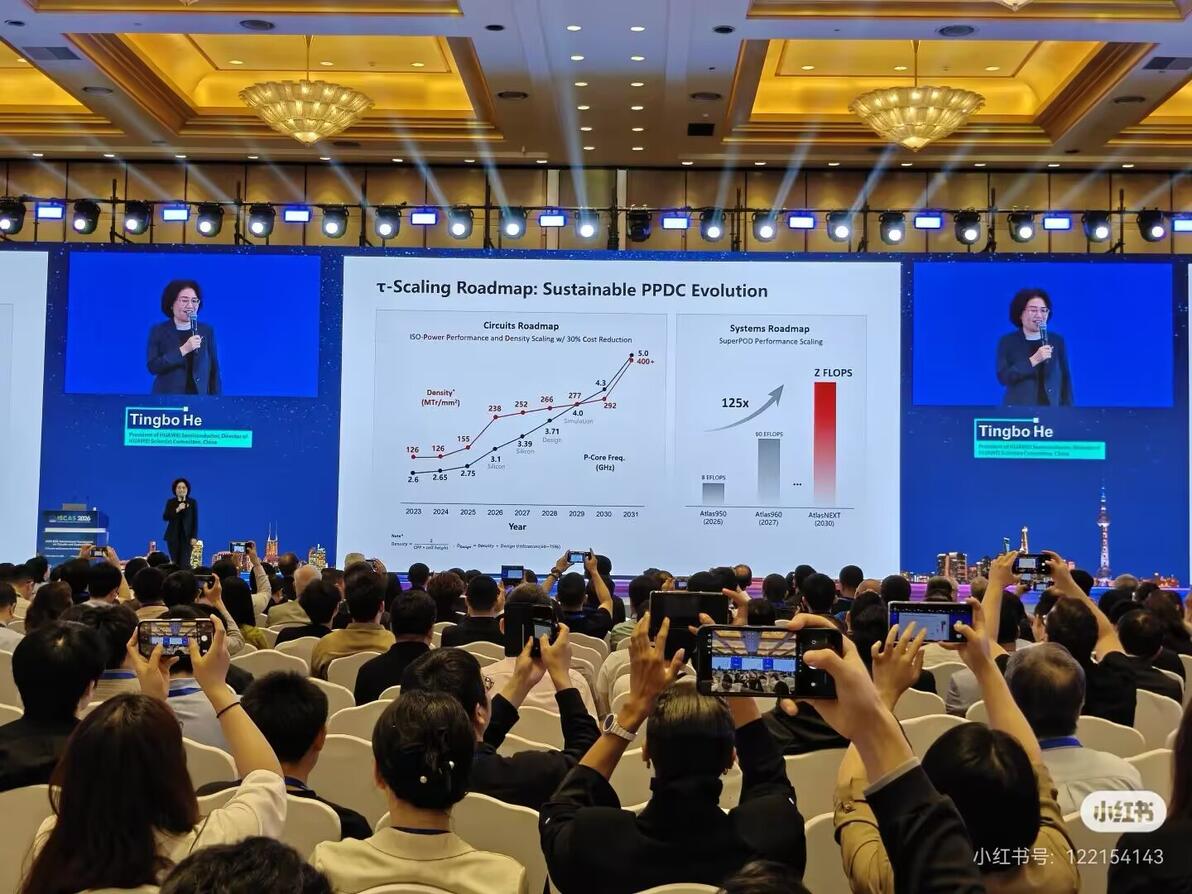
看到这几张图可以说振奋人心啊,第一张图的意思就是后续将采用堆叠工艺结合工艺进步,性能持续高强度增长,然后再是第三张图,如果只堆两层的话,那么下半年对应的2D晶体管逻辑密度为238/2=119mtr/mm²,然后貌似要到2031年还能用上N3级别的euv工艺了,现在据我所知进度是很快,但是华子用的不快,应该也是为了成本考量的吧,工艺方面我不太了解,后续去看我好大哥@_zyslover_ 的分析,然后就是第二张图了,激动人心的时刻来了,首先是频率较9030 Pro的LinXi Big Core*3rd提升12.7%,达到3.1GHZ左右,可喜可贺,频率终于破3了,直指麒麟9000的3.13GHZ的A77HP库性能中核,然后能效提升41%左右,刚开始太太太爷爷报出来的频率为3.05GHZ,但是因为积热严重,我们后续一直都认为频率在终端上可能会降低,没想到啊,哈哈哈,竟然还提高了,还可以告诉大家的是华为内部对每颗芯片都会做一个“定调”,华子只跟苹果进行对比,9030Pro对应的是A16,而这次的9050 Pro对应的是A18标准版,当然单核还是远远不如,所以这次我又来贷款一次性能,哈哈哈
核心排布为1(超大核)+3(高频性能大核)+4(能效大核)+2(低功耗岛小核)
频率设定为3.1GHZ+2.75GHZ+2.25GHZ+2.05GHZ
超大核不改架构,应该仅靠这次的设计提升流水线级数和分支预测失误率以换取频率,460*1.428*1.025*1.025*3.1=2139左右,骁龙8Gen2水平
大核会改架构,也是主要改善跑高频的能力。
性能大核,460*1.17*1.125*2.75=1665,符合天机8400性能核A725水平
能效大核,460*1.17*1.08*2.25=1307,和麒麟9000s的单核差不多
小核估计不改架构,所以
小核,460*0.45*1.1*2.05=467
按照GB 6麒麟开超线程但是核较前代多了2个,估多核利用率按0.75估算
2139+1665*3+1307*4+467*2=13296*0.75=9972
多核X90水平应该没问题,能效估计是9400左右水平?以后我的测试不会再出现GB 6的多核了,这个东西争议很大,故以后多核能效曲线仅看GB 5但也不能代表实际负载,仅供参考,最终还是要以实际表现为主
GPU呢,我发现了个规律,好像每年频率就提升个90MHZ左右,750,840,933,那么下一代就估计是1020MHZ左右了,只要不乱改架构,从6 CU提升到8 CU的话,计算单元将达到恐怖的2048个,众所周知,马良935的纯架构提升仅对比920只有7%到12%左右,就按955同频率同规模提升10%来算吧,WLE马良935是3300左右,则下一代大概是3300/6*8/933*1020*1.1-200=5091左右,大概是接近8Gen3的水平吧
SNL马良935是1000左右
则1000/6*8/933*1020*1.1-50=1553左右,也大概是接近8G3的水平,不如A18标准版,能效估计介于8G2到8G3之间吧。
所以下一代估计吃CPU的游戏不会有太大问题了,GPU的短板也在慢慢被补上,然后下一代NPU也会堆规模,托梦得到int 8算力大概为50 TOPS,也是一个不错的提升,大约为72%左右,又赶上了移动端的主流水平。
差不多就是这样,感谢大家观看,等着下半年我自费磨dieshot和新一次微架构逆向的好消息吧还有暑假后期别忘了来赤咕噜咕噜G6的蚀,估计大核又会有一个明显提升。
