
美团开源LongCat-Video-Avatar 1.5深度解析:当数字人从"彩排室"走向"真实舞台"
生成10秒视频仅需1分钟,推理效率提升15倍,多项指标超越顶尖闭源模型
2026年5月24日,美团LongCat团队正式开源了LongCat-Video-Avatar 1.5——一款从开源SOTA迈向商业级应用的数字人视频生成模型。这不仅是版本的迭代,更标志着数字人视频生成正在经历从"展示效果"到"真实使用"的质变。
从"高拟真"到"真可用":技术跃迁的四个维度
如果你关注过2025年12月LongCat-Video-Avatar初版的发布,一定还记得它带来的惊艳——基于单张参考图和音频就能生成超逼真、口型同步的长视频。但"惊艳"不等于"可用",尤其是在商业场景中,稳定性、自然度和效率才是真正的"命门"。
LongCat-Video-Avatar 1.5正是瞄准了这些"命门"下刀,在四个方面实现了全面跃升:唇形同步、物理合理性、长视频稳定性、多人互动和高效推理。
1. 听得更准,说得更真:Whisper-large 取代 Wav2Vec2
音频特征提取是数字人视频生成的"第一道关口"。如果模型连"什么时候开口、用什么口型开口"都搞不清楚,后续一切都是空中楼阁。
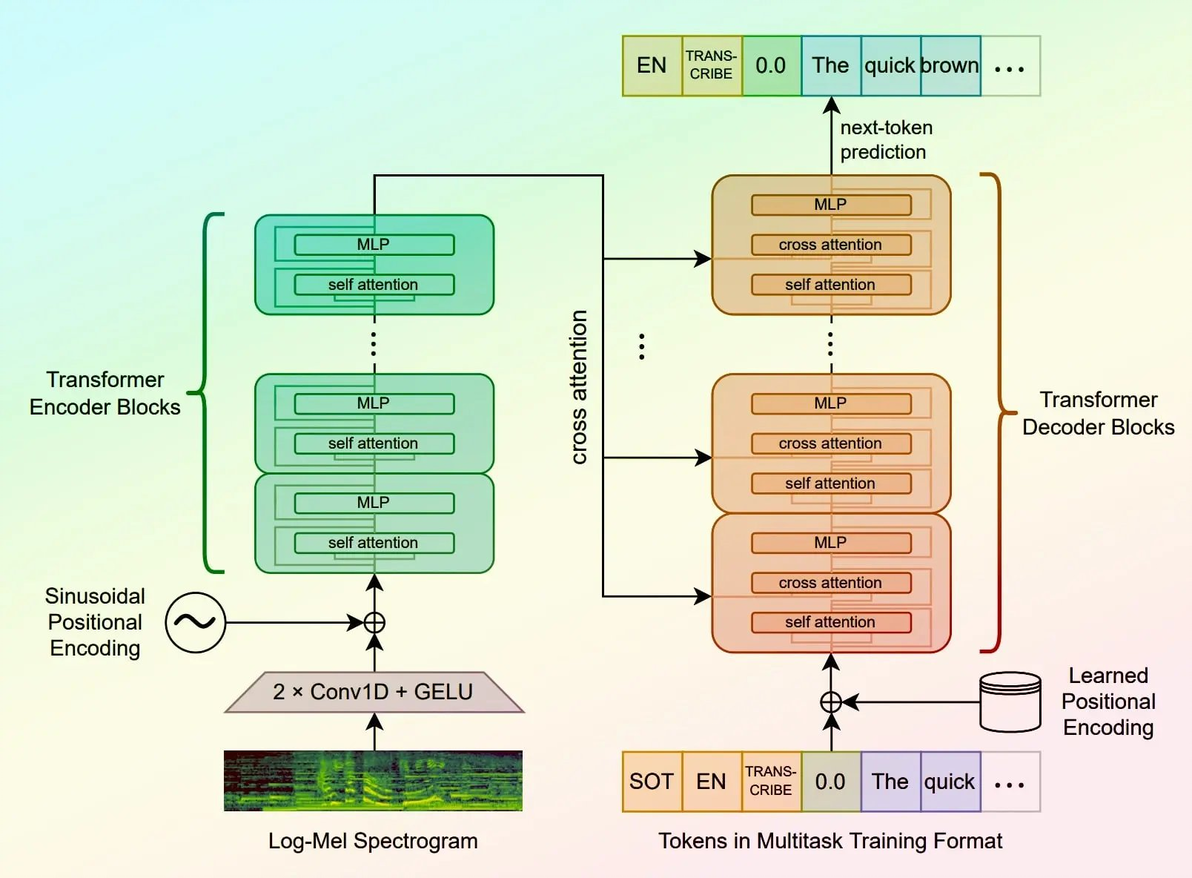
LongCat团队做了最直接也最有效的操作:将编码器从 Wav2Vec2 升级为 Whisper-large。
更大的参数量意味着更强的表征能力,而Whisper原生具备的多语言先验知识,让模型能够更细致地捕捉音素变化、发音节奏和多语言韵律。用大白话说就是:模型终于能"听懂"每一句话的节奏和情绪了。
这一升级的连锁反应非常显著——不仅仅是唇形同步更精准,面部表情、头部姿态、肩颈和肢体动作与语音的协同也变得更加自然。长视频中最令人头疼的抖动、跳帧、画面冻结和身份漂移问题,得到了大幅缓解。
2. 用数据"喂养"出来的泛化能力
商业场景中的数字人形态是千奇百怪的:真人主播、虚拟偶像、动漫角色,甚至动物。这就要求模型必须具备极强的开放域泛化能力,不能只对着"标准脸"表现良好。
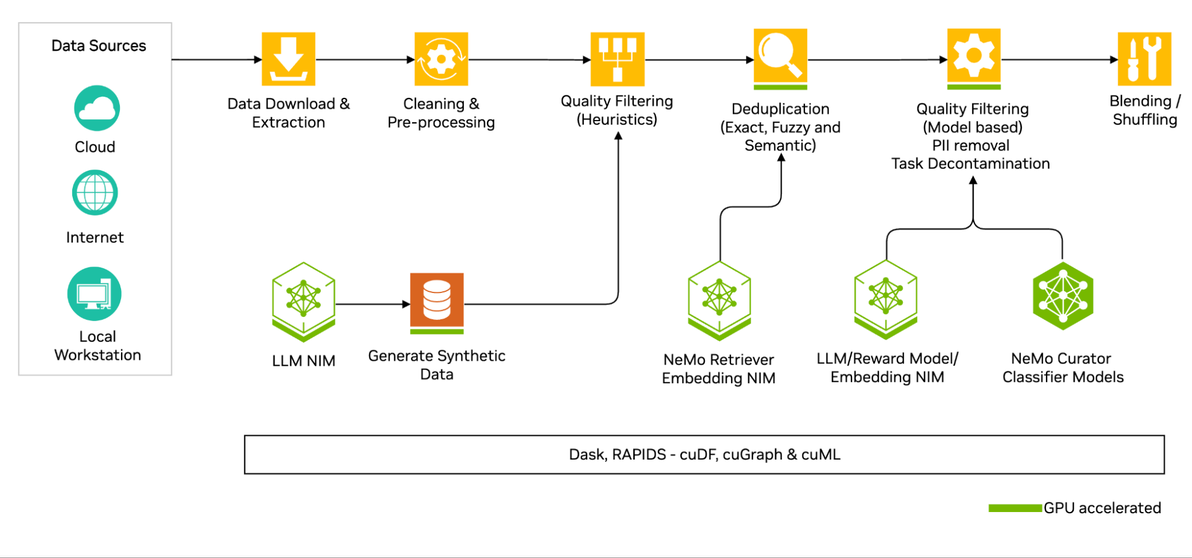
LongCat团队构建了一套多阶段数据处理流程:先通过离线标注提取人脸关键点、人物数量、身体构图、音画同步等属性,再通过在线验证自动过滤转场、黑帧、闪烁、跳帧等低质量片段。
更值得关注的是,他们专门构建了三类增强数据:
多人数据:通过主动说话人检测,保留同一时刻只有单一说话人的片段,从源头降低多人场景的音画歧义
静默数据:筛选人物未说话的视频,让模型学会无语音状态下的微表情、视线与身体动态,避免非说话角色"嘴部乱动"
情绪数据:结合多模态初筛与帧级情绪识别精筛,注入情绪变化过程
这套组合拳打下来,模型面对不同角色、不同语言、不同内容形态时的适应能力大幅提升。从测试数据来看,多人场景得分达到了2.730,大幅领先此前的InfiniteTalk(2.339),在说话者/聆听者区分上优势明显。
3. GRPO对齐:逐帧打磨,不让手"崩掉"
数字人视频生成中有一个经典难题:手部变形。即使是顶尖的商业模型,也经常会出现手指数量不对、手势不自然、动作卡顿等问题。这在电商直播、产品展示等场景中是致命伤。
LongCat团队引入GRPO(Group Relative Policy Optimization)进行人类偏好对齐,并做了一件极其精细的事——将奖励信号细化到逐帧层面。
这意味着什么?传统对齐方法可能只看整段视频的"总体质量",但GRPO逐帧机制能精准定位到具体是哪一帧出现了手部变形、动作不连贯、短时结构崩塌,然后针对性修正。
针对图像到视频和视频续写任务,团队还加入了首帧手部检测机制,优先提高含可见手部样本的训练比例。最终成果是:主体变形问题率仅为23.1%,低于所有对比模型。虽然这个数字看起来不算低,但在数字人视频生成这个"魔鬼细节"密集的领域,已经是商用级的优异表现。
4. 效率革命:15倍加速,1分钟生成10秒视频
技术再好,跑不快就没用。商业场景对实时性的要求极其苛刻。
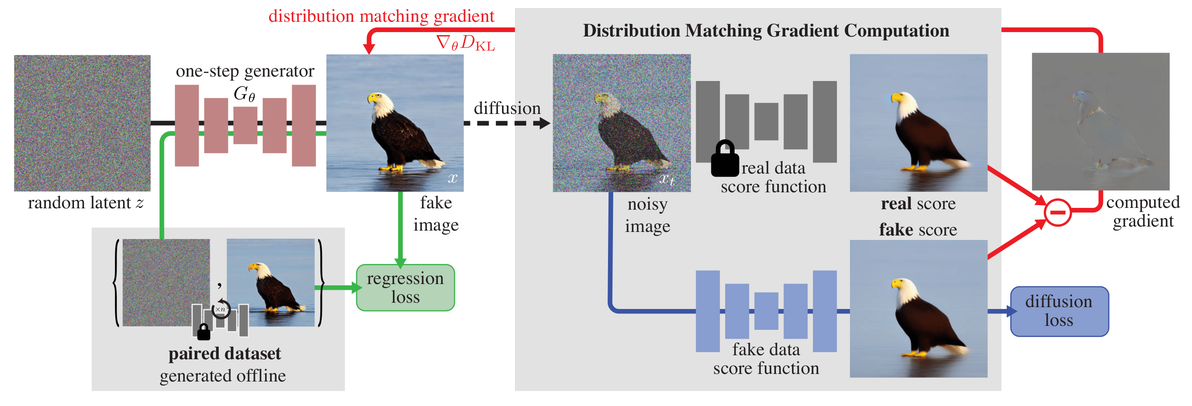
LongCat-Video-Avatar 1.5采用 DMD(Distribution Matching Distillation)蒸馏技术,将原本整整50步的生成过程压缩到惊人的8步。
8步是什么概念?相当于把一本300页的书压缩到48页,却保留了绝大部分信息量。
与此同时,团队用一个共享基础模型 + 多个LoRA适配器替代了传统三模型并行的方案,大幅降低显存开销——你不再需要一台"小型发电机组"来跑数字人模型。
实际测试中,推理效率提升约15倍,生成10秒视频仅需约1分钟。
硬碰硬的数据:超越闭源模型的底气
Talk is cheap,show me the numbers。LongCat团队基于EvalTalker构建的综合评测基准,由770名评估者完成13,240条主观评分,并由10名领域专家进行结构化质量分析,数据含金量十足。
在物理合理性、时间稳定性、身份一致性和音视频协调性四个维度上,LongCat-Video-Avatar 1.5的雷达图面积全面领先。用户偏好测试的数据尤其亮眼:
相比 Kling Avatar 2.0 胜率 65.9%
相比 OmniHuman-1.5 胜率 61.1%
相比 HeyGen 胜率 54.3%
在具体指标上:
单人场景得分3.336,显著高于HeyGen、OmniHuman-1.5等产品
跳帧问题率仅0.8%,是所有对比模型中最低
面部-身体同步问题率5.1%,音视频协调性最优
唇形同步问题率29.8%,低于所有对比模型
开源生态:不只是模型,更是技术基座
LongCat-Video-Avatar 1.5的完整开源资源已在多个平台同步开放:
GitHub:网页链接
HuggingFace:https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
ModelScope:https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary
Tech Report:查看技术报告
Project Page:https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
从2025年12月首次发布LongCat-Video-Avatar,到2026年5月推出1.5版本,美团LongCat团队保持了高强度的迭代节奏,而且始终坚持开源。
行业意义:数字人正在跨过"应用鸿沟"
在我看来,LongCat-Video-Avatar 1.5发布的意义不仅在于技术指标的领先,更在于它清晰地传递了一个信号:数字人视频生成正在从"实验室里的展示效果"走向"真实世界中的规模化应用"。
过去,数字人视频生成面临三大难题:效果不够自然、成本太高、跑得不够快。1.5版本用DMD蒸馏+LoRA架构解决了效率问题,用GRPO对齐+高质量数据体系解决了自然度问题,用开源生态降低了准入成本。
展望未来,数字人视频生成的下一个战场将是"实时互动"。当你和数字人主播对话时,她能实时调整表情和动作;当你在虚拟会议室开会时,每个数字人都能有自然的微表情和肢体语言。LongCat团队已经在多人场景和静默数据上做了铺垫,这或许正是下一代版本的方向。
从"彩排室的完美演练"到"千人千面的真实舞台",LongCat-Video-Avatar 1.5迈出了坚实的一步。而这一步,是整个行业向前的重要里程碑。
作者点评:开源社区最大的魅力在于"众人拾柴火焰高"。LongCat-Video-Avatar 1.5选择在2026年年中这个时间点开源,恰逢数字人技术从"探索期"进入"应用期"的关键节点。如果你正在做数字人相关的产品开发,现在绝对是上车的最佳时机——模型、代码、技术报告全套开放,1分钟生成10秒视频的效率已经足够支撑大多数商业场景。美团在AI领域的这次"降维打击",值得每一位从业者认真对待。
本文部分图片来源于网络,版权归原作者所有,如有疑问请联系删除。
