
想必持续学习相关领域的朋友都关注了MIT最近那篇硬核工作“RL’s Razor”,它从理论和实验上证明:RL比SFT更不容易遗忘旧任务!
不过MIT这篇更大的价值不在于它证明RL更强,而是给我们指了一个前沿方向:RL+CL。近两年顶会上这个交叉方向的文章数量明显在涨,但远没到卷的程度。机器人、大模型、自动驾驶、医疗图像...只要任务流是动态的,RL+CL都能讲故事。如果感兴趣,现在正是上车的好时候!
为了帮助各位快速上手,我整理了11篇强化学习+持续学习相关的高质量论文(含MIT这篇),有综述也有最新方法,无偿分享。拿到手就能直接省去筛资料的精力,快速摸清这方向还能发什么、缺什么。
扫码添加小享,回复“强化持续”
免费获取全部论文+开源代码
RL’S RAZOR: WHY ONLINE REINFORCEMENT LEARNING FORGETS LESS
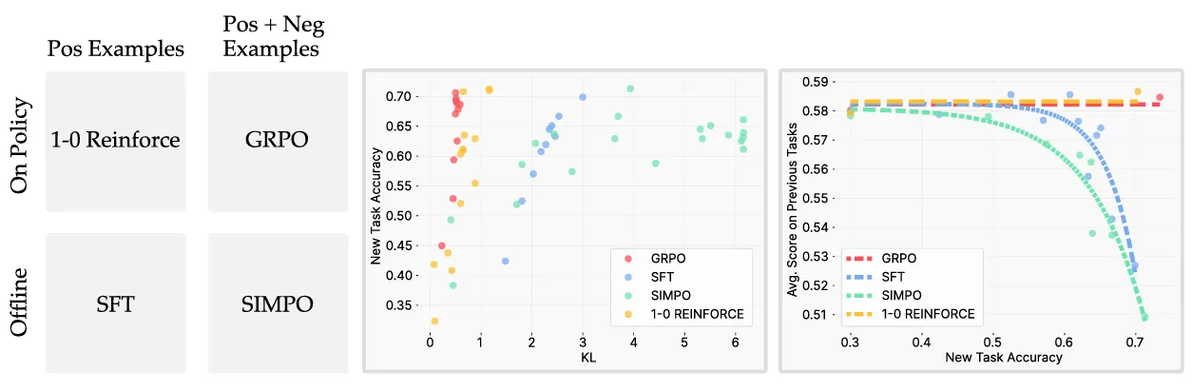
研究方法:论文以持续学习中灾难性遗忘为核心问题,对比在线强化学习与有监督微调,通过LLM、机器人模型及受控实验,结合KL散度量化分布偏移与理论推导,验证在线RL因隐式KL最小化偏向原模型分布,从而在持续适配新任务时显著减少旧技能遗忘。
创新点:
实证发现在线强化学习相比监督微调在同等新任务性能下,能显著保留模型旧有能力,更少发生灾难性遗忘。
提出经验遗忘定律:新任务上微调模型与原模型的KL散度,可精准预测遗忘程度,为量化遗忘提供统一指标。
揭示RL剃刀原理:在线策略更新天然偏向与原模型KL最小的最优解,从理论上阐明RL抗遗忘机制,为持续学习优化提供新方向。
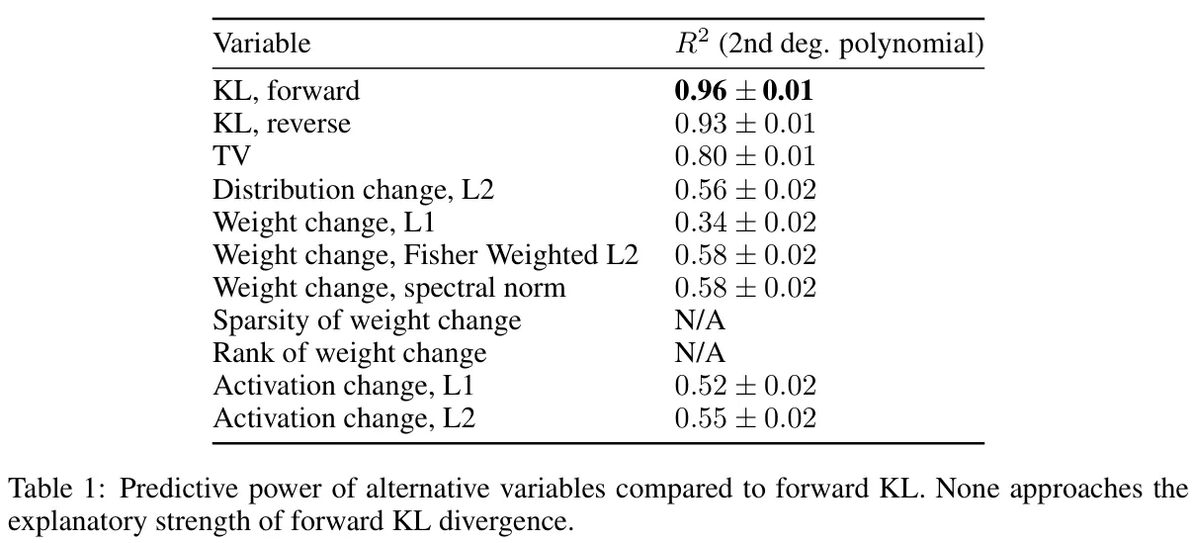
研究价值:论文提出RL 剃刀原理,揭示在线强化学习微调因天然偏向与原模型 KL 散度最小的新任务解,比监督微调遗忘更少,且证明新任务上的 KL 散度可精准预测灾难性遗忘程度,为大模型持续学习提供核心理论依据。
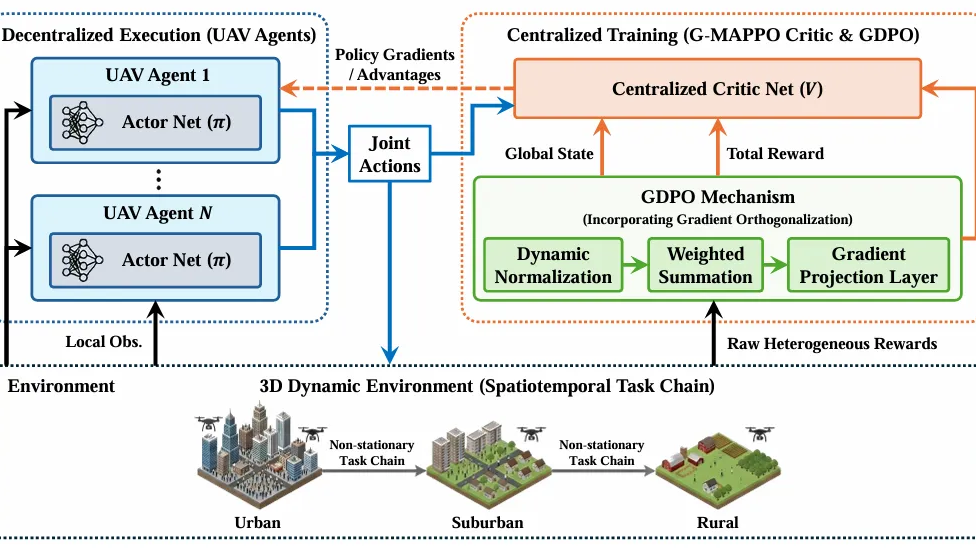
Spatiotemporal Continual Learning for Mobile Edge UAV Networks: Mitigating Catastrophic Forgetting
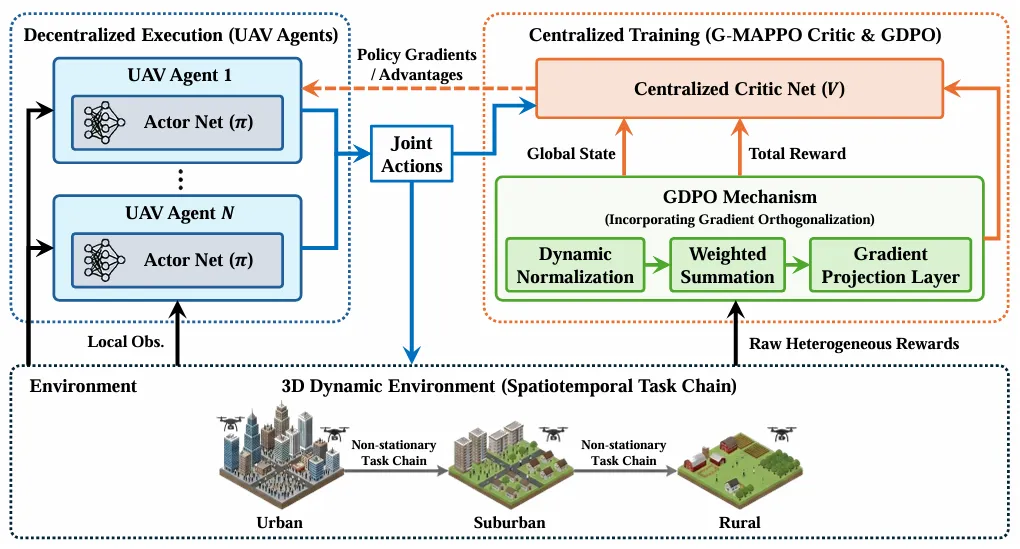
研究方法:研究面向移动边缘无人机网络,提出时空持续学习框架,基于多智能体强化学习,融合群体解耦策略优化、梯度正交化与三维空间补偿,实现动态时空环境下的持续学习,有效缓解灾难性遗忘,提升无人机集群长期自适应能力。
创新点:
提出时空持续学习(STCL)框架,面向动态移动边缘无人机网络,有效解决环境切换时的灾难性遗忘问题。
设计G-MAPPO强化学习算法,融合组解耦策略优化与梯度正交化机制,平衡能量效率、用户公平、覆盖等多冲突目标。
引入三维空间补偿,通过无人机动态高度调节应对用户密度极端变化,提升复杂场景下的自适应能力与服务稳定性。
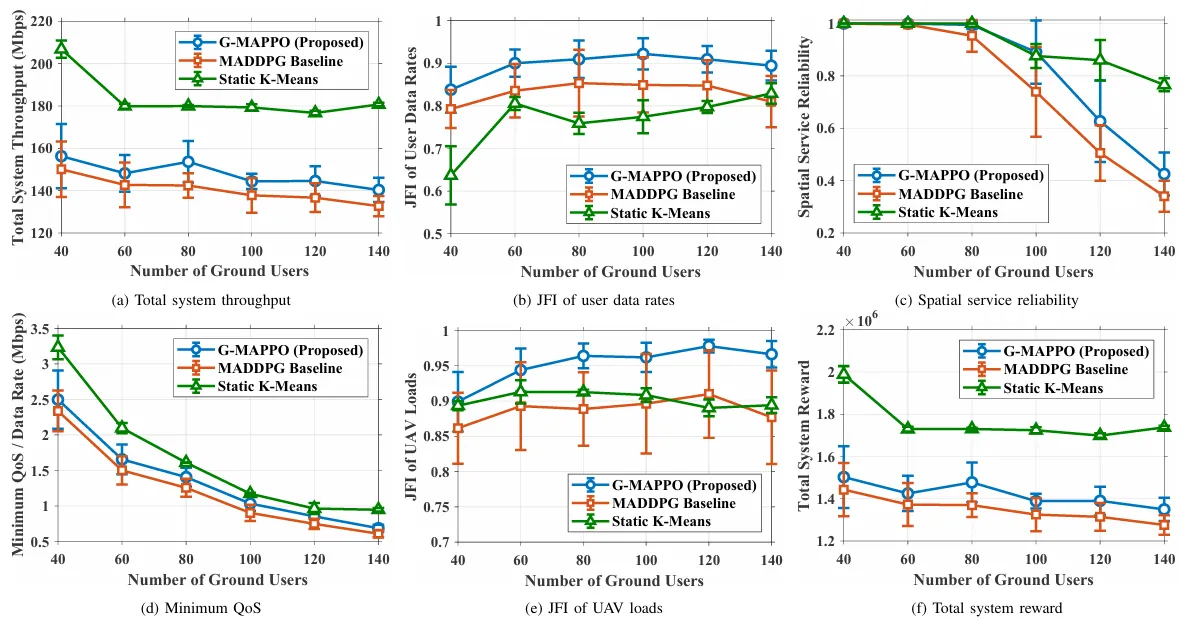
研究价值:研究提出的STCL框架与G-MAPPO算法,为动态移动边缘无人机网络提供了持续学习+强化学习的一体化解决方案,有效缓解灾难性遗忘、提升多目标优化能力,为大规模空中边缘集群的长期稳定运行提供了理论支撑与技术路径。
扫码添加小享,回复“强化持续”
免费获取全部论文+开源代码