
本文是Google DeepMind团队最新研究 Image Generators are Generalist Vision Learners 的深度解读,这项研究介绍了 Vision Banana,一个通过对图像生成模型进行轻量级指令微调而构建的全能型视觉模型。作者提出,图像生成预训练不仅能合成高质量图像,还让模型习得了深刻的视觉理解与表征能力,其角色类似于大语言模型中的文本预训练。通过将深度估计和语义分割等感知任务重构为图像生成问题,该模型在保持原始生成水平的同时,在多项 2D 和 3D 视觉任务上达到或超越了专门的领域专家模型。这种方法证明了图像生成可以作为一种统一且通用的视觉任务接口,预示着计算机视觉领域可能正向以生成式预训练为核心的基础模型范式转变。
大家好!长久以来,我们一直认为AI图像和视频生成模型仅仅是用来“创造”视觉内容的工具。然而,Google DeepMind 的最新研究提出了一个颠覆性的观点:创造视觉内容的能力,实际上意味着对视觉世界的深刻理解。这项研究证实,图像生成模型的预训练过程,本质上发挥了与大语言模型(LLM)预训练相似的作用,让模型学到了强大且通用的视觉表示能力,成为了一个隐秘的“视觉通用学习器(Generalist Vision Learner)”
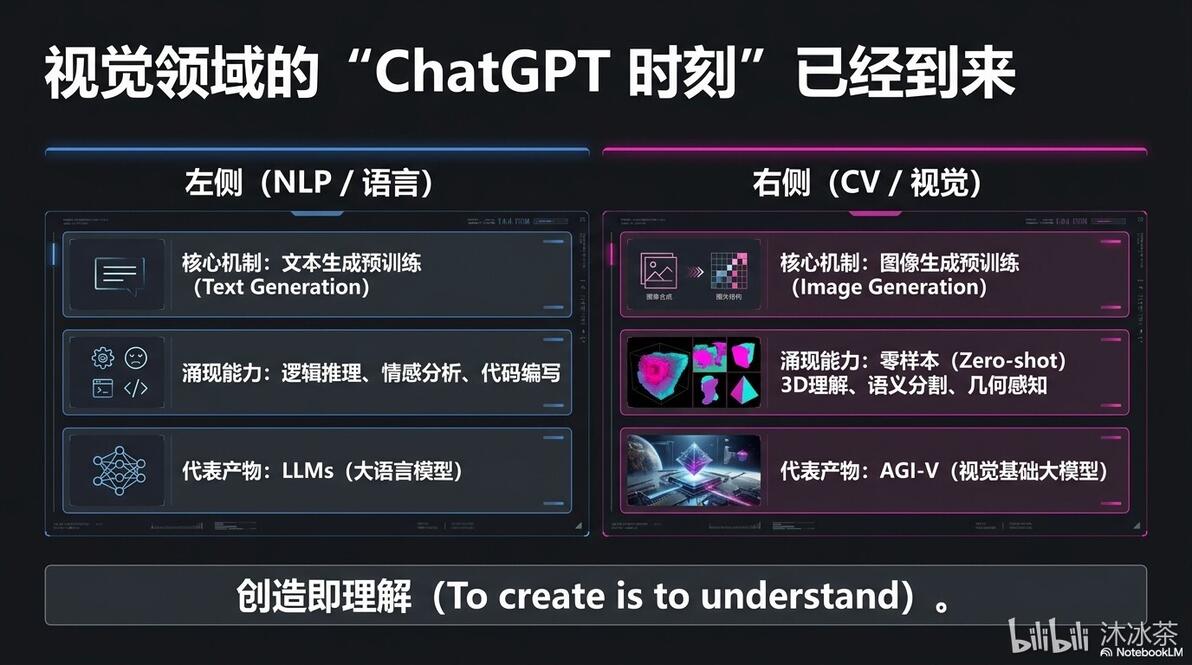
我们可以把当前的计算机视觉发展,与自然语言处理(NLP)领域做个类比。在 NLP 领域,模型通过海量的“文本生成”预训练,涌现出了令人惊叹的逻辑推理和语义理解能力,诞生了 ChatGPT 这样的大语言模型。而在右侧的视觉领域,历史正在重演:通过海量数据的“图像生成”预训练,生成模型同样涌现出了零样本(Zero-shot)的3D理解、语义分割和几何感知能力。这印证了“创造即理解(To create is to understand)”的理念,标志着视觉通用基础模型(AGI-V)的时代正在开启
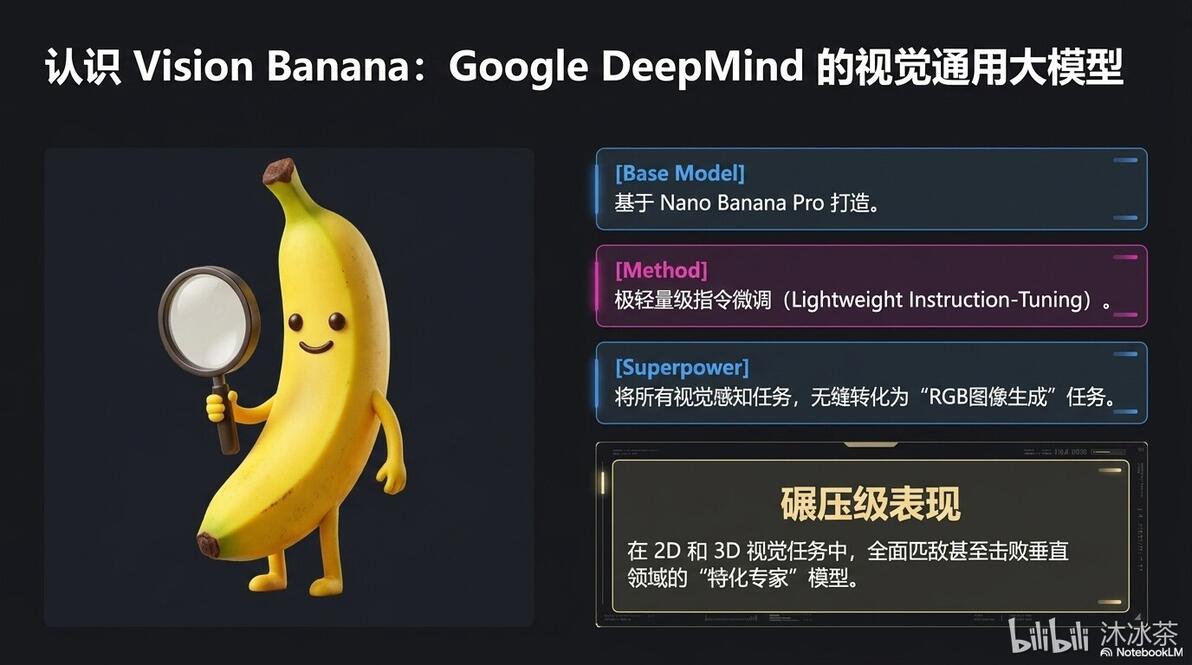
为了验证这一假设,研究团队推出了这只“长着香蕉脸”的通用大模型——Vision Banana。它的底座是先进的图像生成模型 Nano Banana Pro。研究人员采用了一种极轻量级的“指令微调(Lightweight Instruction-Tuning)”方法,将少量视觉任务数据混合到原始训练数据中。它的核心“超能力”在于:将所有的视觉感知任务,无缝转化为了最基础的“RGB图像生成”任务。最终,这个单一的通用模型在2D和3D视觉任务中,表现出了碾压级的实力,全面匹敌甚至击败了垂直领域的特化专家模型
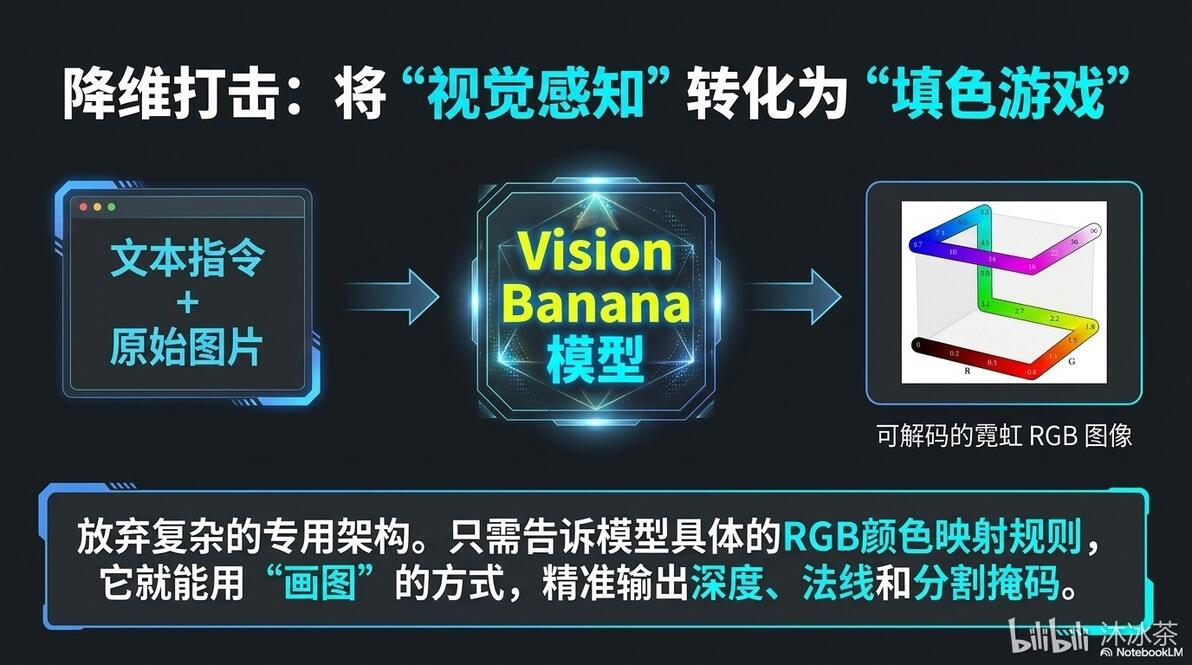
Vision Banana 是如何做到的呢?答案是“降维打击”。传统视觉模型需要复杂的专用架构和损失函数来处理特定任务。而 Vision Banana 彻底抛弃了这些,它要求模型按照提示词(Prompt)中指定的颜色映射规则,直接“画”出包含深度、法线或分割信息的RGB图像。例如,它可以通过将无界的物理深度值经过“幂变换(Power Transform)”映射到有限的RGB色彩空间中,生成一张可以直接解码回精确数据的伪彩色可视化图像。这不仅大大降低了对新训练数据的需求,还保留了模型原本的生成能力
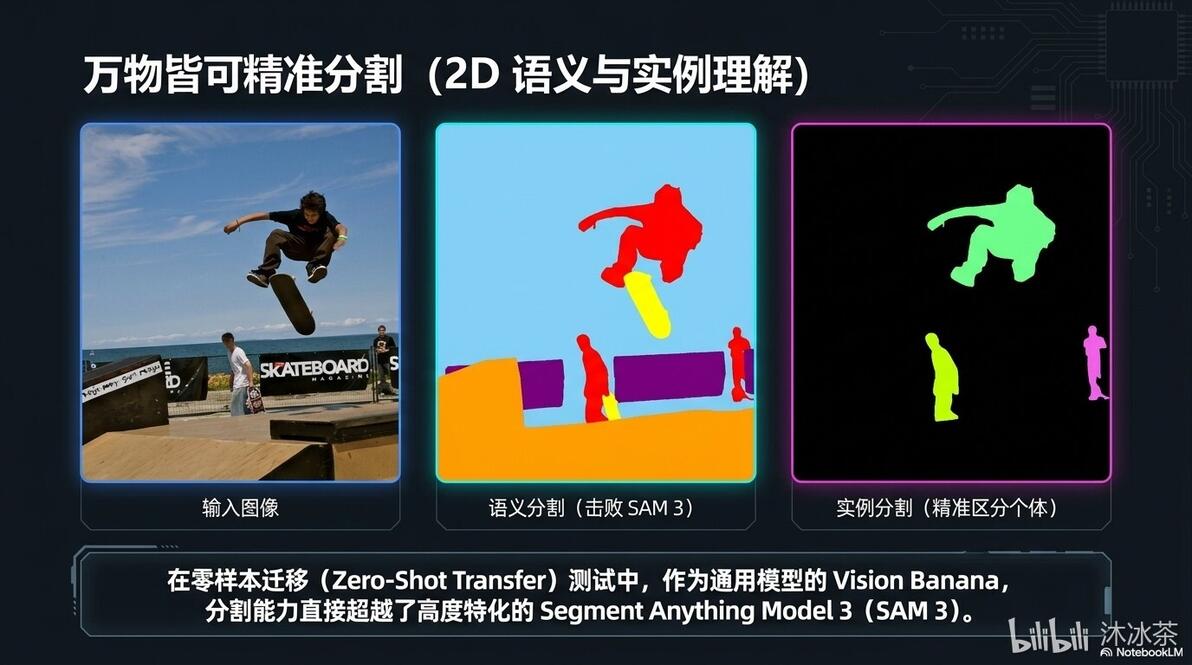
在2D语义和实例理解方面,Vision Banana 展现了惊人的零样本迁移(Zero-Shot Transfer)能力。在经典的语义分割任务(如识别背景、人物、滑板)中,它只需接收类似“将滑板涂成纯黄色”的文本指令,就能输出精确的分割掩码。在 Cityscapes 验证集上,它取得了 0.699 的 mIoU 成绩,直接击败了高度特化的专家模型 SAM 3(0.652)。对于实例分割,它也可以通过逐个类别推理的方式,为同类别的不同个体分配不同的颜色进行精准区分
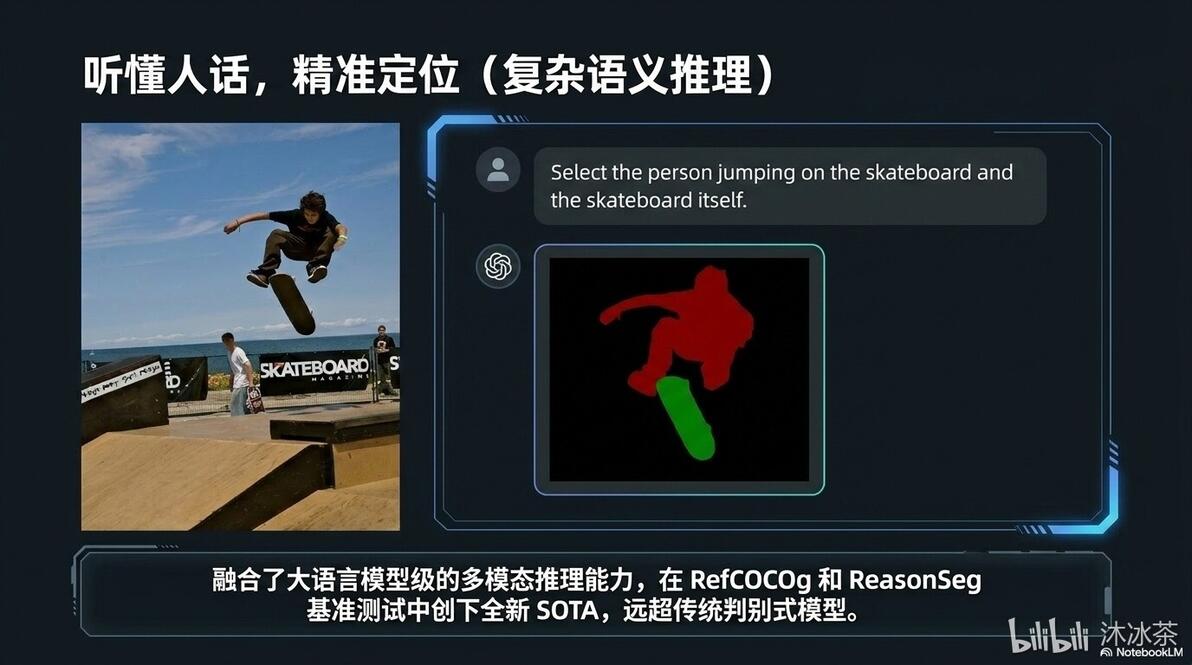
不仅是简单的物体分类,Vision Banana 在处理自由形式的文本提示(Referring Expression Segmentation)时,更展现了强大的多模态推理能力。如图所示,当你让它“选择在滑板上跳跃的人和滑板本身”时,它不仅能精准定位,还能理解动作和物体间的复杂关系。在 RefCOCOg 和 ReasonSeg 这两个高难度基准测试中,它分别取得了 0.738 和 0.793 的 SOTA 成绩,全面超越了采用零样本迁移配置的 SAM 3 Agent 及其他传统判别式模型
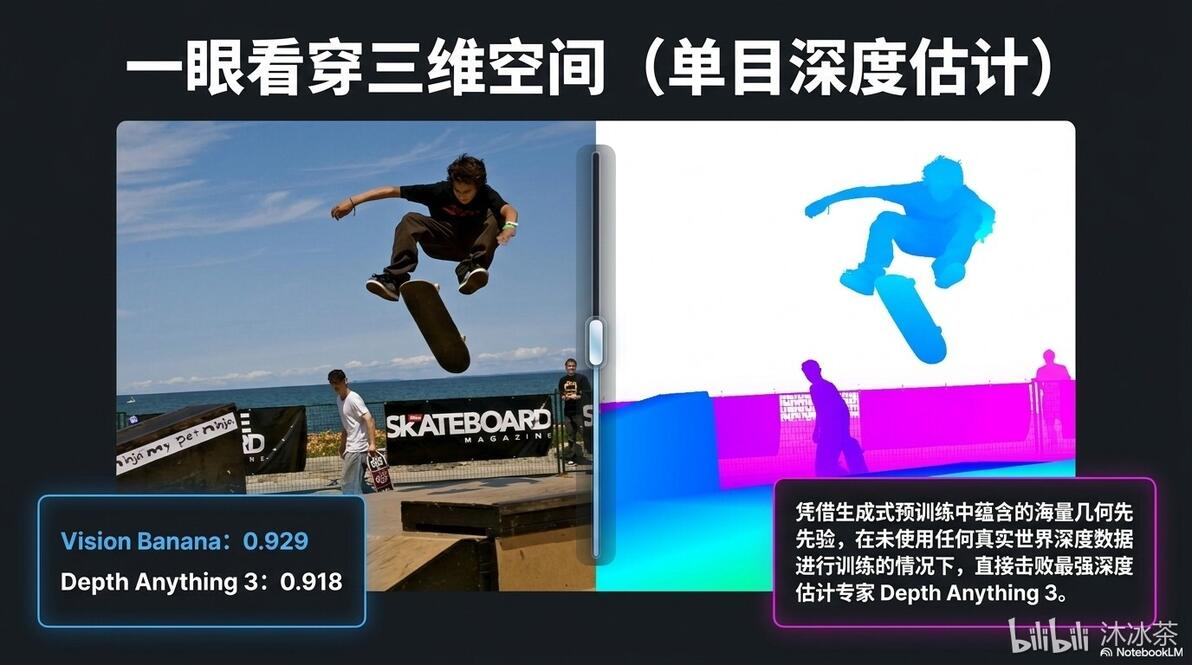
到了3D感知领域,单目深度估计一直是个极具挑战的难题,因为2D图像天然丢失了3D几何信息。但 Vision Banana 凭借生成式预训练中积累的海量世界知识和物体比例先验,在完全不使用任何真实世界深度数据训练、且推理时不依赖相机内参的情况下,直接“看穿”了三维空间。在包括 NYU、ETH3D 在内的4个测试集上,它取得了平均 0.929 的精准度,超越了该领域的目前最强专家模型 Depth Anything 3(0.918)
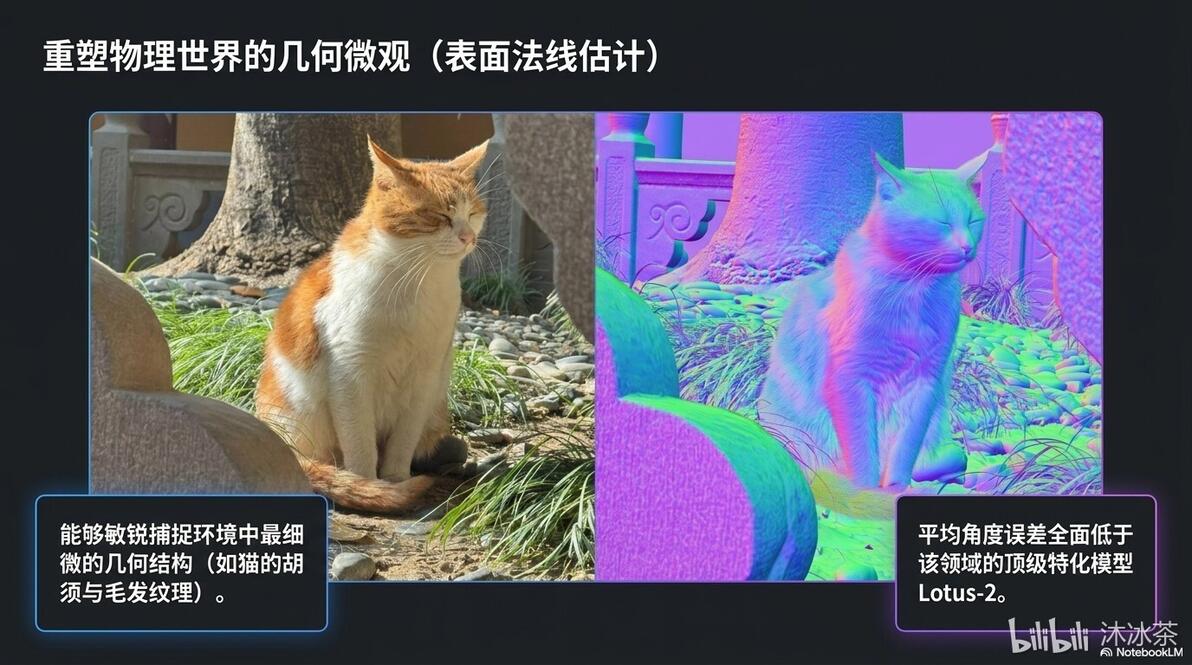
表面法线估计是理解局部几何形状的关键。Vision Banana 能够敏锐地捕捉环境中极其细微的几何结构。我们可以通过将方向向量直接映射到RGB通道(例如朝左对应粉红色,朝上对应浅绿色)来让模型生成法线图。从对比图中可以看到,无论是猫咪细微的胡须和毛发纹理,还是地面的石子形状,Vision Banana 都能完美还原。在室内数据集上,其平均角度误差(18.928)全面低于该领域的顶尖特化模型 Lotus-2
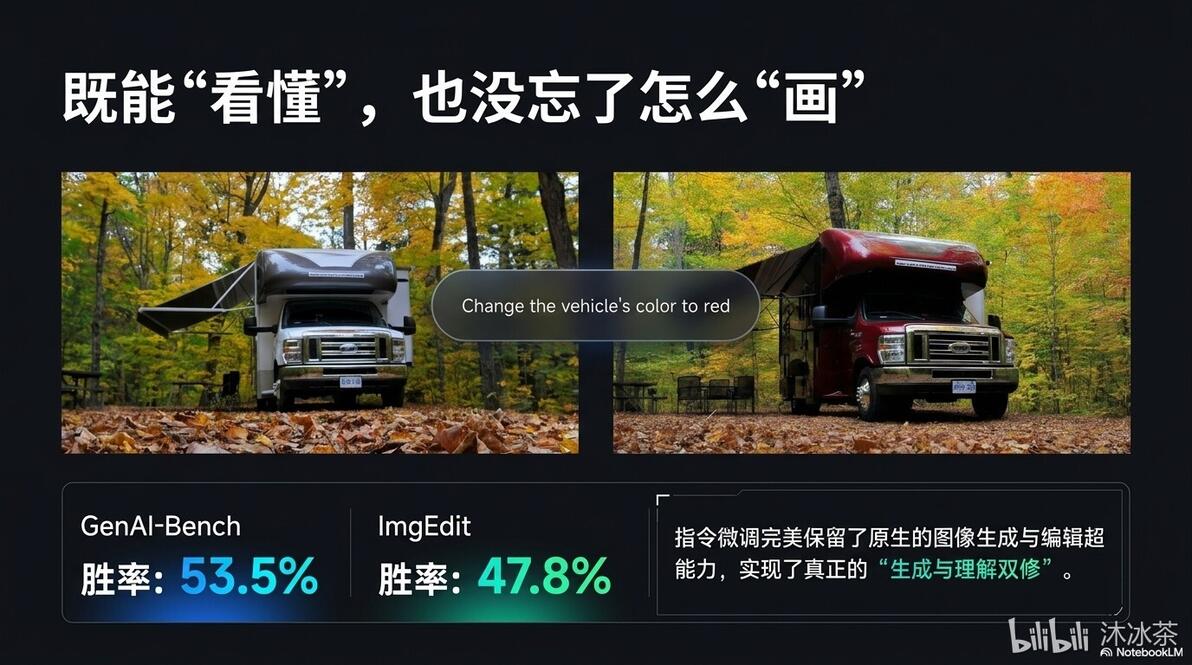
有人可能会问,微调之后,它还会“画画”吗?答案是肯定的。因为指令微调的混合比例极低,Vision Banana 完美保留了其原生基座模型 Nano Banana Pro 的图像生成与编辑“超能力”。在人类评估盲测中,它在文本到图像生成测试(GenAI-Bench)中对基座模型的胜率达到了 53.5%,在图像编辑测试(ImgEdit)中胜率达到了 47.8%。它真正实现了“生成与理解双修”,证明了轻量级微调不会破坏模型的原生能力
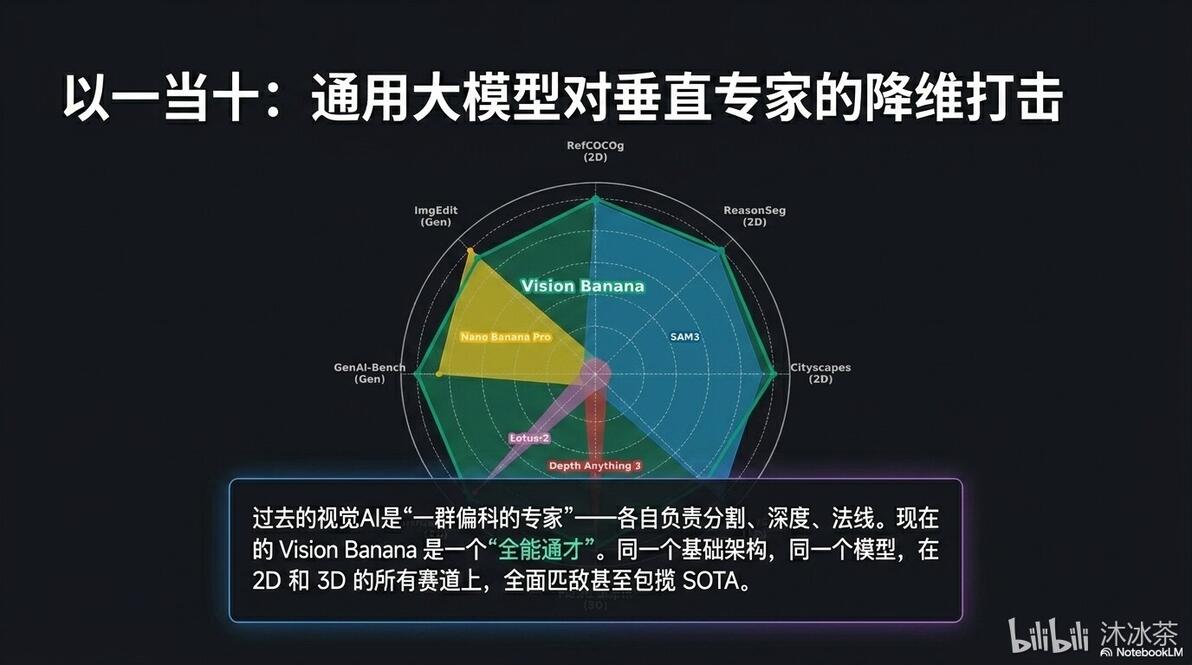
这张雷达图直观地总结了 Vision Banana 的统治力。过去的视觉AI是一群“偏科的专家”——各自负责分割、深度、法线等单一任务,需要专门的网络设计以避免输出结果模糊。现在的 Vision Banana 是一个“全能通才”。利用同一个基础架构和共享的权重,仅仅通过改变输入的提示词(Prompt),它就在 2D 和 3D 的各项核心赛道上,全面匹敌甚至包揽了 SOTA(State-of-the-Art)指标
总结来说,这项研究带来了两点深刻启示:第一,图像生成预训练已被证实是构建视觉基础通用大模型(Foundational Vision Models)的最强大途径。第二,复杂的专用计算机视觉架构,正在被统一的“视觉转化为RGB生成”范式所终结,图像生成将成为统一视觉理解的通用接口。展望未来,从单图扩展到多视角,再到视频流,生成式模型必将构建出真正的跨模态推理引擎,铺平通往 AGI-V 的道路。
