
选题依据(选题意义,国内外动态,初步设想及创新点等)及可行性论述
一、 选题背景与意义
1. 选题背景
随着数字娱乐产业的蓬勃发展,以Steam为代表的PC游戏平台汇聚了海量用户与游戏产品。面对庞大的信息规模,用户面临着"信息过载"的困境,难以高效发现符合个人偏好的游戏。传统的热门排行榜或简单分类浏览已无法满足用户日益个性化的需求。因此,构建一个能够精准理解用户兴趣、融合多维信息的智能推荐系统,成为提升平台用户体验、促进游戏生态健康发展的关键技术需求。
2. 选题意义
理论意义:
推荐算法融合探索:本研究旨在实践中探索协同过滤(基于用户/物品)与内容推荐算法的有效融合策略,为解决推荐系统中普遍存在的“冷启动”(新用户、新游戏)和“稀疏性”问题提供一种混合解决方案,丰富个性化推荐领域的应用案例。
大数据技术应用验证:通过将Hadoop生态的MapReduce分布式计算框架应用于游戏领域的数据处理与分析,验证其在处理非结构化、大规模用户行为日志方面的可行性与效率,为同类娱乐数据分析项目提供技术参考。
系统化功能闭环设计:构建从前端交互、数据处理、推荐生成、用户反馈到模型更新的完整闭环系统,为推荐系统的工程化实现提供可复用的架构参考。
实践意义:
提升用户体验:为用户提供“千人千面”的游戏推荐,缩短游戏发现路径,增强用户粘性与平台满意度。
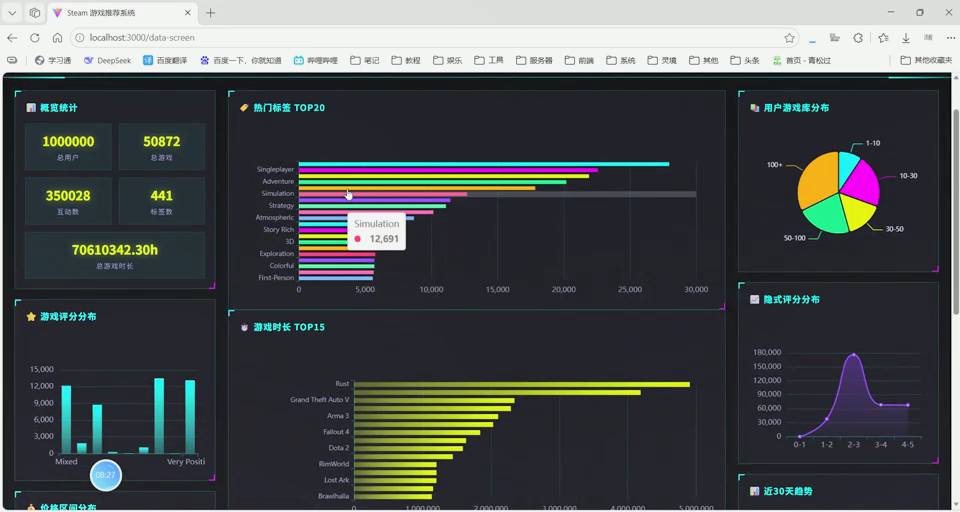
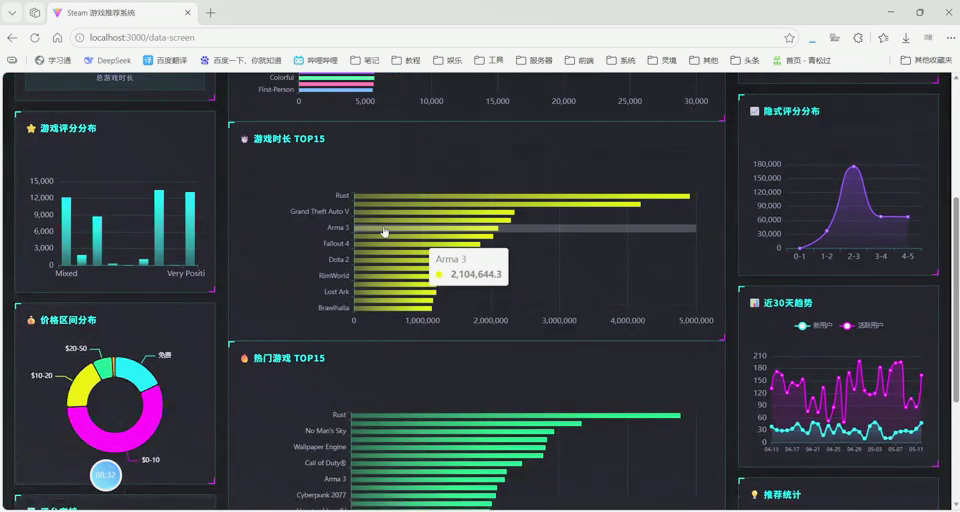
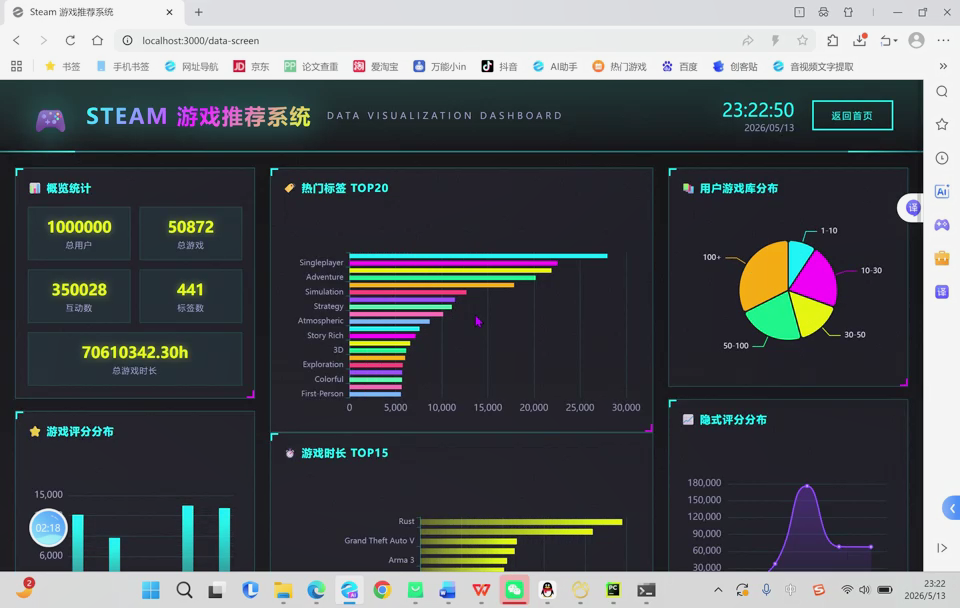
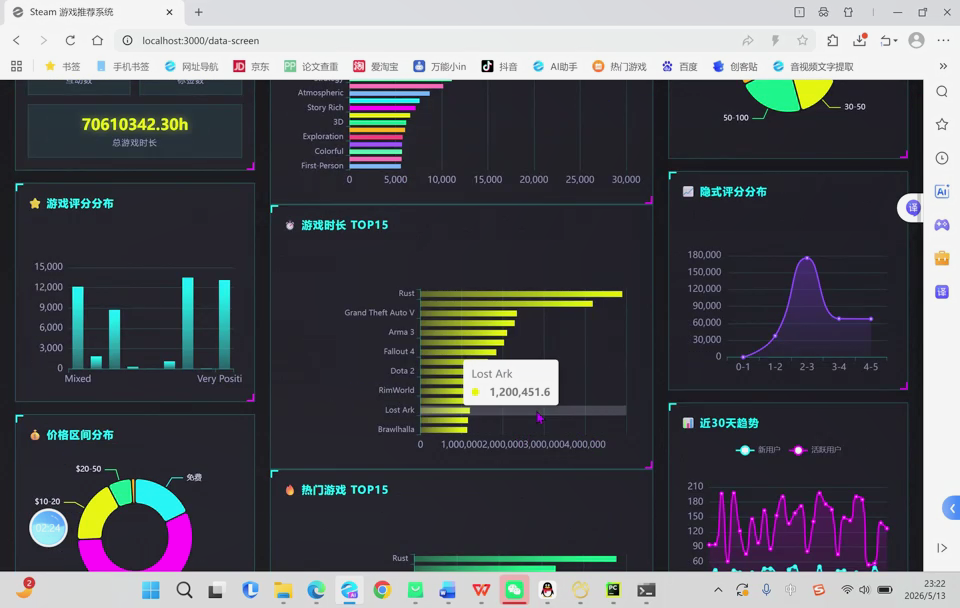
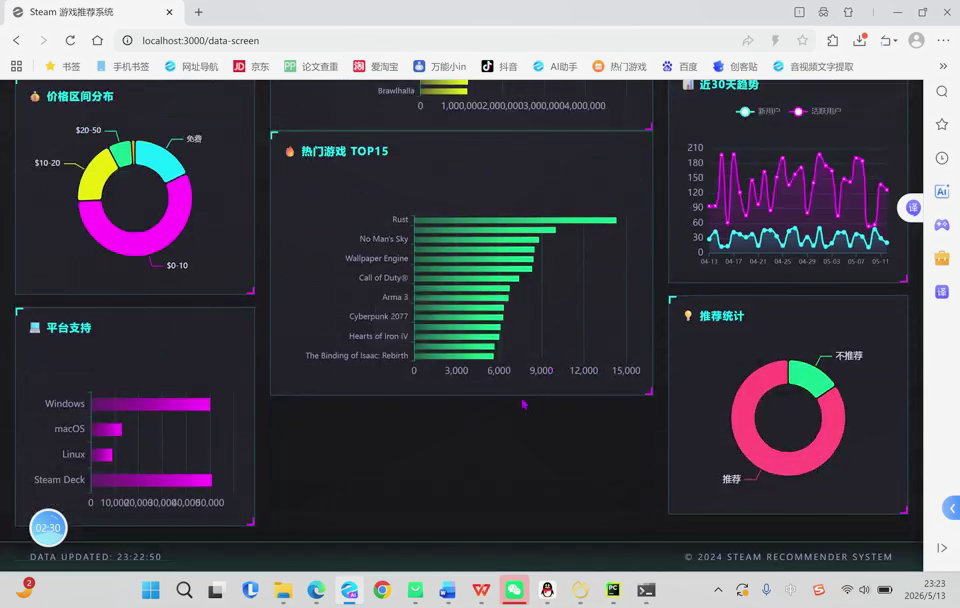
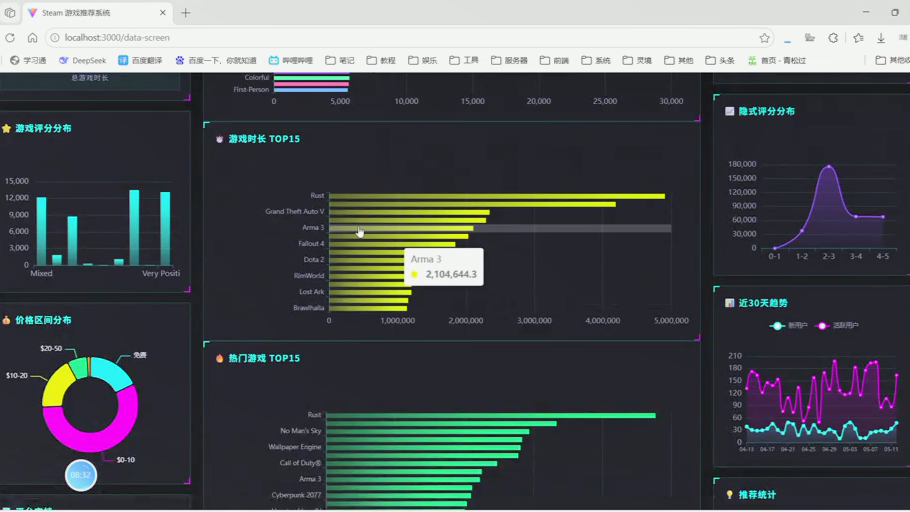
辅助商业决策:通过对游戏评分分布、热门标签趋势、价格-销量关系等进行可视化分析,为游戏开发者提供市场洞察,为平台方的运营策略、促销活动提供数据支持。
毕业设计综合训练价值:本课题涵盖了前端开发(可视化界面)、后端逻辑、大数据处理(Hadoop)、推荐算法、数据库设计等多个计算机核心知识领域,能够全面锻炼学生系统分析、设计、实现与优化的综合工程能力,符合高水平本科毕业设计的要求。
二、 国内外研究动态
1. 国外研究动态
推荐系统研究在国外起步较早,Netflix、Amazon、Spotify等公司已将其作为核心业务组件。
算法层面:从早期的协同过滤(UserCF, ItemCF)到矩阵分解(如SVD++),再到近年与深度学习结合的神经协同过滤(NCF)、基于图神经网络的推荐等,研究不断深入。在游戏推荐领域,Valve公司自身也在Steam平台应用了基于协同过滤的推荐引擎,但具体细节未公开。
技术架构:以Apache Spark、Flink为代表的流处理框架与以TensorFlow、PyTorch为代表的机器学习框架已成为构建大规模推荐系统的工业标准。Hadoop MapReduce虽在实时性上不占优,但在海量历史数据的批处理与特征生成方面仍具稳定性优势。
研究焦点:当前研究更侧重于解决可解释性、公平性、跨域推荐以及利用多模态数据(如文本描述、封面图像)进行内容理解。
2. 国内研究动态
国内推荐系统研究与应用同样活跃,在电商(阿里、京东)、短视频(字节跳动)、音乐(网易云)等领域成果显著。
应用实践:国内各大游戏平台(如WeGame)及社区(如“小黑盒”)均已部署了各自的推荐模块,多采用融合用户社交关系、实时行为的热度加权和协同过滤混合策略。
学术研究:国内高校及研究机构在结合知识图谱增强推荐、基于强化学习的序列推荐等方面有不少创新。针对游戏数据,有研究开始关注利用玩家游玩时长、成就解锁深度等强信号,而不仅仅是评分或购买行为。
现状总结:目前,完全开源、集成了完整数据处理流水线、混合推荐算法以及丰富可视化前端的Steam游戏推荐系统案例较少。多数研究侧重于单一算法改进或后端分析,缺乏一个从数据采集、分布式处理、算法融合到交互式可视化展示的端到端系统实现。
三、 初步设想与创新点
1. 初步设想
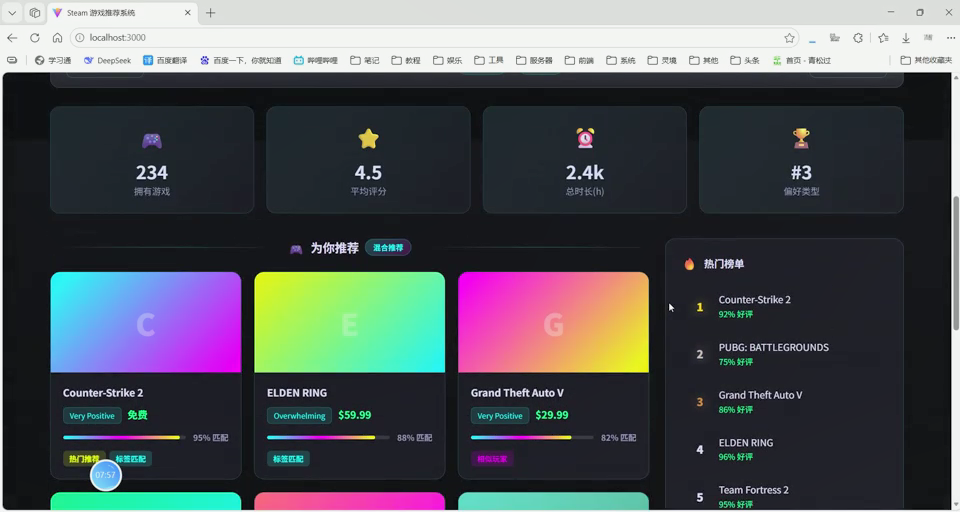
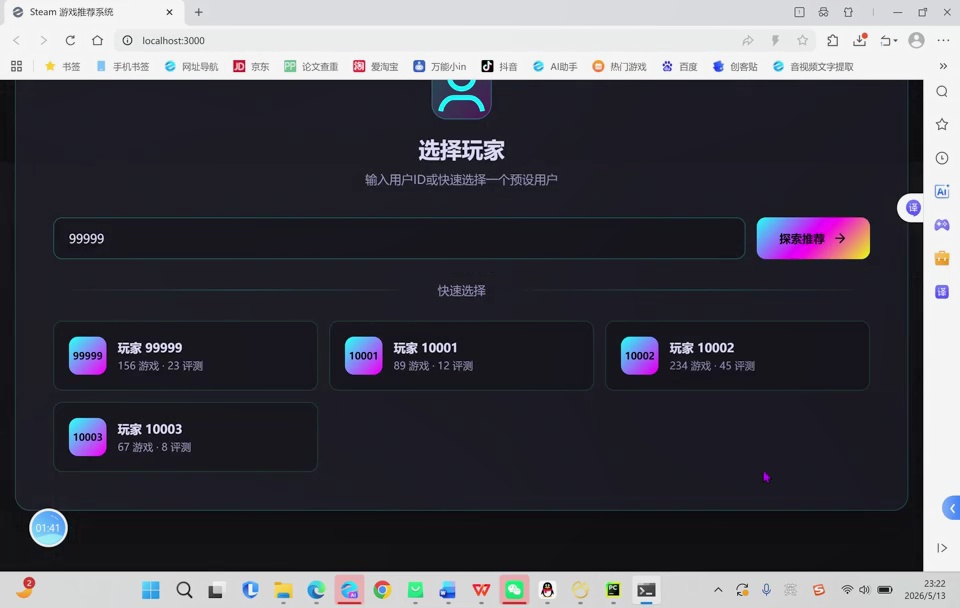
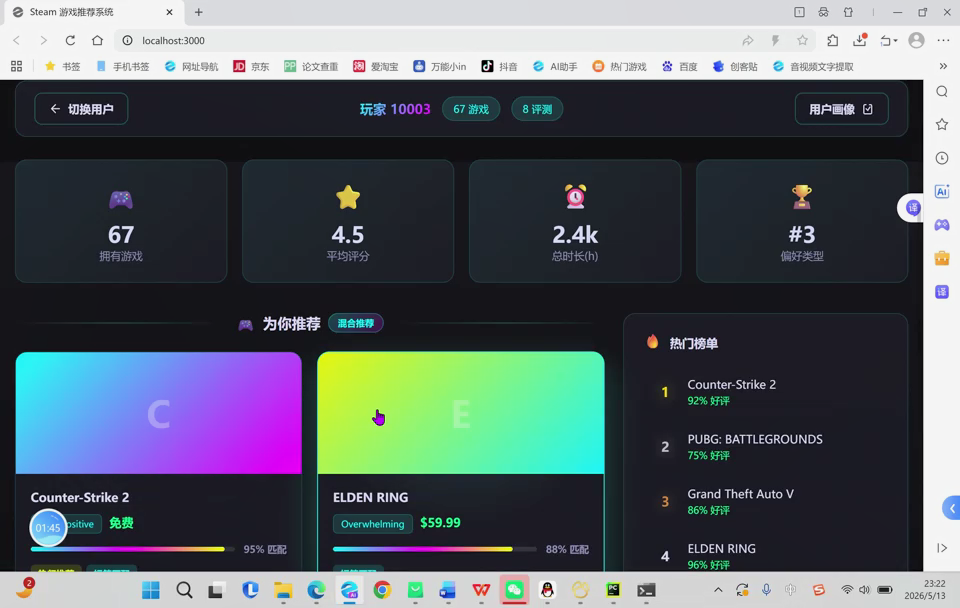
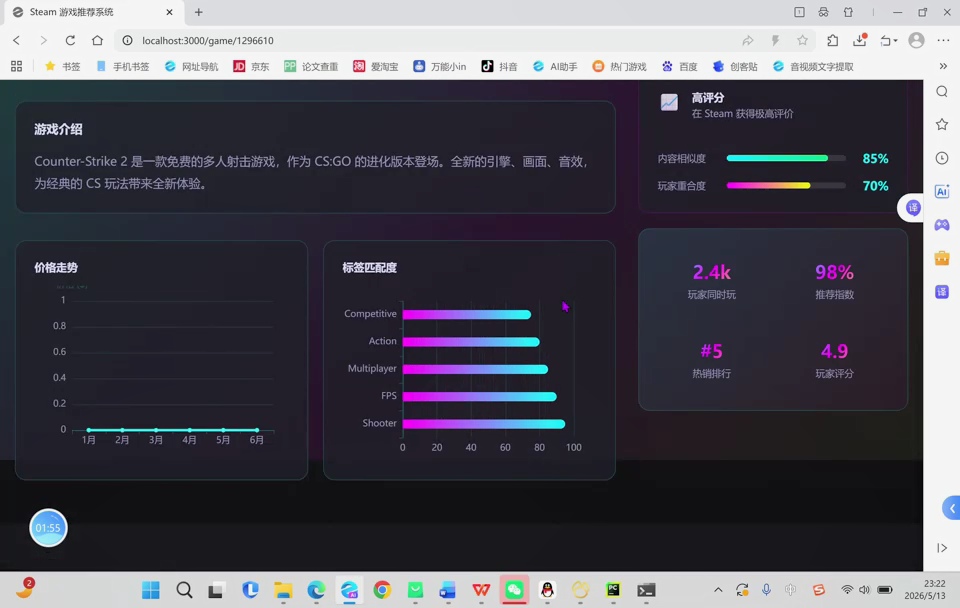
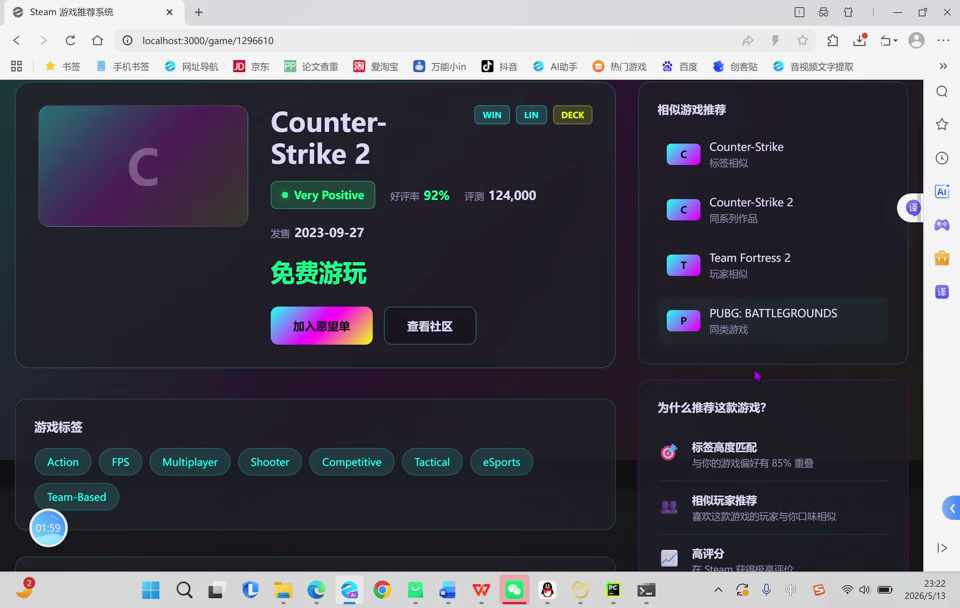
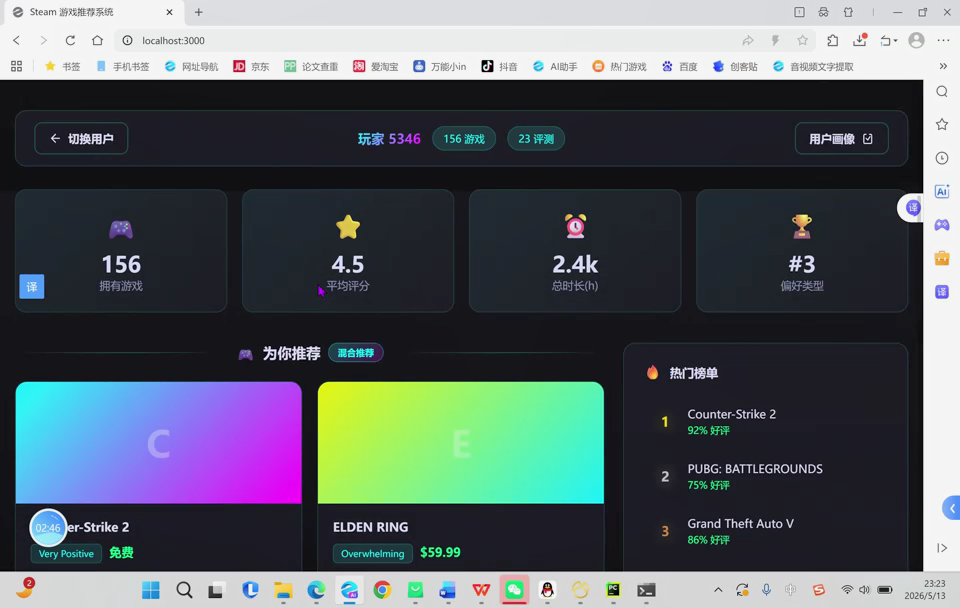
本项目拟设计并实现一个B/S架构的、端到端的Steam游戏混合推荐系统原型,构建一个集游戏发现、个性化推荐、社区互动与数据分析于一体的综合平台。系统采用分层架构,涵盖以下核心层次与模块: 前台用户端模块: 首页聚合模块: 集成个性化推荐流、热门游戏榜、新游上线、限时促销、编辑精选等多维度推荐入口。 游戏浏览与搜索模块: 支持多维度筛选(类型/标签/价格/评分)、高级搜索(语义搜索、标签组合),提供游戏详情页(含相似推荐、玩家评测)。 资讯与社区模块: 聚合游戏新闻、更新公告、玩家动态墙、攻略/视频内容,增强用户粘性与社区互动。 个人中心模块: 提供我的游戏库、愿望单与收藏、游戏记录与统计分析、好友与社区互动、偏好设置等功能。 价格智能模块: 实现价格走势可视化、折扣预测提醒、性价比评分,辅助用户消费决策。 后台管理端模块: 用户与游戏信息管理: 支持用户信息、游戏数据的增删改查与批量导入。 推荐策略管理模块: 提供算法权重配置、冷启动策略调整、A/B测试管理界面。 反馈分析与系统监控: 可视化展示用户反馈统计、推荐效果评估报表、系统性能监控与日志审计。 数据导出与备份: 支持结构化数据导出与系统备份恢复功能。 核心推荐引擎模块: 数据采集与预处理模块: 整合Steam公开数据集(games.csv、recommendations.csv、users.csv),进行清洗、去重、格式化。 用户画像构建与更新模块: 基于用户行为(点击、购买、评分、游戏时长)动态构建并更新用户兴趣画像。
多算法推荐模块: 实现协同过滤(UserCF/ItemCF)、内容推荐(基于标签/类型/描述)、热门推荐等多种算法。 混合推荐策略模块: 设计加权融合与动态切换策略,结合用户场景(新/老用户、活跃度)自适应选择推荐策略。 推荐结果解释生成模块: 为每条推荐结果生成可理解的推荐理由(如标签匹配度、相似用户行为)。 反馈闭环优化模块: 收集用户显式(点赞/踩)与隐式(点击时长、跳出率)反馈,用于持续优化推荐模型。
2. 主要创新点
“大数据处理 + 混合推荐 + 可视化 + 闭环优化”的全流程集成:不同于单一的算法研究,本设计强调构建一个完整的、可演示的系统原型,将Hadoop批处理、混合推荐模型、交互式可视化前端与反馈闭环机制无缝结合,展示从原始数据到用户可感知推荐结果的全过程。
面向游戏领域的混合推荐策略针对性设计:在混合策略中,除常规算法外,计划引入“游戏标签权重衰减”机制(区分核心玩法标签与题材标签),并探索将“玩家平均时长”、“成就解锁深度”作为重要权重因子纳入推荐考量,使推荐更贴合游戏消费特点。
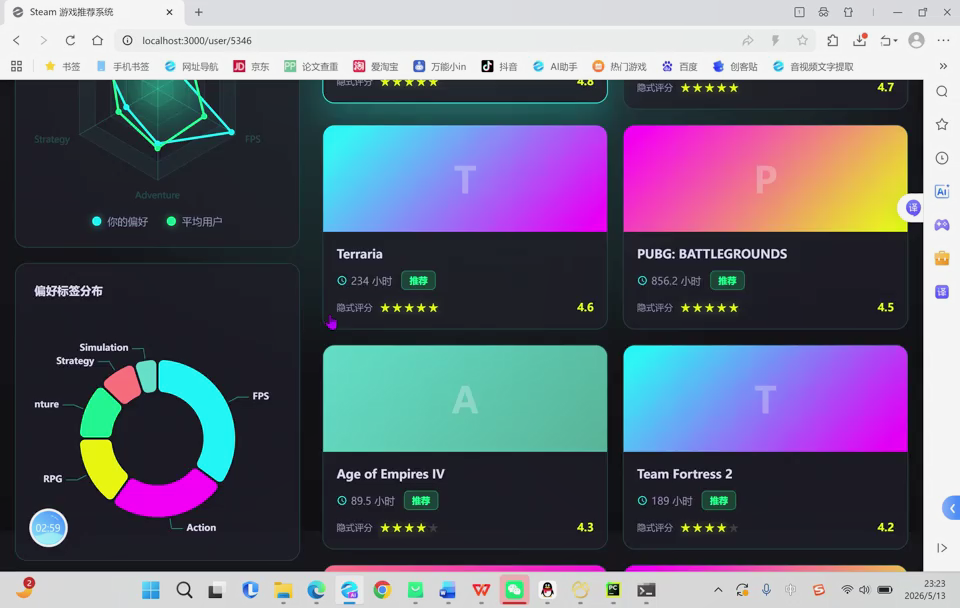
增强的可解释性、社交互动与消费决策支持:系统不仅给出推荐列表,还通过可视化图表(如雷达图展示游戏标签匹配度)直观展示“推荐理由”。同时,融入社区动态、价格智能、个人游戏库管理等模块,构建一个支持用户社交互动与理性消费决策的综合游戏发现平台。
四、 可行性论述
1. 技术可行性
数据获取:Steam提供了公开的Web API和丰富的社区数据,Kaggle等平台也有相关数据集,为项目提供了可靠的数据来源。
核心技术:Hadoop(HDFS, MapReduce)、推荐算法(协同过滤、内容过滤)、Web开发(Vue/React + Flask/Spring Boot)、数据库(MySQL/MongoDB)等技术均为成熟的工业级技术,有大量开源文档、教程和社区支持。Python的Scikit-learn、Surprise等库简化了推荐算法的实现。
开发工具:IDEA、VS Code等集成开发环境,以及Docker等容器化技术,便于环境搭建与部署。
2. 硬件与资源可行性
项目开发阶段可在本地机器或实验室服务器上进行。Hadoop集群可以部署在少量节点(如3-5台)甚至使用单机伪分布式模式进行学习和开发,足以处理百万级规模的数据集。云服务器(如阿里云ECS)也可作为备选部署方案。
3. 理论可行性
协同过滤和内容推荐是推荐系统的基础且经典的理论,相关数学模型和算法流程清晰明确。混合推荐策略是业界公认的提升推荐效果的有效途径,有充分的文献和案例支持。用户画像构建、闭环优化机制在推荐系统领域也有成熟的理论框架。
4. 人员与时间可行性
本课题作为毕业设计,时间跨度约6个月,计划安排合理,有充足的阶段进行学习、设计、开发、测试与文档撰写。课题所需技能与计算机专业本科课程(数据结构、数据库、Web开发、机器学习基础等)衔接紧密,学生通过自主学习与导师指导可以掌握。
结论: 综上所述,本课题“基于大数据的游戏推荐系统的设计与实现”立足实际应用需求,紧跟技术发展趋势,具有明确的理论与实践价值,且在技术、资源、时间上均具备充分的可行性。
研究内容、方法及技术路线
(一) 研究内容
本项目以构建端到端的Steam游戏混合推荐系统为目标,聚焦以下核心内容:
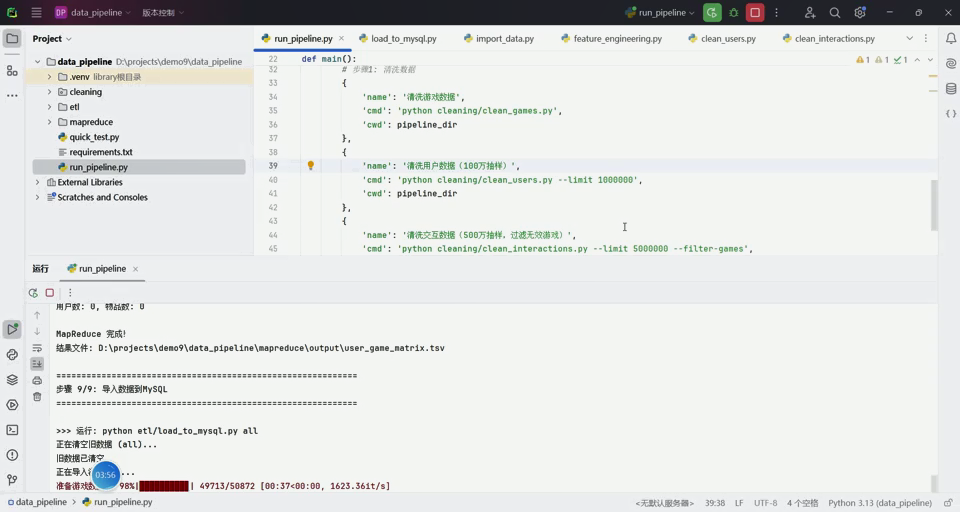
1. 数据工程与特征处理: 基于Hadoop MapReduce实现分布式数据清洗、标签热度统计、用户-游戏交互矩阵构建、用户行为模式分析(如活跃时段、偏好类型、游戏时长分布)。 2. 用户画像构建与动态更新机制: 设计并实现基于多源行为数据(浏览、点击、购买、评分、时长)的用户兴趣模型,支持实时与定时更新。 3. 混合推荐模型设计与实现: 实现协同过滤(UserCF/ItemCF)与内容推荐算法,重点设计针对游戏领域的混合策略(加权融合、分层融合、场景自适应切换),并探索引入“标签权重衰减”、“游玩时长权重”、“价格敏感度”等游戏特有因子。 4. 系统功能模块完整实现: 完成前台首页聚合、游戏浏览搜索、资讯社区、个人中心、价格智能等模块的开发,以及后台管理、系统监控等支撑功能。 5. 可视化、可解释性与交互设计: 开发前端可视化大屏(评分分布、价格-销量关系、用户行为热力图等),为推荐结果生成可视化解释(如标签匹配雷达图),并设计友好的用户交互流程。 6. 推荐系统闭环优化与评估: 设计用户反馈收集机制,实现基于反馈的模型迭代优化。通过离线指标(准确率、召回率、F1值)与在线模拟反馈(点击率、转化率、停留时长)进行综合评估。
(二) 研究方法
文献研究法:梳理推荐系统、大数据处理及可视化的前沿理论与技术。
原型开发法:采用敏捷开发模式,迭代构建系统核心模块。
对比实验法:通过控制变量实验,验证不同算法及混合策略的性能优劣。
系统评估法:结合定量指标与定性分析,全面评价推荐效果与系统可用性。
(三) 技术路线
系统技术架构采用经典的分层设计,自底向上逐步实施: 1. 数据采集与存储层: 使用Python(Scrapy/Requests)采集Steam公开数据,或直接使用Kaggle等平台的现有数据集。 利用Pandas进行初步数据清洗与格式化。 将清洗后的结构化数据存储于MySQL关系型数据库,用于业务查询;将原始日志与大规模中间数据存储于HDFS。 2. 大数据处理与特征工程层: 部署Hadoop集群(HDFS + MapReduce),编写MapReduce程序进行分布式特征提取,如游戏标签词频统计、用户-游戏评分矩阵计算、用户行为序列分析等。 3. 推荐算法与模型层: 使用Python(Surprise/Scikit-learn)库实现协同过滤与内容推荐基础算法。 使用Java/Python编写混合推荐策略控制器,实现算法融合与场景判断逻辑。 实现用户画像建模与更新模块。 4. 服务与应用层: 采用Spring Boot(Java)或Flask/Django(Python)框架构建后端RESTful API服务,提供用户认证、游戏查询、推荐请求、反馈提交等接口。 设计并实现后台管理功能,提供数据管理与系统配置界面。 5. 展示与交互层: 采用Vue.js或React框架构建响应式前端单页应用(SPA)。 集成ECharts、AntV等可视化库,实现数据大屏与推荐结果的可视化解释。 设计并实现完整的用户交互界面,包括首页、搜索页、个人中心、资讯社区等。
关键实施流程: 数据采集 → HDFS存储 → MapReduce特征工程 → 模型训练与评估 → 后端API封装 → 前端界面调用与展示 → 用户反馈收集 → 模型迭代优化。
计
划
进
度
及
其
内
容
2025.12.20~2025.12.25:与导师联系了解设计内容及相关材料,完成开题报告;
2025.12.26~2026.03.04:了解系统设计内容的发展现状,学习系统开发工具及相关知识;
2026.03.05~2026.04.01:系统总体功能框架设计及系统详细设计的准备;
2026.04.01~2026.05.10:系统总体功能实现,并进行数据实验,初步完成调试;
2026.05.11~2026.05.26:系统进一步调试,并完成设计说明书编写工作;
2026.05.27~2026.06.10:设计说明书定稿打印。
写
作
提
纲
第1章 绪论
1.1 研究背景与意义 1.2 国内外研究现状 1.3 研究内容与目标 1.4 论文结构安排
第2章 相关技术与理论基础
2.1 推荐系统概述 2.2 协同过滤算法 2.3 内容推荐算法 2.4 大数据处理技术 2.5 数据可视化与前端开发技术
第3章 系统需求分析与设计
3.1 需求分析 3.2 系统总体架构设计 3.3 系统功能模块设计 3.4 数据库设计
第4章 数据处理与特征工程实现
4.1 数据采集与预处理 4.2 基于Hadoop MapReduce的分布式特征提取 4.3 用户画像构建与更新实现
第5章 混合推荐算法实现
5.1 协同过滤算法实现与优化 5.2 内容推荐算法实现与优化 5.3 面向游戏领域的混合推荐策略设计 5.4 推荐结果可解释性生成
第6章 系统实现与集成
6.1 后端服务实现(API设计、业务逻辑) 6.2 前端界面与可视化模块实现 6.3 前后端系统集成与调试
6.4 后台管理功能实现
第7章 总结与展望
7.1 工作总结 7.2 不足与展望