
前言
最近有球友去高德地图面试,面试官问:线上慢SQL问题导致CPU飙升,如何处理?
这就是典型的慢SQL拖垮整个应用的案例。
今天,我就带大家从排查、分析到优化,完整走一遍线上慢SQL导致CPU飙升的实战处理流程。
希望对你会有所帮助。
最近想快速提升项目实战能力(包含多个AI项目),或者最近找工作的小伙伴,可以看看下面 的这个链接(或许真的能够帮到你):http://susan.net.cn/project
一、如何快速定位问题?
当你发现应用或数据库CPU飙升时,不要慌,按以下步骤快速锁定元凶。
1.1 确认数据库层面的CPU消耗
登录数据库服务器,使用top或htop查看MySQL进程的CPU占用率。
如果mysqld的CPU超过100%(多核),基本可以确定是数据库内部有消耗大的操作。
接着,进入MySQL命令行,执行:
SHOW PROCESSLIST;重点关注Time(执行时间)和State(状态)列。如果出现大量Sending data、Copying to tmp table、Sorting result等状态的会话,且执行时间很长,大概率就是慢SQL。
还可以开启慢查询日志(如果没开的话):
SET GLOBAL slow_query_log = 1;
SET GLOBAL long_query_time = 1; -- 超过1秒记录然后通过mysqldumpslow工具分析慢日志:
pt-query-digest /var/log/mysql/slow.log # 或使用mysqldumpslow1.2 拿到具体的SQL
从SHOW PROCESSLIST中复制出问题SQL,或者从慢日志中提取。
例如:
SELECT o.id, o.amount, u.name, p.title
FROM orders o
LEFT JOIN users u ON o.user_id = u.id
LEFT JOIN products p ON o.product_id = p.id
WHERE o.status = 'PAID'
  AND o.create_time > '2026-01-01'
ORDER BY o.amount DESC
LIMIT 1000;最近想快速提升项目实战能力(包含多个AI项目),或者最近找工作的小伙伴,可以看看下面 的这个链接(或许真的能够帮到你):http://susan.net.cn/project
二、为什么会慢?
慢SQL导致CPU飙升的根本原因是:数据库需要耗费大量CPU资源去执行全表扫描、排序、创建临时表等操作。
2.1 执行计划分析
使用EXPLAIN查看SQL的执行计划:
EXPLAIN SELECT ...关键列:
type:ALL表示全表扫描(最差),range或ref表示用到索引。
rows:估算扫描行数,越大越慢。
Extra:Using filesort(文件排序)、Using temporary(临时表)都很耗CPU。
2.2 为什么全表扫描会飙高CPU?
MySQL要逐行读取数据页到内存,然后逐行过滤条件。
如果表很大(千万级),即使内存足够,也要扫描大量数据,CPU忙于解析和比较。
排序、分组等操作需要额外内存和CPU计算。
2.3 索引失效的常见场景
对索引列使用函数(WHERE DATE(create_time) = '2026-01-01')
隐式类型转换(WHERE user_id = '123',但user_id是数值类型)
使用!=或<>
LIKE '%abc'(前缀模糊匹配)
OR 条件中有非索引列
三、紧急处理措施(止血)
在找到根本原因之前,先要让系统恢复可用,避免故障扩大。
3.1 杀掉慢查询
SHOW PROCESSLIST;
-- 找到Id列和执行时间长的会话,执行:
KILL <Id>;可以写脚本定时kill超过某阈值的SQL。
3.2 临时限流
在应用层对可疑接口进行限流,例如使用Sentinel或Hystrix降低该接口的并发。
3.3 重启数据库? 不推荐
重启会清空buffer pool,可能导致启动后更慢。除非无法连接。
最近想快速提升项目实战能力(包含多个AI项目),或者最近找工作的小伙伴,可以看看下面 的这个链接(或许真的能够帮到你):http://susan.net.cn/project
四、根治手段:优化SQL与索引
4.1 添加合适的索引
针对上述例子,我们分析:
WHERE o.status = 'PAID' AND o.create_time > '2026-01-01',可以考虑联合索引(status, create_time)。
排序字段amount,看能否加到索引中避免filesort。
优化后:
ALTER TABLE orders ADD INDEX idx_status_time_amount (status, create_time, amount);再次EXPLAIN,type变成range,rows大幅减少,Extra不再有Using filesort。
4.2 改写SQL
避免SELECT *,只取必要字段。
将LEFT JOIN改为INNER JOIN如果业务允许(可提前过滤掉空数据)。
使用子查询或临时表减少关联数据量。
4.3 拆分复杂查询
把一条多表JOIN拆成多条简单查询,在应用层组装(适合数据量不是特别大的场景)。
五、实战案例
原始SQL(订单表500万,用户表200万,商品表100万):
SELECT o.order_no, u.phone, p.name, o.amount
FROM orders o
LEFT JOIN users u ON o.user_id = u.id
LEFT JOIN products p ON o.product_id = p.id
WHERE o.status = 1
  AND o.create_time BETWEEN '2026-04-01' AND '2026-04-30'
ORDER BY o.amount DESC
LIMIT 100;问题:
orders表只有单列索引status,导致只过滤了状态,但create_time没走索引,扫描了全部状态为1的历史订单。
ORDER BY amount引发文件排序。
优化方案:
创建联合索引:ALTER TABLE orders ADD INDEX idx_status_time_amount(status, create_time, amount);
改写SQL,将LEFT JOIN改为INNER JOIN(因为用户和商品一定有对应数据,且不要求展示空)。
分页优化:因为LIMIT 100,已经很好。
优化后执行计划:type=range,rows=2000,Extra中无Using filesort,查询时间从30秒下降到0.08秒。
效果:数据库CPU从85%降到15%,应用恢复正常。
最近想快速提升项目实战能力(包含多个AI项目),或者最近找工作的小伙伴,可以看看下面 的这个链接(或许真的能够帮到你):http://susan.net.cn/project
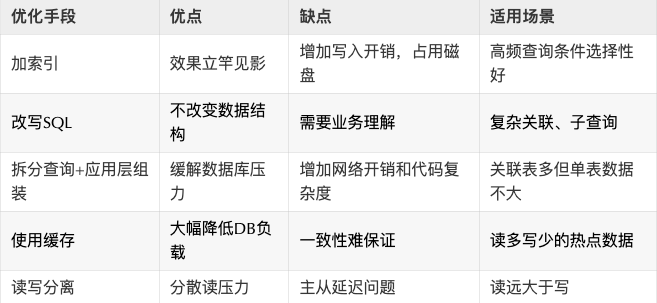
六、优缺点与适用场景
七、如何预防慢SQL导致CPU飙升?
建立SQL审核机制:上线前必须通过EXPLAIN review,禁止全表扫描语句上线。
开启慢查询监控:配置阈值(如1秒),并接入告警系统。
定期分析索引使用情况:删除未使用的索引,优化重复索引。
压测:大促前对核心查询进行压力测试,观察CPU拐点。
限流与降级:在API网关或业务层配置限流,防止突发流量冲击数据库。
全链路压测平台:提前发现潜在慢SQL。
八、总结
线上慢SQL导致CPU飙升,本质上是一个“数据库资源被低效查询耗尽”的问题。
处理的核心流程可以概括为:
定位慢SQL → EXPLAIN分析 → 索引优化/SQL改写 → 验证效果 → 建立事前预防机制
在实际工作中,80%的CPU飙升问题都可以通过加索引或简单改写SQL解决。
但更重要的是,我们要有敬畏之心——每一行SQL都可能成为生产事故的导火索。
建立规范的开发流程和强有力的监控体系,才是长久之计。
最近想快速提升项目实战能力(包含多个AI项目),或者最近找工作的小伙伴,可以看看下面 的这个链接(或许真的能够帮到你):http://susan.net.cn/project
