
有没有跟我一样,被 AI 生图折腾到没脾气的?
前两年不管用市面上哪个主流工具,玩 AI 生图都跟开盲盒没区别:明明提示词写得清清楚楚,要奶茶海报上的 slogan 是「春日青提乌龙 第二杯半价」,出来的字要么缺胳膊少腿,要么直接乱码成火星文;想画一套 4 格职场漫画,同个主角每张脸都不一样,连西装颜色都能给你随机换三遍;更别说想做个带细小标注的学习资料图、曲面上的品牌名,出来的东西根本没法用,最后还是得自己开 PS 吭哧吭哧改俩小时。
我一直跟身边玩 AI 的朋友说,AI 生图最大的痛点,从来不是「画得不够好看」,而是「不够听话」。你明确要的东西它给不了,你没提的乱七八糟的元素它瞎加,出图全靠运气堆次数,改个十遍八遍都未必能出一张能用的。
直到最近深度用了一段时间 GPT-Image2.0,我才真的有种感觉:AI 生图终于从「碰运气的玩具」,变成了「能正经干活的工具」。
核心逻辑变了:它为什么能让 AI 生图从 “拼运气” 变 “真听话”?
很多人可能会问,不就是个 AI 生图工具吗?凭什么它能做到别的工具做不到的事?
其实核心根本不是画风、分辨率这些表层的东西,而是底层的架构彻底换了。
之前市面上绝大多数 AI 生图工具,用的都是扩散模型。给大家打个大白话的比方:扩散模型就像一个刚学画画的新手,先在画布上糊一团乱七八糟的噪点,然后一点点擦、一点点修,试图从乱麻里 “擦” 出你要的画面。这个过程里,它很容易跑偏,尤其是文字、固定角色、精准布局这种细节,它根本顾不过来,经常是顾了画面好看,就丢了你要的核心信息。
而 GPT-Image2.0,直接用自回归架构取代了传统的扩散模型。这个架构,说白了就像一个有十几年经验的资深画师,拿着笔一笔一笔按你的要求画,从第一个元素到最后一个细节,全程都跟着你的指令走,每一步都在核对你的需求,根本不会出现 “画着画着就跑偏” 的情况。
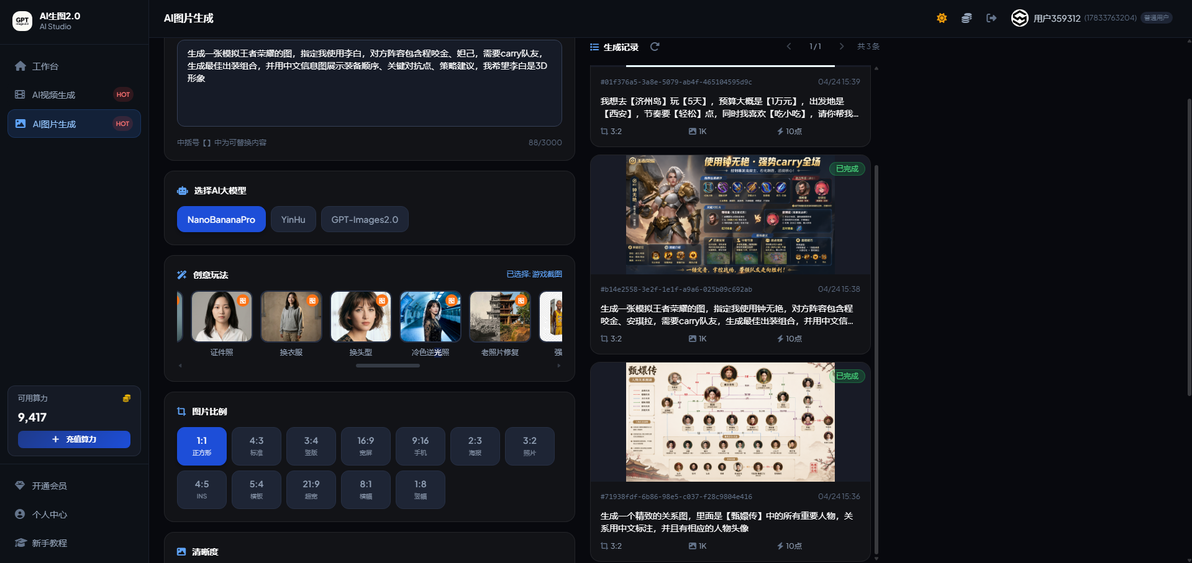
这也是为什么,它能真正解决 “AI 生图不听话” 的核心问题 —— 不是它画得更花哨了,而是它从根上就学会了 “先听懂,再动笔”。
实测下来,这几个功能,直接把 AI 生图的行业痛点给解决了
99%+ 文字渲染准确率:终于搞定了 AI 生图的 “文字乱码” 难题
玩 AI 生图的人都知道,文字渲染,一直是所有 AI 生图工具的老大难问题。
不管是之前多热门的工具,一碰到文字就拉胯:单独的中文还好,但凡中英文混排、细小字体、曲面上的文字,出来的东西大多都是乱码,要么是笔画不对,要么是凭空造字,甚至直接给你画一堆像字又不是字的符号。
我之前为了做一张带产品 slogan 的易拉罐海报,前前后后用不同工具渲染了二十多遍,要么瓶身上的字是歪的,要么直接乱码,最后还是自己在 PS 里重新贴的字,折腾了一下午。
而 GPT-Image2.0 最让我惊喜的第一点,就是它的文字渲染准确率能做到 99% 以上。
我自己做了好几轮实测:不管是海报上的大标题、角落的小字备注,还是中英文混排的品牌名,甚至是酒瓶、咖啡杯这种曲面上的环绕文字,它都能清清楚楚、准准确确地渲染出来,没有错字,没有乱码,连标点符号都不会出错。
就这一点,直接把之前 AI 生图只能 “画氛围感” 的局限给打破了,终于能正经用来做带文字的商用海报、产品包装、宣传物料了。
单次 8 张一致性输出:批量创作终于不用再 “凑素材” 了
除了文字乱码,第二个让所有创作者头疼的问题,就是 “一致性”。
不管你是画漫画分镜、做系列海报,还是电商的系列主图,都需要同一个角色、同一款道具、同一种风格,在多张图里保持统一。
之前的工具,为了做到这一点,你得锁种子、调参数、写一大堆限定提示词,折腾半天,出来的图还是能给你换个发型、变个衣服颜色,甚至连人物特征都能给你改了。一套 8 张的分镜,能凑出 2 张能用的就不错了,剩下的全靠后期硬修。
而 GPT-Image2.0,支持单次生成 8 张图片,而且能做到角色、道具、风格完全统一。
我自己测了一下,让它生成一套职场主题的漫画分镜,设定了主角是戴黑框眼镜、穿灰色西装的女生,办公室背景,8 张图里,主角的脸型、发型、衣服颜色,甚至眼镜的款式,完全一模一样,连背景的办公桌、文件柜的风格都全程统一,根本不用反复调整参数。
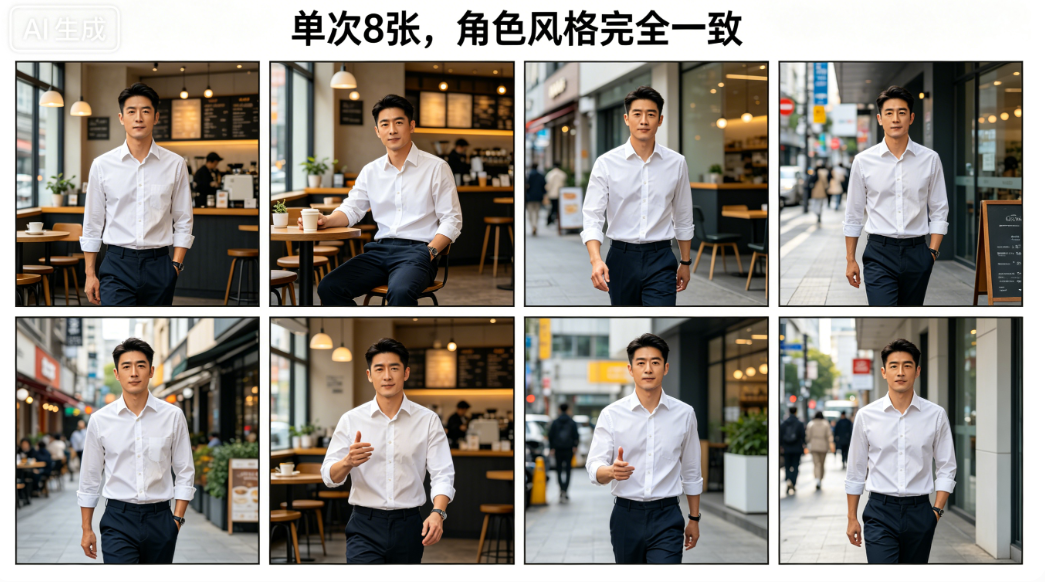
就这一个功能,对于做漫画、系列海报、短视频分镜的朋友来说,直接能省掉一大半的工作量,不用再为了统一风格,反复渲染几十遍了。
4K 分辨率 + 精准布局控制:商用级需求直接一步到位
还有很多朋友吐槽,之前的 AI 生图工具,出来的图只能发个朋友圈、社交媒体,根本没法商用。
要么是分辨率不够,一放大就糊,别说印刷喷绘,就连做个详情页大图都费劲;要么是布局根本没法控制,你要标题在顶部,它给你放中间,你要联系方式在右下角,它给你塞到左边,出来的图还要自己开 PS 重新排版,跟自己做一张没区别。
而 GPT-Image2.0 在这两点上,也做得足够到位。
首先是分辨率,最高能输出 4K 级别的高清图,不管是做海报印刷、画册排版,还是电商的高清主图、线下的喷绘物料,都完全够用,不用再找放大工具修复,一步到位。
其次是布局控制,它能精准听懂你对排版的要求,比如 “标题放在画面顶部居中,产品图放在画面中间,文案放在左侧,联系方式放在右下角”,它能严格按照你的要求排布每个元素的位置,不会乱加东西,也不会跑偏。
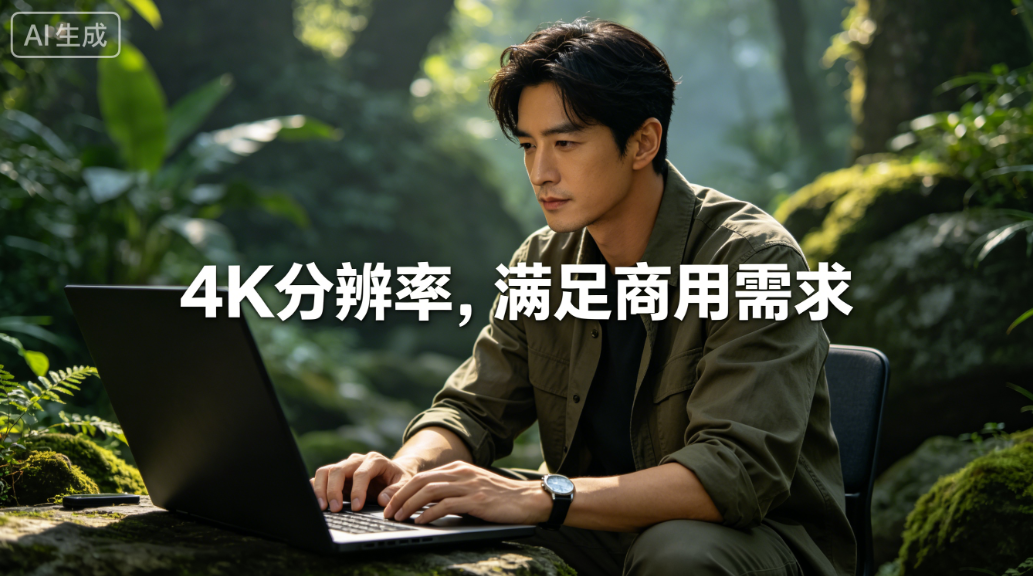
我用它做过一张培训班的招生海报,连每个文本框的位置、配图的大小,都完全按我给的要求来,出来的图基本不用后期修改,直接就能用。
效率提升 4-6 倍:普通人不用懂设计,设计师不用熬大夜
说到底,工具好不好用,最终还是要看能不能提效。
之前用传统的设计工具,或者老的 AI 生图工具,做一张符合要求的图,成本太高了:
普通人想做个活动海报、班级宣传图,得先学 PS、找模板、凑素材,折腾大半天都未必能做出一张像样的;设计师朋友就更不用说了,客户改个文字、换个布局,就要重新渲染、反复修改,经常为了一张图熬大夜。
而 GPT-Image2.0,把这个效率直接拉上来了。实测下来,做同一张符合商用要求的图,它比传统的设计工具、老款 AI 生图工具,效率能提升 4-6 倍。
普通人不用懂任何设计软件,不用懂配色、排版,只要把你的需求用大白话说清楚,几分钟就能出一张符合要求的专业图片;设计师朋友也不用再把时间浪费在反复渲染、修改细节、调整排版上,把基础的执行工作交给它,自己能把更多时间放在创意和构思上,不用再为了改图熬大夜。
国内想体验的朋友,不用折腾,这里就能直接上手
很多朋友看到这里可能会问,OpenAI 的工具,国内用起来不是很麻烦吗?要海外账号、要特殊的网络环境,门槛太高了。
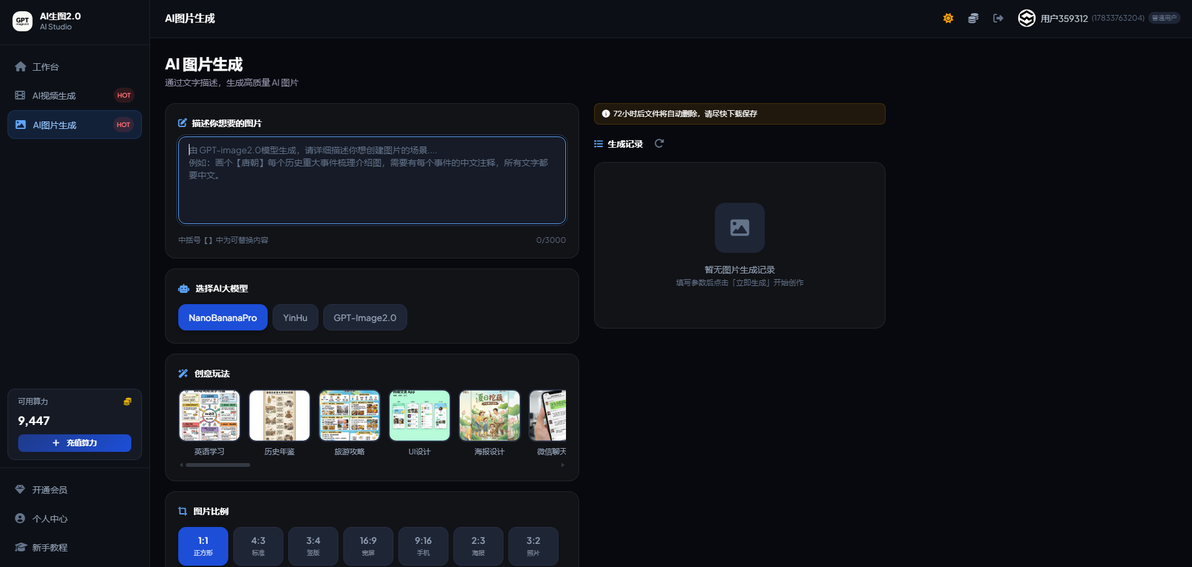
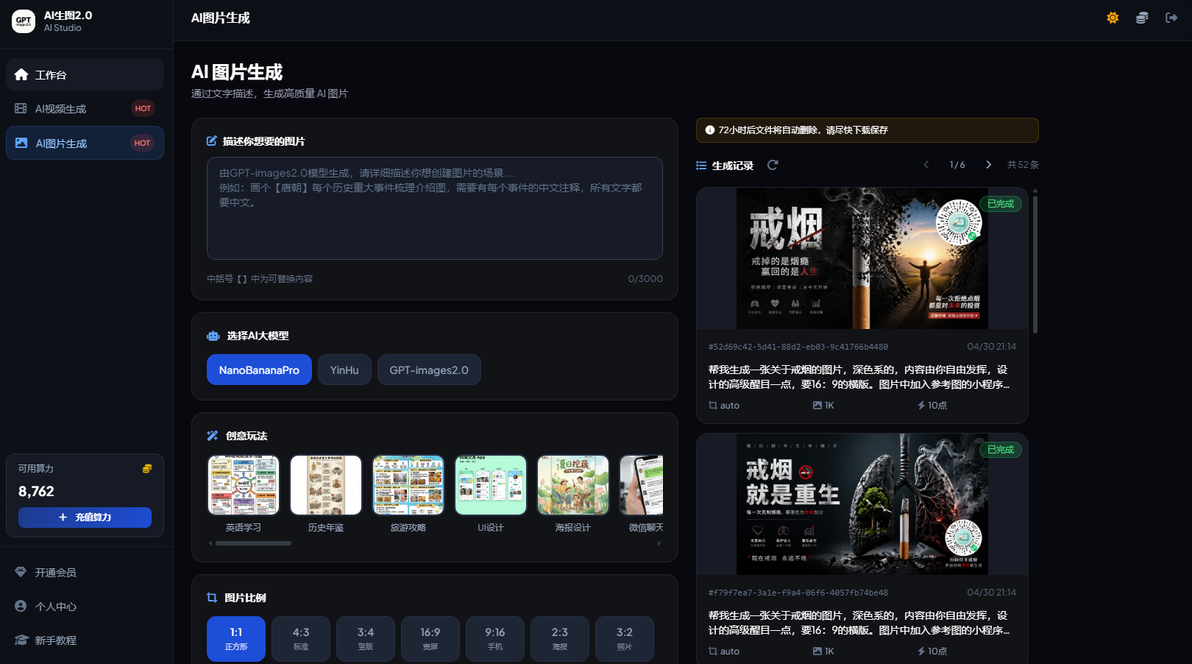
我自己最开始也折腾了半天,后来找了一圈,发现国内有个【AI 生图 2.0】公众号,里面已经接入了 GPT-Image2.0 的模型,不用折腾那些复杂的步骤,也不用准备海外账号和网络,直接就能体验到完整的功能。
我自己已经用了快半个月,里面的核心功能,包括高准确率的文字渲染、8 张一致性输出、4K 分辨率、精准布局控制这些,都和原版一致,上手很方便,不用看复杂的教程,输入你的需求就能出图。想上手试试的朋友,直接去微信搜索就能找到。
最后说句实在话:AI 生图的终局,从来不是 “画得好看”,而是 “听得懂话”
我玩 AI 生图到现在,也有三四年的时间了,从最开始的新鲜好奇,到后来的烦躁无奈,再到现在终于遇到一款能真正 “听话” 的工具,说实话,还是挺感慨的。
之前很长一段时间,整个 AI 生图行业都在卷 “画风多逼真”“风格多丰富”,卷谁能画出更炫的画面,却忽略了用户最核心的需求:我们要的不是一张 “好看但没用的图”,而是一张 “完全符合我需求的图”。
你要做海报,核心是文字准确、排版合规;你要做漫画,核心是角色统一、分镜清晰;你要做产品图,核心是产品还原、细节到位。这些最核心的需求,之前的工具都没解决,只会在画风上卷来卷去。
而 GPT-Image2.0 最核心的突破,从来不是它画得比别的工具好看多少,而是它真的把 “听懂指令” 这件事做到了极致。它让 AI 生图从 “你得适应它的规则”,变成了 “它来适配你的需求”;从 “碰运气开盲盒”,变成了 “指哪打哪,说啥是啥”。
不管你是完全没接触过设计的普通人,就是想做几张日常的配图、活动海报;还是靠设计吃饭的专业创作者,想提高效率、减少重复工作,它都能真正帮到你,而不是给你添堵。
技术的进步,从来都不是把东西做得越来越复杂,而是把复杂的事情变简单。AI 工具的意义,也从来不是取代谁,而是让更多人能轻松实现自己的想法,让专业的人能从重复的工作里解放出来。如果你也曾经被 AI 生图的乱码、不一致、反复修改折磨过,不妨试试这款工具,说不定会刷新你对 AI 生图的认知。
