
今天,我们来讨论一个非常关键且有趣的话题——记忆体。
你是否曾想过,如何让智能体像人一样,随着交互次数的增加而变得越来越聪明?在企业级应用中,用户往往期望智能体能够记住过往的对话历史、用户偏好或关键信息,从而实现更精准、个性化的服务。这一切,都离不开“记忆”。
一、什么是记忆?为什么它如此重要?
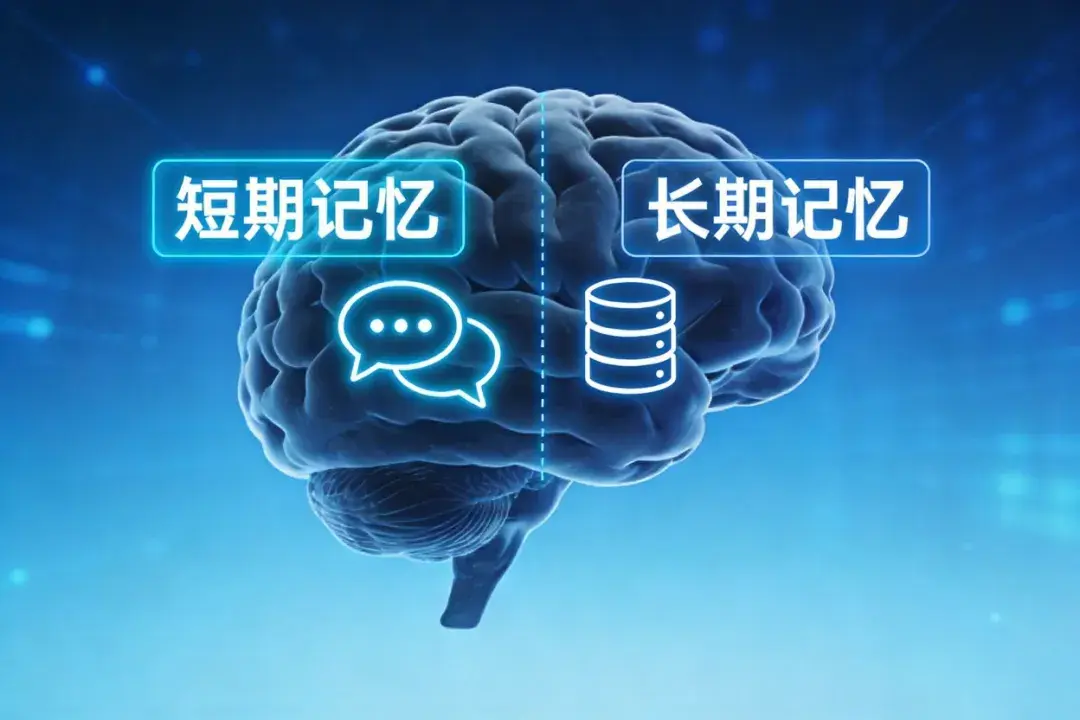
记忆是智能体变得“聪明”的核心机制之一。我们可以把记忆分为两大类:
·短期记忆:指的是在当前会话(或线程)内记住的信息。比如在一个对话中,你告诉智能体“我叫小明,在北京工作”,它会在本次对话中记住这些信息,并在后续回答中调用。
·长期记忆:指的是跨会话、跨线程的记忆能力。即使你开启新的对话,智能体依然能记住你之前告诉它的关键信息,比如你的身份、喜好或历史查询记录。
为什么需要这样区分?因为如果把所有聊天记录都一股脑塞给大模型,不仅低效,还可能超出模型的上下文限制。真正的智能记忆,是选择性地记住关键信息。
二、短期记忆:会话内的记忆管理
在LangChain和LangGraph中,实现短期记忆非常简单。我们可以使用 create_agent 配合 InMemorySaver 来存储当前会话的历史记录。下面是一个简单的示例:
pythonfrom langchain.agents import create_agentfrom langgraph.checkpoint import InMemorySaver # 创建智能体agent = create_agent( llm=llm, tools=[weather_tool], checkpoint=InMemorySaver()) # 用户对话config = {"thread_id": "user_001"}response = agent.invoke("你好,我叫小明,我在北京工作。", config)response = agent.invoke("帮我查一下所在城市的天气。", config)三、长期记忆:跨会话的智能记忆
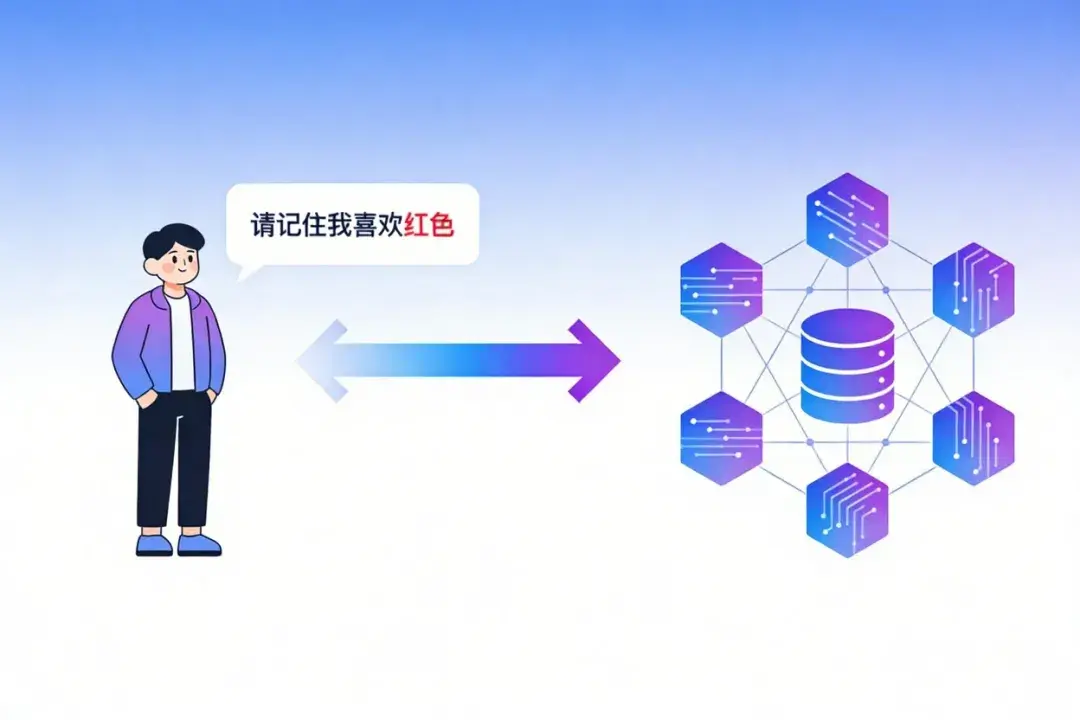
长期记忆的实现更为复杂,也更为强大。它不仅仅是存储所有历史记录,而是有选择地存储关键信息,比如用户明确说“请记住我是……”这样的内容。
在LangGraph中,我们可以使用 PostgresStore 或其他向量数据库来实现长期记忆。系统会在对话中识别出需要长期保存的信息(例如带有“记住”“喜欢”“我是”等关键词的句子),并将其存入向量数据库中。下次用户再次对话时,系统会先从数据库中检索相关记忆,再结合当前上下文生成回答。
这样,智能体就能够实现跨会话的记忆延续,真正成为一个“越用越聪明”的助手。
四、实战:从内存存储到持久化存储
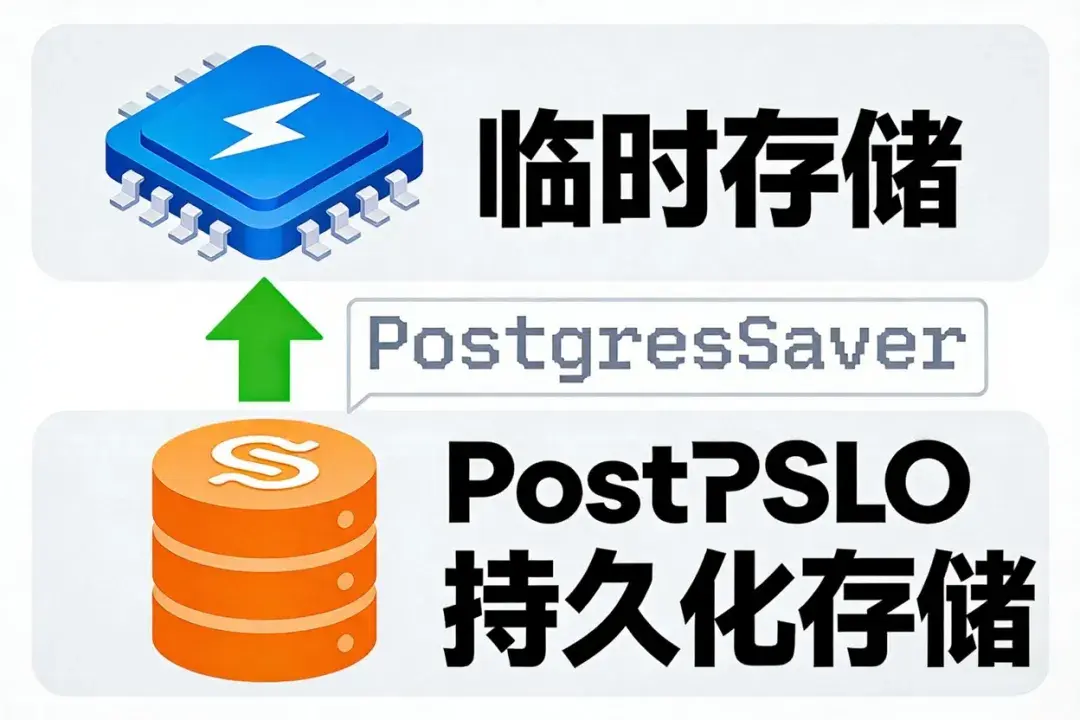
在实际生产环境中,我们通常需要将记忆持久化存储,以便服务重启后依然能保留记忆。LangGraph支持多种存储后端,例如 PostgreSQL、MySQL 等,你甚至可以根据自己的需求进行二次开发。
以下是一个使用 PostgreSQL 作为记忆存储后端的示例:
pythonfrom langgraph.checkpoint import PostgresSaver checkpointer = PostgresSaver.from_conn_string("postgresql://user:pass@localhost/langgraph_db")agent = create_agent(llm=llm, tools=[tool], checkpoint=checkpointer)这样一来,所有的对话记忆都会被保存到数据库中,即使服务重启,记忆也不会丢失
写在最后:记忆,是智能体从「工具」走向「伙伴」的核心
从会话内即时响应的短期记忆,到跨场景持久留存的长期记忆,我们搭建起了智能体「学习与成长」的底层逻辑。
短期记忆让交互更连贯,解决当下对话的上下文衔接;长期记忆让服务更懂人,实现跨会话的个性化延续;而持久化存储,则让这份「智慧」真正落地企业级场景,稳定、可靠、永不丢失。
本质上,给智能体赋予记忆,不是简单地存储对话,而是让它从「被动应答的程序」,变成「越用越贴心、越交互越精准」的智能伙伴。这正是企业级智能体实现个性化服务、持续迭代优化的关键 ——有记忆,才会成长;会成长,才够智能。
未来,随着记忆机制的不断优化,智能体将真正读懂用户、沉淀经验,成为业务与服务中不可或缺的「专属智囊」。
