
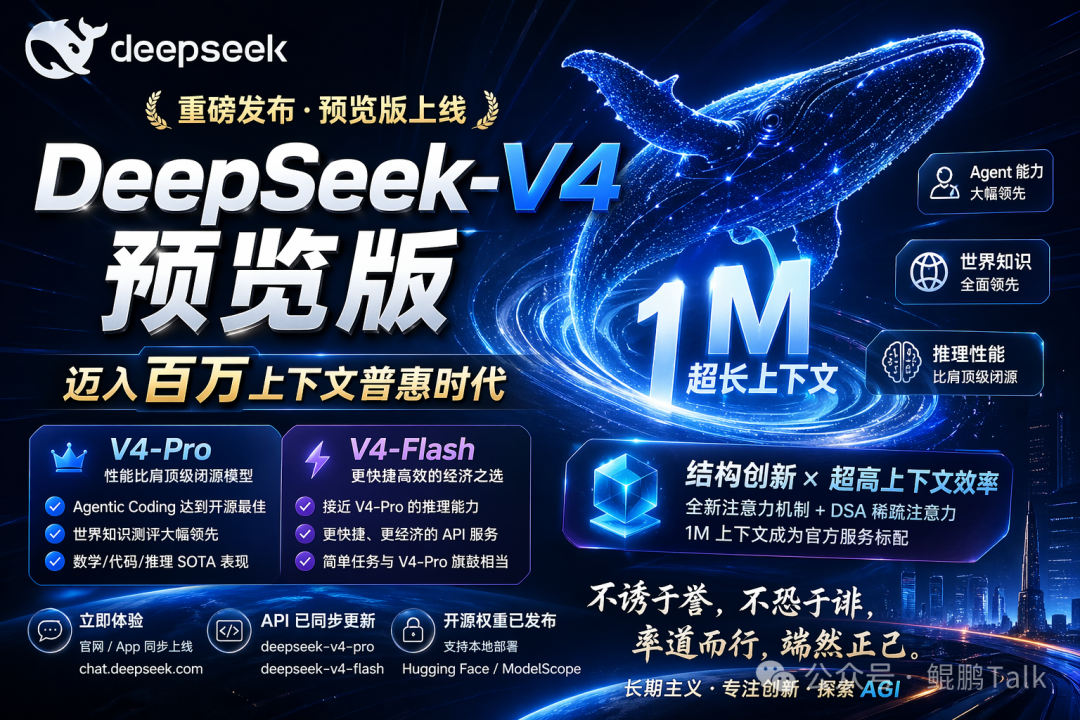
不诱于誉,不恐于诽,率道而行,端然正己。DeepSeek-V4以1.6万亿参数、百万Token上下文、MIT开源许可震撼发布。本文深度解析其MoE+Engram架构创新、混合注意力机制、性能实测数据、颠覆性定价策略,以及国产算力适配的战略意义。
一、一个反直觉的数字:1.6万亿参数,推理成本却只有上代的27%
2026年4月23日,中国AI公司DeepSeek(深度求索)悄然发布了其最新旗舰模型系列——DeepSeek-V4。
没有盛大的发布会,没有铺天盖地的公关稿,只是在官网、App和API端上线了一个Preview(预览版)。但就是这个"低调"的发布,却在全球AI社区引发了地震般的反响。
为什么?
因为DeepSeek-V4交出了一组让所有人瞠目结舌的数字:
1.6万亿总参数,单次推理仅激活490亿参数。
百万Token上下文窗口,KV缓存占用却只有上代V3.2的10%。
单Token推理计算成本,降至V3.2的27%。
这意味着什么?
意味着你可以用不到上一代三分之一的成本,处理八倍长的文本。意味着"百万Token上下文"从一个昂贵的技术演示,变成了可以日常调用的基础能力。意味着中国AI公司,正在用架构创新而非单纯堆参数,重新定义大模型的"性价比"游戏规则。
这不是参数竞赛,而是一场效率革命。
二、DeepSeek-V4全景:双版本策略与核心规格
在深入技术细节之前,让我们先厘清DeepSeek-V4的基本面貌。
2.1 两个版本,两种定位
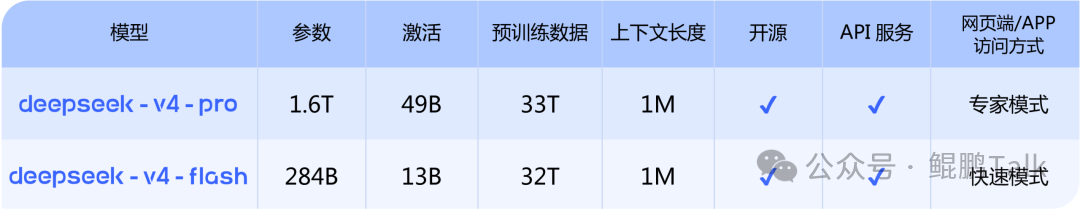
DeepSeek-V4采用了典型的"双模型策略",提供两个主要变体:
DeepSeek-V4-Pro(旗舰版):
• 总参数:1.6T(1.6万亿)
• 活跃参数(per token):约49B
• 预训练token量:约33T
• 定位:高强度推理、复杂代码、Agent任务、长文本处理
DeepSeek-V4-Flash(轻量版):
• 总参数:284B
• 活跃参数(per token):约13B
• 预训练token量:约32T
• 定位:高速响应、高性价比、日常高频调用
这种"一大一小"的组合,覆盖了从企业级复杂任务到个人日常使用的全场景需求。Pro版负责"攻山头"——在最难的基准测试上挑战闭源巨头;Flash版负责"打天下"——用极致性价比抢占市场份额。
2.2 共同特性:不只是"更大"
两个版本共享一系列关键特性,这些特性共同构成了V4的竞争力:
百万Token上下文窗口(1M tokens)
这是V4最醒目的标签。100万token相当于可以一次性处理《三体》三部曲的全文,然后回答关于书中任何细节的问题。对于法律文档分析、大型代码库理解、知识库问答等企业级场景,这是质变级别的能力。
最大输出可达384K tokens
不仅能"读"长文,还能"写"长文。这意味着V4可以生成完整的技术文档、长篇报告、甚至中篇小说,而不会出现中途"失忆"或逻辑断裂。
原生多模态支持
V4支持文本+图像/视觉输入,部分报道还提及视频理解能力。这标志着DeepSeek从"纯文本模型"向"原生多模态模型"的关键过渡。
MIT开源许可
权重完全开源,可私有化部署。这与GPT-4o、Claude等闭源模型形成鲜明对比,为全球开发者提供了"可控、可定制、可审计"的替代方案。
兼容OpenAI接口格式
API完全兼容OpenAI的调用格式,开发者可以零成本迁移。这种"无缝替换"策略,极大地降低了采用门槛。
深度优化华为Ascend等国产芯片
这是V4最具战略意义的特性之一。DeepSeek明确强调对华为昇腾等国产芯片的深度优化,减少对NVIDIA的依赖。在当前地缘政治背景下,这不仅是技术选择,更是生态自主的战略布局。
三、架构革命:MoE+Engram如何重构大模型效率
V4的效率奇迹,根源在于其底层架构的三重创新:MoE(混合专家)、Engram条件记忆架构,以及一系列工程优化。
3.1 MoE:1.6万亿参数的"精打细算"
DeepSeek-V4采用Mixture-of-Experts(MoE,混合专家)架构。简单来说,MoE就像一家大型咨询公司——公司有1.6万个"专家"(参数),但处理每个具体问题时,只会召集其中最相关的490个"专家"开会(激活参数)。
这种"按需激活"的机制,带来了两个直接好处:
第一,计算成本大幅下降。
虽然总参数高达1.6万亿,但每次推理只用到3%左右的参数。这意味着同样的计算资源,可以支撑更大规模的模型。
第二,专业化程度提升。
不同的"专家"可以专攻不同领域——有的擅长数学推理,有的擅长代码生成,有的擅长中文写作。当模型遇到特定任务时,自动调用最擅长的"专家"组合,效果自然更好。
但MoE并非新鲜事物。V4的真正突破,在于解决了MoE架构的两大顽疾:长上下文效率和记忆连续性。
3.2 Engram条件记忆架构:让AI"越用越懂你"
传统大模型有一个致命弱点:上下文遗忘。
当你和模型对话超过一定长度(比如128K token),早期的信息就会逐渐"模糊"。模型仿佛得了"短期记忆丧失症",忘记了你之前说过什么。这在百万Token级别尤为严重——前面90万字的内容,对最后10万字几乎没有任何影响。
DeepSeek-V4的解决方案是Engram条件记忆架构(或称条件存储/长期记忆)。
这个架构的核心思想是:将静态知识记忆与动态逻辑计算分离。
具体来说,Engram架构会把对话历史中的关键信息,以"记忆碎片"的形式存储下来。这些碎片不是简单的文本复制,而是经过压缩和索引的"语义摘要"。当模型处理新输入时,会先检索相关的记忆碎片,然后将其与当前输入融合,生成响应。
这带来了三个革命性效果:
高效长上下文检索: 即使在百万Token的上下文中,模型也能在毫秒级定位到相关信息,而不是逐字扫描全文。
连续性记忆: 模型会"记住"你的偏好、习惯和上下文。比如,你之前提到自己是Python开发者,后面问代码问题时,模型会自动用Python风格回答,而不需要每次都重新说明。
解决衰减问题: 传统模型的注意力权重会随着距离增加而指数衰减。Engram通过外部记忆存储,打破了这种"距离诅咒",让远距离信息同样清晰可及。
3.3 其他架构优化:mHC、Muon与FP4量化
除了MoE和Engram,V4还引入了一系列工程创新:
Manifold-Constrained Hyper-Connections(mHC)
这是一种新型连接器,替代了传统的残差连接。你可以把它理解为信息高速公路上的"智能立交桥"——它不仅让信号传递更顺畅,还能根据流量动态调整路线,避免"拥堵"。这使得训练1.6万亿参数的超大模型时,梯度传播更稳定,不容易出现"梯度消失"或"梯度爆炸"。
Muon优化器
V4用Muon优化器替代了业界标准的AdamW。Muon的核心优势在于收敛速度更快、训练稳定性更高。DeepSeek团队还针对大规模分布式训练环境做了专门优化,使得数千张GPU上的训练任务能够高效协同。
FP4量化训练
在训练后期,V4直接引入FP4(4位浮点)精度进行量化感知训练。这不仅减少了显存占用,还让训练和推理行为完全一致。更有趣的是,团队发现FP4反量化为FP8可以是"无损"的,完全兼容现有推理框架。这种"训练-推理一致性",避免了传统量化常见的"训练时高精度、推理时低精度"导致的性能损失。
四、混合注意力机制:从平方级到线性的数学突破
如果说MoE+Engram是V4的"骨架",那么混合注意力机制就是它的"神经系统"。这也是V4能够实现"百万Token上下文+低成本推理"的核心秘密。
4.1 传统注意力的"平方级诅咒"
要理解V4的突破,必须先理解传统Transformer的痛点。
在标准注意力机制中,每个词都要和句子中的所有其他词"交流"一遍。如果你有N个词,计算量就是N×N——这叫平方级复杂度。
当N=1000时,计算量是100万。当N=100万时,计算量是1万亿。这就是为什么长上下文一直如此昂贵——不是模型"不想"处理长文本,而是数学上的"不可能"。
4.2 V4的解决方案:CSA+HCA混合策略
DeepSeek-V4设计了一套"混合注意力机制",交替使用两种"压缩型"注意力,在不同网络层"模块化拼接":
稀疏压缩注意力(CSA):微观细节的"高速索引"
CSA的工作方式,就像一个高效的信息摘要系统:
1. 分块压缩: 先把连续的几个词(比如4个)压缩成一个"信息块"的KV缓存。这相当于把一本书的每几页折成一个"便签"。
2. 快速检索: 当生成新词时,模型通过一个"快速索引器",从所有历史信息块中,只挑出最相关的少数几个(比如top-512)进行精细计算。
3. 局部精细: 对于当前位置附近的词,保留完整的密集计算,确保局部细节的准确性。
这就像查阅一本1000页的书时,你不是通读全文,而是先看目录和章节摘要,只精读最相关的几章。时间节省了,关键信息也没遗漏。
重度压缩注意力(HCA):宏观脉络的"超级缓存"
HCA更加激进。它的压缩率极高——比如将128个词合并成一个"超级缓存块"。但为了平衡,它保留了密集计算,并用滑动窗口确保对局部细节的捕捉。
你可以把HCA看作一个"长期脉络记忆库"。它不关心"第三段第二句用了什么修辞",而是把握"整篇文章的主旨是什么"。这种"抓大放小"的策略,使得宏观层面的语义连贯性得以保持,同时计算量大幅下降。
4.3 效果:数量级的效率提升
正是这种"微观细节用CSA,宏观脉络用HCA"的混合策略,配合低精度存储(部分使用FP8/FP4),使得V4在长上下文场景下的效率实现了数量级突破:
• Pro模型: 单Token推理计算量是V3.2的27%,KV缓存占用仅10%
• Flash模型: 单Token推理计算量降至V3.2的10%,KV缓存占用仅7%
这意味着,处理同样长的文本,V4比V3.2快了近4倍,显存占用少了近10倍。这为长上下文应用的真正普及,奠定了经济基础。
4.4 KV缓存的创新管理
面对混合注意力带来的多层、多类型缓存,传统的"分页"管理方式(如vLLM的PagedAttention)失效了。DeepSeek为V4量身定制了新的缓存结构:
异构KV缓存: 将CSA压缩缓存、HCA超级缓存、滑动窗口状态缓存分开管理,每种类型采用最适合的存储策略。
磁盘KV缓存: 创新性地支持将压缩后的KV缓存存入磁盘,实现前缀复用。这对于长文档的多次查询场景(比如先问"总结全文",再问"第三章的核心观点")极为高效——第一次计算后,后续查询可以直接从磁盘加载缓存,无需重新编码。
滑动窗口状态管理: 将滑动窗口看作一种"状态"而非"缓存"来管理,进一步降低显存占用。
五、性能实测:开源模型首次叫板闭源巨头
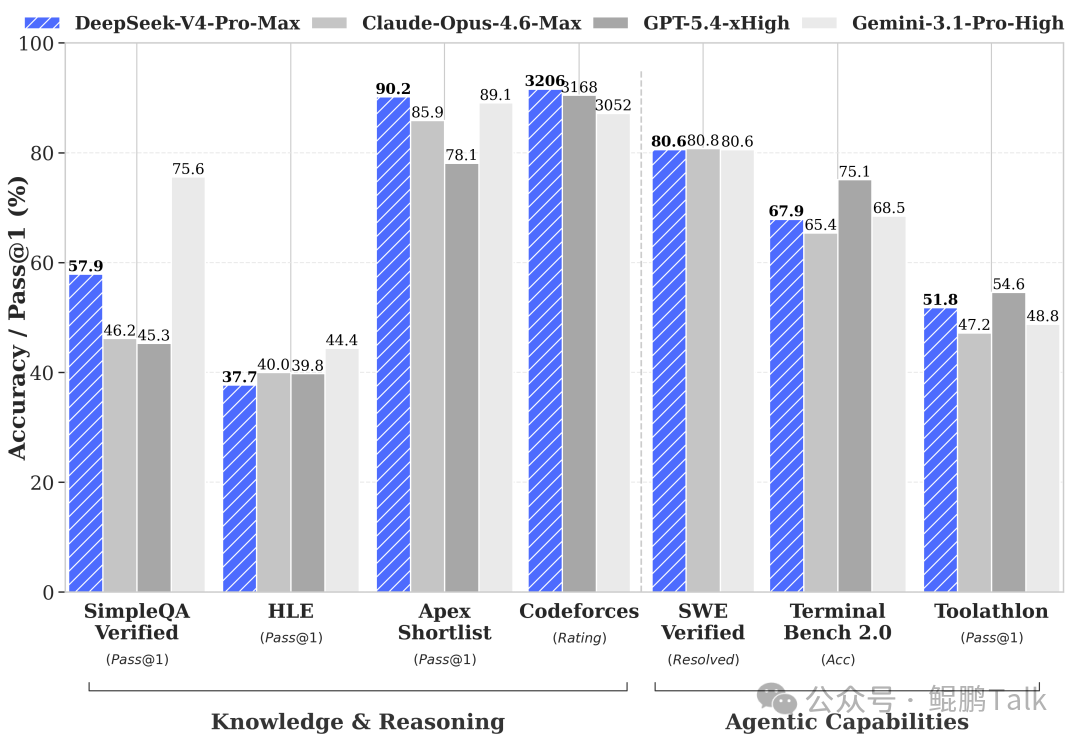
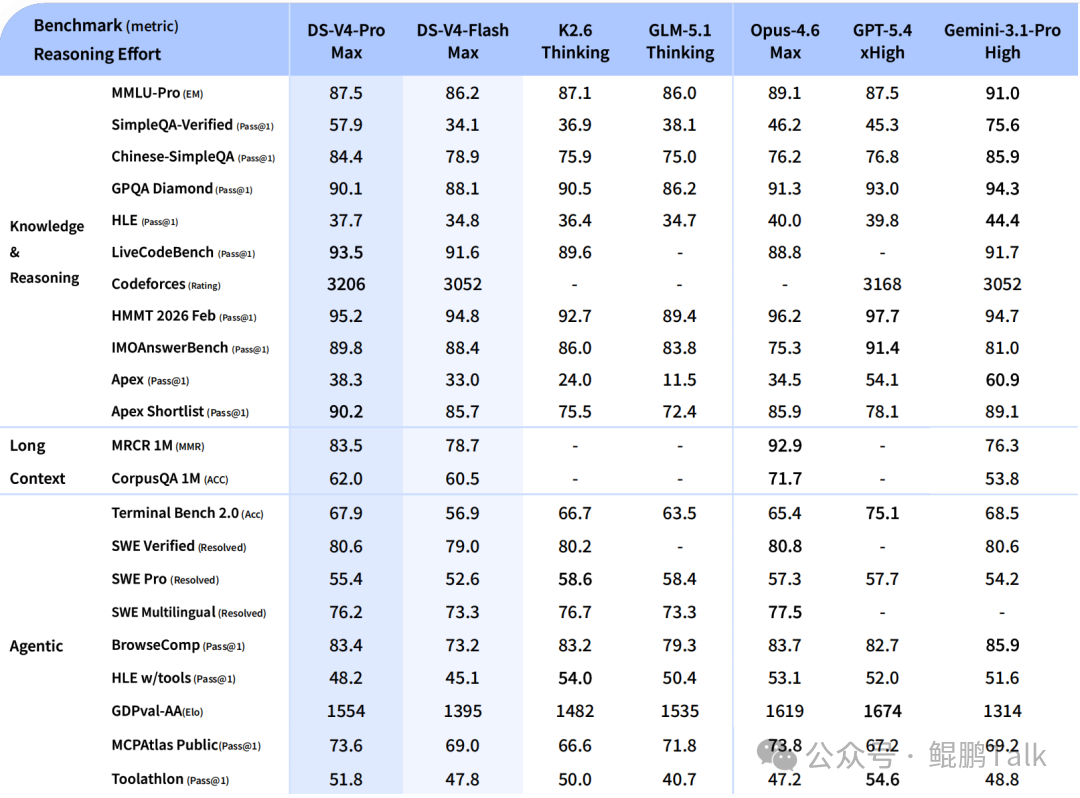
架构创新终究要接受基准测试的检验。DeepSeek-V4-Pro在多个领域达到了开源模型的SOTA(State of the Art),甚至在某些基准上超越了顶级闭源模型。
5.1 编码能力:程序员的"新神器"
LiveCodeBench Pass@1:93.5%
这一成绩领先Gemini 3.1 Pro等强劲对手。LiveCodeBench是评估模型真实编程能力的权威基准,93.5%的通过率意味着V4在解决实际编程问题时,几乎每10题能答对9题以上。
Codeforces评级:3206
Codeforces是全球最权威的算法竞赛平台,3206分超越了GPT-5.4的3168分。这意味着V4的算法设计和代码实现能力,已经达到了人类顶尖竞赛选手的水平。
SWE-bench Verified:约80.6%
SWE-bench测试模型在真实软件工程任务中的表现(如修复GitHub上的真实bug)。80.6%的成绩表明,V4不仅能写代码,还能理解和修改大型代码库——这是Agent能力的关键指标。
HumanEval:90%+
OpenAI的经典编程基准,V4的成绩超过90%,与顶级闭源模型处于同一梯队。
5.2 数学与推理:逻辑思维的"新高度"
IMOAnswerBench:89.8%
国际数学奥林匹克级别的题目,V4接近90%的准确率。这意味着它不仅能解常规数学题,还能处理需要多步推理和创造性思维的竞赛级难题。
GPQA Diamond:90.1%
GPQA(Graduate-Level Google-Proof Q&A)是测试模型在研究生级别科学问题上的能力。Diamond子集尤为困难,需要深度领域知识。90.1%的成绩,证明V4在科学推理上达到了专家水平。
HMMT等竞赛数学: 同样取得高分,显示其在各类数学推理任务上的全面优势。
5.3 长上下文:百万Token的"记忆力"测试
MRCR 1M、CorpusQA 1M: 在百万Token级别的阅读理解测试中表现强劲,证明其长上下文检索和理解能力确实达到了标称的1M水平。
5.4 与闭源巨头的对比
模型编码数学长上下文性价比DeepSeek-V4-Pro⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐GPT-5.4⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐Claude Opus 4.6⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐Gemini 3.1 Pro⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐⭐
整体定位: V4在编码、Agent、长上下文任务上性价比极高。虽然在通用对话、安全过滤等场景可能仍需追赶闭源顶级模型,但开放权重+极致性价比是其最大亮点。
需要注意: 当前为Preview版,官方尚未发布完整独立基准报告,实际表现需以第三方评测为准。社区反馈称其在代码和高效任务上特别亮眼,但简单QA等场景可能仍有提升空间。
六、定价策略:"成本有效性"的商业颠覆
如果说技术性能是V4的"硬实力",那么定价策略就是其"杀手锏"。
6.1 API定价:便宜到"不真实"
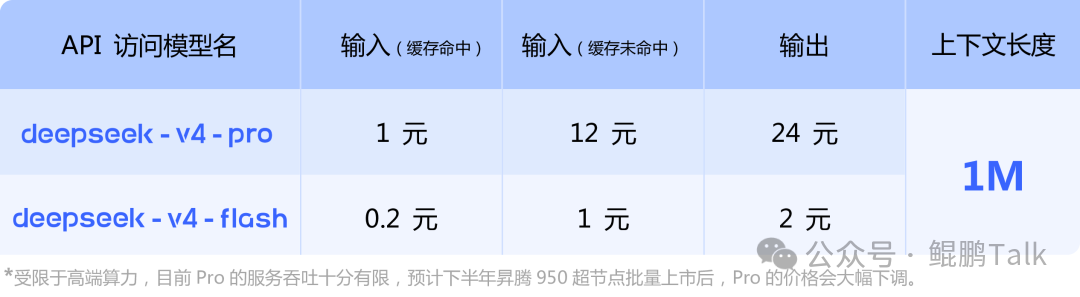
V4-Flash:
• 输入:约$0.028–0.14 / 1M tokens(缓存命中/未命中)
• 输出:$0.28 / 1M tokens
V4-Pro:
• 输入:约$0.145–1.74 / 1M tokens
• 输出:$3.48 / 1M tokens
这是什么概念?
相比GPT-4o、Claude 3.5 Sonnet等美国主流模型,V4的成本低10–50倍不等。具体取决于缓存命中率和使用时段。
6.2 off-peak折扣:深夜早间的"薅羊毛"策略
DeepSeek还推出了off-peak折扣机制:北京时间深夜至早间(具体时段以官方公告为准),API调用费用再降50%。
这种"分时定价"策略,既分散了峰值负载,又给了开发者实实在在的优惠。对于批量处理任务(如数据清洗、文档分析),完全可以安排在深夜运行,成本再砍一半。
6.3 开源部署:零API成本的"终极方案"
如果你不想按token付费,V4的MIT开源许可允许你直接下载权重,在本地或私有云部署。
支持的工具包括:
• vLLM: 高性能推理引擎,适合生产环境
• Ollama: 本地一键部署,适合个人开发者
• Unsloth等量化工具: 进一步压缩模型体积,支持消费者级GPU运行
这意味着,对于数据敏感型企业(如金融、医疗、政府),可以完全在内部网络运行V4,既保证了数据安全,又消除了API调用的持续成本。
6.4 商业影响:重新定义"AI成本"
V4的定价策略,正在重塑整个AI行业的成本预期:
对开发者: 以前用不起的长上下文应用(如全库代码分析、百万字文档处理),现在成本降低了10倍以上,商业化变得可行。
对企业: 私有化部署的门槛大幅降低。一个284B参数的Flash模型,量化后可以在单张RTX 4090(24GB显存)上运行,中小企业也能拥有自己的"私有GPT"。
对竞争对手: OpenAI、Anthropic等闭源厂商面临巨大压力。如果V4的性能确实接近甚至超越闭源模型,那么"为什么要花10倍价钱买闭源API?"将成为每个企业的灵魂拷问。
七、国产算力适配:华为Ascend的"去NVIDIA化"实验
V4最被低估的意义,可能是其对国产算力的深度适配。
7.1 混合异构训练集群
根据技术报告,DeepSeek-V4的训练集群采用了NVIDIA GPU + 华为Ascend NPU的混合架构。
这是一个极具战略意义的信号:
技术层面: 证明先进大模型的训练不依赖单一硬件供应链。MoE架构的稀疏特性,天然适合异构计算——不同的"专家"可以运行在不同类型的芯片上。
商业层面: 为其他中国AI公司提供了"去NVIDIA化"的可行路径。在当前地缘政治背景下,这不仅是技术选择,更是生存策略。
7.2 对硬件厂商的"喊话"
在V4的技术报告中,DeepSeek罕见地向硬件厂商提出了几条具体建议:
算力-通信比: 他们算了一笔账,说只要1 GBps的互联带宽能喂饱6.1 TFLOP/s的算力就够了,并直接呼吁:“我们鼓励未来的硬件设计瞄准这个平衡点,而不是无条件地堆带宽”。
功耗预算: 他们抱怨极端的算子融合会让计算、显存、网络同时满载,导致"功耗墙"成为性能瓶颈。建议未来的硬件要有更大的供电冗余。
激活函数: 甚至建议硬件厂商考虑取消SwiGLU里的昂贵指数运算,以配合MoE设计。
这些"喊话"说明,DeepSeek可能已经触及了现有最顶级硬件的物理极限,才会如此强调软件适配要迁就硬件的物理短板。
7.3 对国产芯片产业的影响
V4对华为Ascend的适配,可能产生连锁反应:
需求端: 证明Ascend可以训练万亿参数大模型,打消了"国产芯片不行"的疑虑,推动更多企业采购国产算力。
供给端: 倒逼华为等芯片厂商针对大模型训练优化架构。DeepSeek提出的具体建议(如算力-通信比、功耗预算),很可能成为下一代芯片的设计输入。
生态端: 开源的V4权重+国产芯片适配,为"中国版AI生态"提供了完整的"模型+芯片+框架"闭环。
八、Agent与多模态:下一代AI应用的基础设施
除了长上下文和低成本,V4在Agent能力和多模态支持上的升级,同样值得关注。
8.1 Agent能力大幅增强
V4的Agent能力体现在三个层面:
复杂多步任务: 可以拆解并执行需要多个步骤的复杂指令。比如"帮我分析这份财报,找出三个风险点,然后写一份邮件给投资团队"——V4可以自动完成"阅读→分析→写作→格式化"的全流程。
仓库级代码理解: 不仅能理解单个文件,还能理解整个代码库的架构、依赖关系和调用链。这对于大型软件项目的维护和重构,是质变级别的能力。
工具调用增强: 更精准的函数调用、更可靠的外部API集成、更灵活的工作流编排。
8.2 原生多模态:从"文本模型"到"世界模型"
V4支持文本+图像/视觉输入,部分报道还提及视频理解能力。这标志着DeepSeek正在从"纯文本模型"向"原生多模态模型"过渡。
多模态能力的意义在于:
更丰富的输入: 可以处理PDF、图表、截图、照片等非文本信息。比如,你可以直接上传一张财务报表的截图,让V4提取数据并分析。
更直观的交互: 在客服、教育、设计等场景,"看图说话"比"纯文本描述"更高效。
更接近"世界模型": 人类认知本身就是多模态的——我们看、听、读、写。多模态模型更接近通用人工智能(AGI)的目标。
8.3 推理模式:Non-think、Think High、Think Max
V4支持通过reasoning_effort参数调节推理深度:
• Non-think: 快速响应,适合简单问答
• Think High: 中等深度推理,平衡速度和质量
• Think Max: 最大化推理深度,适合复杂数学、代码、逻辑题
这种"可调推理"机制,让用户可以根据任务复杂度灵活选择,避免"杀鸡用牛刀"的资源浪费。
九、总结与展望:下一代AI应用的真正起点
DeepSeek-V4的发布,不像是一次常规的模型升级,更像是一次定向爆破——精准地瞄准了困扰LLM社区已久的"长上下文效率"痛点。
它交出的答卷,不仅是两个强大的模型,更是一套从底层架构到上层训练的完整技术方案:
• MoE+Engram 解决了"大模型必须慢"的魔咒
• CSA+HCA混合注意力 打破了长上下文的平方级诅咒
• FP4量化+异构缓存 实现了训练-推理的一致性和高效性
• MIT开源+极致定价 重新定义了AI的商业逻辑
• 国产芯片适配 为中国AI生态自主提供了可行路径
V4的局限性
当然,V4并非完美:
架构复杂度: 为效率而设计的混合架构,增加了理解和调试的难度。
训练不稳定性: 技术报告中坦承,训练中仍存在难以解释的不稳定性。
指令遵循: 在某些极困难的指令遵循和格式化美感上,仍有提升空间。
Preview版风险: 当前为预览版,功能和性能可能继续迭代,生产环境使用需谨慎。
未来展望
DeepSeek-V4最重要的意义在于,它有力地证明了:通过架构创新,我们可以打破"大"就必须是"慢"和"贵"的魔咒。
它让"百万Token上下文"从一个理论指标,变成了能在真实应用中被高效、低成本调用的基础能力。这为下一代AI应用——如全自动代码生成、实时多文档分析、长周期智能体工作流——打开了全新的大门。
如果你是一名开发者,现在就可以访问 platform.deepseek.com 体验API;如果你想本地部署,可以去 Hugging Face 下载权重。
百万Token时代,真的来了。
本文基于DeepSeek-V4 Preview版公开资料整理,具体性能以官方正式发布和第三方独立评测为准。技术细节参考了DeepSeek技术报告及社区分析,如有疏漏,欢迎指正。
觉得有收获?欢迎点赞、在看、转发,让更多人看到中国AI的创新力量。后续我们将持续跟进V4的实测表现和部署教程,敬请关注。
