
1什么是爬虫?
定义:
网络爬虫(Web Crawler),也称为网络蜘蛛(Web Spider)是一种按照特定规则自动抓取互联网信息的程序或脚本。它通过模拟浏览器行为,访问网页并提取所需数据。
通俗理解:
就像一只在互联网上爬行的"蜘蛛",沿着网页链接不断探索用代码模拟人的浏览行为:访问网站、点击链接、查看内容核心任务:自动、批量地从网页中提取结构化数据技术
本质:
爬虫=网络请求+数据解析+数据存储
1.发送HTTP请求获取网页内容
2.解析HTML/]SON等格式的数据
3.提取并存储目标信息
爬虫的作用与价值,
通过有效的爬虫手段批量采集数据,可以降低人工成本,提高有效数据量,给予运营/销售的数据支撑,加快产品发展。
核心价值:
效率提升:替代人工手动收集,实现7x24小时不间断工作
成本降低:减少人力投入,提高数据采集的经济性
数据规模:获取海量数据,支持大数据分析
实时性:快速响应市场变化,获取最新信息
具体应用场景:
1.搜索引擎:Google、百度等搜索引擎的基础技术
2.价格监控:电商平台价格对比与趋势分析
3.舆情分析:社交媒体、新闻网站的内容监控
4.学术研究:文献、专利、论文数据收集
5.市场调研:竞品分析、用户行为研究
6.内容聚合:新闻、博客、视频等内容整合
爬虫的核心工作原理
完整工作流程步骤:
1.URL管理阶段
。种子URL:设定初始访问地址
。URL队列:维护待抓取URL列表
。去重机制:避免重复抓取
优先级调度:重要URL优先处理
2.请求发送阶段
。HTTP请求:GET/POST等方法
。请求头设置:模拟真实浏览器
。会话管理:维持登录状态
。错误处理:超时、重试机制
3.响应处理阶段
。状态码检查:200成功、404不存在等
。编码识别:自动检测网页编码
。内容类型:HTML、JSON、XML等
反爬检测:识别验证码、限制等
4.数据解析阶段
。 HTML解析:DOM树构建与遍历
。数据提取:XPath、CSS选择器、正则表达
。数据清洗:去除噪音、格式化处理
。链接提取:发现新的抓取目标
5.数据存储阶段
。存储格式:CSV、JSON、数据库等
。增量更新:只存储新变化的数据
。数据备份:防止数据丢失
。索引建立:便于后续查询分析
6.控制策略
。礼貌爬取:遵守robots.txt
。频率控制:避免对服务器造成压力
。深度限制:控制抓取层级
。时间调度:定时执行任务
......
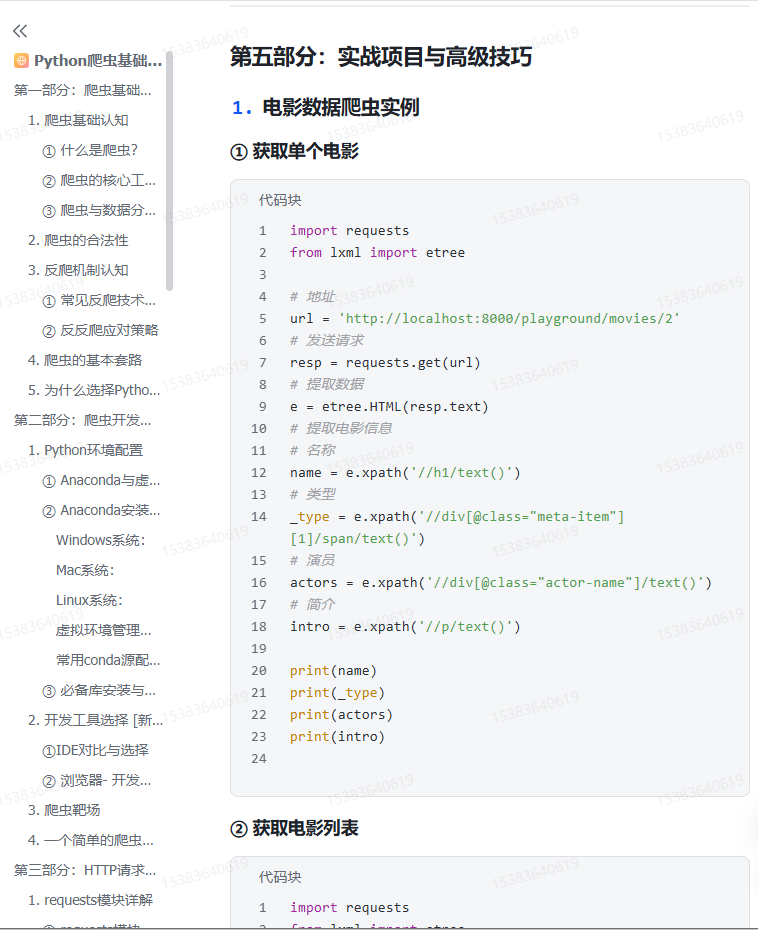
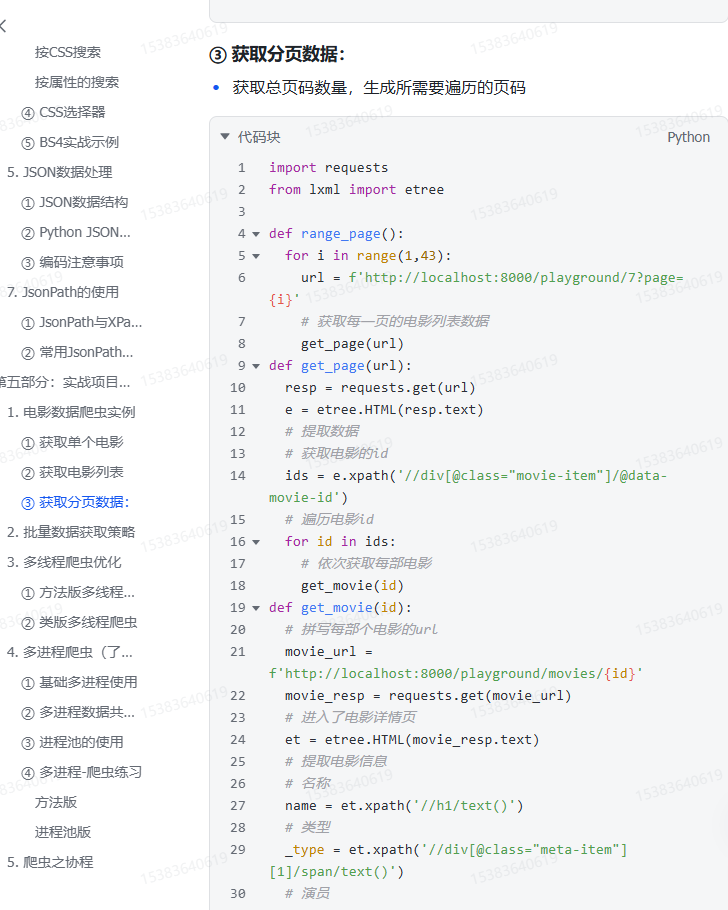
已经把完整Python爬虫教程整理成飞书版本了,方便大家随时随地都能学习。需要的文末领取
【文末领取】
#计算机# #学习# #大学生# #编程##数据分析##Python##Python爬虫##爬虫#
获取方式:
一键三连+关注
后台主动留下痕迹:飞书
