
通过观察目前市场岗位要求,我们可以发现,大多数岗位对于rag的应用是非常高的,要求已经不只是“了解”了,而是深入到了系统搭建和全链路优化的层面。
目前主流岗位对rag的要求有如下四点。
RAG系统开发与优化
需要具备完整的RAG系统搭建经验,并能对其进行深度优化。这包括解决模型幻觉、提升业务响应准确性等具体问题。“全链路优化”,如混合检索、重排序等是高频要求。
向量数据库
“掌握至少一种向量数据库” 是普遍硬性要求。FAISS、ChromaDB、PGVector等都是常见的被提及的选项。
RAG与Agent协同开发
大部分岗位将RAG与Agent(智能体)并列,要求能用LangChain/LangGraph等框架实现“工具调用、知识检索”。一些岗位还将MCP协议(Model Context Protocol)也列为加分项。
知识库与语义检索
要求能基于RAG构建和维护知识库系统,并熟悉语义检索、知识图谱等技术。
那么我们现在开始学习rag的核心概念。
关键概念:检索(Retrieval)、增强(Augmentation)、生成(Generation),以及RAG如何解决大模型的“幻觉”和知识时效性问题。
作为实践,我们开始打造一个“基于MCP协议的智能RAG知识库助手”。我们的目标是:构建一个可以通过MCP协议进行访问的RAG系统,Agent可以随时“调用”它来回答问题。
我们的思路是这样的:在本地用一个小的文本文件作为知识库,用LangChain + ChromaDB(轻量级向量数据库)来构建检索,最后用阿里云百炼的通义千问来生成答案。
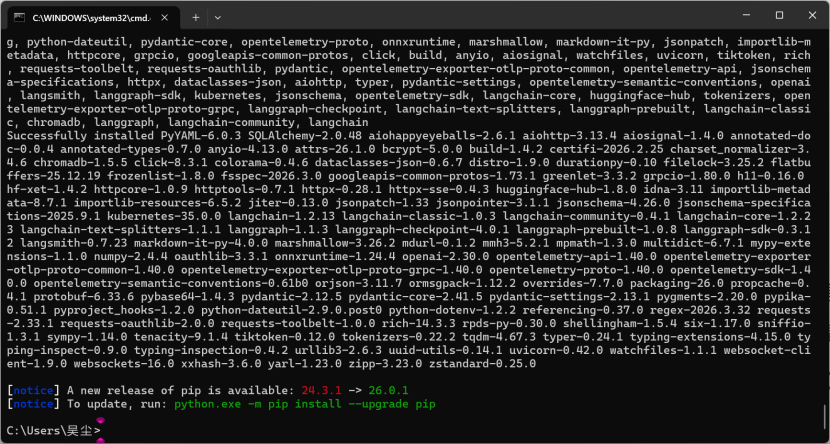
首先安装必要的库。
pip install langchain langchain-community langchain-classic langchain-text-splitters chromadb openai tiktoken sentence-transformers
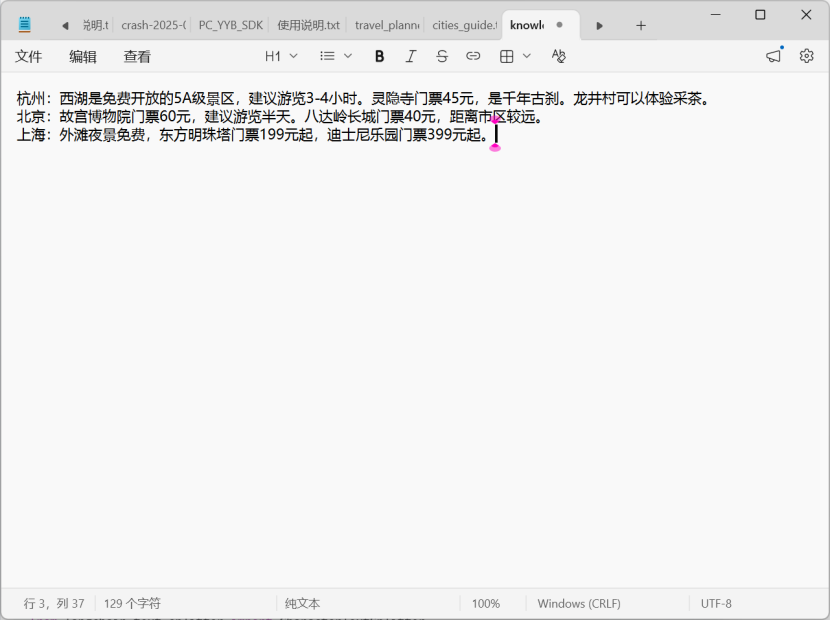
接着创建一个文本文档作为知识库底料。
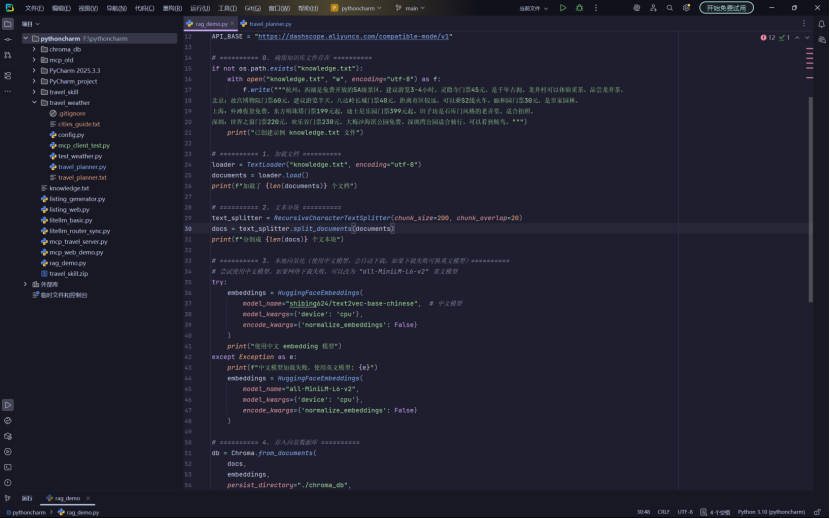
接下来我们新建一个py脚本文件,利用我们之前的知识库底料创建一个向量数据库,然后存放数据。
运行结果如下所示。
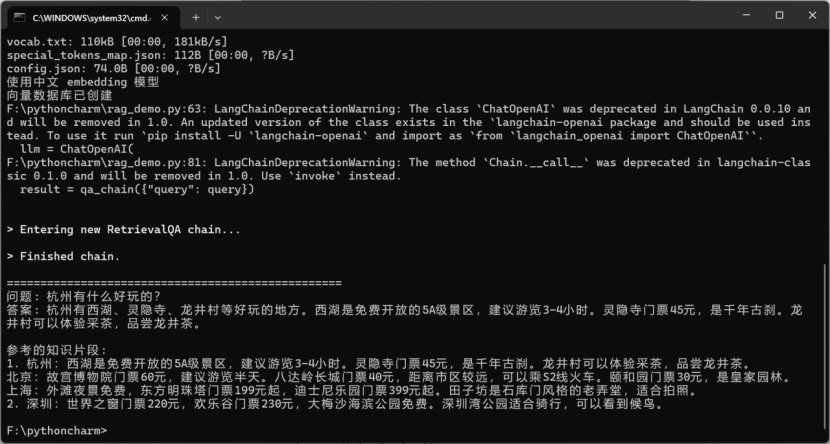
这个脚本执行了如下指令:
成功加载知识库文档;
使用本地中文 embedding 模型(text2vec-base-chinese);
创建了向量数据库;
检索并生成了准确答案(杭州的景点信息完全来自知识库中的文本);
执行这个脚本的过程中,我们亲手搭建了一个完整的 RAG 系统,包括:
文档加载;
文本分块;
使用中文 embedding 模型向量化;
存入向量数据库(Chroma);
检索相关片段;
调用大模型生成基于事实的回答;
这是企业级 AI 应用的核心能力。
我们刚才成功跑通了第一个RAG程序,已经实现了“加载文档 -> 分块 -> 向量化 -> 存储 -> 检索 -> 生成答案”的完整流程。现在我们要做的,就是让检索更精准,从而让最终答案质量更高。
首先我们学习一下检索的概念。
RAG中的“R”(Retrieval)指的就是检索。它的目标是从你的知识库中,找到与用户问题最相关的几个文本片段(称为“召回”),然后把这些片段连同问题一起交给大模型生成答案。
当前这个RAG知识系统用的检索方式:向量检索(语义检索)
原理:把用户的问题和知识库中的文本块都转换成向量(embedding),然后计算它们之间的“距离”或“相似度”,找到最相近的K个文本块。
优点:能理解语义,比如“好玩的地方”能匹配到“景点”。
缺点:纯粹依赖语义相似度,可能会漏掉一些关键词完全匹配但语义略有差异的片段,或者被一些语义相似但内容不相关的片段干扰。
也就是说,如果检索到的片段不相关,大模型可能给出错误答案(“幻觉”);如果检索到的片段太片面,答案可能不完整。所以,我们要对这个系统进行检索优化。
在我们之前创建的py脚本中,检索器是由这行代码创建的;
retriever = db.as_retriever(search_kwargs={"k": 4})
这里的 k=4 表示:每次检索返回 4个最相似的文本块。这是最简单的参数。但实际中,我们还可以调整:
相似度阈值:只返回相似度高于某个值的片段(比如只返回相似度>0.8的),过滤掉不相关的。
检索数量:可以设置返回更多候选,再通过重排序(rerank)筛选出最相关的几个。
检索策略:可以结合关键词检索(BM25)和向量检索,取长补短,这就是混合检索。
那么我们一步步开始吧。
