
本文是最新论文 DISCOUQ: Structured Disagreement Analysis for Uncertainty Quantification in LLM Agent Ensembles 的深度解读,这篇文章介绍了一种名为 DISCOUQ 的新型框架,旨在通过分析多智能体大语言模型系统中的分歧结构来精确评估输出的置信度。研究者指出,传统的投票统计忽略了智能体推理过程中的语义信息,而该框架通过提取语言结构特征(如证据重合度和论点强度)与嵌入几何特征(如聚类距离和分散度)来捕捉深层信号。实验表明,其中的 DISCOUQ-LLM 方法在多个基准测试中表现出色,不仅显著提升了识别错误答案的能力,还提供了更优的校准性能。此外,该方法具有很强的跨领域泛化能力,在智能体意见不一的复杂场景下优势尤为明显。最后,该框架在维持高准确率的同时展现了极高的成本效益,为可靠的自动化决策提供了实用方案。
大家好。在如今火热的多智能体(Multi-agent)系统中,让多个大模型(LLM)独立思考并进行“多数投票(Majority Voting)”是提高准确率的标配做法。但这种做法存在一个巨大的陷阱:当 5 个 AI 中有 3 个同意、2 个反对时,传统算法会简单地将置信度标记为 60%。但 3:2 的胜率真的永远是 60% 吗?本期我们要分享的突破性研究——DISCOUQ 框架告诉我们:绝对不是!这不仅是对群体智慧的误解,更是对不确定性量化(UQ)的严重低估
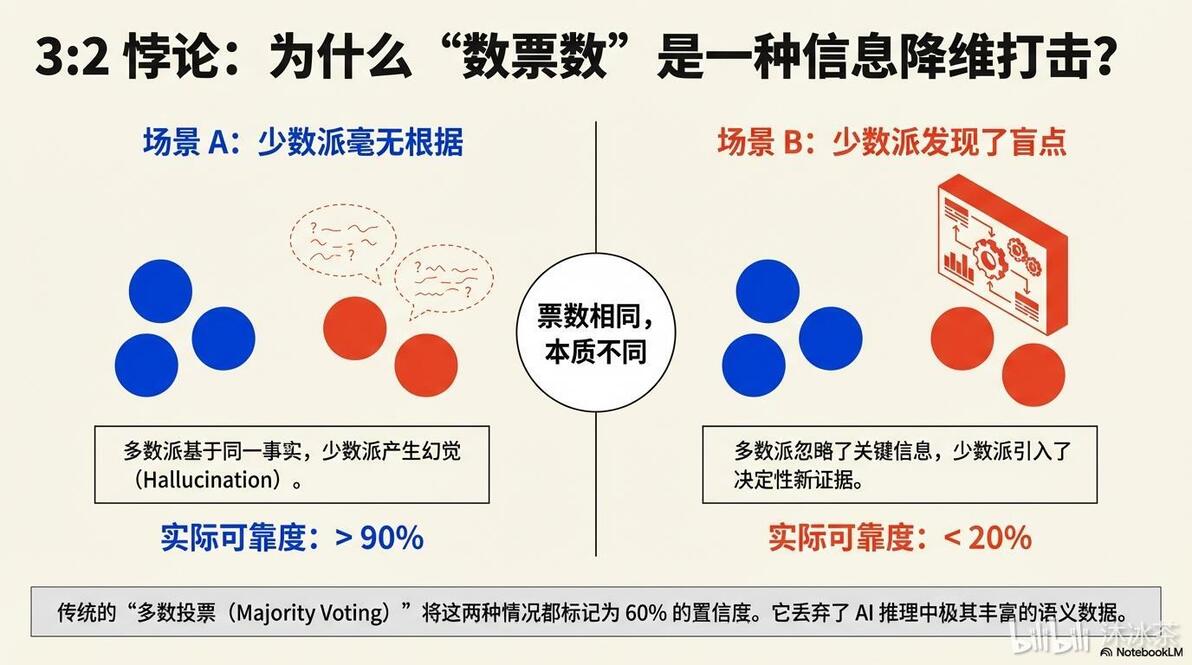
为什么说“算票数”是在暴殄天物?我们来看两种截然不同的“3:2”场景。 场景 A:3个多数派基于可靠事实达成一致,而2个少数派完全是在产生幻觉(Hallucination)或提出了极其薄弱的论点。此时多数派的实际可靠度极高,远超 60%。 场景 B:所有智能体使用了相同的证据,但2个少数派敏锐地发现了多数派忽略的关键盲点,引入了决定性的新证据并得出了不同结论。这种情况下,多数派大概率是错的,实际可靠度极低。 传统的多数投票法粗暴地把这两种情况都归为 60%,完全丢弃了 AI 推理过程中极其丰富的语义信息,这就是“数票数”带来的信息降维打击
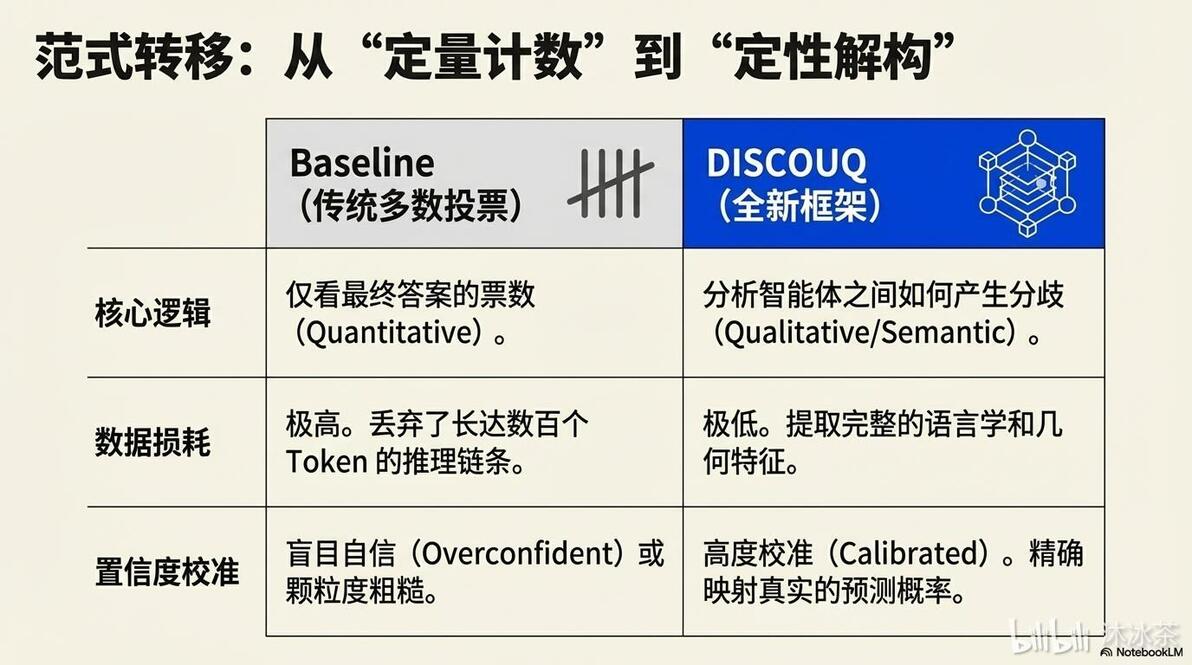
为了解决这个问题,DISCOUQ(基于分歧结构的 LLM 智能体不确定性量化)提出了一场范式转移。 过去的 Baseline 只是“看结果算票数”,丢失了长达数百个 Token 的逻辑推理链条,导致模型常常表现出盲目自信。而 DISCOUQ 的核心理念是:不要只看他们怎么投票,要看他们怎么吵架。 它保留了极低的数据损耗,通过分析智能体产生分歧的结构,将模型的期望校准误差(ECE)降至极低,从粗糙的定量计数走向了精确的定性解构
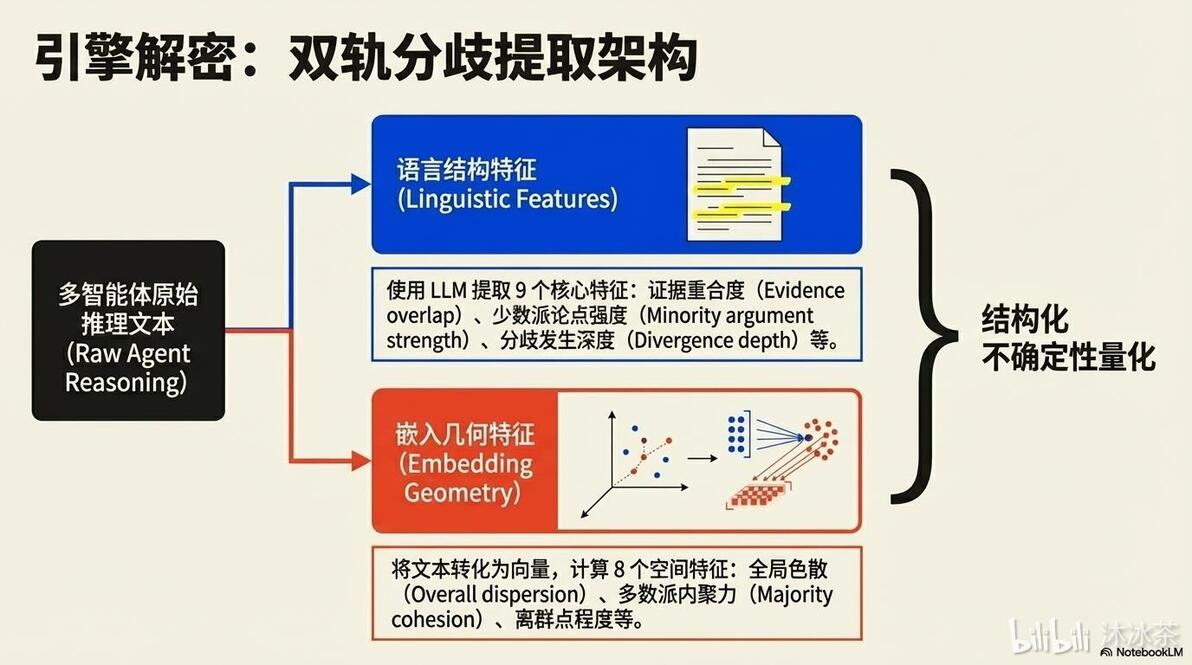
那么,DISCOUQ 是如何“解构”分歧的呢?它采用了一个精妙的双轨架构: 第一轨是语言结构特征(Linguistic Features):它会调用一个 LLM 去阅读 AI 们的原始推理文本,提取出几个核心指标:比如“证据重合度”(大家看的是不是同一个材料?)、“少数派论据强度”(反方辩友的逻辑是否严密?)、以及“分歧发生深度”(是在开头就走偏了,还是最后一步算错了?)等 6 个核心分数。 第二轨是嵌入几何特征(Embedding Geometry):它将推理文本转化为高维向量,从数学空间的角度分析它们的拓扑结构。两者结合,就形成了对 AI 不确定性的结构化量化
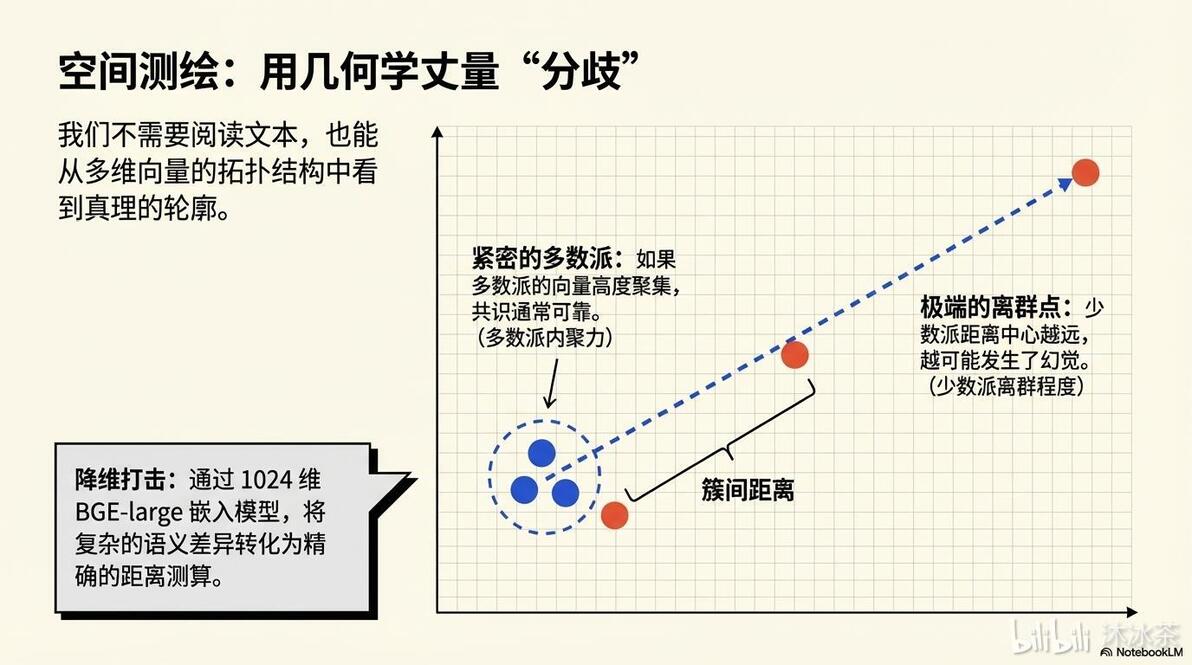
第二轨的“几何特征”非常值得单独拿出来说。DISCOUQ 证明了,有时候我们甚至不需要去读懂文本,只需测量高维空间中的距离就能看穿真理。 通过 1024 维的 BGE-large 嵌入模型,复杂的语义差异被转化为了精确的空间距离。如果多数派的向量在空间中高度聚集(多数派内聚力高),说明共识很坚固;如果少数派的向量距离多数派中心极远(离群点程度高),这通常意味着他们可能陷入了严重的幻觉。这就是真正的降维打击!
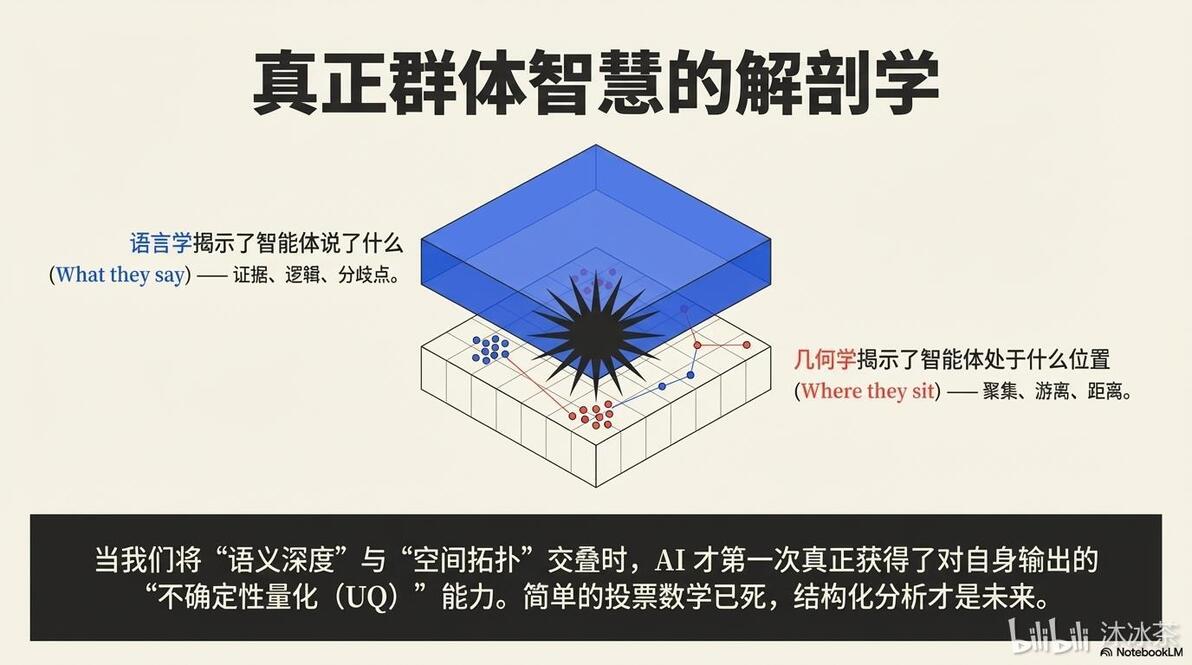
所以,DISCOUQ 完成了对群体智慧的真正解剖。 在顶层,“语言学”揭示了智能体们说了什么(What they say)——他们各自的证据、逻辑和分歧点在哪里; 在底层,“几何学”揭示了智能体在语义空间中处于什么位置(Where they sit)——他们的聚集度、游离态和距离。 当我们将“语义深度”与“空间拓扑”交叠,AI 才第一次真正获得了对自身输出的高度“自我认知”和不确定性量化能力
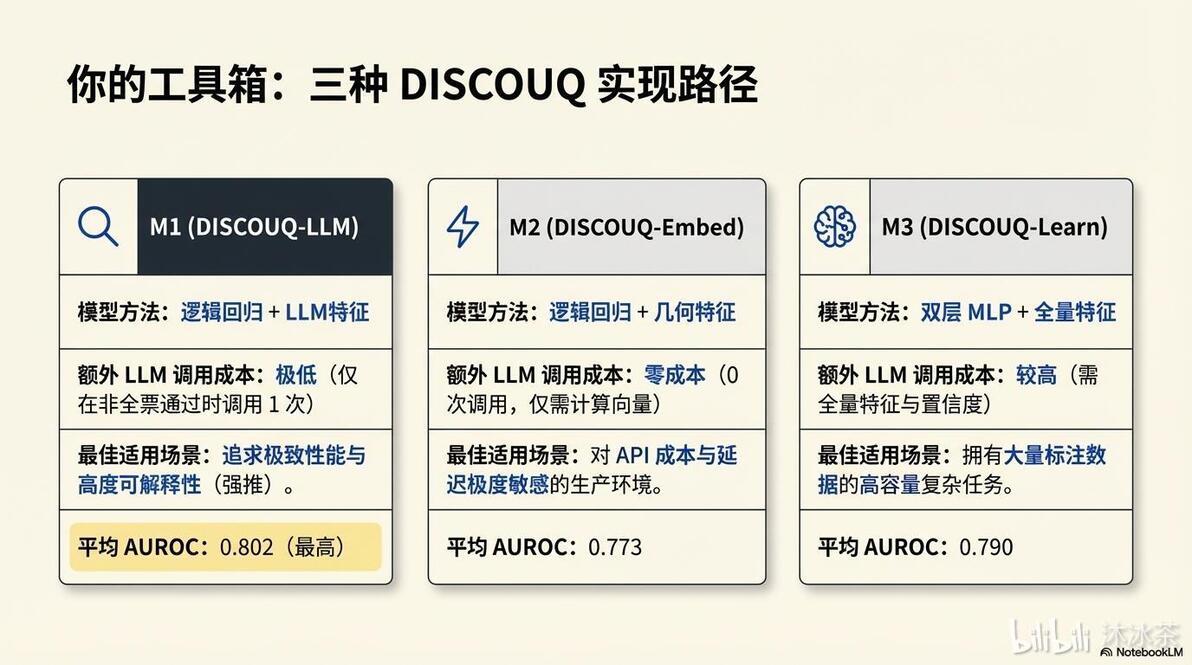
为了适应不同的业务场景,作者贴心地设计了三种实现路径:
M1 (DISCOUQ-LLM):这是性能最强的方案!它使用逻辑回归加 LLM 提取的语言特征。不仅可解释性极强,而且在 Qwen3.5-27B 模型的测试中拿下了最高的 0.802 平均 AUROC。
M2 (DISCOUQ-Embed):极致省钱方案。只需计算向量几何特征,零额外 LLM 调用成本!特别适合对 API 延迟和成本极其敏感的生产环境,性能依然能打(AUROC 0.773)。
M3 (DISCOUQ-Learn):采用双层 MLP 神经网络融合所有特征,适合拥有大量标注数据的高容量复杂任务
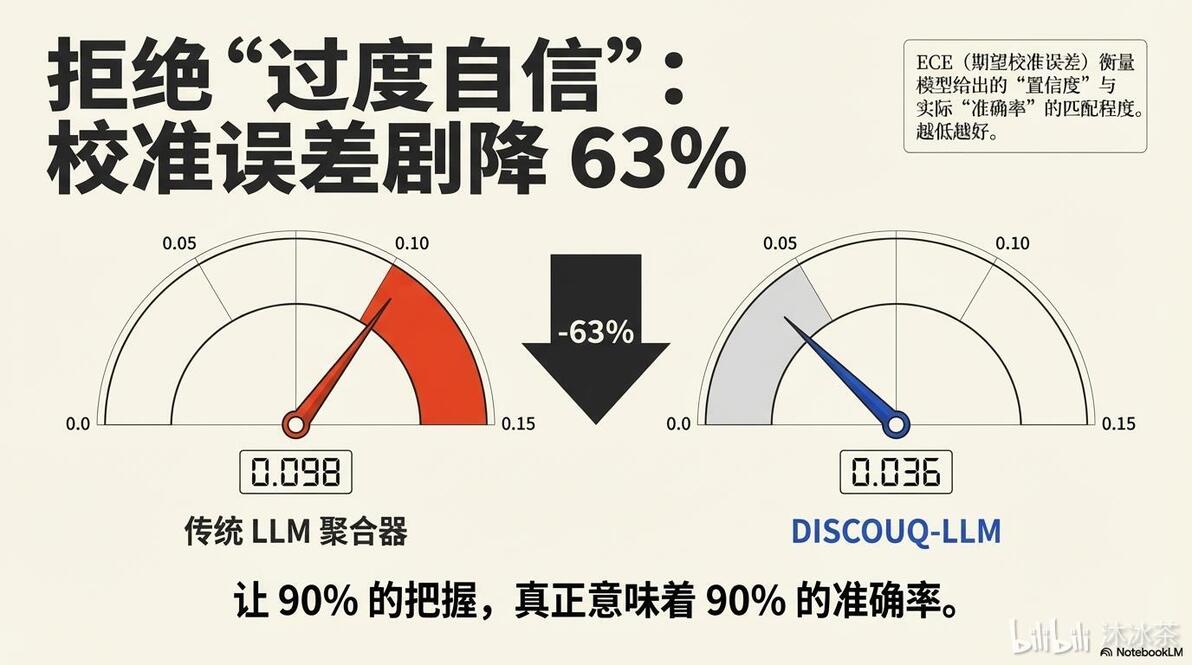
这套系统的威力有多大?最惊艳的成果体现在“校准误差(ECE)”上。 ECE 衡量的是模型声称的“把握”和它实际“准确率”的匹配度。传统方法中,LLM 聚合器的 ECE 高达 0.098,往往过度自信。 而 DISCOUQ-LLM 成功将 ECE 压低至惊人的 0.036,剧降了 63%!这意味着,当 DISCOUQ 告诉你它有 90% 的把握时,它真的就有 90% 的准确率。它让 AI 告别了“盲目自信”
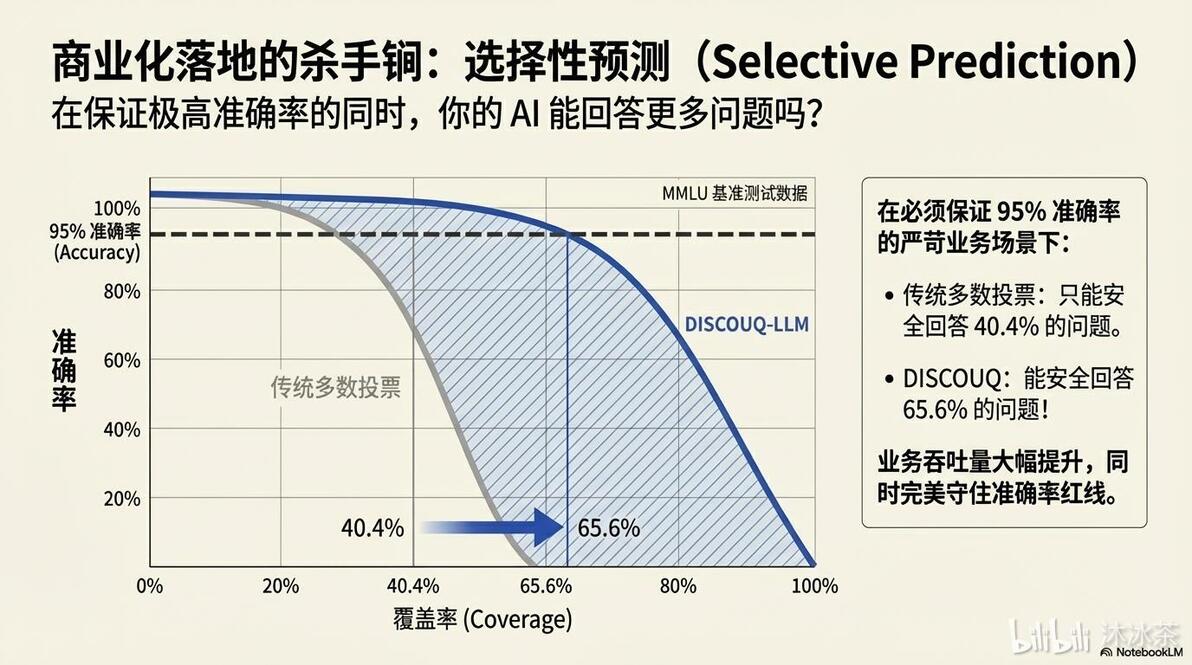
在真实的商业落地中,这一特性的杀手锏应用叫做“选择性预测”:即在必须保证极高准确率的红线前提下,AI 能安全回答多少问题? 在 MMLU 基准测试中,如果业务要求必须达到 95% 的极高准确率:传统的多数投票只能安全回答 40.4% 的问题;而 DISCOUQ 凭借更精准的置信度,敢于安全回答 65.6% 的问题!在守住准确率红线的同时,将业务吞吐量和覆盖率拉升了一个层级
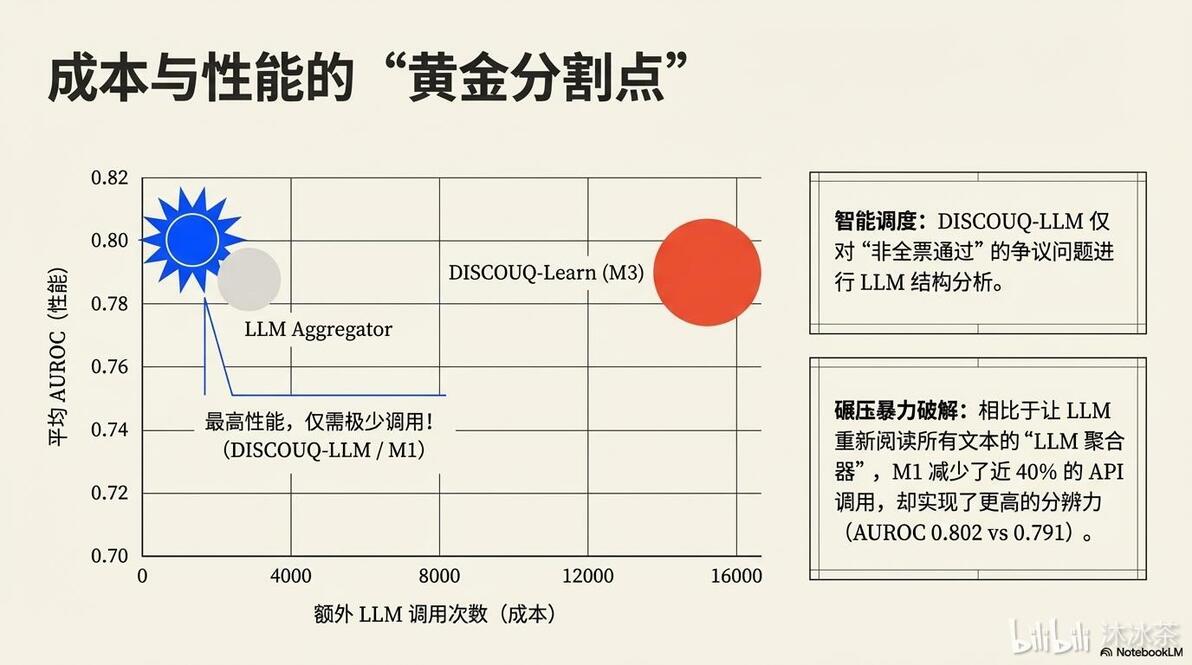
老板可能会问:用 LLM 去分析分歧,API 成本是不是要爆炸? 并非如此!DISCOUQ-LLM (M1) 采用的是智能调度:它只在 AI 们“非全票通过”(产生争议)的时候,才去调用 LLM 进行结构分析。 相比于让一个 LLM 重新阅读所有文本的暴力破解方法(LLM 聚合器),M1 在 2750 个问题中仅仅使用了 1624 次额外调用,大幅减少了计算成本,却实现了全局最高的 AUROC (0.802)。这完美找到了成本与性能的黄金分割点。
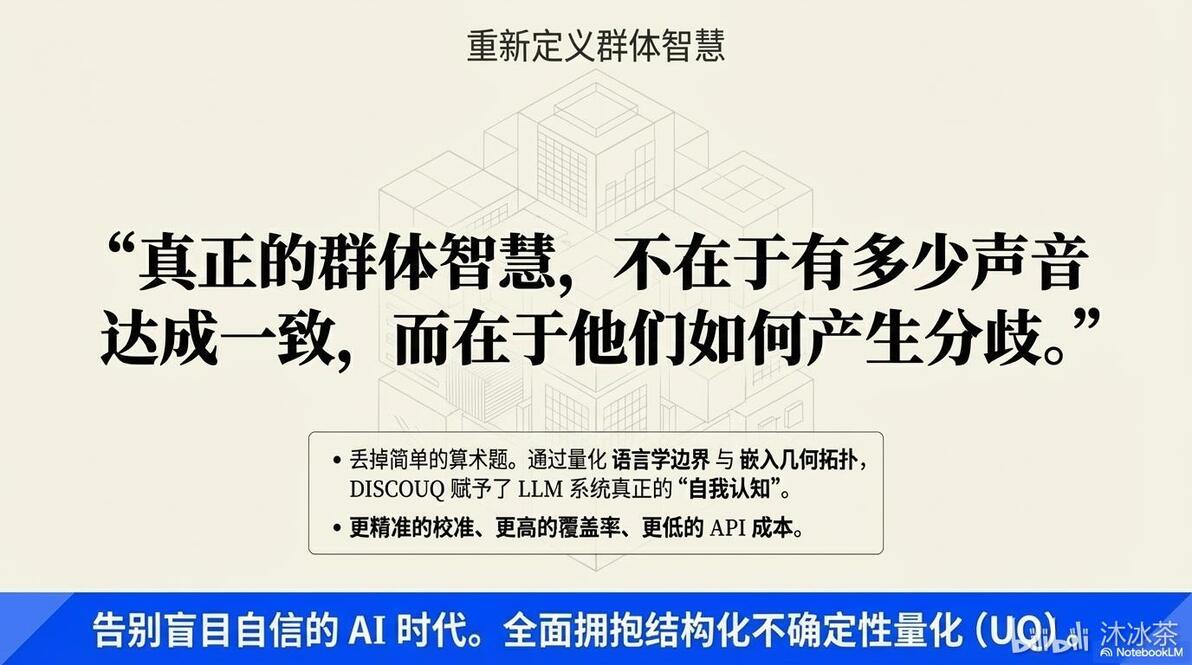
总结一下,DISCOUQ 带来了一句非常深刻的洞察:“真正的群体智慧,不在于有多少声音达成一致,而在于他们如何产生分歧。” 它让我们彻底丢掉了简单粗暴的算术题,通过量化语言学边界与嵌入几何拓扑,赋予了 LLM 系统真正的“自我认知”。这不仅带来了更精准的校准、更高的覆盖率,还维持了极低的 API 成本。 告别盲目自信的 AI 时代,全面拥抱结构化不确定性量化(UQ)将是我们接下来的必经之路。谢谢大家!
