面试官:SFT训练到什么程度,才值得做RL?

Q:SFT训练到什么程度值得做RL?
两次对齐
第一次对齐:把互联网语言模型对齐成对话语言模型
预训练模型优化的是comletion而不是说人话,不使用RL(需要agent获得足够的正向反馈,采样的回答reward分布极度偏向负反馈)
目标:让模型学会基本的对话格式与指令跟随
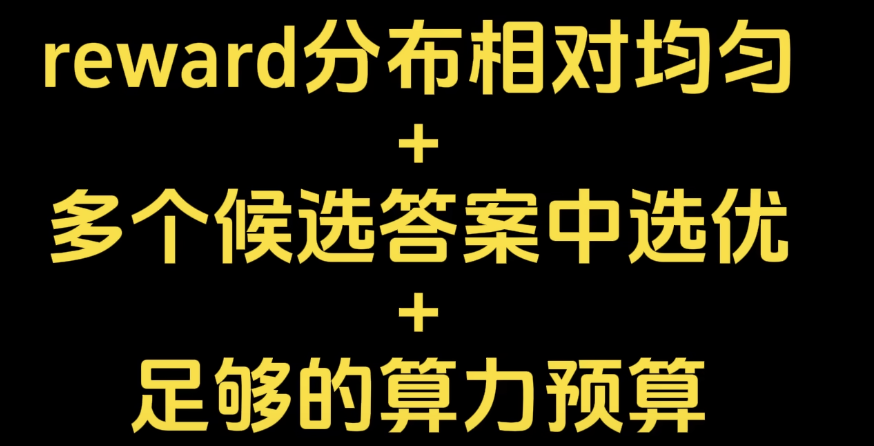
判断标准:reward采样能力,若采样得到的reward比较均匀,既有高分又有低分,说明模型已经会回答了只是质量参差不齐
成本权衡:SFT需要人工标注的完整的(prompt,response)对,若想继续用SFT来提升质量就得不断标注新数据,所以一般采用RL
RL:模型生成候选答案,人只需要偏好标注与排序,甚至可以采用reward model来辅助
第二次对齐:从对话语言模型到可用性强且安全的语言模型
问题:1.回答的好不好 2.回答的安全不安全
天然适配RL,引导模型朝着高质量方向优化
RL可以天然利用负反馈,标注不安全或不好通过pairwise loss或者learning to rank建模reward model泛化性更好
RL适配场景:
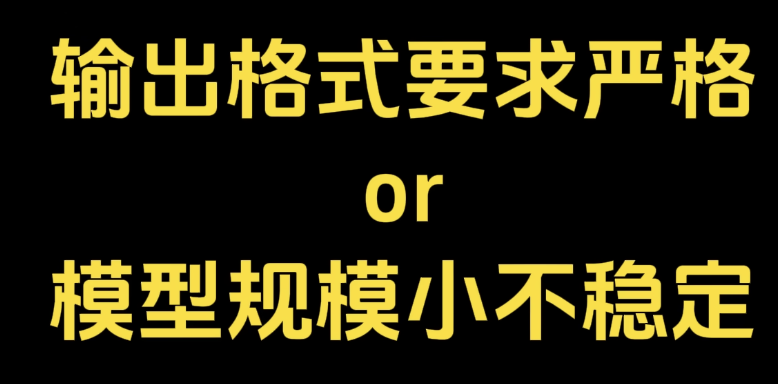
SFT适配场景:
cv47155820
分享至
投诉或建议
