
在AI工具使用中,你是否也遇到过「聊完就忘、反复解释需求」的困扰?蹲完得到「AI 龙虾十日谈」第一场直播,快刀青衣对话智谱 CEO 张鹏(上篇文章有分享),其中张鹏分享了对小龙虾记忆体系的解读,引发我对小龙虾记忆系统的兴趣,所以开始研究 OpenClaw(以下简称:小龙虾) 的记忆架构,通过大量文献调研并结合创始人 Peter 的原始设计,以及行业推演的「五层记忆」版本,今天把这套类人脑的记忆系统逻辑完整拆解,让你彻底弄懂小龙虾记忆的底层原理,用他效率直接翻倍✨
💡为什么小龙虾记忆分层设计这么重要? 传统AI的记忆只靠模型上下文窗口,不仅容量受token限制,会话结束就丢失信息,想实现长期个性化更是难,用起来总觉得“断片儿”。而 OpenClaw 创始人 Peter 提出的本地优先记忆体系,核心是把记忆做成可管理的基础设施,而非仅依赖模型上下文;行业分享在此基础上进一步推演为「五层记忆」,通过分层存储、自动流转、文件即记忆的设计,解决了传统AI记忆混乱、成本高、不可控的问题,让AI能像人脑一样,从瞬时响应到长期进化。
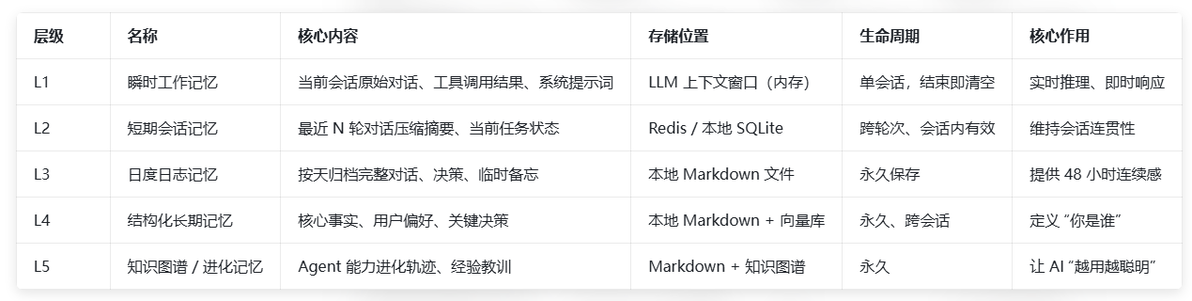
🚀 OpenClaw 五层记忆 | 行业解读版(含官方核心层)
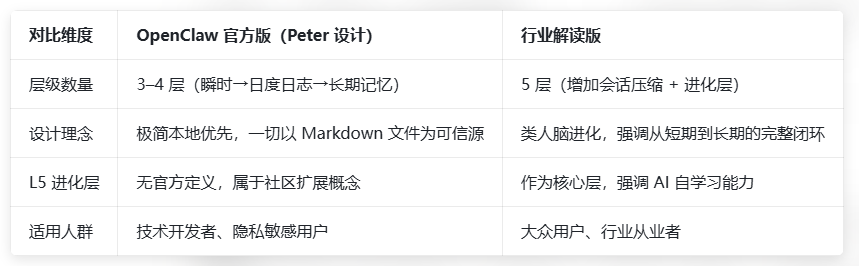
🤝 OpenClaw 官方版 vs 行业解读版 | 核心差异
🛡️OpenClaw 记忆设计的核心原理(Peter 强调的三大底层逻辑) 这套体系能实现高效流转,核心源于三个底层设计,也是它区别于其他AI记忆的关键:
文件即记忆:所有持久记忆都写入本地 Markdown 文件,而非黑盒数据库,透明可编辑、隐私可控,模型只“记住”磁盘上的内容,不凭空生成记忆;
分层溢出:信息从 L1 到 L4 自动流转,L1 满压缩到 L2、会话结束 L2 归档到 L3、每日凌晨 L3 提炼到 L4,彻底解决上下文窗口有限、记忆混乱的问题;
混合检索:关键词+向量语义双重检索,相似度阈值>0.75 才自动召回,且只返回相关片段,既保证检索精准,又控制 token 消耗,降低推理成本。
✨弄懂五层记忆逻辑,用小龙虾的核心价值在哪? 对普通用户来说,摸清 Peter 设计的 OpenClaw 核心记忆体系,能精准区分官方版与解读版,避免用错工具导致效率低下;对想深度使用小龙虾的人来说,理解「五层记忆」流转逻辑,能自定义他的记忆内容,手动编辑 L4 层让他更贴合自己的使用习惯,不管是工作中的项目协作、日常的信息整理,还是长期的个性化需求,都能让AI成为真正的高效助手。
⚠️使用这类记忆型AI,这些点要注意 一是使用 OpenClaw 时,要利用好本地文件可编辑的特点,定期整理 MEMORY.md,剔除无效信息,让AI的“个人特质”更精准;二是例如 MaxClaw 类的云端产品,数据存在厂商服务器,隐私敏感的内容不建议留存,避免信息泄露;三是不管用哪款工具,都要清楚各种小龙虾的记忆边界,重要的核心信息可以手动强化写入对应层级,确保小龙虾能准确调取,同时不要过度依赖小龙虾的记忆,关键决策还是要靠自己判断。
💬 下期预告 | 实操案例+可复制提示词 光懂原理还不够,下一期我会用「写书/个人知识管理」的真实场景,手把手教你如何给 OpenClaw 加固长期记忆,精准写入 MEMORY.md,还会分享可直接复制的提示词模板,让小龙虾真正记住你的身份、写作框架和使用偏好,再也不用反复解释需求~
与大家共勉,小龙虾的核心价值从来不是简单的工具调用,而是让他真正贴合我们的需求,而 OpenClaw 的本地记忆体系,就是让AI从“冰冷工具”变成“贴心且会成长的助手”的关键。
