目录
1.3视频生成技术的当下与未来

AnimateDiff:图像模型到视频模型的迁移
视频是由多张图片组成的,但逐帧生成的图片不能组成连贯的视频,因为一致性有问题。
如何解决?让输入文本更加详细。但这并不能彻底解决,因为自然语言不能完全描述一个图片
AD提供了motion modules,即运行模块这样一个结构,穿插在原来的UNet的模型结构之中。让帧与帧之间进行一些协同性的信息交互,从而提升一致性
直接做文生视频效果弱。但本身作为一个独立的插入模块,跟Controlnet和LoRA一样,可以共同启动。
Animatediff跟Controlnet结合,实现画风转绘,以及一些简单的编辑(修改人物衣服颜色)
模型架构
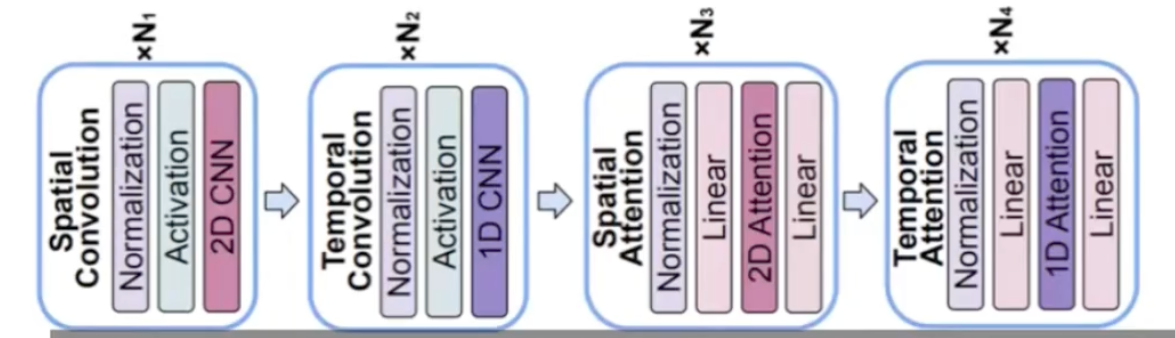
以ModelScopeT2V为例的主流视频生成架构
时空分离,空间可以简单理解为图像生成能力。时间就是把图像生成能力迁移到视频生成中的模块
空间模块来自于SD,即把SD的预训练权重继承了,时间模块是后续加入的类似adapter的形式。
优点:
图像生成能力被完整保留
计算效率高
缺点:
时空不分离的视频生成能力可能更好
长视频生成
短视频模型生成长视频,一个自然思路是:
先生成一个片段,然后用片段最后一帧作为下一段视频的首帧。就有误差累积问题
解决方法:
我们(论文Exvideo)近期提出了一种视频生成模型的扩展训练方法,通过在长视频上继续训练,可以拓展现有视频生成模型到更长的时间尺度上该模型可以在DiffSynth-Studio中使用。
把SVD模型中静态的Positional embedding改为动态的,同时这一部分变成了可训练的。加入了单位卷积。
实现了5倍的帧率提升。
未来猜测
Sora使用了时空一体的架构,虽然消耗更多的计算资源,但目前看效果更好,未来这种模型可能会成为zhu liu
cv46858652
分享至
投诉或建议
