
在视频生成领域,我们已经见证了从文字到视频的惊人跨越。然而,相比于“无中生有”,对现有视频进行精准的局部编辑(如在高速路上加一座塔,或移除草地上的黑猫)依然是一块难啃的硬骨头。现有的视频编辑模型大多依赖大规模的“成对数据”(即同一段视频修改前后的对比图),但这种数据在现实中极难获取,尤其是高质量的局部修改数据。
为了打破这一僵局,来自南京大学、中国科学院大学、腾讯微信和香港大学的研究团队提出了一种名为 NOVA 的全新框架。作者将该框架命名为 NOVA。“Nova”意为“新星”,象征着该方法为视频编辑领域带来的一道曙光;从技术内涵上看,它代表了稀疏控制(Sparse Control)与稠密合成(Dense Synthesis)的有机结合,旨在通过全新的解耦架构解决长久以来的视频局部编辑难题。
论文地址: https://arxiv.org/abs/2603.02802
代码仓库: https://github.com/WeChatCV/NovaEdit (已开源)
背景与动机:为什么局部编辑这么难?
目前的视频编辑主要面临两个痛点。首先是数据饥渴:合成逼真的“修改前-修改后”视频对非常困难,导致模型在处理局部添加或删除任务时,经常会出现视觉伪影。其次是首帧依赖的脆弱性:很多方法(如 AnyV2V)只修改第一帧,然后试图将这种修改“传播”到后续帧。但在镜头剧烈晃动或物体大幅度运动时,这种传播极易失效,导致修改后的物体“漂移”或者背景变得模糊。
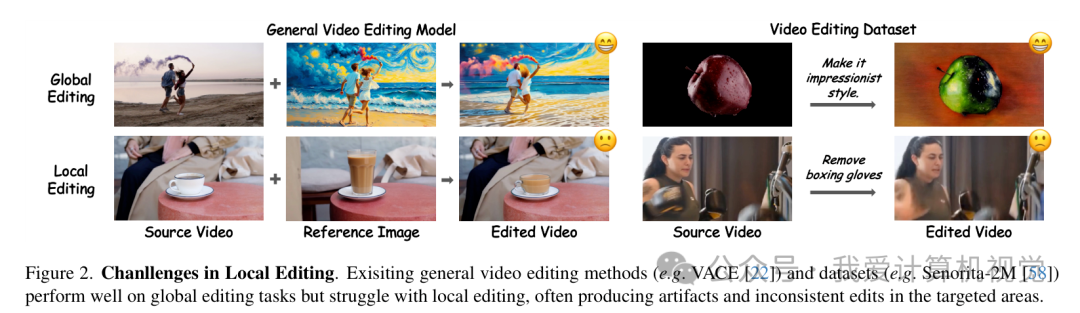
现有通用视频编辑方法在全局任务上表现尚可,但在局部编辑(如移除拳击手套)时容易产生伪影和不一致。
研究团队观察到,现有的视频编辑模型在处理全局风格转换时游刃有余,但在面对局部编辑(Local Editing)时却显得力不从心。正如上图所示,当试图移除视频中的某个特定物体时,背景往往会发生扭曲,或者留下明显的修补痕迹。
此外,如果简单地采用多关键帧引导而没有有效的保真机制,非关键帧区域的背景会出现严重的纹理不一致和不合理的运动。这是因为模型在缺乏原始视频参考的情况下,会根据关键帧的语义信息自行“幻觉”出中间内容。
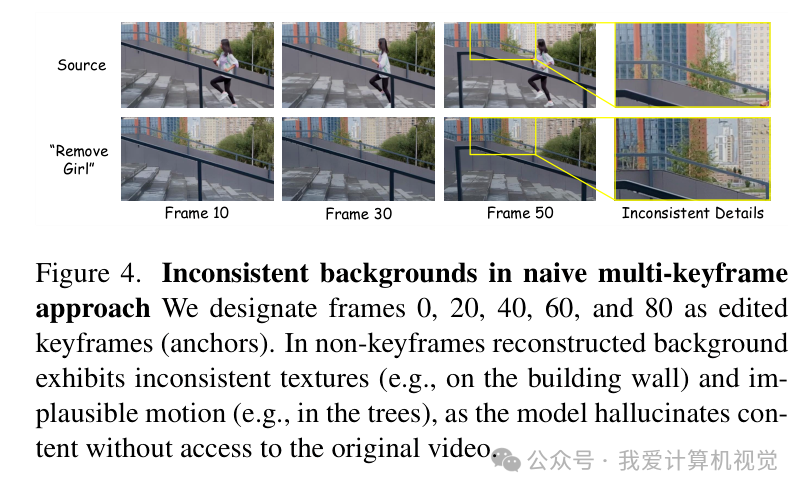
在缺乏原始视频参考的情况下,多关键帧引导会导致背景纹理(如墙壁)和运动(如树木)出现不一致。
NOVA 的核心思想:解耦控制与合成
NOVA 的研究团队意识到,视频编辑本质上是两个任务的结合:“变什么”(语义控制)和**“留什么”**(保真度合成)。为了解决这个问题,NOVA 采用了独特的双分支架构,将这两个信号彻底解耦。
双分支架构设计
NOVA 的核心是一个基于 扩散 Transformer(Diffusion Transformer, DiT) 的生成器,它通过两个辅助分支获取信息:
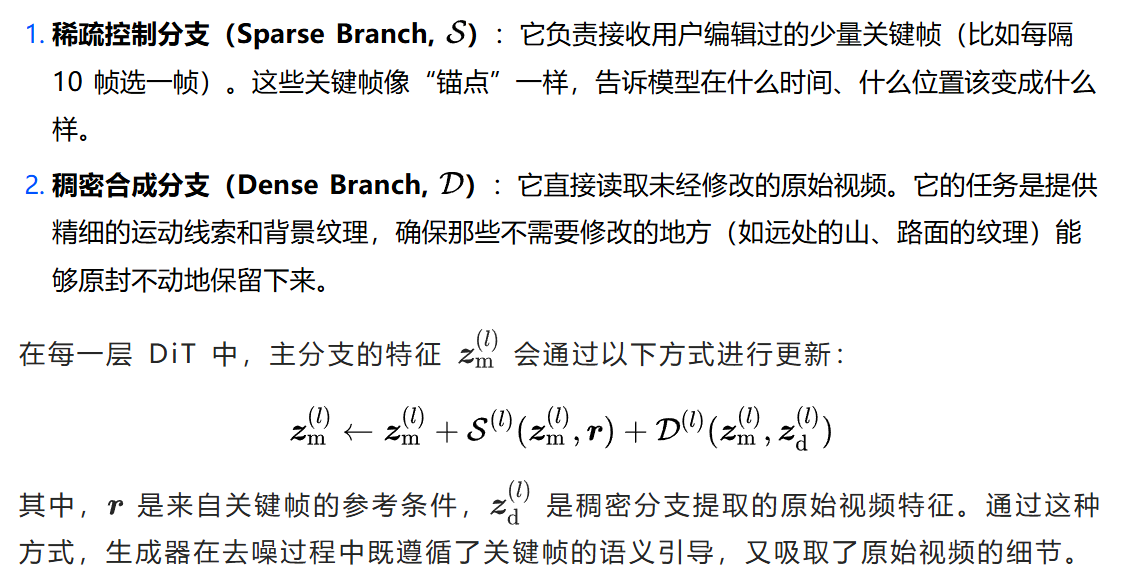
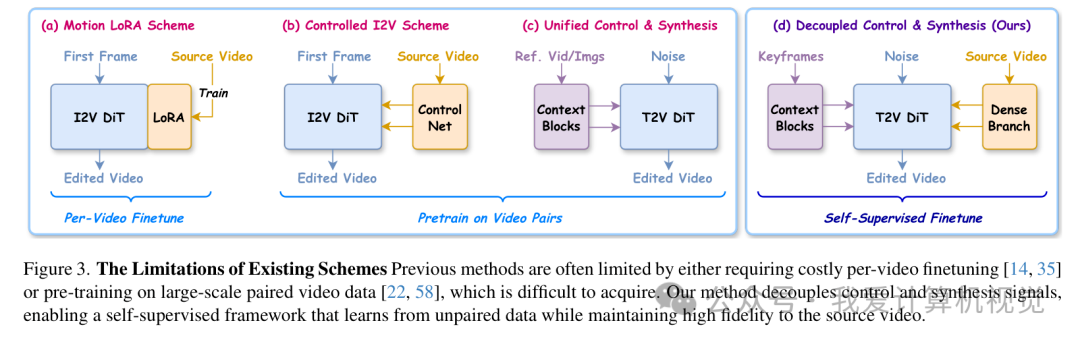
NOVA 的双分支架构与现有方案的对比。NOVA 通过解耦信号,实现了在无成对数据下的自监督学习。
巧妙的训练策略:退化模拟
既然没有成对数据,NOVA 是如何学会编辑的呢?答案是自监督学习(Self-Supervised Learning, SSL)。研究者设计了一套“退化模拟”训练流水线,让模型在单段视频上自己玩“找茬”。
1. 锚定控制流水线(Anchored Control Pipe)
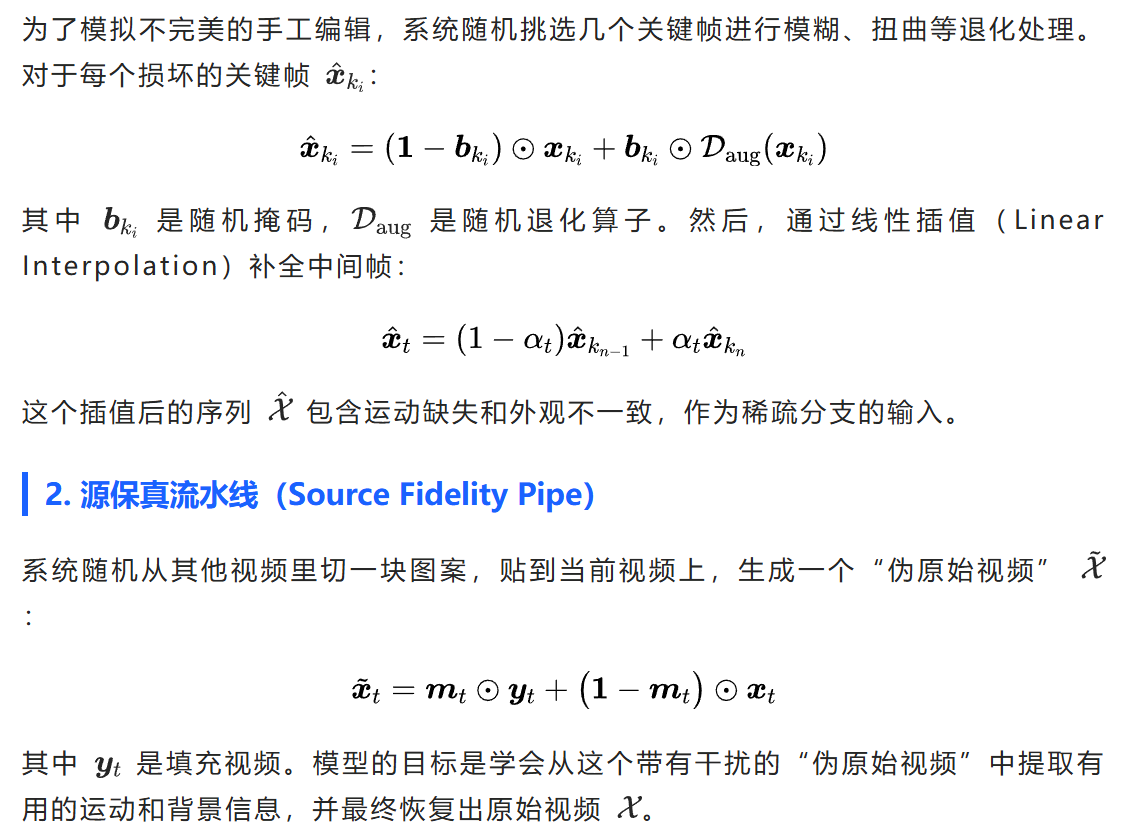
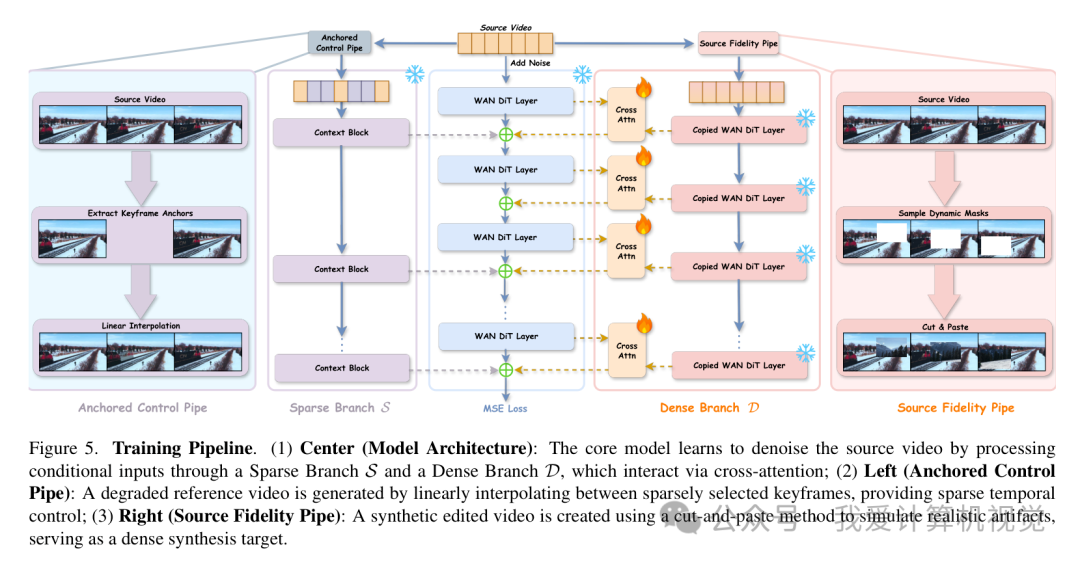
NOVA 的训练流程图。左侧模拟编辑痕迹,右侧模拟原始视频参考,中间的主分支负责最终的去噪合成。
这种“以毒攻毒”的策略,让 NOVA 彻底摆脱了对昂贵成对数据的依赖。训练的目标函数就是标准的去噪损失:
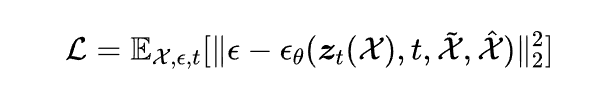
推理过程:一致性感知编辑
在实际推理时,NOVA 的工作流程也非常优雅。首先,它会利用现有的图像编辑模型(如 FLUX.1 Kontext)对用户选定的关键帧进行修改。
为了防止不同关键帧之间出现风格跳变,NOVA 引入了一致性感知关键帧编辑(Consistency-Aware Keyframe Editing):除了第一帧外,后续的关键帧在修改时都会参考第一帧的编辑结果。接着,这些编辑好的关键帧会被插值成一个参考序列喂给稀疏分支,而原始视频则喂给稠密分支。
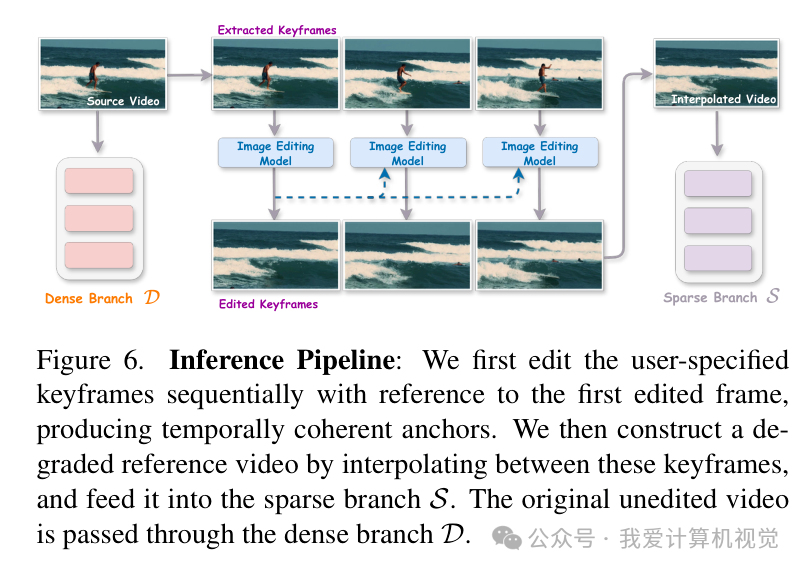
NOVA 的推理流程。通过顺序编辑关键帧并结合双分支输入,生成时间上连贯的修改视频。
实验结果:稳健的局部编辑表现
研究团队在 5,000 段高分辨率(832x480)视频上训练了模型,并与 AnyV2V、I2VEdit、VACE 等一众强手进行了对比。
定量评估
在多项指标上,NOVA 都展现出了极强的统治力:
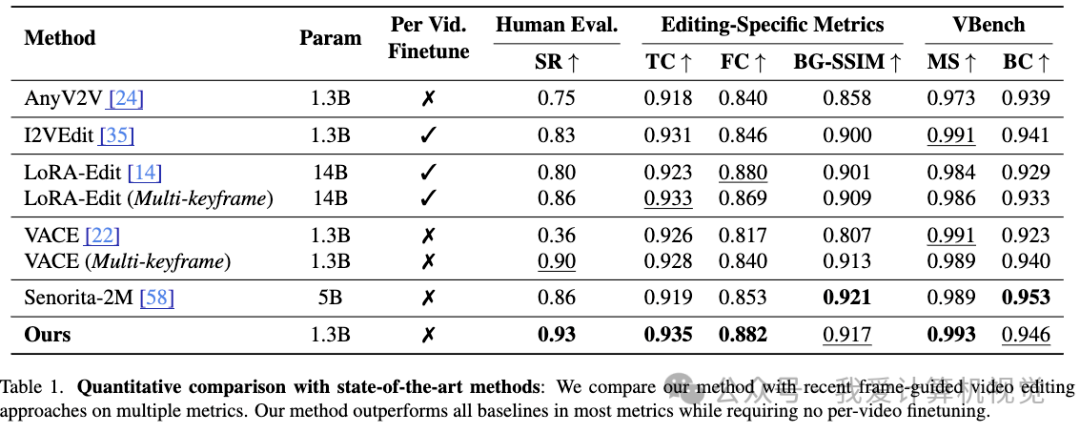
定量对比
成功率(Success Rate, SR):NOVA 达到了 0.93,远超 AnyV2V 的 0.75。
背景保真度(BG-SSIM):在保持背景不失真方面表现卓越,即便在复杂的物体移除任务中,也能完美填补背景。
运动平滑度(Motion Smoothness, MS):在 VBench 测试中获得了 0.993 的高分。
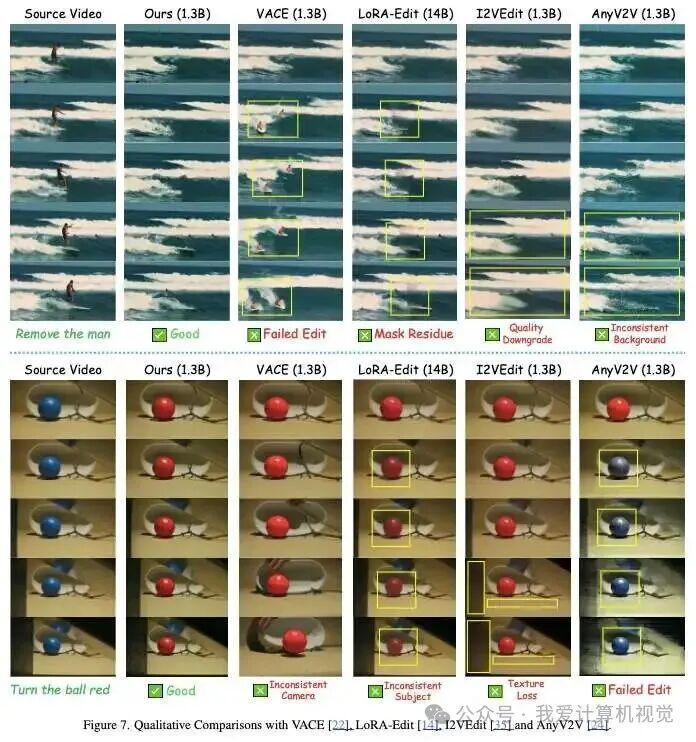
定性对比显示,NOVA 在移除人物、改变球体颜色等任务中,背景保存最完整,且没有明显的伪影。
消融实验的洞察
消融实验揭示了稠密分支的重要性。如下图所示,即便给稠密分支输入模糊的原始视频,模型依然能恢复出锐利的细节。这说明稠密分支不仅仅是在“复制粘贴”,而是在进行一种受引导的生成式重建。
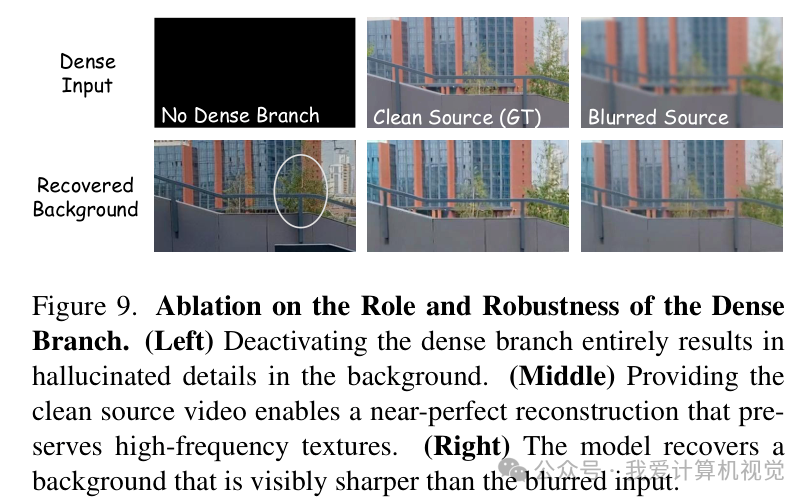
消融实验证明,稠密分支对于捕捉背景细节、提升 CLIP 相似度至关重要。
此外,研究者还测试了关键帧间隔的影响。虽然模型是在间隔为 10 帧的情况下训练的,但在推理时,即便将间隔拉大到 20 帧,模型依然能保持良好的鲁棒性,这证明了其强大的泛化能力。
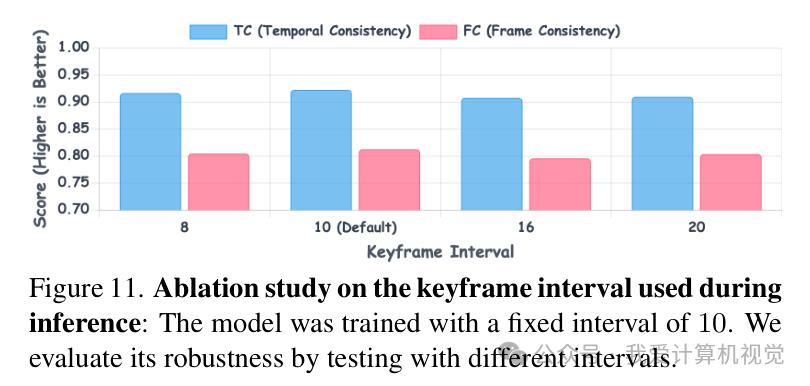
关键帧间隔消融实验显示,模型对不同密度的引导信号具有很强的适应性。
写在最后
NOVA 的出现为视频编辑提供了一个非常有启发性的思路:解耦。通过将语义控制与细节合成拆分开来,我们不仅降低了对数据的要求,还提升了模型处理复杂运动的能力。这种基于自监督学习的“退化模拟”训练范式,也为解决视频领域数据匮乏问题提供了新的模板。
虽然 NOVA 的最终效果仍部分取决于底层图像编辑模型的质量,但它所构筑的这套“稀疏控制+稠密合成”的框架,无疑为未来的高质量、高效率视频创作铺平了道路。目前该项目已经在 GitHub 开源,推荐感兴趣的开发者尝试。
入群加好友(v:xiao-ma-baoli),请备注你感兴趣的技术方向
