
Soul App AI 团队提出 SoulX-FlashHead:1.3B 参数实现“无限流”实时数字人,4090 跑出 96 FPS!
在实时音视频互动、虚拟直播等场景中,让照片“开口说话”且保持长时间稳定,一直是技术圈的一块“硬骨头”。现有的超大模型虽然效果惊艳,但动辄几十亿甚至上百亿的参数量,让消费级显卡望而却步;而轻量化模型又往往在面部细节和长视频稳定性上“掉链子”。
近日,来自 Soul App AI 团队(Soul AI Lab)的研究团队发布了名为 SoulX-FlashHead 的技术报告。该模型被命名为 “SoulX-FlashHead”,其中 “SoulX” 是团队的技术系列代号,“FlashHead” 则寓意其如闪电般迅捷(Flash)的流式数字人生成能力。凭借对 1.3B 模型的一系列优化,就在单张 NVIDIA RTX 4090 上跑出了 96 FPS 的惊人速度,同时支持无限长度的流式生成,真正做到了高保真与低延迟的平衡。
论文地址: https://arxiv.org/abs/2602.07449
项目主页: https://soul-ailab.github.io/soulx-flashhead
代码仓库: https://github.com/soul-ailab/soulx-flashhead (已开源)
数据集仓库: https://huggingface.co/datasets/Soul-AILab/VividHead
模型仓库: https://huggingface.co/Soul-AILab/SoulX-FlashHead-1_3B
为什么实时数字人这么难?
要实现一个完美的流式数字人,通常要跨越三座大山:
音频特征的不稳定:在流式场景下,系统通常只能拿到极短的音频片段(比如 1.32 秒)。传统的音频模型在处理这种“断头断尾”的短音频时,特征容易发生畸变,导致口型对不上。
长序列的误差累积:流式生成本质上是自回归的过程,即“用上一秒生成的脸作为参考来画下一秒”。如果模型稍微出点错,误差就会像滚雪球一样放大,导致几分钟后人脸就开始“崩坏”或者身份漂移。
算力与质量的博弈:要在消费级显卡上实时运行,模型必须足够轻量,但轻量化往往意味着细节丢失。
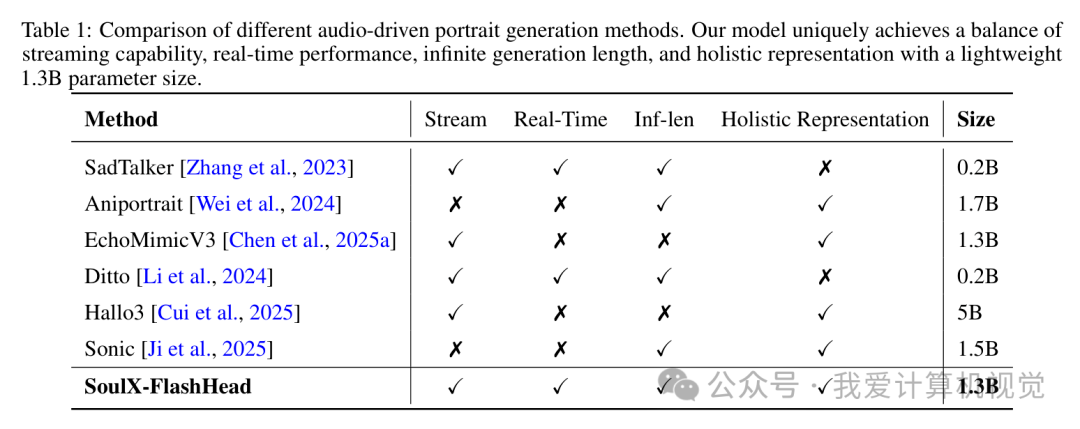
主流方法对比
如上表所示,SoulX-FlashHead 在保持 1.3B 轻量化规模的同时,唯一实现了流式(Stream)、实时(Real-Time)、无限长度(Inf-len)和整体像素级表示(Holistic Representation)的统一。
核心武器一:782 小时的高质量“养料”
俗话说“巧妇难为无米之炊”,研究团队首先构建了一个名为 VividHead 的大规模高质量数据集。
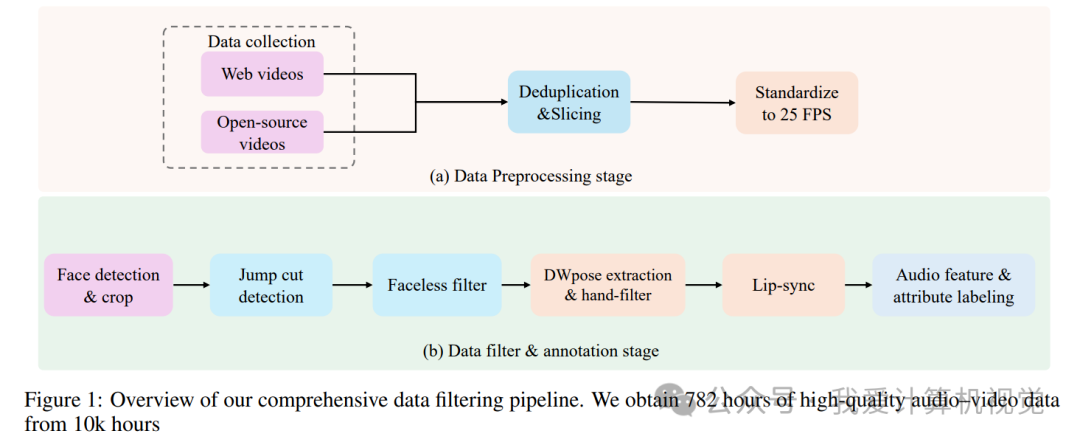
数据处理流程
他们从 1 万小时的原始视频中,通过极其严格的清洗流程(包括人脸检测、光流分析、手部遮挡过滤、口型同步评分等),精选出 782 小时、33 万个高质量片段。
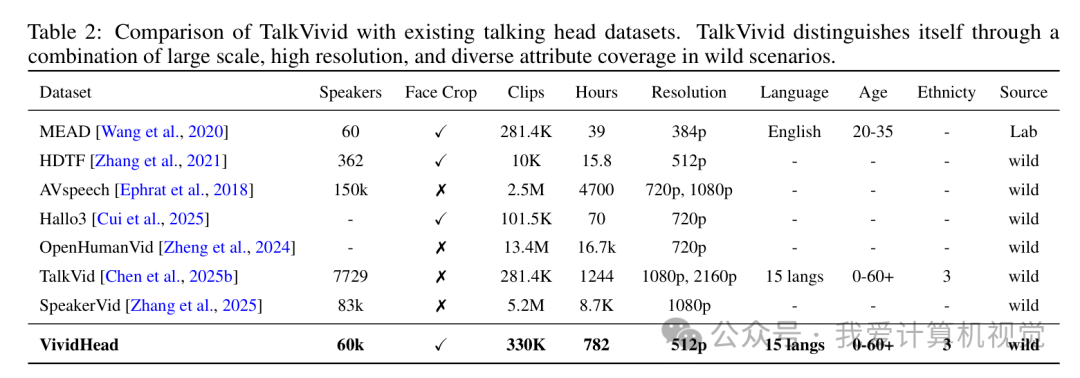
数据集对比
相比于传统的实验室数据集(如 MEAD),VividHead 涵盖了 15 种语言、多种族和全年龄段,且分辨率统一达到了 512p。这种“野外”数据的多样性,是模型能够应对复杂背景和不同光影的关键。
核心武器二:两阶段“进化”策略
SoulX-FlashHead 的架构基于 1.3B 参数的扩散 Transformer(Diffusion Transformer, DiT)。为了解决前文提到的挑战,团队设计了两步走的训练方案。
第一阶段:流式感知时空预训练
为了让模型适应短音频输入,团队引入了时间音频上下文缓存(Temporal Audio Context Cache)机制。
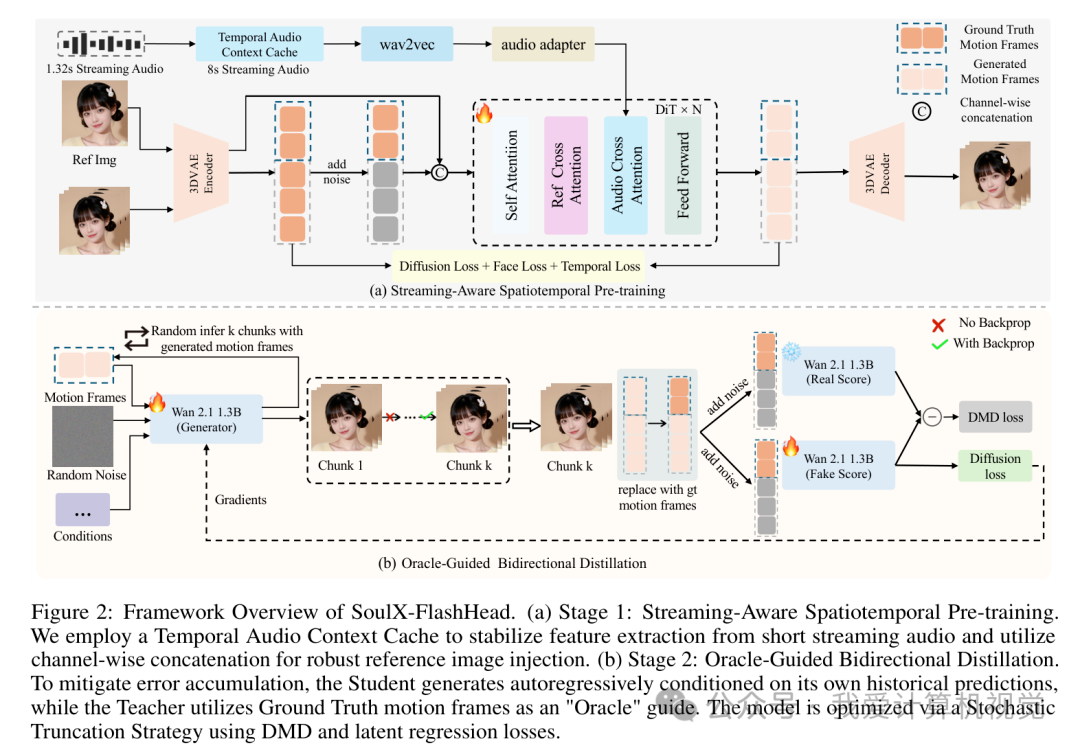
框架概览
如上图 (a) 所示,系统会维护一个 8 秒的音频窗口。即使当前输入的只有 1.32 秒,模型也会结合历史缓存的音频特征进行编码,确保音频特征的稳定性。
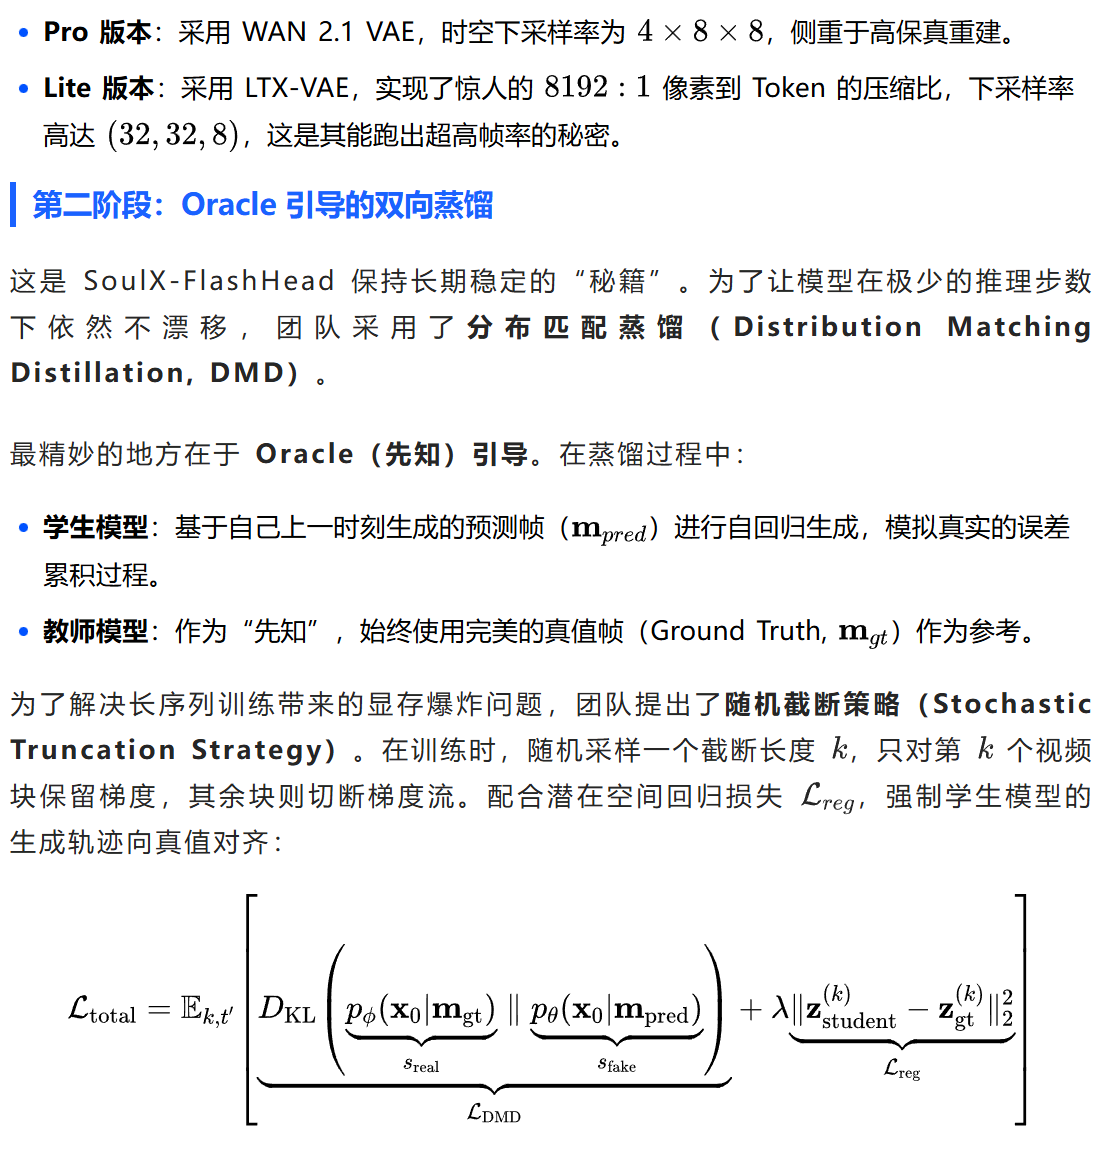
此外,该阶段还涉及了 3D-VAE 的选择。为了平衡质量与速度,团队提供了两个版本:
性能爆表:4090 上的 96 FPS 奇迹
在实验部分,SoulX-FlashHead 展现出了极强的统治力。研究团队在 HDTF 和 VFHQ 两个主流基准测试中进行了评估。
定量评估
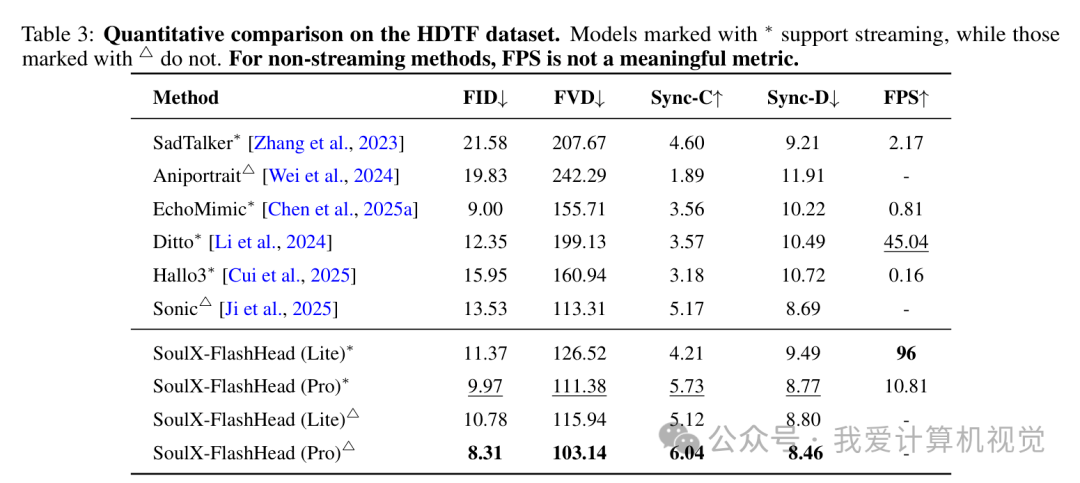
HDTF 实验结果
推理速度:Lite 版本在单张 RTX 4090 上达到了 96 FPS,这意味着它其具备极高的实时处理能力。
口型同步:在 VFHQ 数据集上,Pro 版本的 Sync-C 得分达到 5.53,显著超过了传统的 SadTalker (4.49) 和最近的 Sonic (4.64)。
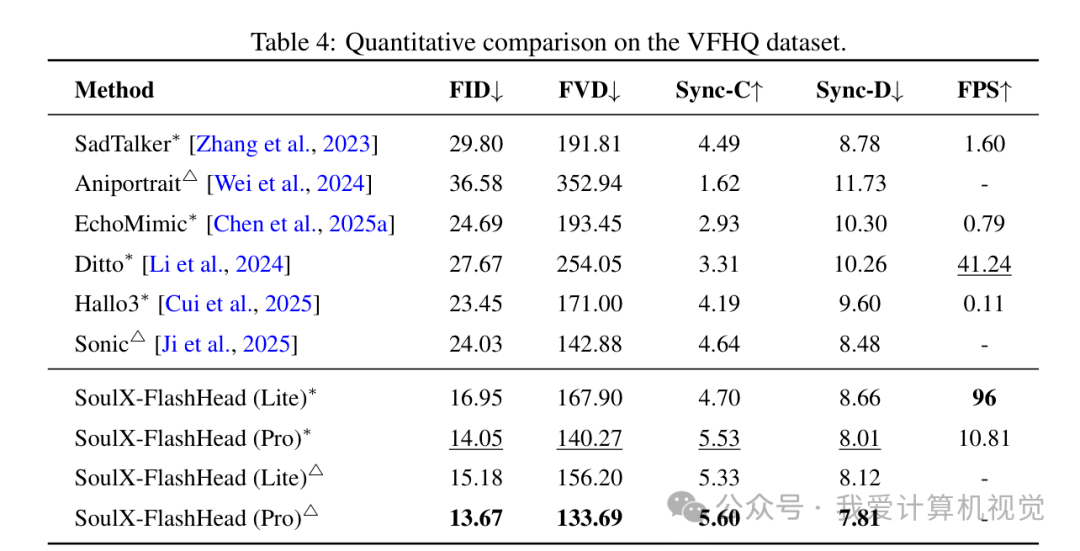
VFHQ 实验结果
定性对比
在长达 60 秒的视频生成测试中,SoulX-FlashHead 的优势更加直观。
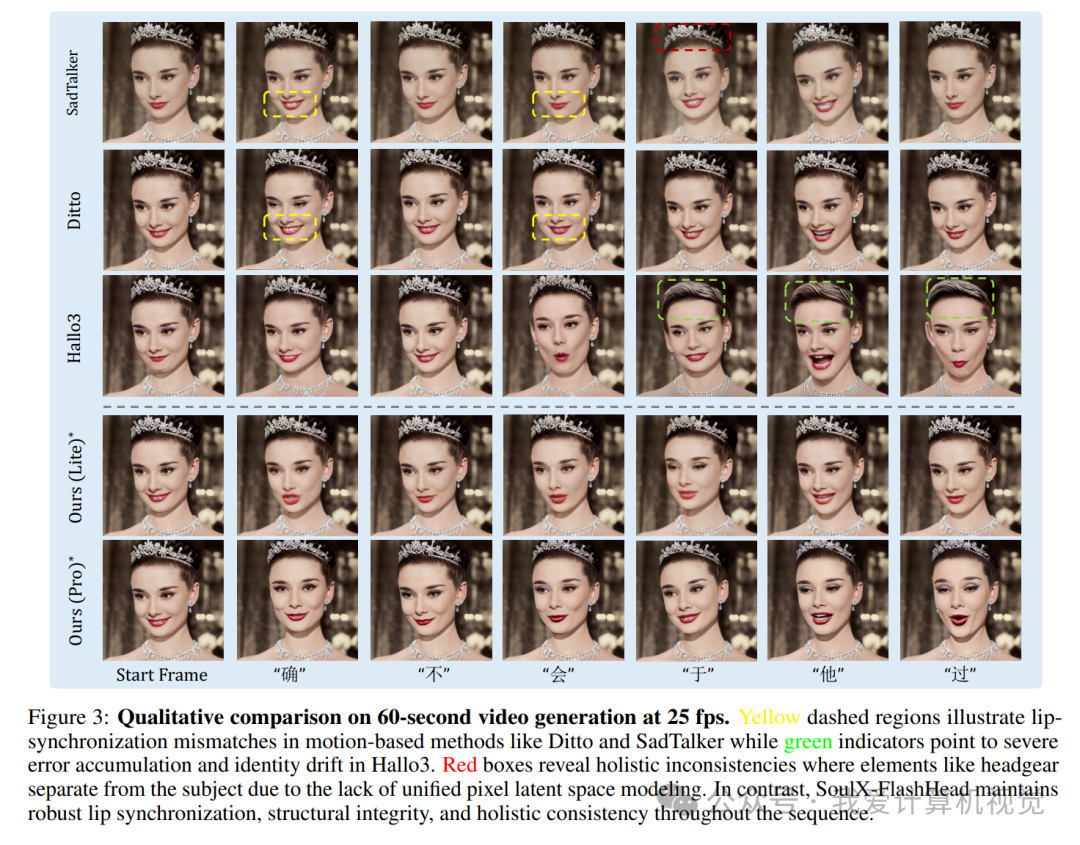
定性对比图
从图中可以看到:
黄色虚线区:Ditto 等方法在长时间生成后出现了明显的口型脱节。
绿色指示器:Hallo3 在长序列中出现了严重的身份漂移和伪影。
红色框:SadTalker 因为缺乏统一的像素潜在空间建模,导致头饰等附件与头部发生分离。
我们的方法:始终保持了稳健的口型同步、结构完整性和身份一致性。
开源与实践指引
目前,SoulX-FlashHead 的代码和数据集均已在 GitHub 和 Hugging Face 上开源。
硬件建议:
如果你追求极致的交互速度,Lite 版本是首选,单张 RTX 4090 即可轻松驾驭。
如果你需要电影级的面部细节,Pro 版本建议配置双 RTX 5090 以获得最佳体验。
代码亮点:仓库集成了 xDiT 的混合序列并行技术(Hybrid Sequence Parallelism)和 FlashAttention-2,充分压榨了 Ada Lovelace 架构显卡的性能。
写在最后
SoulX-FlashHead 的出现,标志着 1B 规模的轻量化模型在经过精细的蒸馏和数据打磨后,完全有能力在特定任务上挑战甚至超越更大规模的模型。它不仅解决了“动起来”的问题,更解决了“一直动且不崩”的问题。
当然,目前的局限在于参数量限制了模型对复杂物理动力学的理解,目前主要集中在面部和头部区域,对于大幅度的肢体动作仍有提升空间。但对于直播、社交等场景,这已经是一个非常成熟且高效的方案。
如果你正在寻找一个高性能、可商用的流式数字人方案,SoulX-FlashHead 绝对值得一试。
入群加好友(v:xiao-ma-baoli),请备注你感兴趣的技术方向
