
在人工智能生成内容(AIGC)的浪潮中,人体生成始终是最具挑战性也最吸引人的领域。无论是栩栩如生的数字替身,还是无缝衔接的虚拟试穿,其背后的技术演进正深刻改变着我们的数字生活。近日,来自香港科技大学、南京大学、中国科学院自动化研究所、新加坡南洋理工大学以及美国北卡罗来纳大学教堂山分校的研究者们共同发布了一篇重磅综述。
这篇论文系统梳理了基于扩散模型的以人为中心的内容生成(Human-Centric Content Generation)技术。作者将其定义为:以人类的面部、身体及其行为为核心主体的内容创作过程。这不仅要求视觉上的高保真度,更涉及身份保持、精细控制、时空一致性等多个维度的极高要求。
论文地址: https://doi.org/10.36227/techrxiv.177138906.63173113/v1
项目主页: https://github.com/Songlin1998/awesome-diffusion-human-centric
背景与动机:为什么人体生成是 AIGC 的“珠峰”?
相比于生成一张猫或狗的图片,生成“人”的要求要苛刻得多。我们对同类的形象极其敏感,任何细微的比例失调或纹理瑕疵都会引发恐怖谷效应(Uncanny Valley Effect)。
作者总结了人体生成的四大核心挑战:
准确性(Accuracy):必须精准嵌入身份特征,保持解剖学上的合理性,例如手指的数量和关节的转动。
可控性(Controllability):需要支持文本、音频、参考图、姿态等多种模态的精细控制,且实现属性解耦。
一致性(Consistency):在视频生成中,要保证身份不随时间漂移,且在不同视角下保持连贯。
泛化性(Generalization):模型要能处理各种艺术风格、极端光照和复杂的开放世界场景。
扩散模型(Diffusion Models)的出现为解决这些问题提供了强大的数学框架。它通过概率去噪的过程,将生成任务转化为稳定的随机优化问题,展现出了比 GAN 更好的模式覆盖能力和条件控制灵活性。
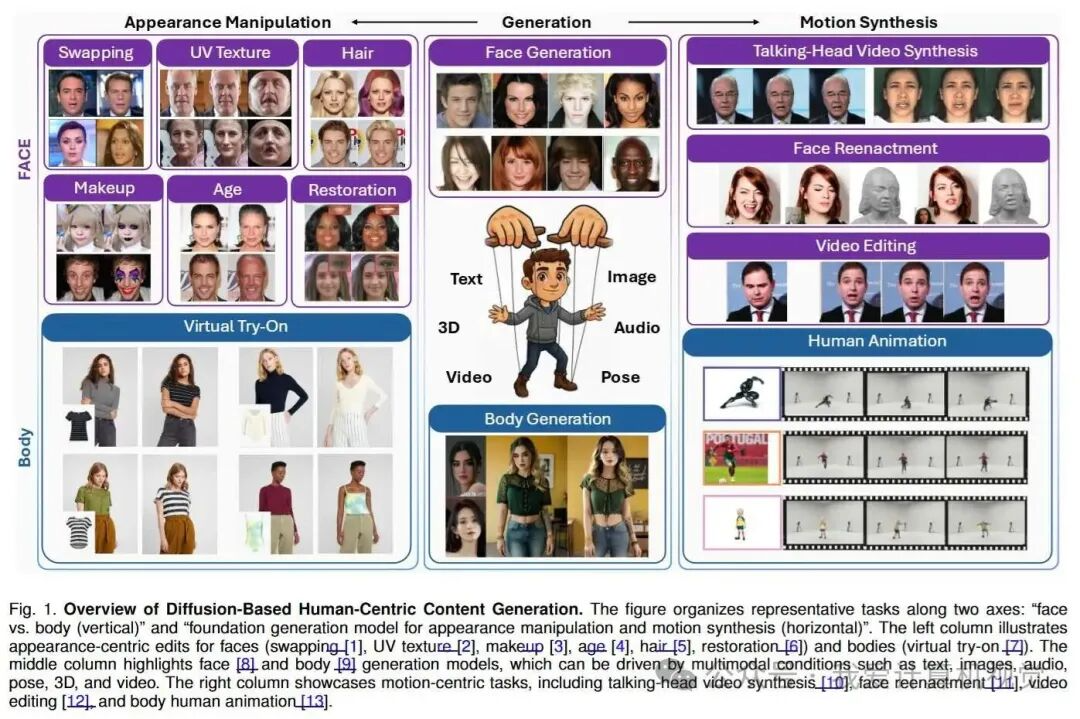
图 1 展示了以人为中心的内容生成任务全景图,按面部 vs 身体(纵轴)和外观操纵 vs 运动合成(横轴)进行组织。
技术基石:从数学公式到人体表示
在深入具体任务之前,我们有必要了解扩散模型的核心机制。
扩散模型与流匹配
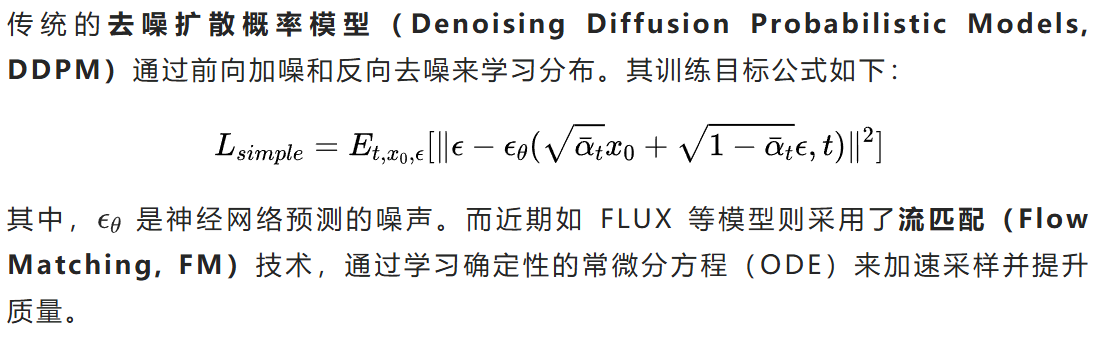
人体表示:给模型一把“尺子”
为了实现精细控制,模型需要理解人体的结构。
面部表示:包括基于主成分分析的 3D 可变形模型(3D Morphable Models, 3DMM)、稀疏或稠密的关键点(Landmarks),以及用于捕捉精细纹理的 UV 贴图。
身体表示:常用的有 2D/3D 姿态骨架、多人线性模型(Skinned Multi-Person Linear Model, SMPL) 提供的 3D 网格,以及 DensePose 提供的像素级表面映射。
方法详解:适配器如何注入“灵魂”?
扩散模型的核心在于其去噪过程。为了实现对人体的精准控制,研究者们通常在预训练模型(如 Stable Diffusion 或 FLUX)的基础上引入“适配器(Adapters)”。
输入与输出流程
在人体生成中,输入通常包含:(1) 初始噪声图;(2) 文本提示词;(3) 条件信号(如参考人脸图、骨架图或音频)。输出则是迭代去噪后的高质量图像或视频序列。
三大适配器家族
论文在图 2 中详细展示了条件信号如何注入去噪过程:
嵌入适配器(Embedding Adapters):如 Textual Inversion,将参考条件映射到文本嵌入空间,简单但表达力有限。
注意力适配器(Attention Adapters):通过修改或增强交叉注意力层(Cross-Attention)来注入信息,代表作是 IP-Adapter。
块级适配器(Block Adapters):在 U-Net 或 Transformer 块级别附加可训练的分支,最典型的代表是 ControlNet。
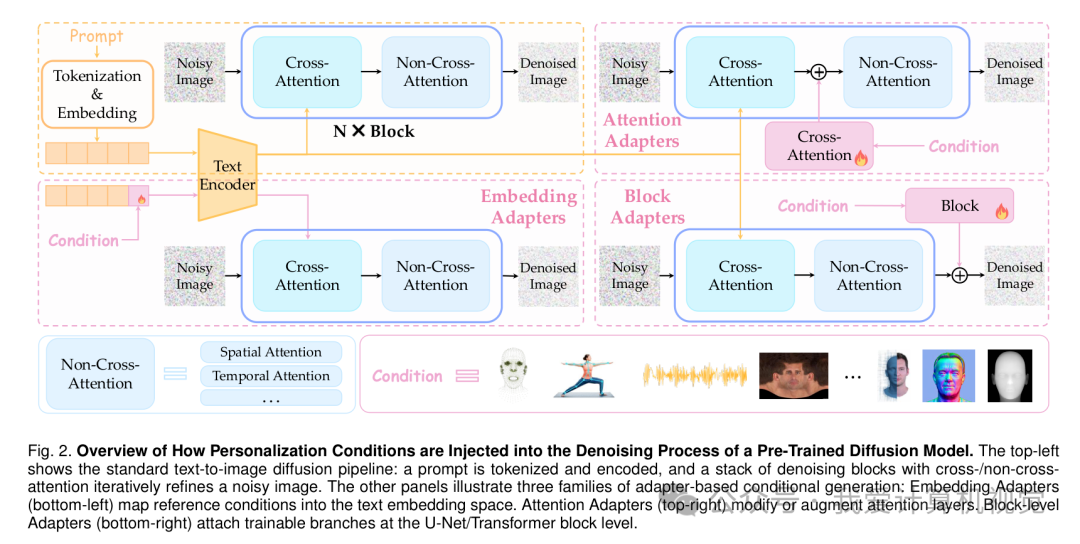
图 2 概述了如何将个性化条件注入预训练扩散模型的去噪过程,包括嵌入、注意力和块级三种适配器。
范式对比:专才 vs 通才
论文对比了两种主流范式:
从零训练扩散模型(From-Scratch Diffusion):作者将其比喻为“专才(Specialist)”。由于在特定领域数据集上训练,它们在准确性和一致性上表现卓越,但泛化到新场景的能力较弱。
预训练扩散适配(Pre-Trained Diffusion Adaptation):被视为“通才(Generalist)”。通过在强大的底座模型上添加适配器,它们继承了海量的互联网先验知识,能够生成任意风格、任意背景的内容。
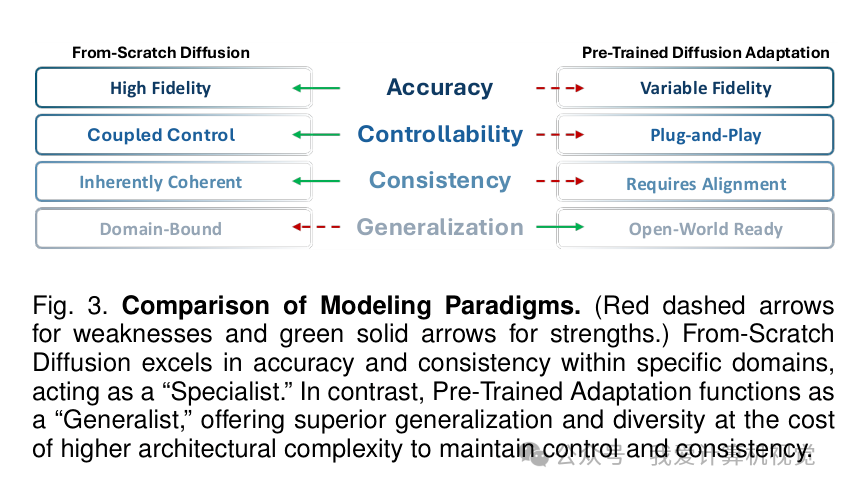
图 3 对比了从零训练与预训练适配两种范式的优劣,前者是特定领域的“专家”,后者是开放世界的“通才”。
任务全景:从面部细节到全身动态
综述将任务细分为面部和人体两大板块,每个板块又分为外观编辑和运动合成。
1. 面部生成与动画
外观编辑:涵盖了换脸(Face Swapping)、妆容迁移(Makeup Transfer)和年龄变换。例如,Arc2Face 仅通过 ArcFace 嵌入就能生成高度一致的 ID 图像。
面部动画:重点在于语音驱动的说话头(Talking-Head)和面部重演(Reenactment)。VASA-1 和 EMO 等模型已经能实现实时的、极具情感表现力的面部视频合成。
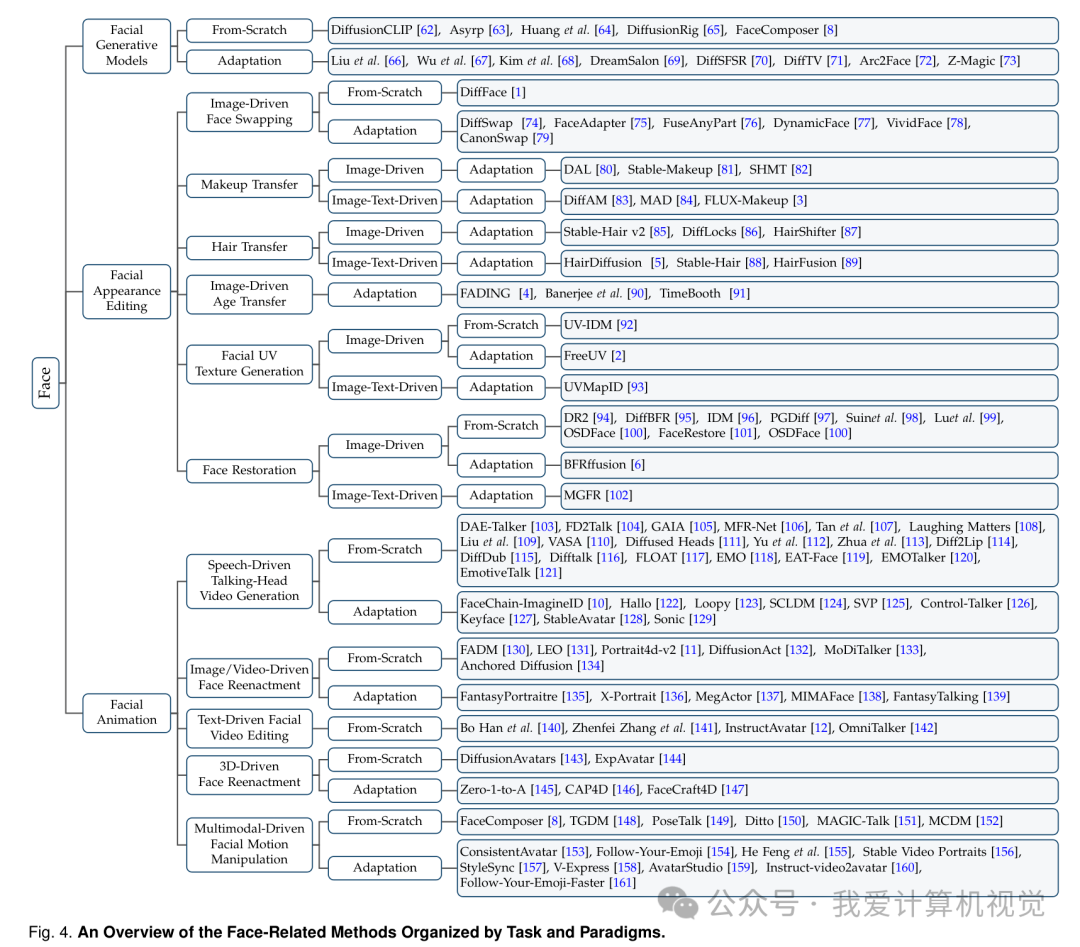
图 4 梳理了面部相关的方法,按任务(如换脸、妆容、动画)和研究范式进行分类。
2. 人体生成与试穿
个性化生成:如 DreamBooth 和 PhotoMaker,允许用户通过少量照片训练出属于自己的数字分身。
虚拟试穿(Virtual Try-On):这是商业化潜力巨大的方向。模型如 OutfitAnyone 需要将服装精确“穿”在不同姿态的人体上,同时保持衣物的物理褶皱和光影。
人体动画:通过姿态序列或文本驱动动作。Animate Anyone 在保持时序一致性方面取得了显著突破。
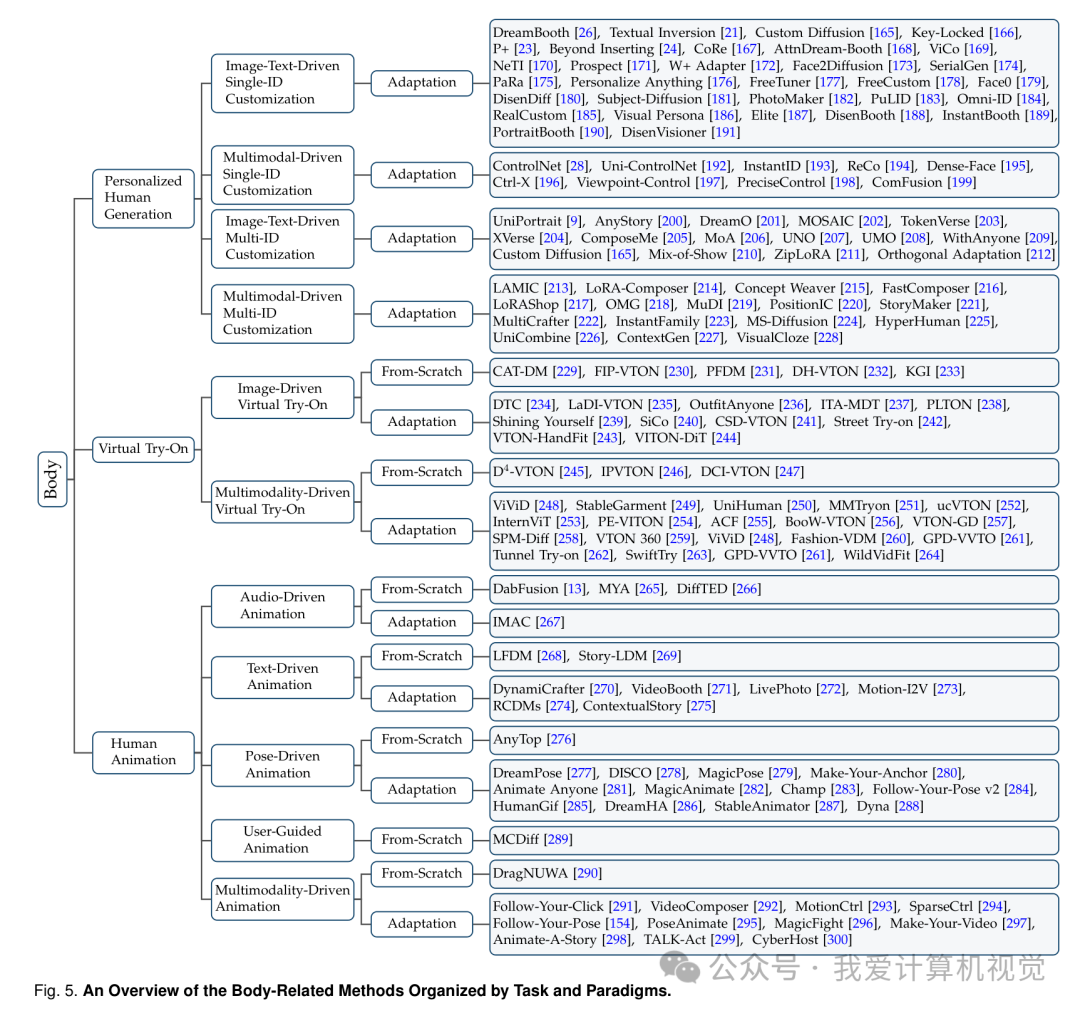
图 5 展示了人体相关的方法,涵盖了个性化生成、虚拟试穿和人体动画等领域。
数据集与评估:规模决定上限
高质量的数据是人体生成的基石。综述详细列举了多个维度的数据库,这对于研究者来说是一份极其宝贵的资源清单。
面部数据:如 Voxceleb2 包含超过 100 万个视频片段,是训练说话头模型的常用选择。
虚拟试穿:LH-400K 提供了 40 万规模的图像-文本对。
人体动画:WebVid-10M 拥有 1070 万个视频,为大规模预训练提供了可能。
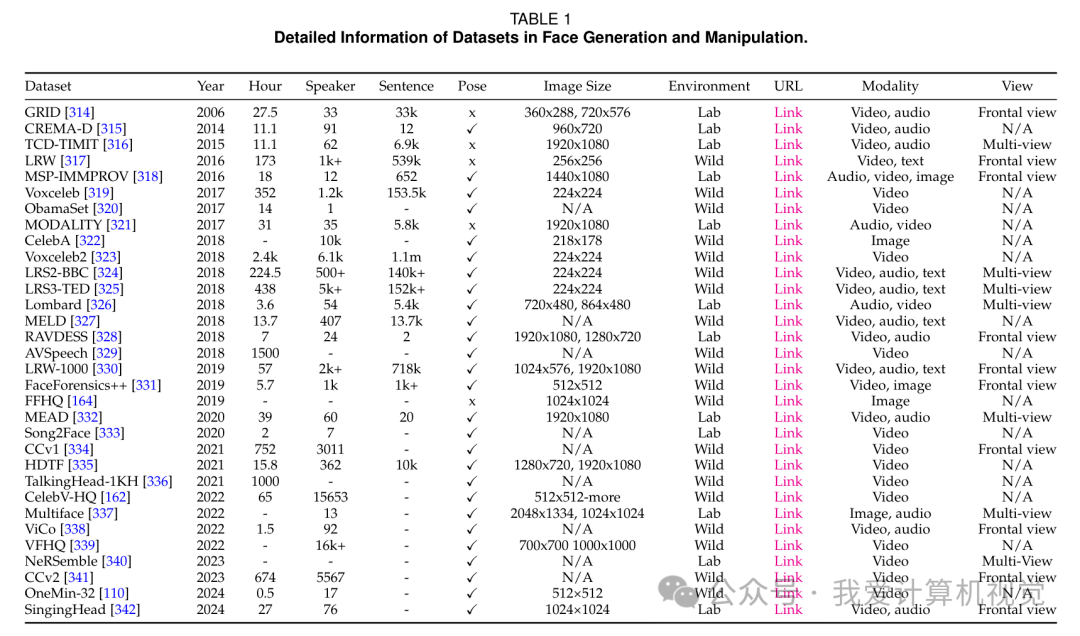
表 1 总结了面部生成与操纵领域的主流数据集。
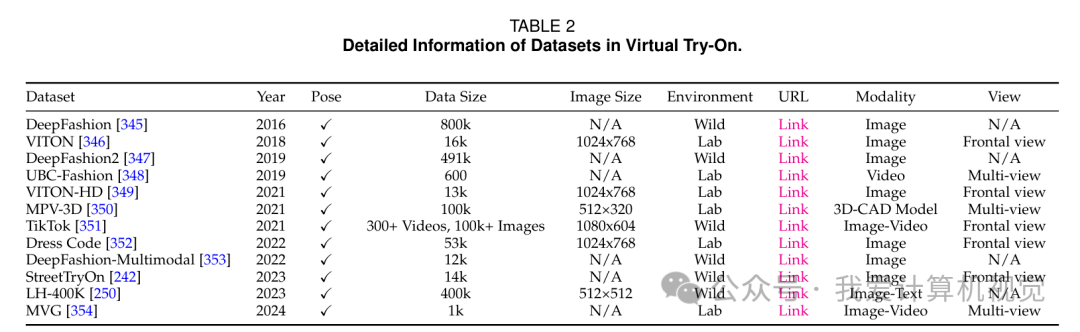
表 2 展示了虚拟试穿领域的数据集详情,标注了数据规模和视角信息。
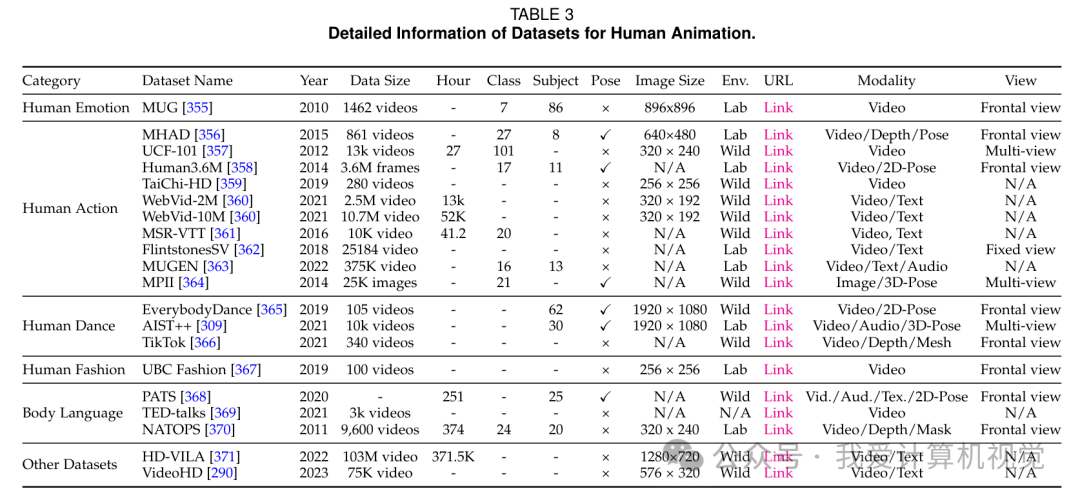
表 3 详细列出了用于人体动画训练的各类数据集,包括情感、动作、舞蹈等。
写在最后:迈向“全能人类生成”
这篇综述不仅是对过去几年技术爆发的总结,更指明了未来的方向。作者提出的 “全能人类(Omni-Human)” 愿景非常令人振奋:未来的模型将不再是修修补补的适配器组合,而是一个能够在统一潜空间内理解整个人体解剖学、物理学和情感表达的智能体。
目前,我们依然面临着超长视频身份漂移、手部细节扭曲以及生成内容的伦理隐私等挑战。但随着 Transformer 架构与扩散模型的进一步融合,以及物理仿真数据的引入,这些问题正被逐一攻克。
入群加好友(v:xiao-ma-baoli),请备注你感兴趣的技术方向
