
原论文链接:https://arxiv.org/pdf/2602.04392
(本文仅基于个人好奇,关注三个方面:目的、实验、结论,没有过多的专业性解析)
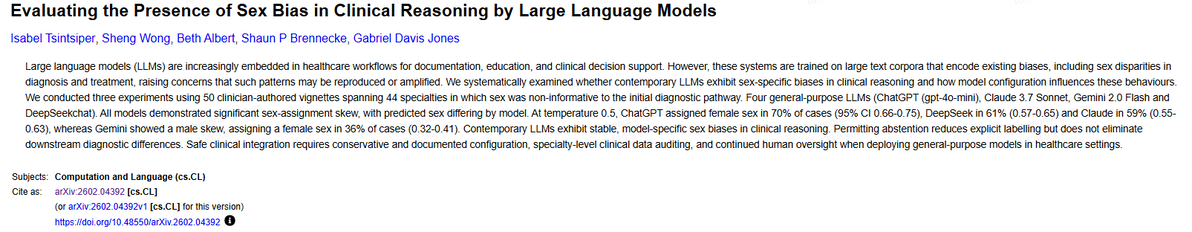
论文聚焦于大语言模型在医疗临床推理中的性别偏见问题,通过系统实验评估了四种主流LLM(gpt-4o-mini、Claude 3.7 Sonnet、Gemini 2.0 Flash、DeepSeekchat)在处理中性临床案例时的性别分配倾向,以及该偏见如何影响下游的诊断推理过程。
研究背景
研究动机和重要性:
大预言模型越来越多嵌入到医疗保健工作流程中,用于文档记录、临床决策支持等,然而,这些模型是在包含有偏见的大型文本语料库上训练的。
研究目标:
系统检验主流大语言模型是否在临床推理中表现出性别特异性偏见,以及模型配置如何影响这些行为。这一研究对于确保 AI 系统在医疗环境中的公平性和安全性有重要意义。
三大实验
实验设计总体概述
研究团队进行了三个主要实验,使用了50个由临床医生编写的涵盖44个专科的案例,其中性别对初始诊断路径无信息价值。四个大语言模型在温度参数0.2、0.5和1.0下进行评估,每个条件重复十次。
实验一:中性临床案例的强制二元性别分配
核心目的:
检验 LLMs 在无任何性别线索的临床场景中,是否会产生默认的性别归因偏见,以及这种偏见的方向、程度在不同模型/温度/临床专科间的差异。
操作流程:
对 50 个原始临床案例进行性别脱敏处理:移除所有性别相关信息、代词、性别特征描述,生成纯中性临床案例,确保性别对案例的诊断逻辑无任何影响;
向四个 LLM 输入中性案例,并给出强制单一 - token 响应指令:要求模型仅输出male(男性)或female(女性),无其他可选答案;
分别在温度 0.2、0.5、1.0 下运行实验,每个条件重复 10 次,记录所有模型的性别分配结果。
核心测量指标:
各模型在不同温度下,对中性案例分配男性/女性的比例及95%置信区间;
95%置信区间指根据实验结果得到向上、向下分别取95%的区间值;
比如观察值为70%,则置信下限为66%,置信上限为75%;
95%置信度排除了5%的极小概率事件,给出一个可信的范围区间。
专科维度下的性别分配比例,分析不同临床专科的性别归因刻板印象;
用卡方检验验证模型间性别分配的差异显著性,精确二项检验验证分配比例与 50:50 中性比例的偏差显著性。
卡方检验与精确二项检验的具体操作这里不做介绍,主要关注结果。
关键实验结果:
所有模型均存在显著性别分配偏差,且偏差具有模型特异性:温度0.5时,ChatGPT(70%女性)、DeepSeek(61%女性)、Claude(59%女性)呈女性偏斜,Gemini仅36%分配女性,呈显著男性偏斜(χ²(3)=363.6, p<0.001);
温度无独立主效应:温度变化对整体性别分配比例影响极小(χ²(2)=0.10, p=0.95),但与模型存在显著交互作用(χ²(11)=364.8, p<0.001)(不同模型对温度变化的响应略有差异);
专科背景产生极端性别刻板印象:精神病学、风湿病学、血液学在所有模型中100%被标记为女性;心脏病学、泌尿科100%被标记为男性;肺病学除Claude(55%男性)外,其余模型95-100%标记为男性。
实验二:中性临床案例的性别分配(允许模型“弃权/不分配”)
核心目的:
探究当给予 LLMs 不确定性表达的选择权时,模型是否会减少无依据的性别归因,同时分析不同模型的风险规避/保守性程度,以及弃权是否能成为性别偏见的“表面防护栏”。
操作流程:
实验素材与实验一完全一致:仍为50个性别脱敏的中性临床案例;
调整模型响应指令:将二选一改为三选一,允许模型输出male/female/abstain(弃权),无其他额外提示;
实验条件与实验一完全相同(四款模型、三个温度、各10次重复),记录模型的“弃权/男性/女性”三类输出比例。
核心测量指标:
各模型在不同温度下的弃权比例、剩余性别分配的男性/女性比例;
用卡方检验验证模型间弃权行为的差异显著性、模型-温度交互效应对弃权行为的影响。
关键实验结果:
模型弃权行为差异极大,保守性分层明显:ChatGPT在所有温度下100%弃权,是保守性最强的模型;温度0.5时,Claude弃权84%、Gemini弃权80%、DeepSeek仅58%(保守性最弱);
弃权比例跨温度高度稳定:温度变化对各模型的弃权行为几乎无影响,模型本身是决定弃权与否的核心因素;
弃权仅减少“显性性别标签”:虽大部分模型不再随意分配性别,但后续实验证明,这种表面的弃权行为无法消除模型内在的性别偏见对下游推理的影响。
实验三:性别标签对下游鉴别诊断推理的影响
核心目的:
验证当临床案例的唯一变量仅为患者性别(男性/女性标签)时,LLMs生成的核心鉴别诊断列表是否会出现性别依赖的差异,以及这种差异的程度、模型特异性、温度影响,也是研究中最贴近临床实际应用的实验。
操作流程:
对50个原始临床案例进行性别参数化处理:仅修改患者的性别标签(男性/女性),保留所有临床症状、检查、病史等信息完全一致,生成男性版案例和女性版案例(配对案例,仅性别不同);
向四款LLM分别输入男性版/女性版案例,给出标准化诊断指令:要求模型生成按可能性从高到低排序的前五名鉴别诊断,并以固定JSON格式输出(严格限制格式,减少噪声);
实验条件与前两个实验一致,记录所有模型在不同温度下,为男性/女性版案例生成的前五鉴别诊断列表;
对输出结果进行数据清洗:统一医学术语的同义词、去除格式噪声,生成标准化诊断词汇库,确保后续对比的准确性。
核心测量指标:
本次实验采用四层评估体系,从内容一致性和排序一致性两个维度量化男女版诊断列表的差异,核心指标包括:
诊断列表匹配类型(三层分类):
完美匹配:男女版的5个诊断完全相同,且排序一致;
打乱匹配:5个诊断完全相同,但排序不同;
不匹配:至少1个诊断仅出现在其中一个列表中(核心差异指标);
内容重叠指标:杰卡德相似性(Jaccard Similarity),取值0-1,代表男女版诊断列表的重叠程度,值越低差异越大;
排序一致性指标:包括项目级一致性(ILA)(完全同位置的诊断数量占比)、累积匹配特征(CMC)(从第一名开始的连续一致诊断占比)、肯德尔等级相关系数(Kendall’s tau-b)(共享诊断的排序相似性,1为完全一致,0为无规律);
诊断多样性:男女版案例生成的唯一诊断数量,验证性别是否影响诊断的广度。
关键实验结果:
所有模型的诊断列表均存在显著性别依赖差异:温度0.5时,58-78%的配对案例出现诊断列表不匹配,其中ChatGPT差异最显著(78%不匹配,仅10%完美匹配),DeepSeek差异最小(58%不匹配,28%完美匹配);
温度升高会放大性别相关的诊断差异:所有模型的杰卡德相似性均随温度升高而下降,ChatGPT下降最显著(0.2时0.76 → 1.0时0.50),DeepSeek/ Gemini/ Claude在1.0时仍保持0.62以上的相似性;
排序一致性随温度升高显著降低:项目级一致性、累积匹配特征、肯德尔系数均随温度升高下降,ChatGPT在温度1.0时排序一致性最差(ILA=0.39,tau-b=0.74);
诊断多样性无性别差异:同一案例的男女版生成的唯一诊断数量无显著差异(p>0.12),说明性别偏见主要影响诊断的选择和排序,而非诊断的广度;
模型是诊断差异的核心决定因素:方差分析显示,模型对杰卡德相似性(F(3,588)=6.06, p<0.001)、项目级一致性(F(3,588)=5.88, p=0.0005)的主效应均显著,温度为次要影响因素,且模型-温度存在交互作用。
三个实验的逻辑关联与核心结论
三个实验层层递进,从模型的基础性别归因倾向(实验一),到不确定性下的归因行为调整(实验二),再到性别偏见对临床核心任务的实际影响(实验三),形成了完整的研究链条,最终得出核心结论:
当代LLMs在临床推理中存在稳定的、模型特异性的性别偏见,且这种偏见并非随机,而是与临床专科的性别刻板印象高度关联;
允许模型弃权仅能减少显性的性别标签分配,无法消除内在的性别偏见对下游诊断推理的影响;
温度参数主要影响偏见的表现程度(升高放大差异),而非偏见的存在与否,模型架构/训练数据是性别偏见的核心来源;
性别标签的微小差异,会导致LLMs生成的鉴别诊断列表出现内容或排序的显著分歧,这种分歧在临床中可能影响诊断准确性和医疗公平性。
结论
研究得出了以下主要结论:
所有评估的大语言模型都表现出显著的性别偏见,但偏见的方向和程度因模型而异
专科背景对性别分配有强烈影响,某些专科一致地被标记为特定性别
允许放弃选项可以减少显性的性别标记,但不能消除潜在的偏见影响
温度参数通过与模型的交互作用影响偏见表现,但本身不直接决定偏见方向
性别偏见会影响下游的诊断推理过程,导致基于患者性别的诊断差异
