
本文是一篇新论文 Spatia: Video Generation with Updatable Spatial Memory 的解读,旨在帮助大家快速学习论文核心内容,了解其中的关键信息。本文非常有创意性的提出了视频中三维记忆为基础的体系,非常值得大家仔细研读。
大家好,欢迎了解 Spatia,这是一个旨在开启时空连贯且可交互视频生成新纪元的框架。Spatia 的全称是“空间存储感知视频生成”(Spatial memory–aware video generation),其核心突破在于赋予了 AI 像人类一样拥有持久且可更新的三维空间记忆能力。
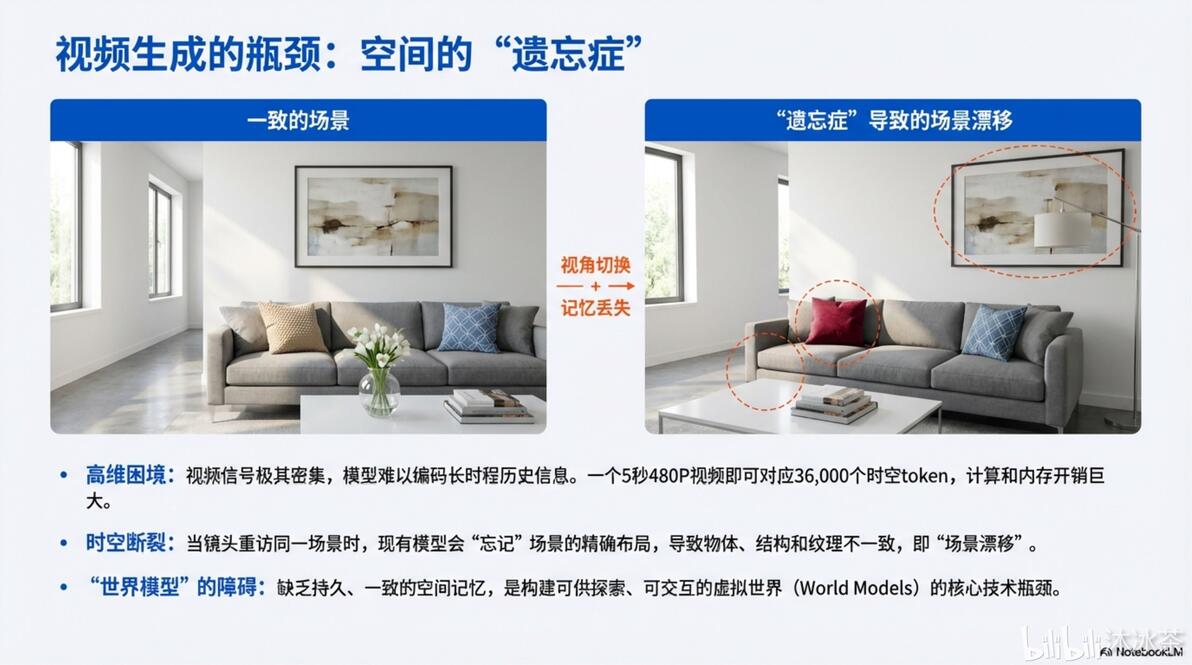
现有的视频生成模型面临着严峻的“高维困境”:视频信号极其密集,一个仅5秒的480P视频就包含约 36,000个时空Token。相比之下,同样的计算量足以让大语言模型处理近3万字的长文。由于难以编码超长时程的历史信息,当镜头在视频中重新访问同一场景时,模型往往会“忘记”之前的布局,导致物体结构和纹理发生场景漂移。这种持久空间记忆的缺失,是通往真正“世界模型”的核心障碍。
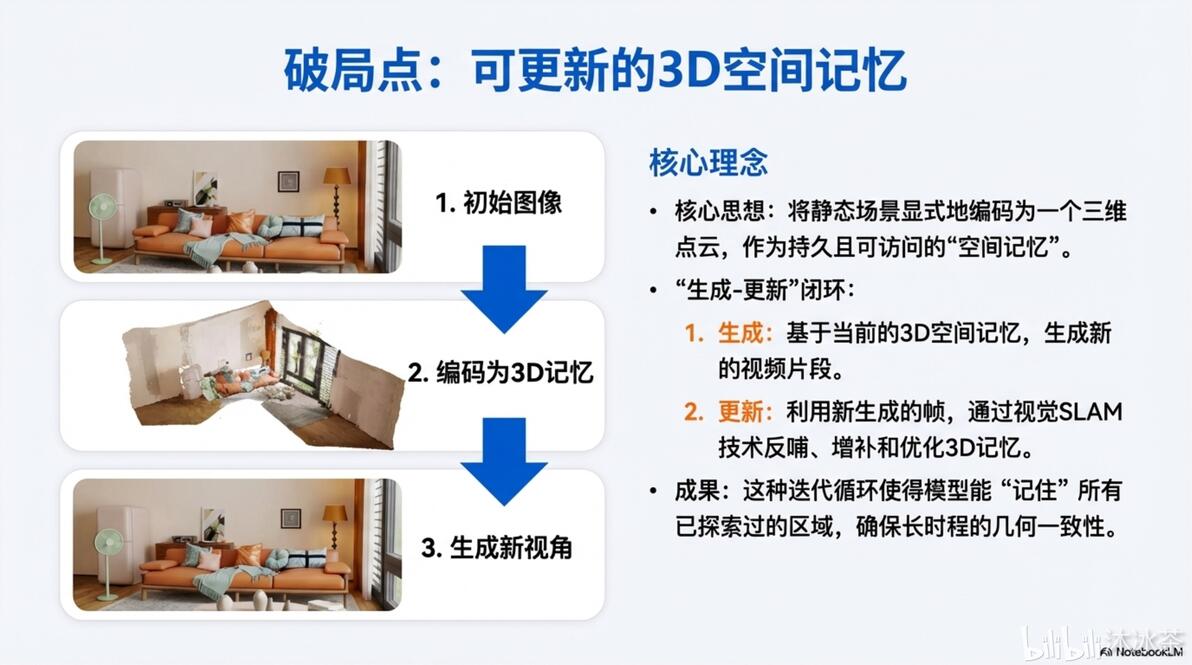
Spatia 的核心破局点在于引入了显式且可更新的三维点云作为持久空间记忆。其运作遵循一个“生成-更新”的闭环:首先基于当前的3D记忆生成新的视频片段;随后利用新生成的帧,通过视觉SLAM技术(即即时定位与地图构建)对3D记忆进行反哺、增补和优化。这种迭代循环确保了模型能“记住”所有已探索区域,从而在长时程生成中保持几何一致性。
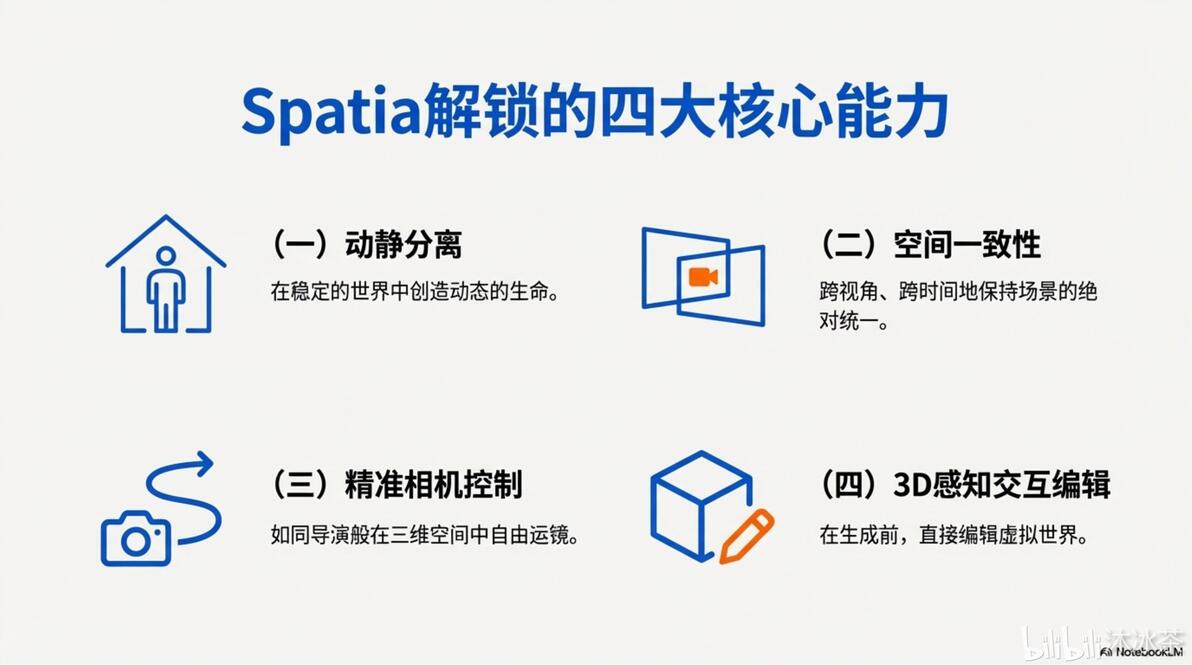
通过集成这种空间记忆机制,Spatia 解锁了四大颠覆性的能力:
1. 动静分离:在绝对稳定的背景中创造生动的动态实体。2. 空间一致性:跨越视角和时间,确保场景绝对统一。 3. 精准相机控制:允许像导演般在三维空间中自由运镜。 4. 3D感知交互编辑:支持在生成视频前直接编辑虚拟世界。
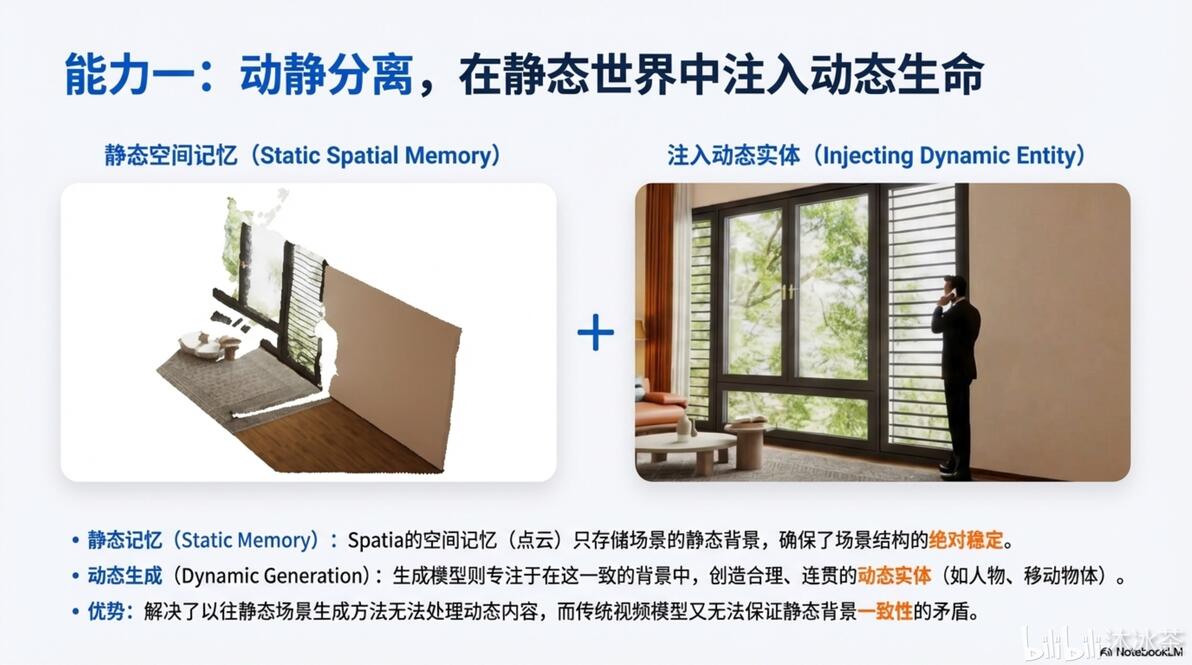
Spatia 实现了动态与静态的解耦:它的空间记忆(点云)只存储场景的静态背景,确保了背景结构的绝对稳定。与此同时,生成模型专注于在这个一致的背景中创造合理、连贯的动态实体(如走动的人或移动的物体)。这完美解决了以往静态场景生成方法无法处理动态内容,而传统视频模型又无法保证背景一致性的矛盾。
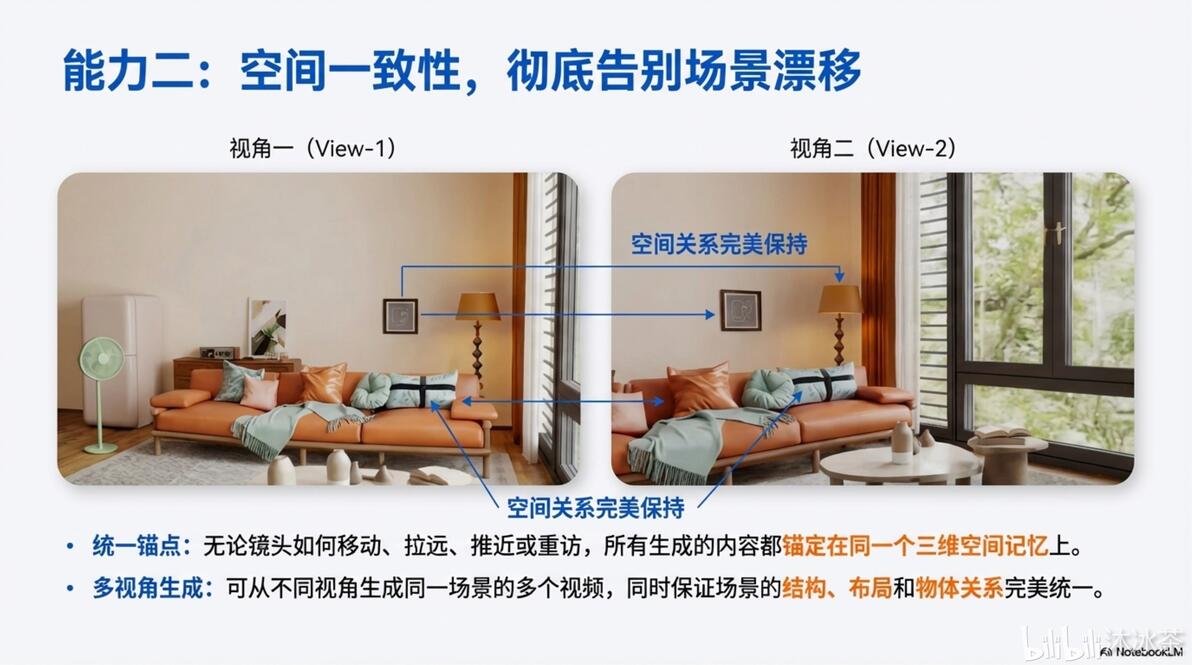
得益于统一锚点的设计,无论镜头如何移动、拉远还是重访,所有生成的视觉内容都通过空间记忆检索,锚定在同一个三维坐标系中。这使得 Spatia 能够从不同视角生成同一场景的多个视频,同时保证场景的结构、布局和物体间的位置关系在时空上完美统一,彻底解决了传统 AI 视频中常见的“背景崩坏”问题。
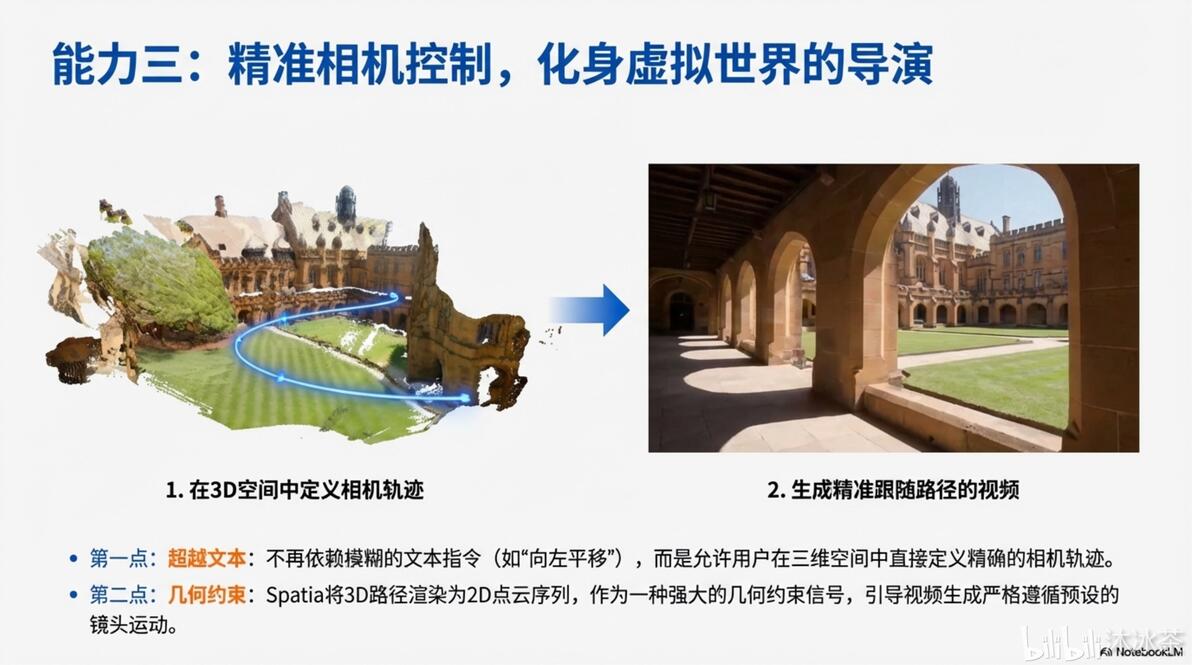
Spatia 超越了模糊的文本指令控制。它允许用户在三维空间中直接定义精确的相机轨迹。Spatia 会将这些3D路径渲染为2D点云序列,作为一种强大的几何约束信号注入模型,引导视频生成严格遵循预设的镜头运动,实现厘米级的运镜精度。
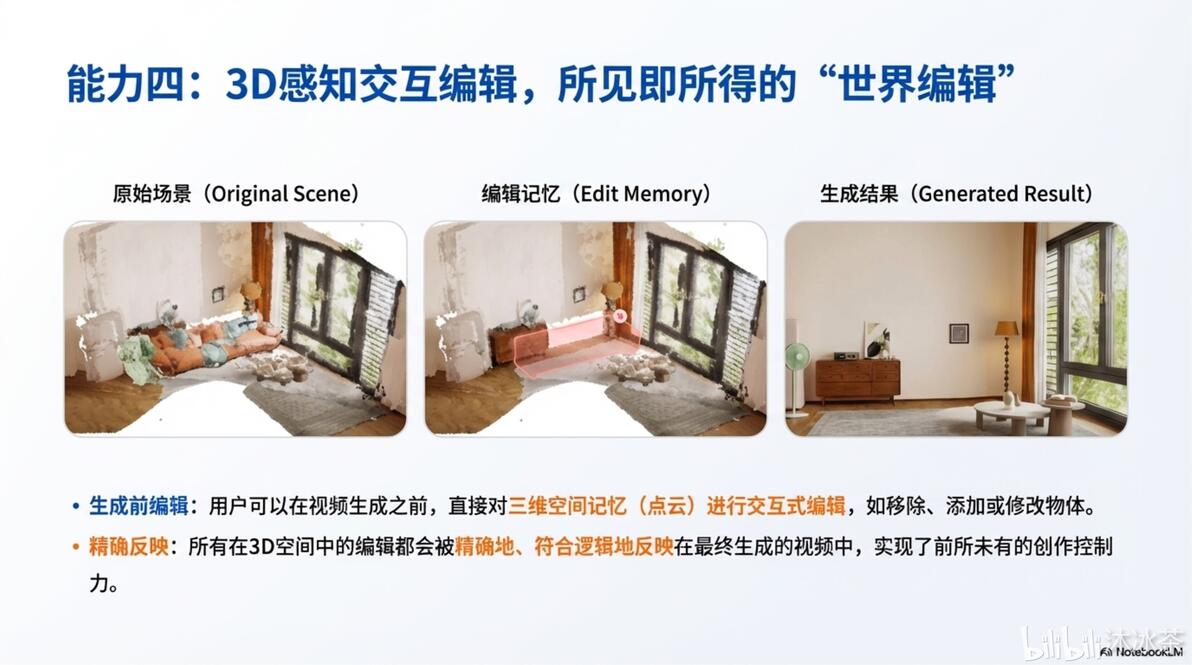
这是 Spatia 最具交互性的功能:由于生成是基于3D点云的,用户可以在视频生成之前,直接对3D记忆进行交互式编辑。例如,你可以手动移除某个沙发、添加一个物体或修改家具颜色。这些在三维空间中的修改会被精确、符合逻辑地反映在最终生成的视频片段中,实现了前所未有的创作控制力。
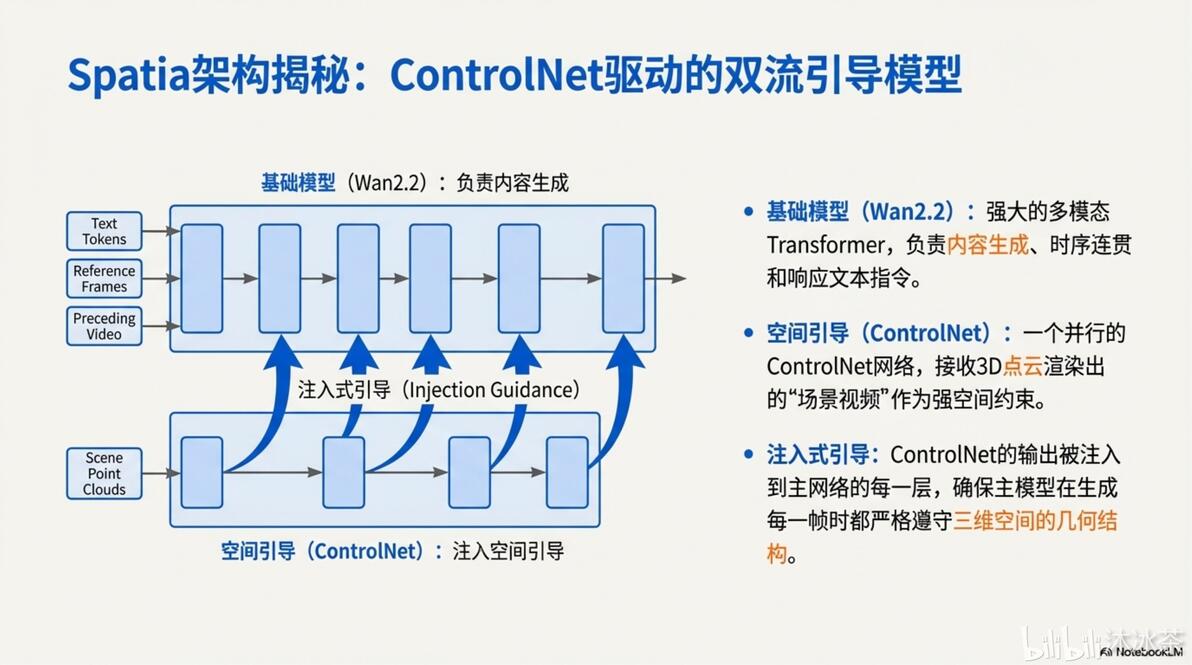
Spatia 的技术底座是拥有50亿参数的 Wan2.2 多模态 Transformer,负责处理内容生成和语义响应。在其并行侧,我们引入了一个由 ControlNet 驱动的空间引导流,它接收从3D点云渲染出的投影视频作为强空间约束。这种注入式引导将 ControlNet 的输出融入主网络的每一层,确保生成的每一帧都严格遵守三维空间的几何结构。
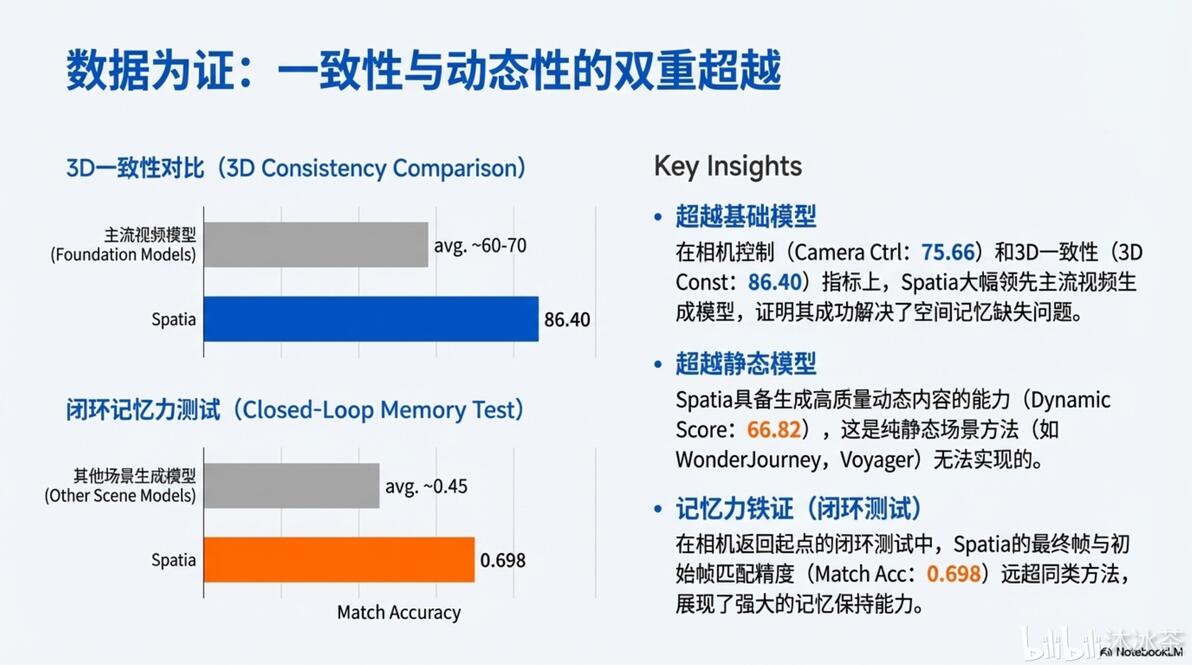
实验数据证明了 Spatia 的卓越表现:在相机控制(75.66)和3D一致性(86.40)指标上,Spatia 大幅领先主流视频大模型,解决了空间记忆缺失问题。在挑战极大的闭环记忆力测试中(即镜头绕一圈回到原点),Spatia 的首尾帧匹配精度达到 0.698,远超同类场景生成方法,展现了其强大的记忆保持能力。
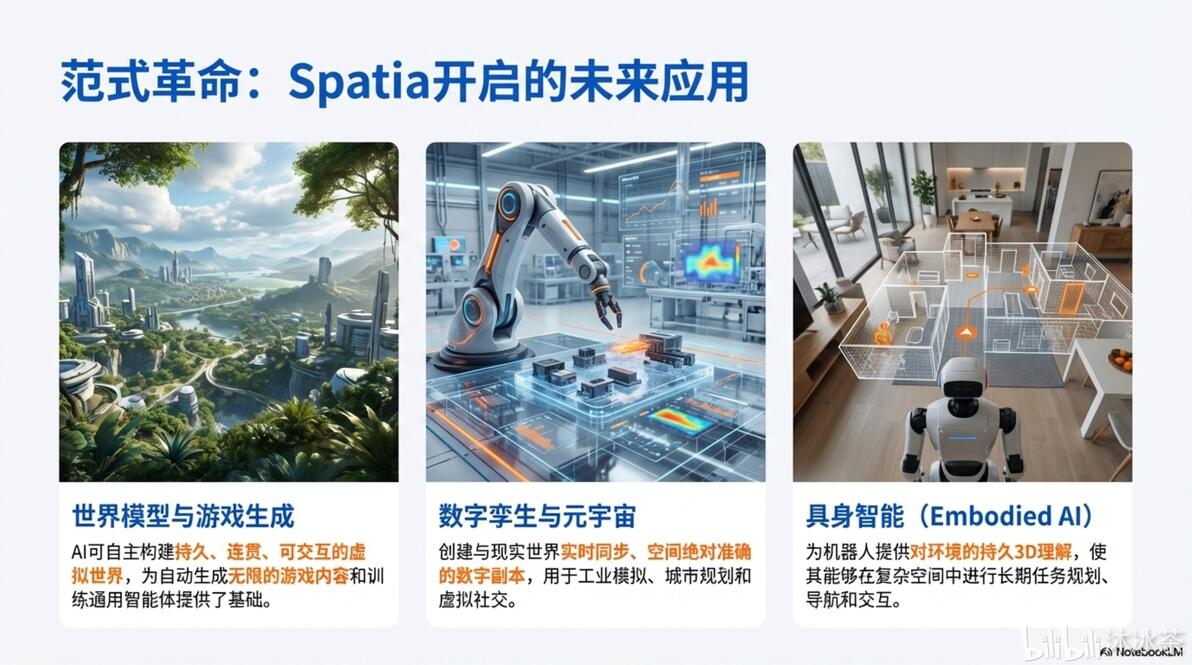
Spatia 不仅仅是一个视频生成工具,它更是多个领域的基石:
• 世界模型与游戏:AI 可自主构建持久、连贯的虚拟世界,为自动生成无限的游戏内容提供可能。• 数字孪生与元宇宙:创建与现实同步、空间绝对准确的数字副本,用于工业规划和社交。 • 具身智能 (Embodied AI):为机器人提供对环境的持久3D理解,使其能在复杂空间中进行长期任务规划与交互。
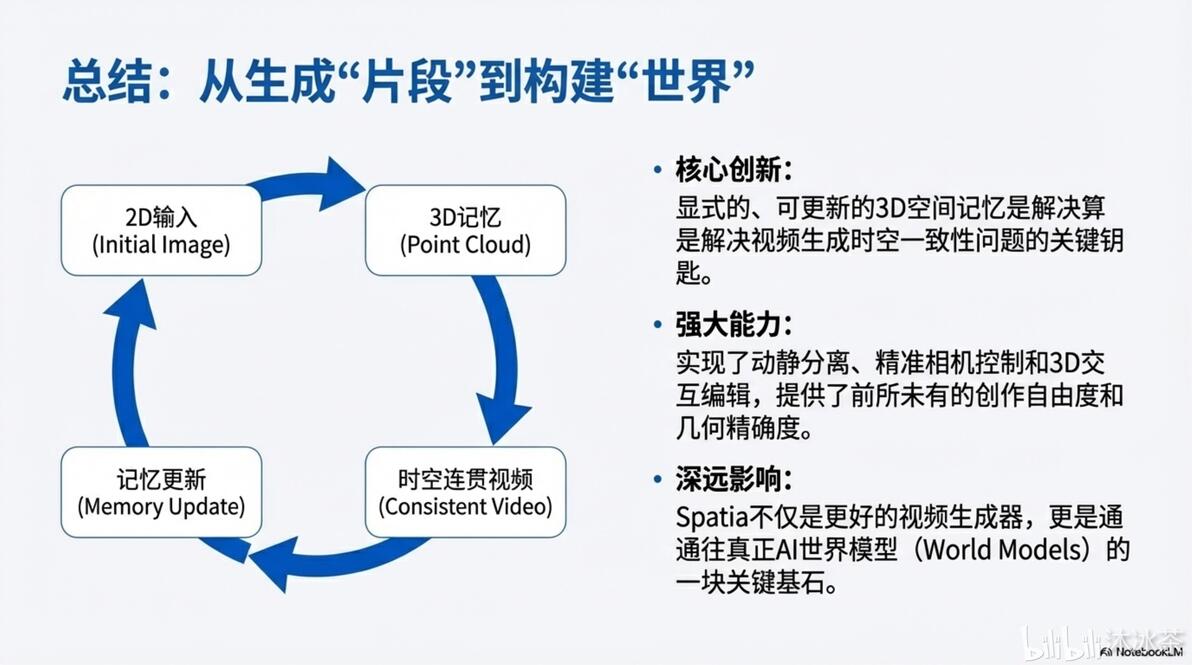
最后总结一下:Spatia 的核心创新在于引入了显式、可更新的3D空间记忆,这是解决视频生成时空一致性问题的关键钥匙。它通过动静分离和精准控制,提供了前所未有的创作自由度。Spatia 不仅仅是更好的视频生成器,更是通往真正 AI 世界模型(World Models)的一块关键基石。
--------------------------------------------------------------------------------
比喻说明: 如果传统的视频 AI 像是一个**“边走边忘”的盲目写作者**,只能勉强接上上一句话;那么 Spatia 就像是一位**“带着蓝图”的建筑师**。它在动笔之前,已经在脑海中建好了整栋房子的三维模型,确保无论镜头怎么转动,每一根柱子、每一扇窗户的位置都永远不会错位。
