
你是否发现,现在的多模态大模型(MLLMs)虽然在单次回答上表现惊艳,但往往像个“健忘症患者”?它们处理每一个问题时都是从零开始(de novo),反复掉进同一个坑里,昨天犯过的视觉识别错误,今天换个姿势又犯一遍。
已有的记忆增强Agent大多只是简单地把过去的“轨迹”存起来。但这种做法有两个硬伤:一是“捡了芝麻丢了西瓜”,随着记忆被反复压缩,关键的领域知识逐渐流失;二是“偏科”,往往只记住了逻辑层面的总结,却丢掉了视觉感知的细节。这完全不符合人类的认知习惯——我们的语义记忆是“多模态且融合”的,既有对“长什么样”的视觉印象,也有对“怎么推理”的逻辑抽象。
针对这个痛点,南京理工大学联合百度等机构的研究团队提出了一种全新的双流记忆框架——ViLoMem(Visual-Logical Memory)。它像人类大脑一样,分门别类地存储“视觉干扰模式”和“逻辑推理错误”,让模型不仅知道“怎么想”,更知道“往哪看”。在六个多模态基准测试中,ViLoMem显著减少了重复的视觉和逻辑错误,特别是在数学推理任务上表现抢眼。
论文地址:https://arxiv.org/abs/2511.21678
机构:南京理工大学、百度、阿德莱德大学AIML、新加坡科技设计大学
作者:Weihao Bo, Shan Zhang, Yanpeng Sun等
项目主页:https://weihao-bo.github.io/ViLoMeo-page/
代码仓库:https://github.com/weihao-bo/ViLoMem
为什么我们需要“视觉-逻辑”双流记忆?
现有的多模态模型在解决复杂问题(特别是数学和图表题)时,很多时候不是“脑子”不够用,而是“眼睛”没看准。比如,把图中的三角形看成了直角三角形,或者忽略了关键的阴影部分。
如下图1所示,当模型面对一个多模态问题时,早期的尝试可能既包含逻辑错误,也包含视觉错误。如果只通过文本反馈来修正,模型往往难以纠正底层的感知偏差。
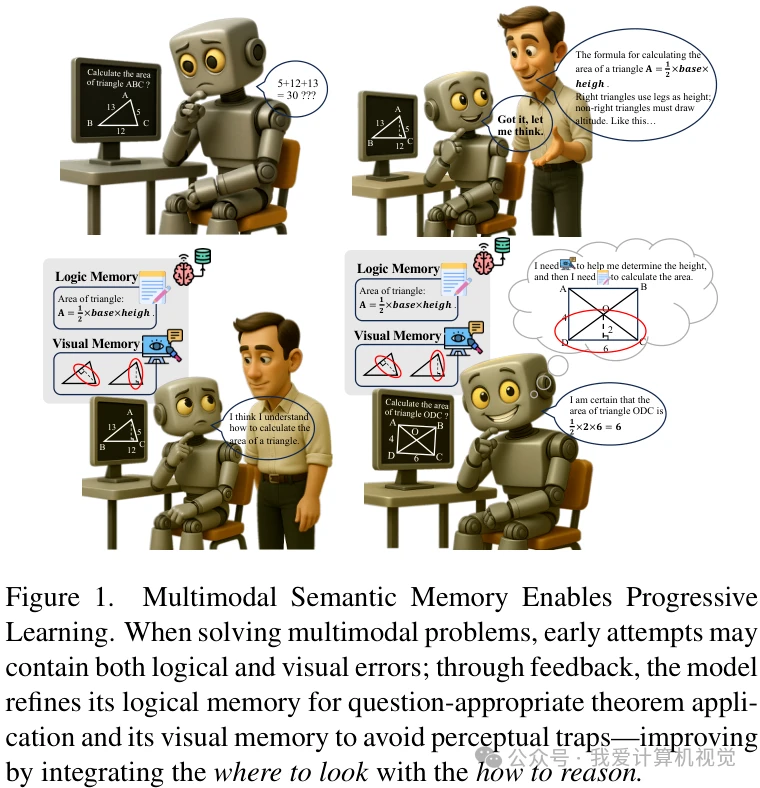
ViLoMem 的核心洞见在于:视觉注意力的错误直接导致了下游的逻辑幻觉,形成连锁反应。 因此,必须将“视觉干扰”和“逻辑幻觉”解耦,分别建立记忆。
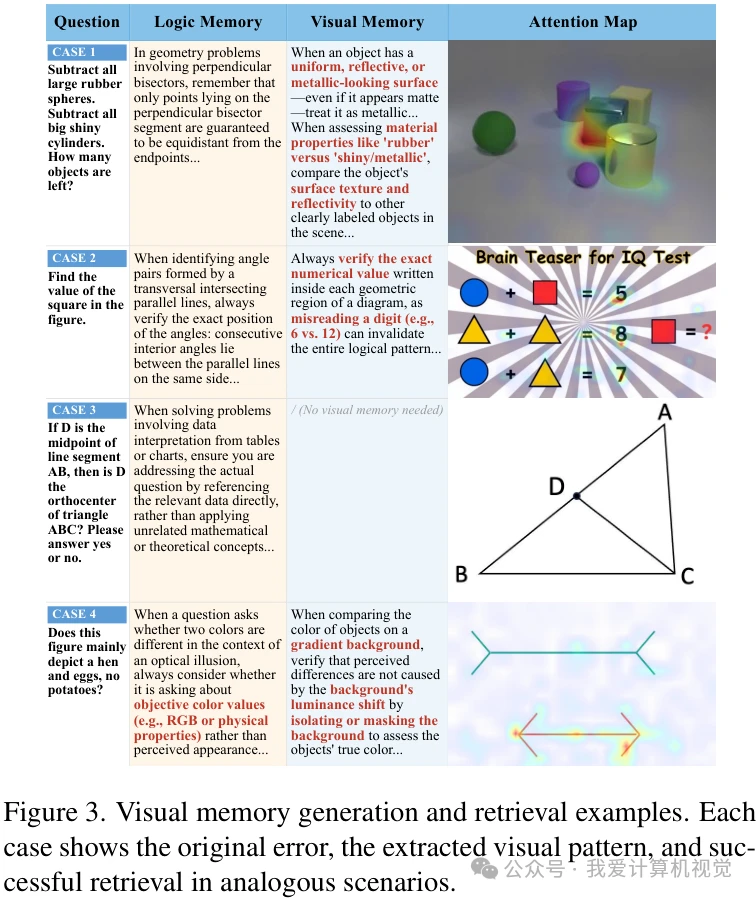
视觉流(Visual Stream):负责记住“哪里容易看错”。比如,“当看到这种反光的物体表面时,不要误以为是某种材质”。
逻辑流(Logical Stream):负责记住“推理规则”。比如,“应用垂直平分线定理前,先确认点是否在直线上”。
这种设计灵感来源于人类的认知神经科学:人类的大脑有专门的视觉联想皮层(处理视觉语义)和顶下小叶等区域(处理抽象规则),并通过前颞叶(ATL)进行整合。ViLoMem 正是模拟了这种机制。
ViLoMem 框架详解:生长与精炼
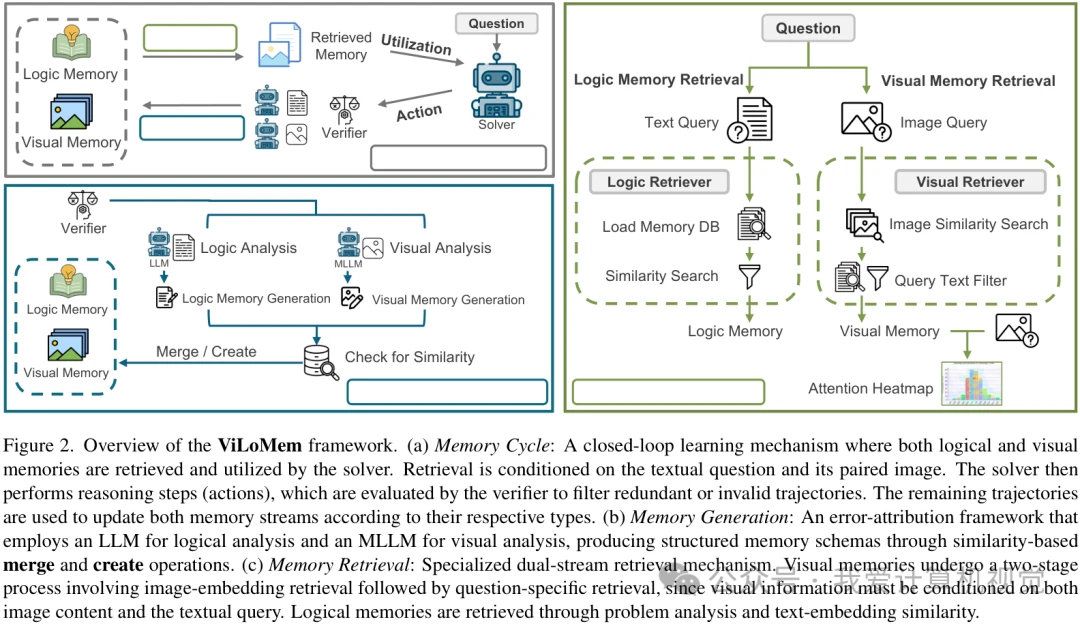
ViLoMem 是一个即插即用的双流记忆框架,通过一个闭环的“记忆周期”(Memory Cycle)来实现持续学习。整个流程包括记忆的检索、利用、生成和更新。
记忆生成:精准归因,结构化存储
当模型在某个问题上失败时,ViLoMem 不会笼统地记录“这题做错了”,而是启动并行的错误归因生成机制:
视觉记忆生成:利用 MLLM 分析图像和错误轨迹,判断是否发生了视觉误解(如对象混淆、符号遗漏)。如果是,则生成一条视觉指南(Visual Guideline),告诉模型“下次遇到类似的图,要特别注意查看XXX区域”。
逻辑记忆生成:利用 LLM 纯粹从文本层面分析推理链,识别计算错误或公式误用,生成逻辑指南(Logic Guideline)。
为了避免记忆库无限膨胀导致检索困难,ViLoMem 遵循“生长与精炼(Grow-and-Refine)”原则。新生成的指南会与已有记忆进行相似度比对:如果发现相似的错误模式,就进行合并(Merge),提炼出更通用的规则;如果是新的错误类型,则**创建(Create)**新的记忆条目。这种机制有效防止了灾难性遗忘和知识碎片化。
记忆检索:双重策略,有的放矢
在解决新问题时,ViLoMem 采用差异化的检索策略来获取最相关的建议:
视觉记忆检索(两阶段法):
第1步:先用图像嵌入(Image Embedding)快速召回视觉上相似的历史案例。
第2步:再用文本嵌入(Text Embedding)结合当前问题的具体语义进行重排序。
高亮:为了更直观地指导模型“往哪看”,ViLoMem还会根据检索到的错误模式,生成问题感知注意力图(Question-Aware Attention Map),高亮显示图像中容易出错的区域作为辅助输入。
逻辑记忆检索(精准定位):
先对当前问题进行分析,提取学科领域和关键概念(如“几何”、“勾股定理”)。
利用这些结构化信息构造查询向量,在逻辑记忆库中精准匹配相关的推理规则。
如下图3所示,无论是材质识别的视觉陷阱,还是图表读数的细节错误,ViLoMem 都能精准地从历史经验中提取出对应的“避坑指南”。
实验结果:全方位提升
研究团队在 MMMU、MathVista、MathVision 等六个主流多模态基准上对 ViLoMem 进行了广泛评估。涵盖了 GPT-4.1、Qwen3-VL-235B 和 Qwen3-VL-8B 等不同规模的模型。
主实验结果
如表1所示,ViLoMem 在所有模型和基准上均取得了一致的性能提升。
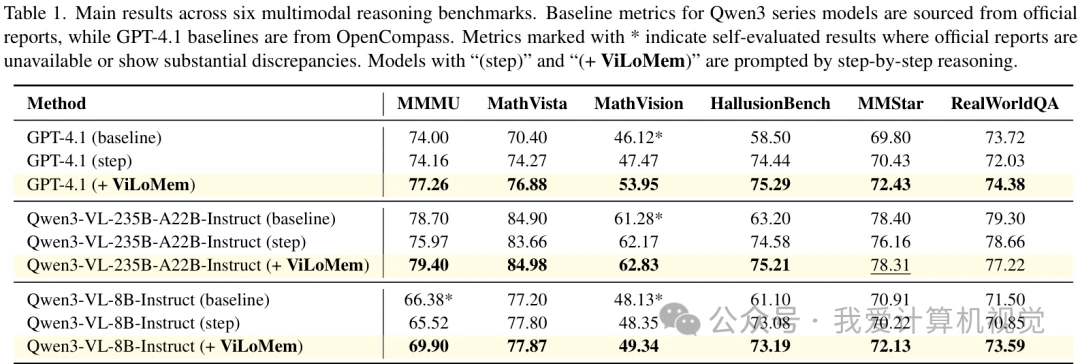
数学推理提升显著:在 MathVision 上,GPT-4.1 结合 ViLoMem 后准确率提升了 6.48% 。这印证了论文的观点:数学任务对视觉感知的精确度要求极高,消除视觉误差能带来巨大的收益。
小模型也有大智慧:8B 参数量的 Qwen3-VL 在 MMMU 上提升了 4.38% ,说明结构化的外部记忆可以有效补充小模型参数知识的不足。
消融实验与分析
为了验证双流记忆的必要性,研究者进行了详细的消融实验(下表2)。
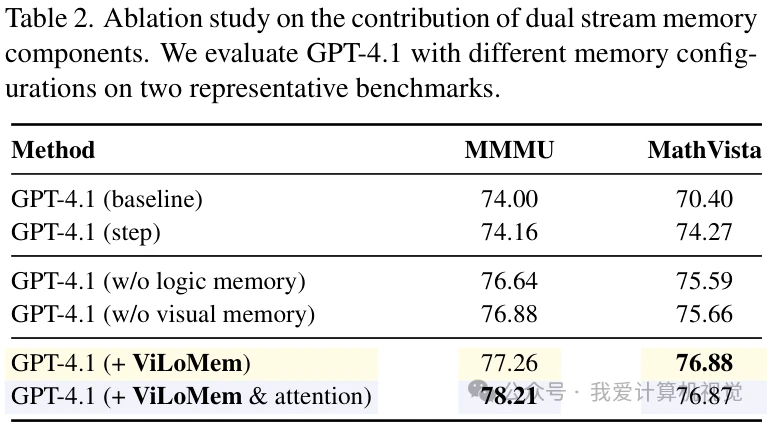
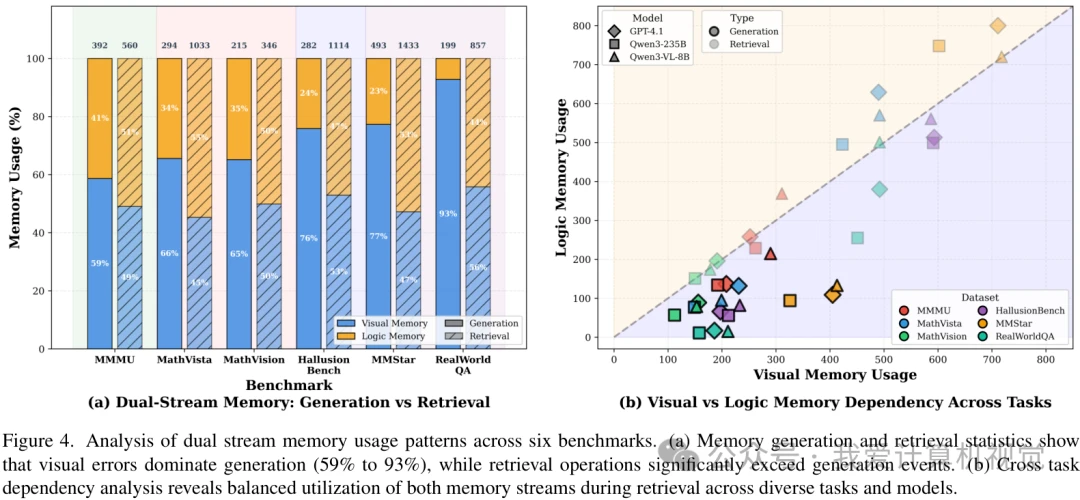
结果显示,单独去掉逻辑记忆或视觉记忆都会导致性能下降。更有趣的是,视觉错误主导了记忆生成(如图4 (a)所示,约59%-93%的生成事件源于视觉错误),这再次强调了在多模态任务中关注视觉感知的重要性。
跨模型与跨领域迁移
ViLoMem 还展现出了优秀的通用性:
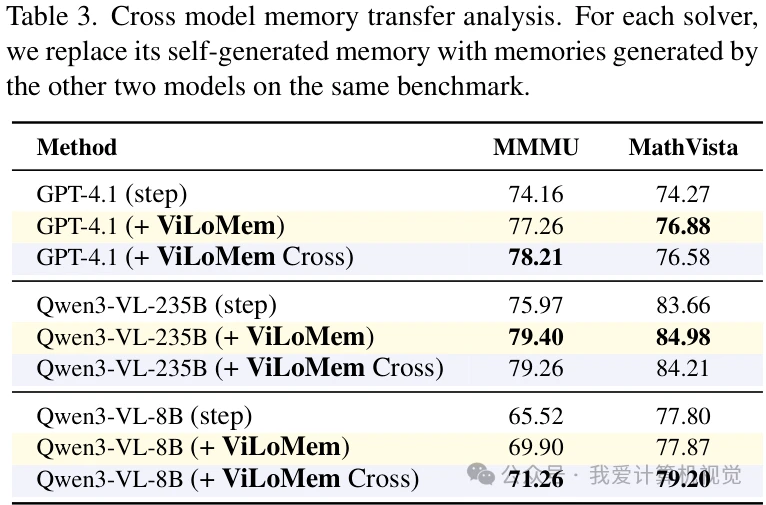
跨模型迁移:把强模型(如 Qwen3-VL-235B)生成的记忆给弱模型(如 8B)使用,弱模型的性能甚至超过了自我生成的记忆(下表3)。这意味着我们可以用大模型“教”小模型避坑。
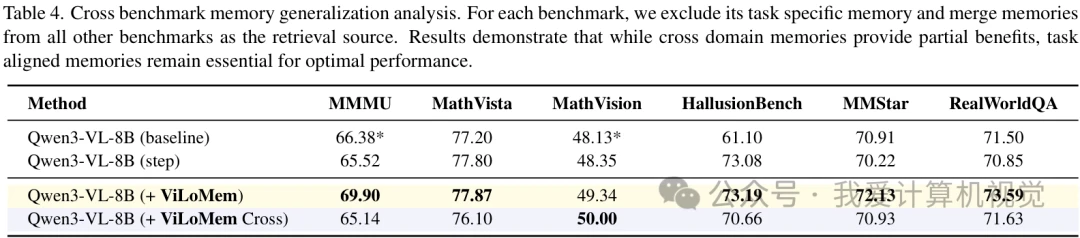
跨领域迁移:虽然任务对齐的记忆效果最好,但在 MathVision 和 RealWorldQA 这样都依赖空间推理的任务间,记忆也表现出了正向的迁移效果(下表4)。
一点思考
ViLoMem 的成功给我们带来了一个重要的启示:在追求更大的模型参数之前,也许我们应该先优化模型“从错误中学习”的能力。人类之所以聪明,很大程度上是因为我们能记住“上次我在这里跌了一跤”。
这种将感知(视觉)与认知(逻辑)解耦并协同的记忆机制,或许能成为大模型能力不断进阶的“错题集”。
