书接上回我们继续学习LLM智能体代码生成的这篇综述
参考文献:A Survey on Code Generation with LLM-based Agents
多智能体技术
1.多智能体系统的工作流
我们先学习基于多智能体的代码生成,其工作流主要有四类:基于流水线的任务分工、分层规划执行机制、自主协商循环优化以及自演化结构更新。工作流与角色配置的落地实现,通常依赖于系统提示词的设计。每个智能体背后的LLM,会基于预设的prompt,明确自身当前的任务与职责。prompt通常包含任务分工、输出要求、输入格式、接口调用方法以及输出格式等内容。
在基于流水线的任务分工范式中,一个智能体负责软件开发流程中的一个特定阶段,并将中间产物传递给下一个智能体进行处理。这一流程体现出明显的时序性。
Self-Collaboration 模型以软件工程领域经典的瀑布模型为基础,设计了一套包含需求分析、代码实现、测试验证三个阶段的经典多智能体协作流程。在该流程中,各阶段的智能体独立完成对应任务,并将成果传递至下一阶段。
AgentCoder 模型同样构建了一套三阶段流水线系统,设置了程序员、测试设计师、测试执行者三类智能体角色。该系统通过结构化的任务拆解与测试反馈机制,有效提升了代码生成的正确性与可执行性。
CodePori 模型则拓展了智能体角色类型,涵盖管理者、开发者、优化者、验证者四类角色。在该框架中,管理者智能体负责解析自然语言需求并拆解任务;多个开发者智能体并行协作,编写不同模块的代码;随后由多个优化者智能体对代码进行优化;最后由验证者智能体开展集成测试,保障系统功能完整。
HyperAgent 模型聚焦于跨语言、跨任务的代码生成问题。该框架通过规划智能体、导航智能体、代码编辑智能体与执行智能体的协同配合,将自然语言需求转化为可运行程序。同时模型引入了自动工具链检索机制。
分层规划执行范式强调由高层智能体完成任务拆解,再由底层智能体负责具体落地执行。
PairCoder 模型模拟结对编程的协作模式,设计了两类协同智能体:负责规划的导航智能体(Navigator)与负责具体实现的驱动智能体(Driver)。导航智能体的职责是提出可行的解决方案、筛选当前最优方案,并基于执行反馈指导后续迭代流程;驱动智能体则遵循导航智能体的指引,完成初始代码生成、代码测试与优化工作。
FlowGen 模型设计了一套四层智能体架构。该架构设置了需求工程师、架构师、开发人员与测试人员四类智能体角色。系统通过阶段性规划与目标验证,循序渐进地推进各项开发任务。
SoA 模型引入了动态智能体调度机制。该系统能够根据任务复杂度与资源使用情况,自主扩充或缩减智能体数量
自主协商循环优化机制以协商、反思与自我反馈为核心,通过多轮交互持续提升代码的质量与鲁棒性。
MapCoder 模型构建了一套由四类专业智能体组成的循环协作流程,四类智能体分工协作,依次完成相关案例检索、解决方案规划、对应代码生成与错误调试修复的任务。通过多次迭代,在每一轮迭代中,这些智能体协同生成代码,并定位缺陷进行修复。
AutoSafeCoder 模型设计了一个集成代码生成智能体、静态分析器与模糊测试器的框架。在该框架中,代码生成智能体能够根据静态分析器提供的静态安全检测反馈,以及模糊测试器提供的动态安全检测反馈,持续修订代码。
QualityFlow 模型构建了一个大语言模型智能体协作团队,该团队首先生成单元测试用例,随后借助基于大语言模型的质量校验器,预判生成的代码与测试用例是否满足需求,最后执行这些测试用例以验证代码正确性。
CodeCoR 模型引入了一种自反思评分机制。该框架在代码生成、测试与修复等阶段之间增设了反思智能体,由其对中间产物进行评分并定位问题,再将结果反馈给上游智能体,以开展下一轮迭代优化。
MARCO 模型提出了一种多智能体代码优化框架,重点聚焦于提升大语言模型生成代码在并行性、内存效率与架构适应性三方面的性能。该系统分别设置了代码生成智能体与性能评估智能体。
自演化机制致力于使系统能够自发且动态地调整自身结构与行为策略。
SEW 模型提出了一种工作流自演化机制,该机制可基于智能体间的协作成效与故障反馈,动态重构通信路径并调整职责分工。
EvoMAC 模型的设计灵感源于神经网络的训练过程,它将代码生成结果与目标需求进行比对,以获取环境反馈的文本形式信息,并创新性地设计了文本反向传播机制,以此自动调整智能体之间的协作结构与行为策略。
2.上下文管理
SelfCollaboration 模型率先将黑板模型引入代码生成任务。该方法构建了一个显式的共享存储空间,用于存储任务描述、生成过程中的中间结果以及代码修订记录等结构化信息。所有智能体均可根据任务类型的需求,对黑板内容进行读取或更新,并据此做出后续决策,形成基于共享视图的协作流程。
L2MAC 模型从冯・诺依曼架构中汲取灵感,设计了解耦的指令寄存器与文件存储模块。该系统引入显式控制单元,以精准控制上下文内容的调度与写入;同时按程序单元组织上下文信息,有效突破了语言模型的上下文窗口限制。
Cogito 系统借鉴神经生物学中的认知 - 记忆 - 成长三阶段模型,将上下文信息划分为三大结构化类别:短时记忆、长期知识库与演化成长单元。
SoA 模型引入了自组织多智能体框架,可根据任务复杂度自动扩展智能体池。每个智能体均在自身固定大小的上下文窗口内工作,通过增加智能体数量而非提升单个智能体的工作负载,有效避免了信息稀疏与混乱问题。
3.多智能体协同优化
顾名思义,这类方法侧重于提升智能体之间的协作能力,目前该技术还属于一个新兴的方向,技术体系尚未成熟。
Lingma SWE-GPT 模型通过将任务拆解为代码库理解、故障定位与补丁生成三个阶段,每个阶段均对应一个子任务智能体。为实现智能体间的协作优化,Lingma SWE-GPT 首先收集多阶段智能体产生的行为数据,包括推理过程、工具调用记录及最终结果;随后通过监督微调对整个系统进行优化,从而提升多阶段协作质量与整体性能。
CodeCoR 模型围绕提示词、代码、测试用例、修复建议四类专属智能体,构建了一套 “生成 — 测试 — 修复” 的循环流程。在训练阶段,每个智能体均会生成多个候选结果,并对其他智能体的输出内容进行评估。随后,模型会基于这些相互评估结果,剔除低质量的提示词、代码片段、测试用例与修复建议。
CANDOR 模型采用群组讨论策略,基于多个审核智能体达成的共识生成精准的参考答案。
基于大模型的代码生成智能体在软件开发任务中的应用
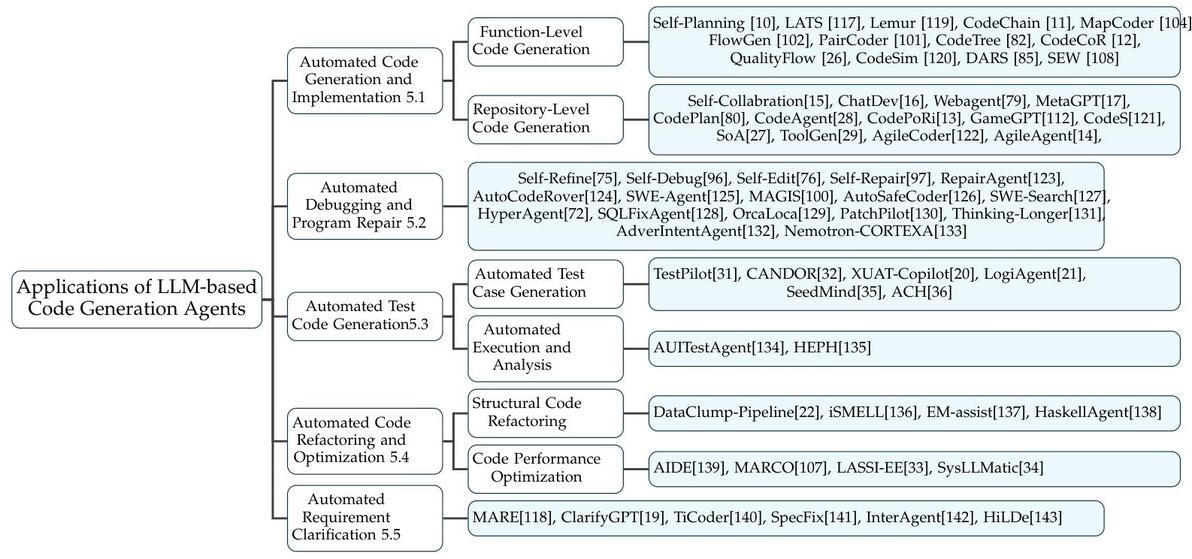
这里不多说了直接上图,图中的工作大多数前面都介绍了。总的来说应用在五个任务中:
自动代码生成
自动debug和修复
自动测试生成
自动代码重构和优化
自动需求分类