
"你有没有想过,如果能像听真人播客一样,让AI为你生成90分钟以上的自然对话,甚至能模仿四川话、河南话、粤语,还能加入笑声、叹气等自然语音元素?"这不再是科幻电影的场景,而是中国科研团队最新推出的SoulX-Podcast技术带来的现实。
近日,来自西北工业大学、Soul AI Lab和上海交通大学的研究团队宣布,他们成功开发出SoulX-Podcast——一款能够生成超长、多说话人、多语言的播客式对话语音的AI系统。这款系统不仅能生成自然流畅的多轮对话,还能在不同方言间无缝切换,甚至支持笑声、叹气等副语言元素的精确控制。
超越传统TTS的革命性突破
传统文本转语音(TTS)技术主要针对单人、单轮的语音生成,难以应对真实对话中的复杂性和自然性。SoulX-Podcast则专为播客式多轮对话设计,突破了现有技术的限制。
SoulX-Podcast能连续生成超过90分钟的对话,保持稳定的说话人音色和流畅的说话人转换,同时根据对话内容自然调整语调和节奏。
三大核心技术亮点
1. 多方言零样本语音克隆:SoulX-Podcast支持普通话、英语以及四川话、河南话、粤语等多种方言。更令人惊叹的是,它能实现"跨方言零样本语音克隆"——只需一段普通话参考音频,就能生成任何目标方言的语音。例如,一段普通话的音频可以被转换为地道的四川话、河南话或粤语,无需额外训练。
2. 精准的副语言控制:系统支持笑声、叹气、呼吸、咳嗽等副语言元素的精确控制,使生成的语音更加自然。在测试中,系统对"笑声"的控制准确率达到100%,对"叹气"和"清嗓子"的准确率也分别达到85%和80%。
3. 长对话稳定性:与现有系统相比,SoulX-Podcast在长对话生成方面表现卓越。它能够保持说话人音色稳定,实现平滑的说话人转换,避免了传统系统在长对话中常见的音色不一致、对话断裂等问题。
实际测试:超越行业标杆
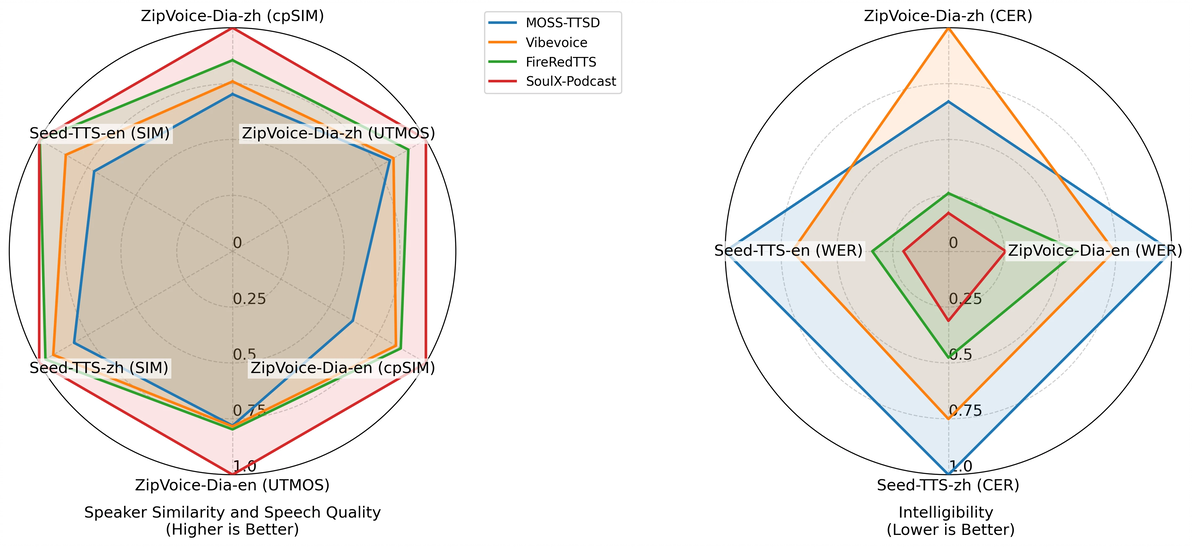
在权威测试中,SoulX-Podcast在单语TTS任务上表现优异,中文CER(字符错误率)仅为1.10,英文WER(词错误率)为1.91,均优于现有主流模型。在多说话人对话生成任务中,其CER低至2.20,cpSIM(说话人一致性指标)高达0.599,远超竞争对手。
这意味着,你听到的播客对话几乎不会出现语音错误,说话人的声音特征也保持一致,听起来就像真正的播客。
从科研到应用:未来可期
SoulX-Podcast已在Hugging Face平台上线最新版本,相关论文也于发表在arXiv上。研究团队表示,他们正在开发Web界面和在线演示,让更多人能够体验这一技术。
我们相信,SoulX-Podcast将为播客制作、教育、辅助技术、语言研究等领域带来革命性变化。
伦理与责任:技术向善
值得注意的是,项目团队在发布时也强调了技术的伦理使用。"我们提供的模型仅用于学术研究、教育目的和合法应用,如个性化语音合成、辅助技术、语言研究等。"团队在声明中明确表示,"请勿将此模型用于未经授权的语音克隆、冒充、欺诈、诈骗、深度伪造或任何非法活动。"
这项技术的出现,标志着语音合成领域从"能说话"向"会对话"的跨越。随着SoulX-Podcast的普及,未来我们或许能听到更多个性化、多语言、多风格的AI播客,让语音内容创作变得更加丰富和便捷。
正如一位语音技术专家所言:"SoulX-Podcast不仅是一个技术突破,更是打开了人机对话新世界的大门。"
