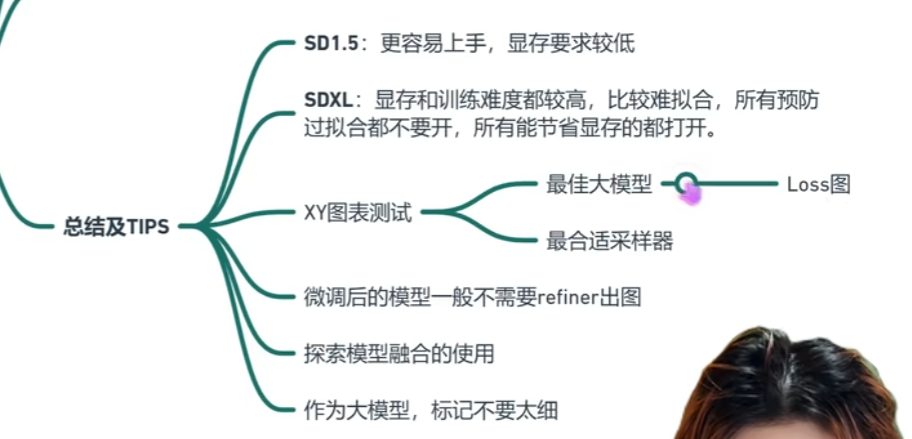
Dreambooth训练
一、Dreambooth的优缺点及适用范围
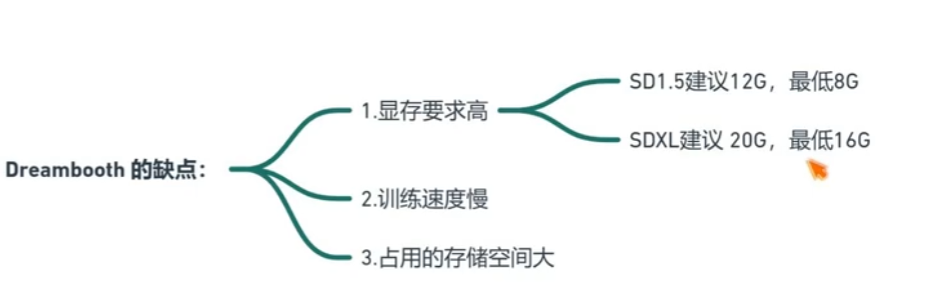
1、缺点
显存要求高
SD1.5建议12G,最低8G;SDXL建议20G,最低16G。
训练速度慢
SDXL训练,千张图,用4090显卡跑一次训练也要两天时间。
占用的存储空间大
Dreambooth 训练生成的模型文件大小通常为 2GB 到 5GB
2、优点
多概念训练
而Lora则更适合单概念、但风格的训练
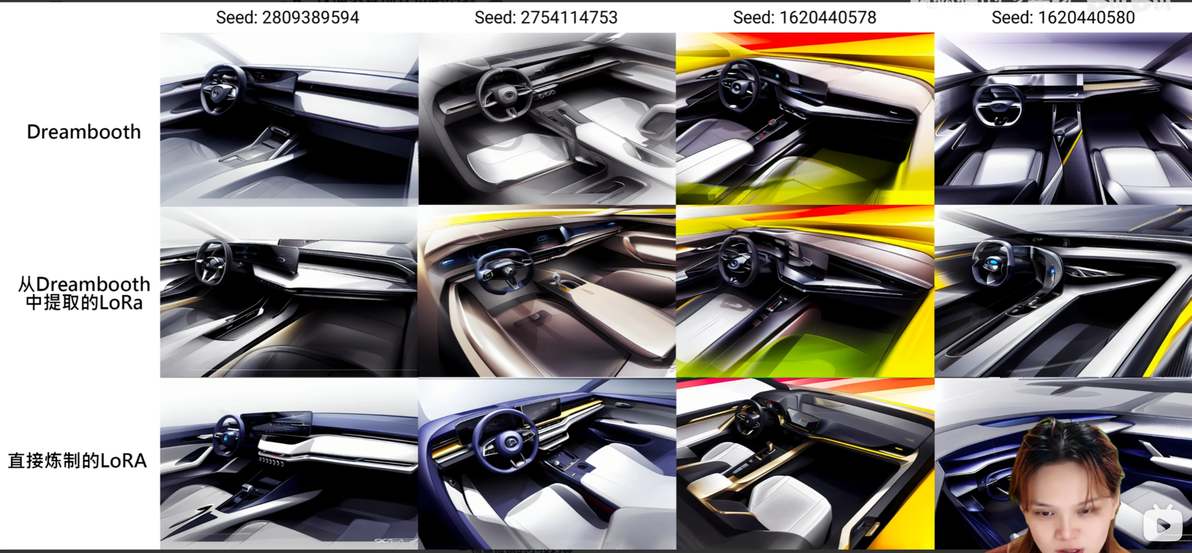
单概念训练效果更好
Dreambooth>从DB中提取的Lora>Lora
与使用相同的数据集的Lora相比,效果更好,但是没必要。
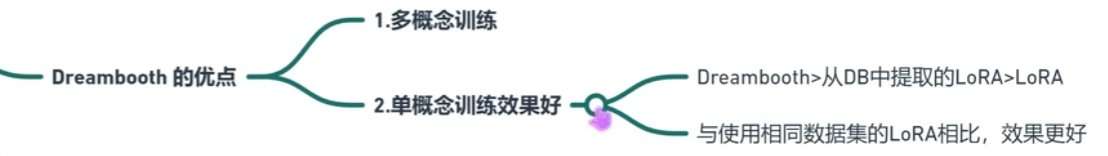
同样的数据集下训练出来的效果都差不多,而Lora具有显存消耗低,训练方便,体量小,又可以与不同的底模配合出图的优势。综合来说,单概念还是Lora更好。
3、适用范围
通常情况下,我们的出图方式是底模+Lora的组合。
底模决定大类别,如二次元、产品、真实摄影等等。
而Lora则更注重于细节,如某个人、某个产品或某种风格。
底模和Lora的结合效果往往比单独使用底模更好,也比不适合的底模加Lora组合要好。
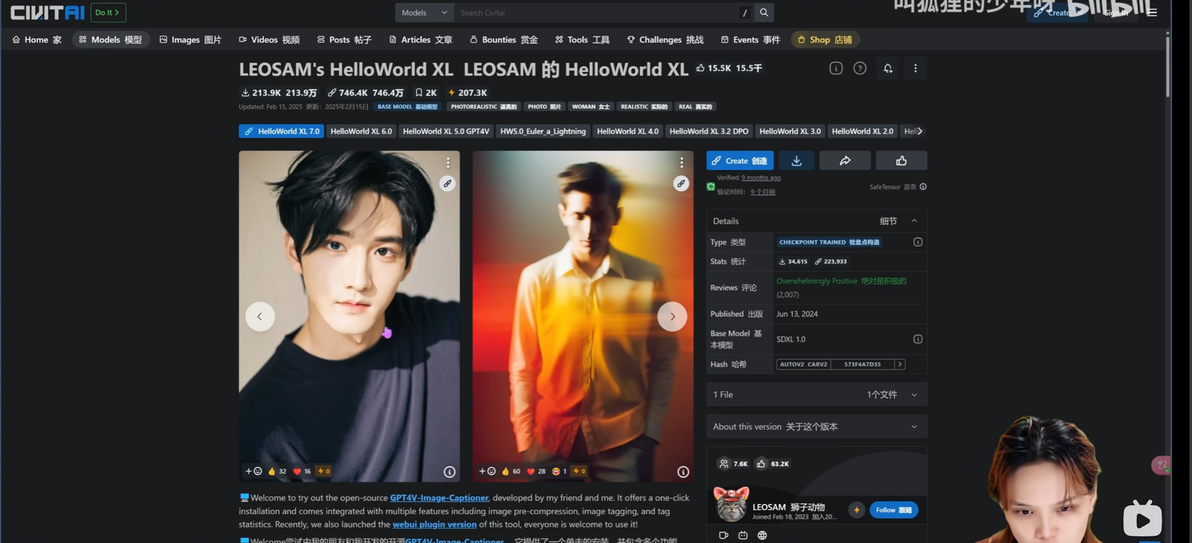
比如针对亚洲人像优化的helloworld,如果我们想在此基础上做一个亚洲细分民族的Lora微调,基于helloworld做调整,会比直接使用官模效果好很多。
什么时候适合Dreambooth?
特定领域找不到合适底模
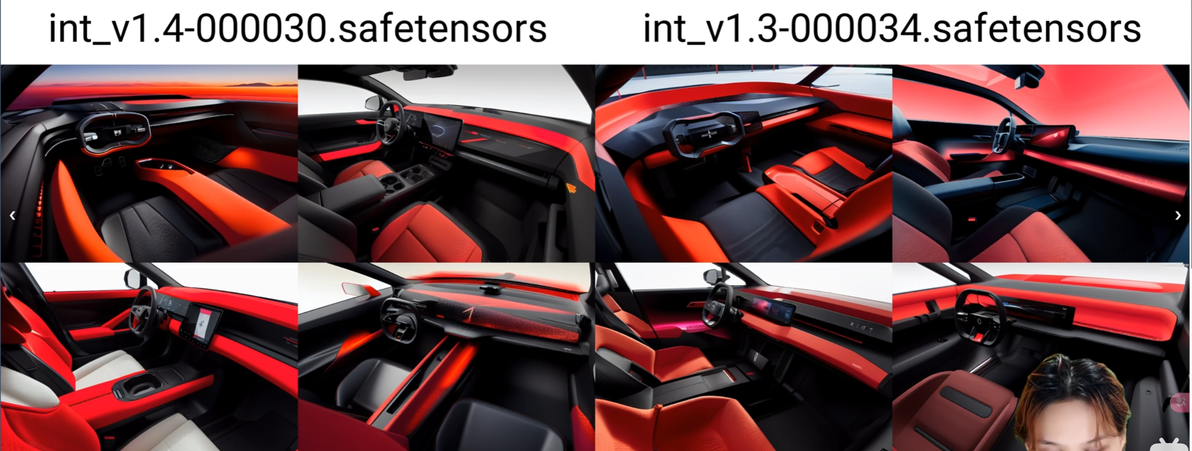
比如,做汽车领域,发现全网几乎没有汽车内饰相关的底模,这个时候就只能自己去训练一个专注于汽车内饰的底模。训练好后,再对这个底模针对性训练相应的Lora,进一步优化效果。
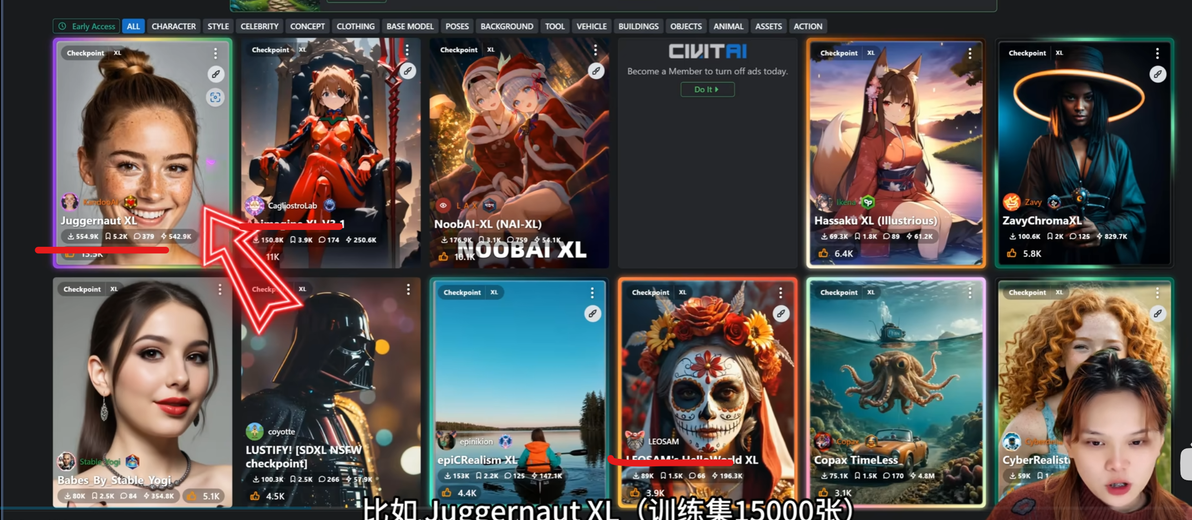
多概念大模型一般训练集都非常庞大,比如Juggernaut XL(训练集15000张),HelloWorld(20000张),Animagine XL(总量200万张)。
对于个人训练师来说,训练Dreambooth建议从数百到小千的图片规模开始。如果是小于一百的单概念、但风格,直接用Lora就用。
同一方向下的概念训练
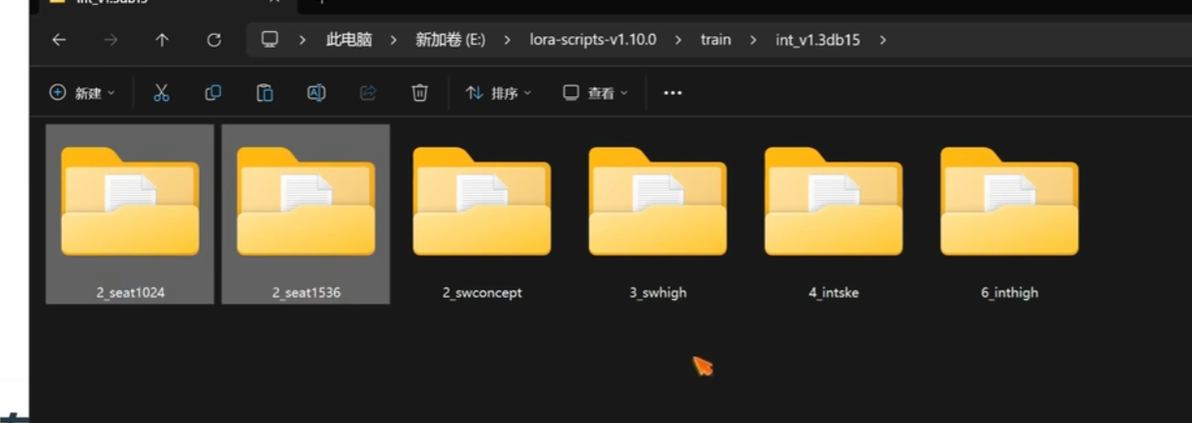
比如:这些文件包含了3个主要概念:汽车内饰、汽车座椅、汽车方向盘。
由于官模产出的汽车内饰太过老套,而近几年的汽车内饰的发展趋势是机械按键更少,操纵集成进屏幕,设计更简洁等等。所以训练目的是能够产出更具现代电车的感觉。
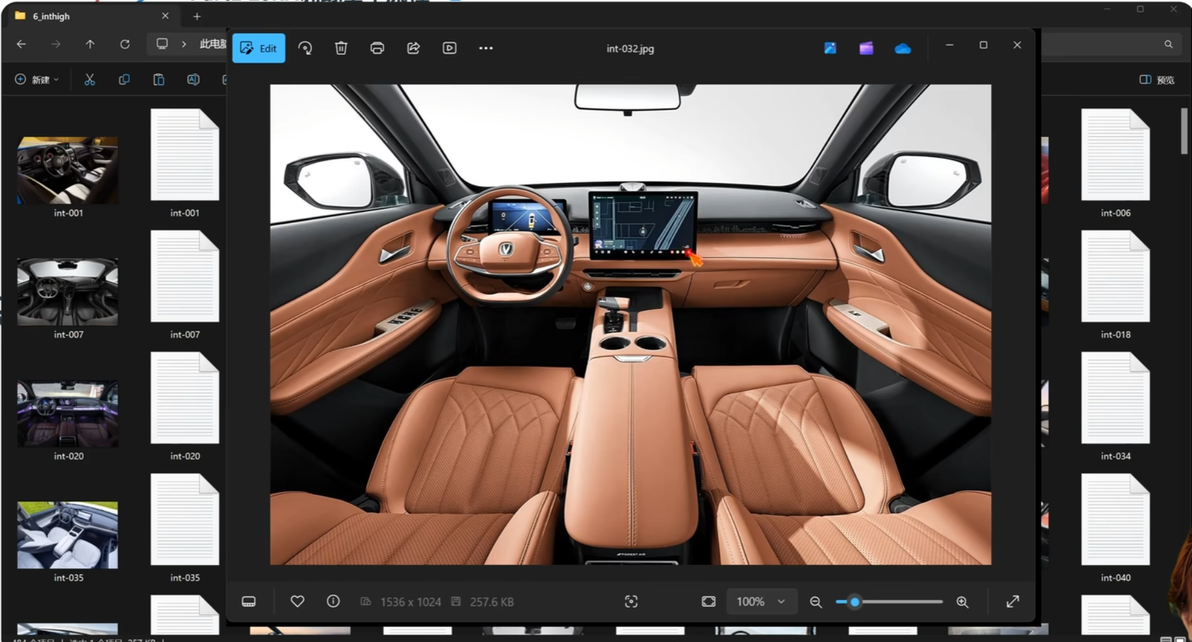
所以高质量的内饰图重复次数最高。
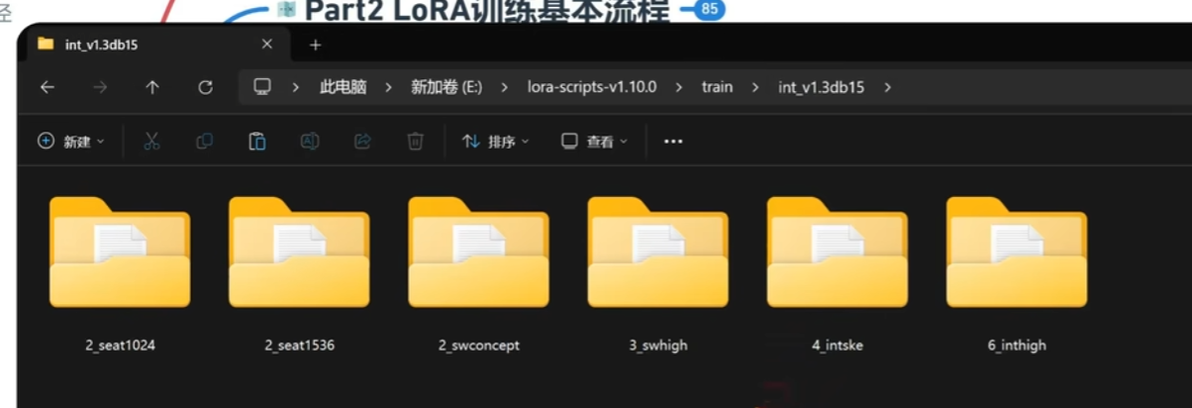
里面还细分了几个小概念,包含高质量渲染的CG图、摄影官图以及手绘风格的渲染图。
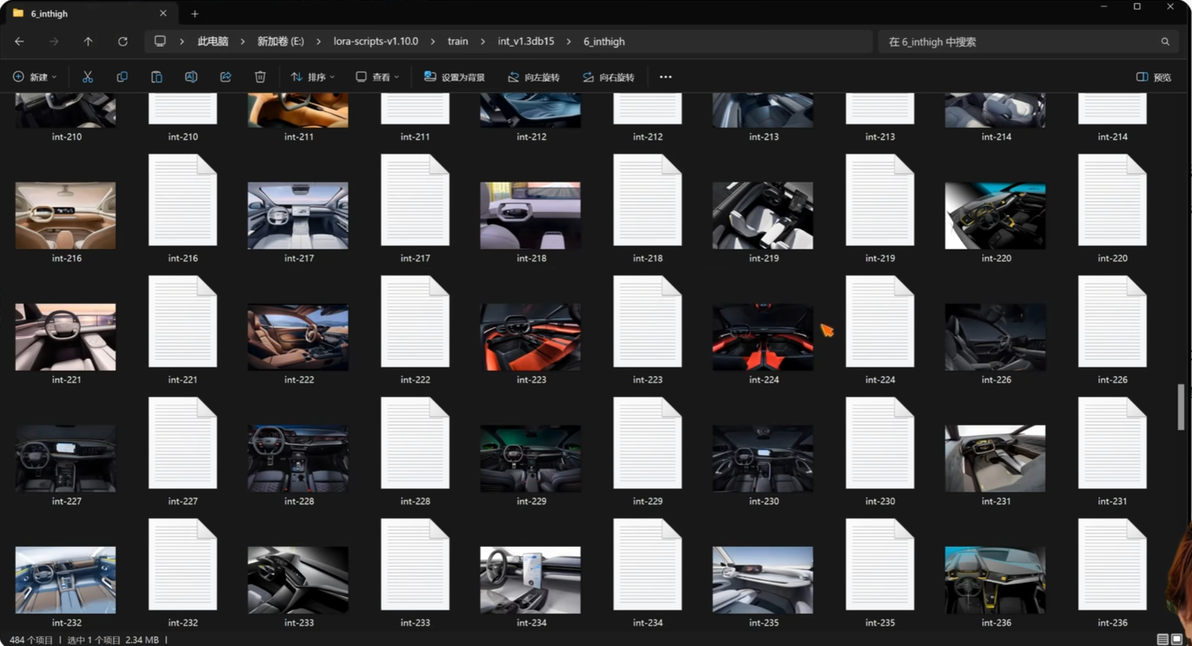
分几个文件夹是为了分别控制权重,也方便在打标时,分类去控制标记。
这种训练出来的大模型比较专精,训练出来的模型在实际使用时,可以根据需要,在底模上再训练Lora。
比如加载一个基于这个大模型的汽车渲染风格Lora,然后结合出图,这样出图的效果会比其余的真实系大模型上训练Lora的效果更好。
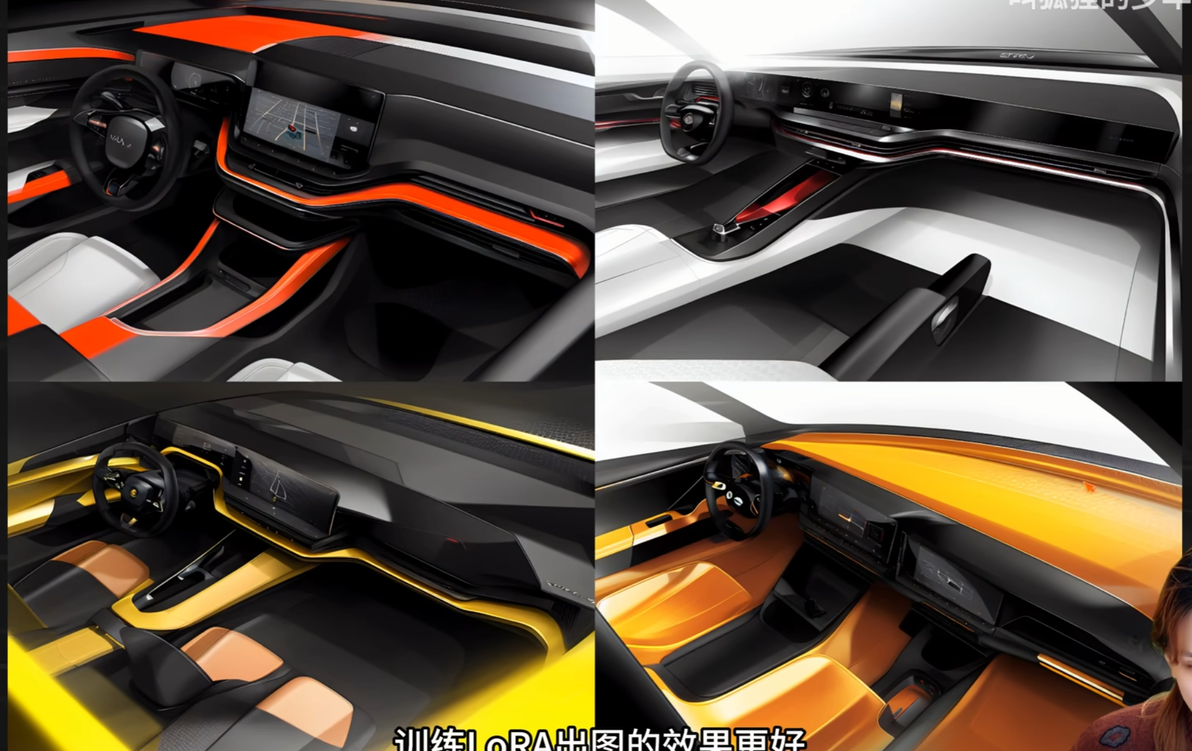
简言之,如果不是需要做特定领域的多概念训练,没必要去做完整微调,因为很多工作室数万或数百万做的大模型效果已经很好了。
二、Dreambooth参数设定
虽然Dreambooth没有专用参数,但有些设置还是不一样的。
训练种类主流的三类:SD1.5、SDXL、FLUX。
目前秋叶没有集成FLUX。
底模文件路径:选择与目标概念相近的底模。
比如炼制一个汽车内饰的大模型,就需要选择一个真实系的底模
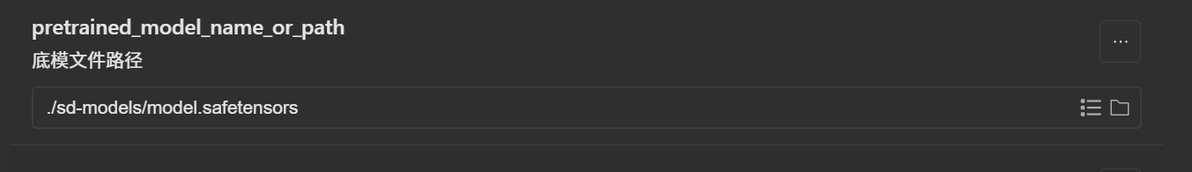
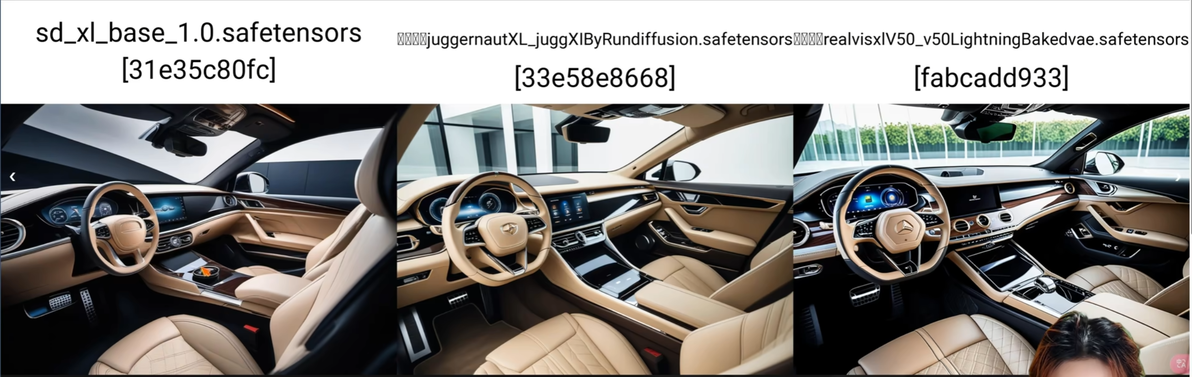
up选择大模型,一般会用XY图分析哪个出图效果更好。
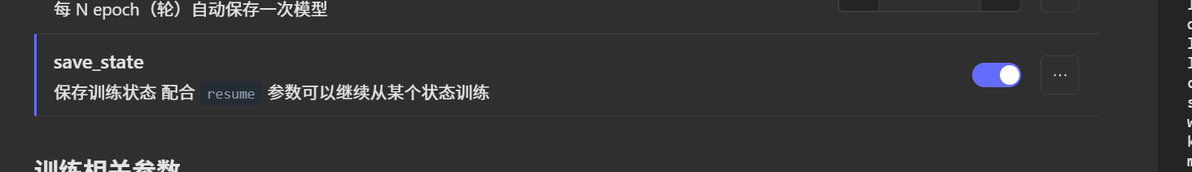
如果训练时间超过48小时,建议开启resume功能,避免断电或电脑崩溃带来的时间损失。
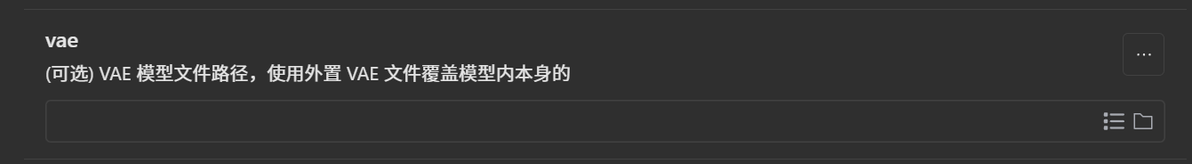
VAE:官模一般内置VAE,如果需要换一个VAE,可以通过此处加载其他VAE,让训练出来的大模型也内置VAE。
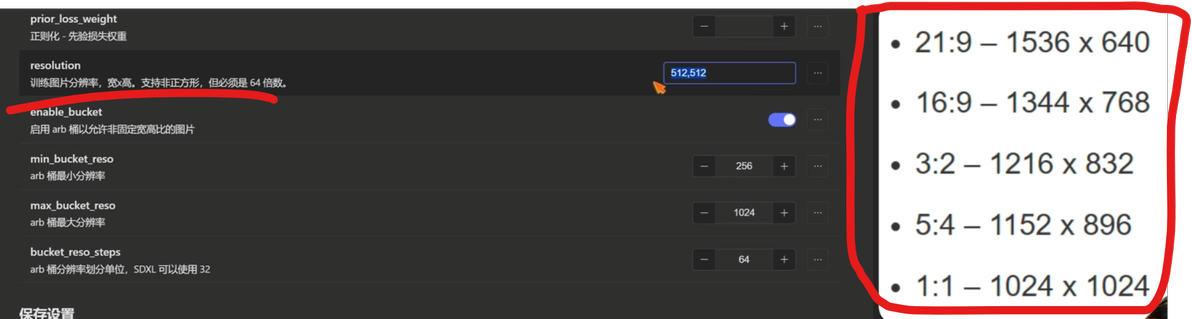
训练分辨率:SD1.5根据需要从512、768随意组合。
SDXL建议100万像素以上,下面是推荐组合。
注意:越高的分辨率越难拟合,也越难拟合。
如果需要同时微调两个版本的模型,最好把原始数据集处理成过百万分辨率的图片,因为高质量的图片能够帮助模型更好的学习细节,在通过arb桶,将高分辨率数据集分别调整为SD1.5和XL所需的分辨率。
比如数据集都是1536×1024,通过arb桶分别处理成(768×512或者1216×832),做到同一数据集,不同模型,省时间。
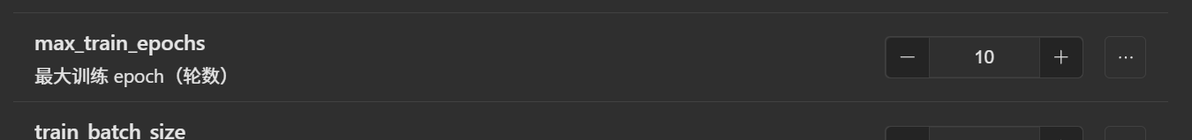
最大训练(epoch)轮次:在重复次数为5的情况下,一般设置最大训练轮次设置为60轮。1.5和XL都适用。
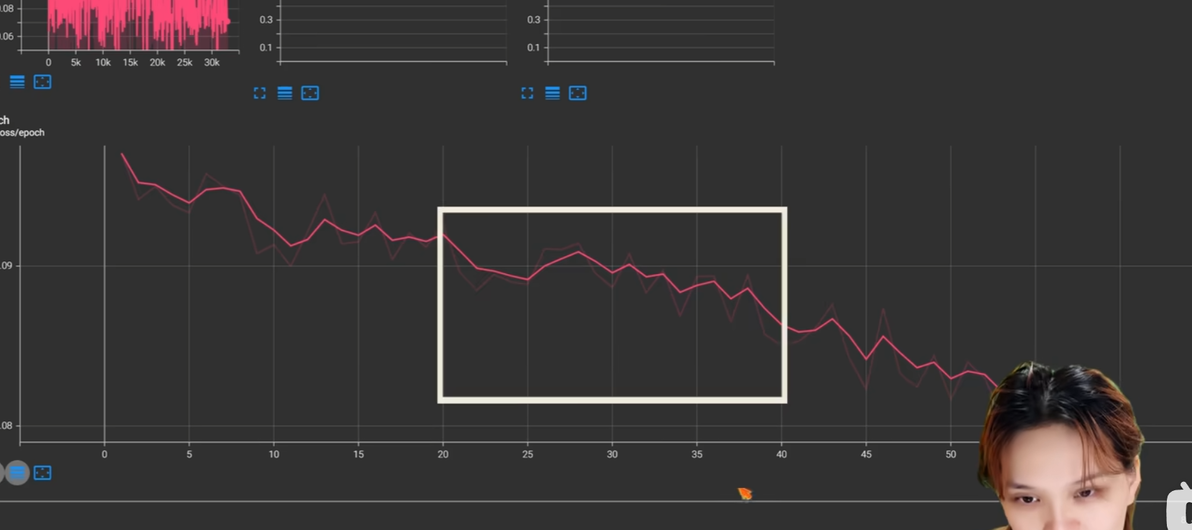
通常拟合的区间在中段,也就是20到40轮左右。
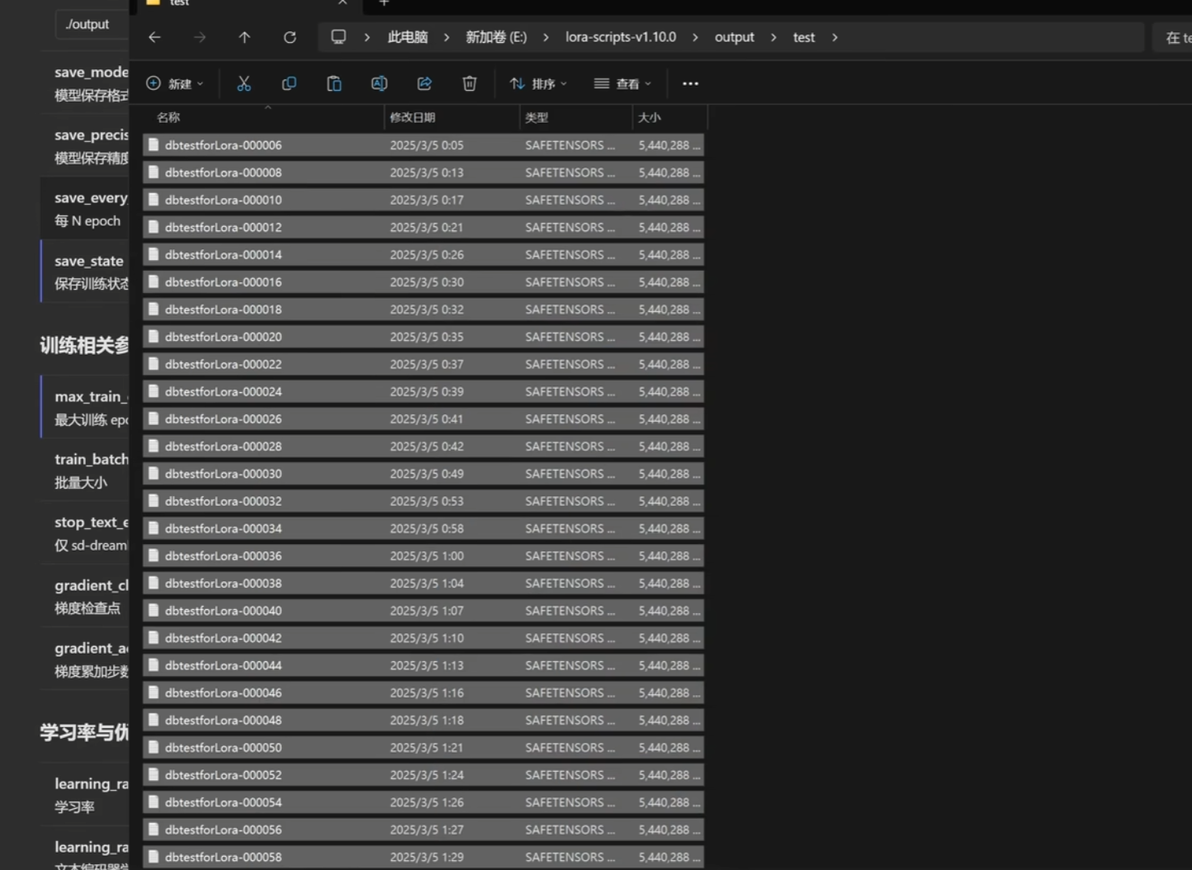
每2轮保存一次模型,总共会产生30个大模型,SD1.5和SDXL分别需要大约150G和200G的存储空间。
如果训练的概念比较多,且概念之间的差异比较大,可以适当增加重复次数,来帮助模型更好的拟合。
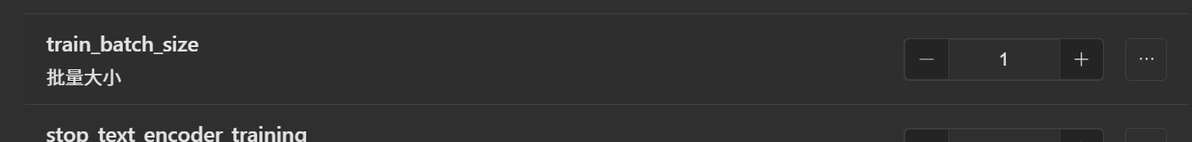
Batch Size:一般设置4~6,批次稍微大一点,训练会更稳定,速度也会更快。如果用4090显卡训练SDXL,在训练文本编码器(TE)的情况下,显存极限是6。需要根据显卡情况来调整Batch Size。
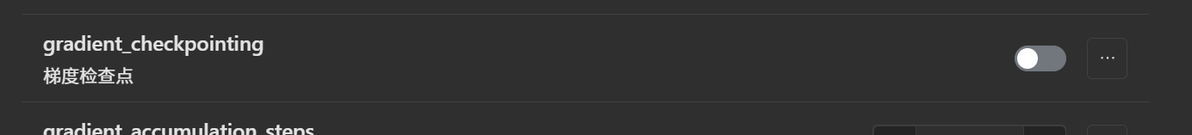
梯度检查点:训练SDXL时,建议打开,以减少显存使用。
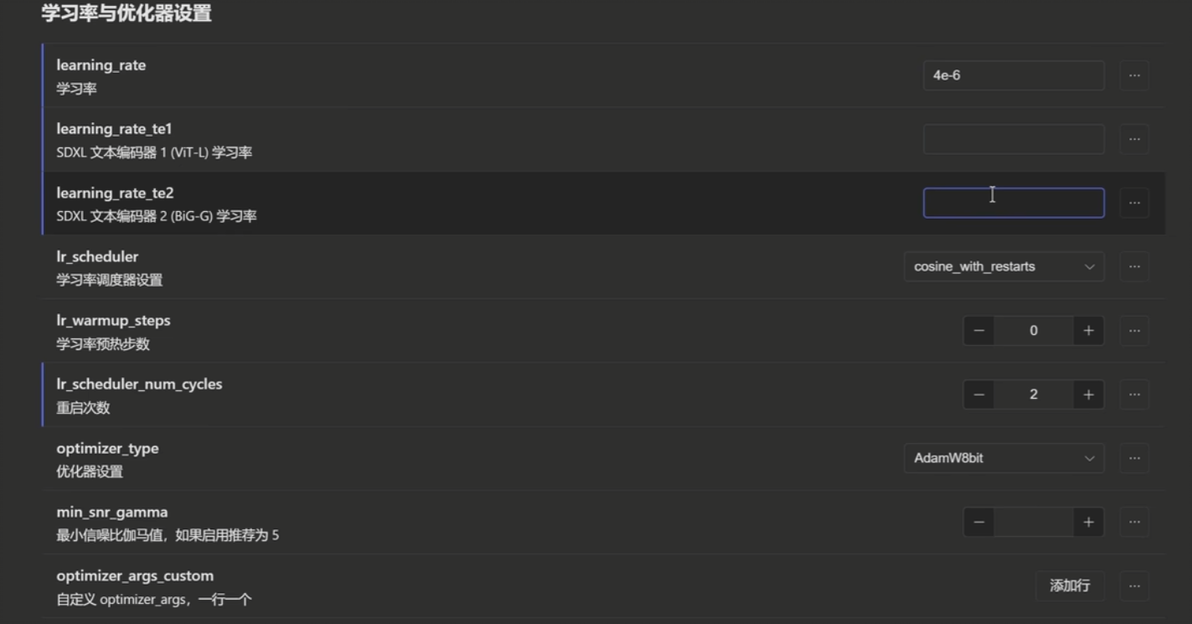
优化器:使用AdamW8bit, 使用神童优化器即使Batch Size开到1,也会爆显存。
调度器:保持默认的重启调度器。
重启次数建议2到3次,Dreambooth的初始学习率比较小,训练时容易“卡”在某个局部最优解。
学习率:从秋叶训练器推荐的默认参数开始,在提高Batch Size时,同步调整学习率倍率。比如Batch Size为4,把UNET学习率调整为4e-6。
如果文本编码器学习率为空,则只训练UNET,可以节约显存。但如果需要训练识别词,比如迪丽热巴的具象Lora,需要特殊的词来让模型建立图像与词的联系,这时是必须要开TE的。
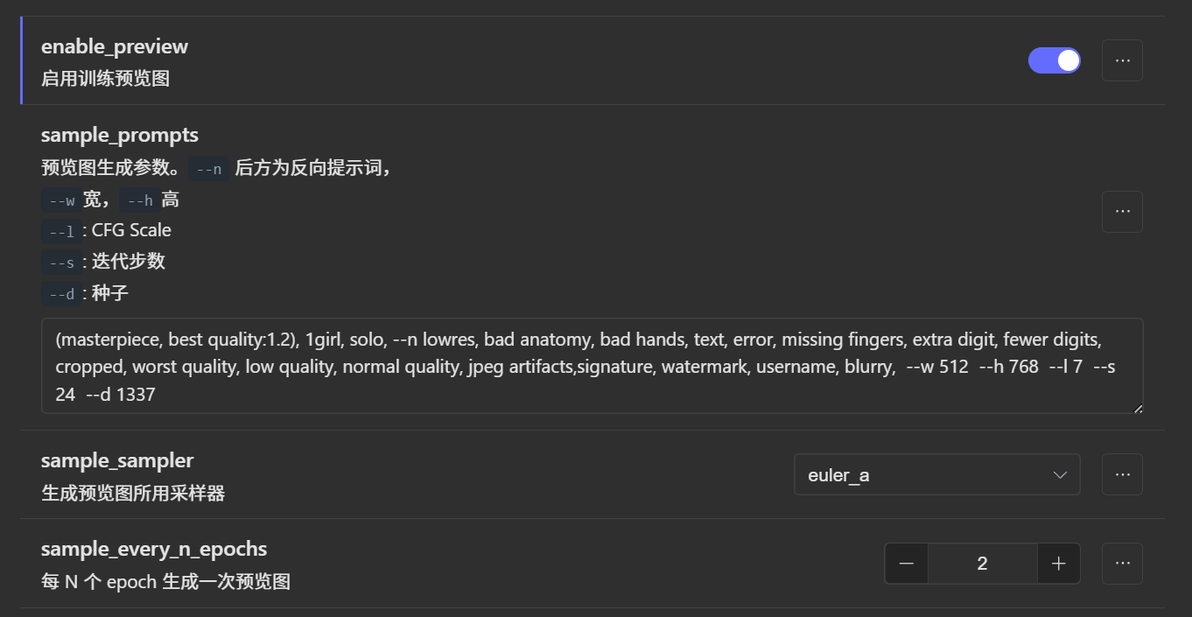
训练预览图:一定要开。
预览图的分辨率建议和训练分辨率一致。
随机打乱tokens:SD1.5建议开启,XL不建议开启,因为SDXL本身就很难拟合。

按逗号分隔标签,随机丢弃tag的概率:训练SD1.5时,可以设为0.1~0.2,防止tag过拟合,增加画风表现。
如v1.4设置为0.4,v1.3设置为没有,其余参数不变,v1.4在汽车内饰表现更好。
SDXL不建议开启随机丢弃tag的概率,任何防止过拟合的设置都不建议在SDXL中使用,因为难拟合。
混合精度:建议使用bf16,省显存。
三、总结