说明
Standalone模式
自包含架构 该模式采用 Master/Worker 架构(主节点/工作节点),包含完整的内置资源管理组件,无需依赖 Hadoop YARN 或 Apache Mesos 等外部资源调度系统。
独立部署能力 可独立部署于任何物理或虚拟集群环境,不需要任何第三方资源管理框架支持,实现了开箱即用的集群管理能力。
适用场景 特别适合中小型企业快速构建集群环境或在未部署企业级资源调度系统的场景下使用,其极简部署流程显著降低了集群搭建门槛。
核心限制 由于内置调度器无法实现跨应用的资源动态分配,在多框架共享集群时资源隔离能力不足,容易导致计算资源利用率低下。
Mesos
YARN
统一的资源管理机制, 在上面可以运行多套计算框架, 如map reduce、storm,spark、flink 等, 根据 driver 在集群中的位置不同,分为 yarn client 和 yarn cluster,其实本质就是drive不同。
K8S
K8S 是 Spark 上全新的集群管理和调度系统
运行机制
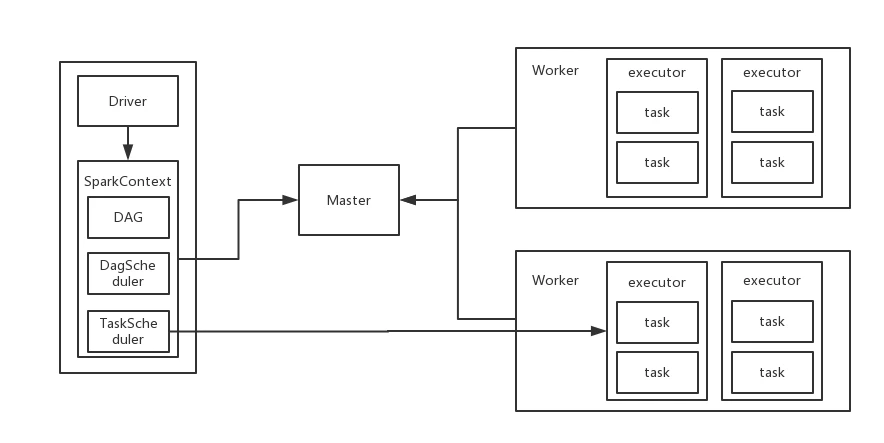
Driver: 是一个进程,我们编写的 Spark 应用程序就运行在 Driver 上, 由Driver 进程执行;
Master:是一个进程,主要负责资源的调度和分配,并进行集群的监控等职责;
Worker:是一个进程,一个 Worker 运行在集群中的一台服务器上,主要负责两个职责,一个是用自己的内存存储 RDD 的某个或某些 partition;另一个是启动其他进程和线程(Executor) ,对 RDD 上的 partition 进行并行的处理和计算。
Executor:是一个进程, 一个 Worker 上可以运行多个 Executor, Executor 通过启动多个线程( task)来执行对 RDD 的 partition 进行并行计算,也就是执行我们对 RDD 定义的例如 map、flatMap、reduce 等算子操作。
安装JDK环境
下载JDK
https://repo.huaweicloud.com:8443/artifactory/java-local/jdk/8u191-b12/jdk-8u191-linux-x64.tar.gz
安装JDK
mkdir -p /home/master/service/jdk
cd /home/master/service/jdk
#下载
wget https://repo.huaweicloud.com:8443/artifactory/java-local/jdk/8u191-b12/jdk-8u191-linux-x64.tar.gz
#解压
tar -xvf jdk-8u191-linux-x64.tar.gz
#配置环境
vim /etc/profile
export JAVA_HOME=/home/master/service/jdk/jdk1.8.0_191
export JRE_HOME=${JAVA_HOME}/jre
export CLASSPATH=.:${JAVA_HOME}/lib:${JRE_HOME}/lib:$CLASSPATH
export JAVA_PATH=${JAVA_HOME}/bin:${JRE_HOME}/bin
export PATH=$PATH:${JAVA_PATH}
#验证
java -version
机器角色划分
机器IP机器名节点类型192.168.1.120hadoop-node1Master/Worker
配置hostname
# 编辑主机名配置文件
sudo vim /etc/hostname
devutil
# 修改相关配置
sudo vim /etc/hosts
192.168.1.120 devutil # <-- 这里替换为实际IP和新主机名
下载Spark
官方下载地址:http://spark.apache.org/downloads.html
国内下载地址:https://mirrors.huaweicloud.com/apache/spark/spark-3.4.3/spark-3.4.3-bin-hadoop3.tgz
选择的版本是Spark3.4.3,Scala版本是2.14,在后续程序集成时也要选择对应的版本包
mkdir -p /home/master/service/spark-master
cd /home/master/service/spark-master
#下载
wget https://mirrors.huaweicloud.com/apache/spark/spark-3.4.3/spark-3.4.3-bin-hadoop3.tgz
#解压
tar -zxvf spark-3.4.3-bin-hadoop3.tgz
配置Spark
配置spark-env.sh
cd /home/master/service/spark-master/spark-3.4.3-bin-hadoop3/conf
# 创建data目录(所有节点都得创建这个目录)
mkdir -p /home/master/service/spark-master/data
# copy一份环境变量文件
cp spark-env.sh.template spark-env.sh
# 加入以下内容:
export SPARK_MASTER_HOST=devutil
export SPARK_LOCAL_DIRS=/home/master/service/spark-master/data
export JAVA_HOME=/home/master/service/jdk/jdk1.8.0_191
配置spark-defaults.conf
这里不做修改,默认端口7077
cp spark-defaults.conf.template spark-defaults.conf
cat spark-defaults.conf
启动
启动master节点
cd /home/master/service/spark-master/spark-3.4.3-bin-hadoop3/sbin
./start-master.sh
# 查看进程端口,spark master web ui 默认端口为8080
ss -tnlp|grep :8080
如果端口冲突,修改start-master.sh脚本里的端口即可
grep SPARK_MASTER_WEBUI_PORT start-master.sh
开放端口8080,访问spark master web ui:
启动Worker节点
cd /home/master/service/spark-master/spark-3.4.3-bin-hadoop3/sbin
./start-worker.sh spark://devutil:7077