
1.Question
时间序列的数据分析中,ARMA和ARIMA是常用的统计模型,主要用于描述和预测时间序列模型。当我们拿到一个时间序列数据,首先要观察时间序列数据是否平稳(均值和方差不随着时间变化),如果时间序列本身是平稳的,直接用ARMA模型;如果不平稳则需要平稳化处理,一般是使用差分处理(差分之后数据之间的时间自相关性会减少,消除趋势,让时间序列更接近平稳状态),如果时间序列有季节性,除了普通的差分之外,还要进行季节差分来消除季节性波动的影响,到此时我们就可以使用ARIMA模型。
但是无论使用ARMA还是ARIMA模型,都要确定时间自相关的阶数,因为它们都是由AR(p)(自回归)和MA(q)(移动平均)模型组成的,而AR模型是要确定当前值 Yt 受到过去多少个时间点(滞后期)的直接影响,如果阶数 p 过低,可能会遗漏一些重要的滞后信息,如果阶数 p 过高,可能会引入不必要的噪声,导致模型复杂化和过拟合;MA模型是要当前值 Yt 受到过去多少个误差项(残差)的影响。选择合适的 q 值能够有效捕捉到时间序列中由随机波动引起的模式。
因此,确定p和q值就至关重要!具体原理和方法如下。
2.Answer
其实确定p和q的方法比较简单。对已经平稳的数据进行自相关和偏相关计算,得到PACF和ACF图或者表,通过图表即可判断。关键是其中的原理如何以更简单的方式被理解,因此,在这记录,用于强化自己的理解,如有问题,欢迎看客老爷随时批评指正。
2.1 确定q的原理与方法
2.1.1 寻找q的意义和本质
q 反映了模型在做预测时,如何利用过去预测中的误差信息来改进当前预测。它并不直接看过去的数据值,而是看之前预测与实际值的“偏差”。当 q = 1 时,模型在预测今天的值时,会参考昨天预测错了多少,从而调整今天的预测。类似地,如果 q = 2 则模型会参考昨天和前天的预测误差,来修正今天的预测。
比如你预测了未来三天的天气温度,昨天你预测20℃,实际是22℃,差了 -2℃。前天你预测25℃,实际是27℃,差了 -2℃。在今天的预测中,q=2 的模型会参考昨天和前天的误差(都是 -2℃),假设误差有延续性,那么今天的预测会加上这两个偏差进行调整,以避免类似的误差再次发生。
所以,q 的本质是让模型“记住”过去预测中的偏差,利用这些偏差来调整当前预测,避免同样的错误重复发生。确定 q 的过程就是在寻找滞后多少阶的偏差(误差项)对当前值有显著影响。
2.1.2 MA模型的计算公式
在Question中,我提到是MA模型需要确定 q 值,确定 q 值的核心在于找到当前的值 Yt 和之前多少个误差项(即误差的滞后项)相关。因此,MA模型的公式主要围绕当前值和过去的误差项展开:
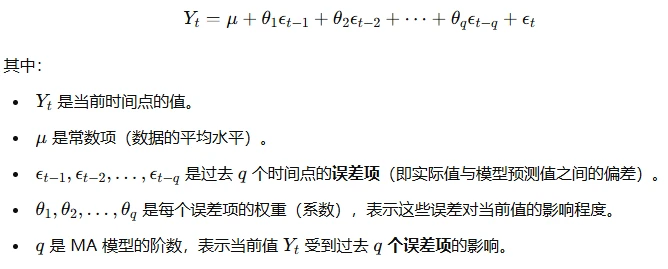
冷冰冰的公式如何理解呢?这里我们举个简单的例子,草履虫都能懂的那种。
假设我们观察到最近几天的销售情况如下:
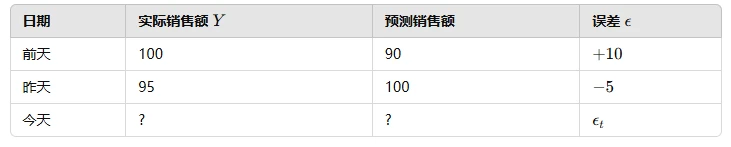
我们用MA(2)模型预测今天的销售额,利用前两天的误差 +10 和 −5。根据 MA(2)模型,今天的销售额可以通过前两天的误差项来计算:
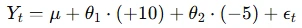
假设我们已知:平均销售水平 μ=98 元,系数 θ1=0.6 和 θ2=0.4,表示昨天的误差对今天的影响比前天的误差大。则今天的预测值(不考虑今天的误差项)为:Yt = 98+0.6×10+0.4×(−5) = 102,所以,今天的销售预测值为102元,它是基于前两天的误差项计算得出的。
至于这里的参数θ如何求解,本人也不是很精通,但是大概知道是如何求解的(因为MA模型可以通过计算转换为AR模型,而AR模型的参数可以用OLS或者Yule-Walker 方程等求解,所以可以求得参数θ)。
2.1.3 通过ACF图确定q值
详细的ACF计算公式参考https://zhuanlan.zhihu.com/p/430503143,因为MA模型需要寻找滞后多少阶的偏差(误差项)对当前值有显著影响,这就可以转换为滞后多少阶的数据和当前数据有相关性,这样就可以利用当前数据和滞后时期的数据组成数据对,放在ACF公式中计算相关性和显著性。如果显著相关,表明滞后多少阶的数据和当前数据有相关性,也就意味着滞后多少阶的偏差(误差项)对当前值有显著影响。自然就找到我们需要的q值!
我们通过软件或者代码很容易得到ACF图,比如这里我们用Python示例时间序列数据绘制出一张ACF图:
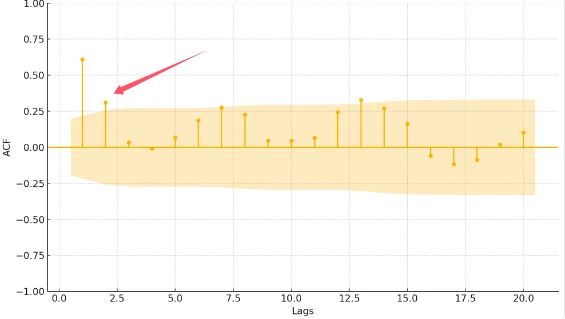
在这个图中,阴影部分为置信区间,一般是95%的置信区间,它显示了在滞后阶数上,相关系数是否显著。
我们可以观察到滞后1或滞后2的相关(实际上来源于误差项的滞后影响)系数较大且显著偏离0,到滞后3的自相关就不显著了,相当于自相关系数和0没有区别。所以我们可以确定q值为2。
2.2 确定p的原理与方法
2.2.1 寻找p的意义和本质
在时间序列分析中,寻找p(AR的阶数)是为了确定当前值 Yt 受过去多少个时间点的数据直接影响,注意这里是直接影响!即找出与当前值显著相关的滞后数据。也即当前状态与过去哪些时刻有显著关联。
在 AR模型中,当前值 Yt 是过去 p 个滞后值的线性组合(我个人认为不一定就非要是线性模型,只是用线性模型比较简单直接),因此 p 的大小决定了模型参考的历史范围。寻找合适的 p 值可以帮助我们捕捉时间序列中的直接相关性,而不会引入过多无关的滞后数据点,保持模型的简洁和有效性。过小的 p 值可能导致欠拟合,无法捕捉到重要的历史信息;过大的 p 值则可能导致过拟合,引入不必要的噪声。
所以,p的本质是衡量时间序列中当前值对过去数据的直接依赖程度。确定 p 的过程就是在找滞后多少阶的历史数据对当前值有显著影响。
那这里和q有什么区别吗?在2.1.3中,我们说到q可以转化为寻找滞后多少阶的数据和当前数据有相关性,这种相关性不管是直接的影响还是间接影响,但是p是希望找到直接影响,我们是希望剔除通过中间项传递的间接影响的。
2.2.2 AR模型的计算公式
参考https://zhuanlan.zhihu.com/p/581510541
定义:对于时间序列,一个值得研究的问题是:Xt与时刻t之前的数据是否有关若存在关系,自然的想法是建立Xt与时刻t之前的数据之间的模型,以此来预测将来时刻的取值。
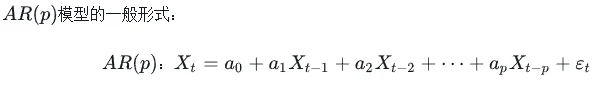
这里很好理解,不过多赘述。
2.2.3 通过PACF图确定p值
时间序列中的前后数据是会存在关系的,比如我们用ACF那种方法计算Yt和滞后两期Y(t-2)的数据相关性,这种相关性不仅包含Yt和Y(t-2)的直接关系,还会包含通过 Y(t−1)传递的间接影响(意思就是Y(t-2)会影响Y(t-1),而Y(t-1)又会影响Yt)。所以,偏自相关系数就是用来求解Y(t-2)对Yt简单直接影响。求解方法就是,当滞后几阶,我们就建立几阶多元回归。
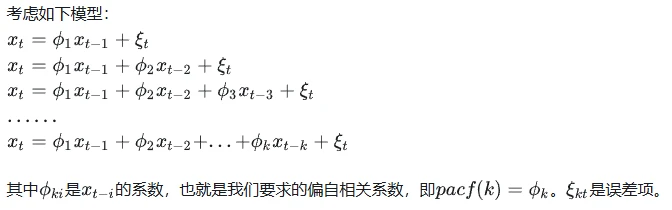
将时间序列与滞后时期以及之间的所有数据组成数据对,放进去计算,到这里就是我们熟悉的地方了,直接用OLS求解参数即可。当然还有什么Yule-Walker, Burg"s method, Levinson-Durbin方法求解参数(这些方法本人都不会,只会OLS)。
然后我们通过PACF图判断参数的影响以及显著性即可得到p。
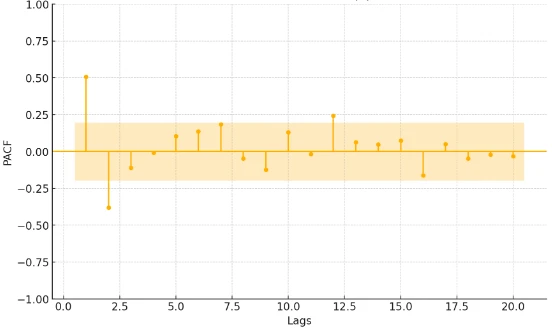
通过这张PACF图,很明显当滞后1期或滞后2期的参数都是有显著影响的,当滞后3期的时候,当前时间数据和滞后3期数据之间的直接关系就不显著,表示和0没有区别。
所以,p值可确定为2
3. Reference
[1] https://zhuanlan.zhihu.com/p/430503143
[2] https://zhuanlan.zhihu.com/p/581510541
[3] chatgpt 4o
