北太天元科普:最小二乘法和线性回归
北太天元卢朓
2024年10月16日 08:57
收录于文集
共74篇

线性回归作为统计学的基础算法,其理论推导主要涉及到模型假设、损失函数、参数估计等方面。以下是线性回归理论的详细推导:

1. 模型假设

线性回归模型假设因变量 \(Y\) 与自变量 \(X_1, X_2, \ldots, X_n\) 之间存在线性关系,即:

Y%20%3D%20%5Cbeta_0%20%2B%20%5Cbeta_1X_1%20%2B%20%5Cbeta_2X_2%20%2B%20%5Cldots%20%2B%20%5Cbeta_nX_n%20%2B%20%5Cepsilon

其中,%5Cbeta_0%2C%20%5Cbeta_1%2C%20%5Cldots%2C%20%5Cbeta_n 是模型参数,%5Cepsilon 是误差项。线性回归模型通常还假设误差项%5Cepsilon服从均值为0的正态分布,即 %5Cepsilon%20%5Csim%20N(0%2C%20%5Csigma%5E2),且各误差项之间相互独立。

2. 损失函数

为了估计模型参数,我们需要定义一个损失函数来衡量模型预测值与实际观测值之间的差异。在线性回归中,常用的损失函数是均方误差(Mean Squared Error, MSE),其数学表达式为:

J(%5Cbeta)%20%3D%20%5Cfrac%7B1%7D%7B2m%7D%20%5Csum_%7Bi%3D1%7D%5E%7Bm%7D%20(y_i%20-%20%5Chat%7By%7D_i)%5E2%5C

其中,m 是样本数量,y_i 是第 i 个样本的实际观测值,%5Chat%7By%7D_i 是第 i 个样本的模型预测值,即:

%5Chat%7By%7D_i%20%3D%20%5Cbeta_0%20%2B%20%5Cbeta_1x_%7Bi1%7D%20%2B%20%5Cbeta_2x_%7Bi2%7D%20%2B%20%5Cldots%20%2B%20%5Cbeta_nx_%7Bin%7D

损失函数 J(%5Cbeta) 表示了模型在所有样本上的平均预测误差的平方和。

 3. 参数估计

参数估计的目标是找到一组参数值  %5Cbeta_0%5E*%2C%20%5Cbeta_1%5E*%2C%20%5Cldots%2C%20%5Cbeta_n%5E* ,使得损失函数 J(%5Cbeta) 最小化。这通常通过最小化损失函数来实现。

首先,我们把损失函数$J(\beta)$的具体表达式写出来。损失函数是均方误差(Mean Squared Error, MSE),其数学表达式为:

J(%5Cbeta)%20%3D%20%5Cfrac%7B1%7D%7B2m%7D%20%5Csum_%7Bi%3D1%7D%5E%7Bm%7D%20(y_i%20-%20%5Chat%7By%7D_i)%5E2%5C

其中 %5Chat%7By%7D_i%20%3D%20%5Cbeta_0%20%2B%20%5Cbeta_1x_%7Bi1%7D%20%2B%20%5Cbeta_2x_%7Bi2%7D%20%2B%20%5Cldots%20%2B%20%5Cbeta_nx_%7Bin%7D

为了简化表示,我们可以引入向量和矩阵符号。令:

 y%20%3D%20%5Cbegin%7Bpmatrix%7D%20y_1%20%5C%5C%20y_2%20%5C%5C%20%5Cvdots%20%5C%5C%20y_m%20%5Cend%7Bpmatrix%7D%2C%20%5Cquad%20X%20%3D%20%5Cbegin%7Bpmatrix%7D%201%20%26%20x_%7B11%7D%20%26%20x_%7B12%7D%20%26%20%5Cldots%20%26%20x_%7B1n%7D%20%5C%5C%201%20%26%20x_%7B21%7D%20%26%20x_%7B22%7D%20%26%20%5Cldots%20%26%20x_%7B2n%7D%20%5C%5C%20%5Cvdots%20%26%20%5Cvdots%20%26%20%5Cvdots%20%26%20%5Cldots%20%26%20%5Cvdots%20%5C%5C%201%20%26%20x_%7Bm1%7D%20%26%20x_%7Bm2%7D%20%26%20%5Cldots%20%26%20x_%7Bmn%7D%20%5Cend%7Bpmatrix%7D%2C%20%5Cquad%20%5Cbeta%20%3D%20%5Cbegin%7Bpmatrix%7D%20%5Cbeta_0%20%5C%5C%20%5Cbeta_1%20%5C%5C%20%5Cbeta_2%20%5C%5C%20%5Cvdots%20%5C%5C%20%5Cbeta_n%20%5Cend%7Bpmatrix%7D 

则模型预测值可以表示为:

%5Chat%7By%7D%20%3D%20X%20%5Cbeta

损失函数可以重写为:

J(%5Cbeta)%20%3D%20%5Cfrac%7B1%7D%7B2m%7D%20%5C%7Cy%20-%20X%20%5Cbeta%5C%7C_2%5E2%20%3D%20%5Cfrac%7B1%7D%7B2m%7D%20(y-X%5Cbeta)%5E%7BT%7D(y-X%5Cbeta)

X被称为设计矩阵(Design Matrix),其每一行代表一个样本的自变量值,y 是实际观测值向量。

接下来,我们求损失函数的梯度。对于二次函数,梯度等于0的点就是最小值点。因此,我们对$J(\beta)$求梯度并令其为0:

%5Cnabla%20J(%5Cbeta)%20%3D%20%5Cfrac%7B1%7D%7Bm%7D%20X%5ET%20(X%20%5Cbeta%20-%20y)%20%3D%200

从而,我们得到:

X%5ETX%5Cbeta%20%3D%20X%5ETy

这就是正规方程(Normal Equation)。如果$X^T X$是可逆的(即满秩的),那么我们可以直接求解$\beta$:

%5Cbeta%20%3D%20(X%5ET%20X)%5E%7B-1%7D%20X%5ET%20y

这样,我们就找到了使得损失函数$J(\beta)$最小化的参数值$\beta^*$。这个方法就被乘坐 最小二乘法。 在我们使用最小二乘法的时候, 根本没有考虑误差项  . 如果考虑的话,则往往是统计课上讲线性回归时讨论的内容。

在线性回归模型中,假设因变量 $Y$ 与自变量 $X_1, X_2, \ldots, X_n$ 之间存在线性关系,

Y%20%3D%20%5Cbeta_0%20%2B%20%5Cbeta_1X_1%20%2B%20%5Cbeta_2X_2%20%2B%20%5Cldots%20%2B%20%5Cbeta_nX_n%20%2B%20%5Cepsilon

并且误差项 $\epsilon_i$ 是独立同分布且服从均值为0、方差为 %5Csigma%5E2 的正态分布。下面,我将展示在正态分布和独立同分布的假设下,最小二乘法与最大似然估计法(MLE)的等价性。

似然函数 L(%5Cbeta%2C%20%5Csigma%5E2) 是模型参数(在这里是 %5Cbeta 和 %5Csigma%5E2)的函数,它表示在给定参数下,观测到实际数据(即 $m$ 个观测值)的概率。由于误差项 %5Cepsilon_i 是独立同分布的正态随机变量,因此每个观测值 Y_i 的概率密度函数可以表示为:

f(Y_i%20%7C%20%5Cbeta%2C%20%5Csigma%5E2)%20%3D%20%5Cfrac%7B1%7D%7B%5Csqrt%7B2%5Cpi%5Csigma%5E2%7D%7D%20%5Cexp%5Cleft(-%5Cfrac%7B(Y_i%20-%20(%5Cbeta_0%20%2B%20%5Cbeta_1X_%7Bi1%7D%20%2B%20%5Cbeta_2X_%7Bi2%7D%20%2B%20%5Cldots%20%2B%20%5Cbeta_nX_%7Bin%7D))%5E2%7D%7B2%5Csigma%5E2%7D%5Cright)

似然函数则是所有这些概率密度函数的乘积,即:

L(%5Cbeta%2C%20%5Csigma%5E2)%20%3D%20%5Cprod_%7Bi%3D1%7D%5E%7Bm%7D%20f(Y_i%20%7C%20%5Cbeta%2C%20%5Csigma%5E2)

将每个 f(Y_i%20%7C%20%5Cbeta%2C%20%5Csigma%5E2) 的表达式代入上式,我们得到:

L(%5Cbeta%2C%20%5Csigma%5E2)%20%3D%20%5Cprod_%7Bi%3D1%7D%5E%7Bm%7D%20%5Cfrac%7B1%7D%7B%5Csqrt%7B2%5Cpi%5Csigma%5E2%7D%7D%20%5Cexp%5Cleft(-%5Cfrac%7B(Y_i%20-%20(%5Cbeta_0%20%2B%20%5Cbeta_1X_%7Bi1%7D%20%2B%20%5Cbeta_2X_%7Bi2%7D%20%2B%20%5Cldots%20%2B%20%5Cbeta_nX_%7Bin%7D))%5E2%7D%7B2%5Csigma%5E2%7D%5Cright)

这个乘积通常很难直接最大化,因此在实际操作中,我们通常会取似然函数的对数(即对数似然函数),并尝试最大化它对参数 $\beta$ 和 $\sigma^2$ 的值。

对数似然函数为:

%5Clog%20L(%5Cbeta%2C%20%5Csigma%5E2)%20%3D%20%5Csum_%7Bi%3D1%7D%5E%7Bm%7D%20%5Clog%20%5Cleft(%20%5Cfrac%7B1%7D%7B%5Csqrt%7B2%5Cpi%5Csigma%5E2%7D%7D%20%5Cexp%5Cleft(-%5Cfrac%7B(Y_i%20-%20(%5Cbeta_0%20%2B%20%5Cbeta_1X_%7Bi1%7D%20%2B%20%5Cbeta_2X_%7Bi2%7D%20%2B%20%5Cldots%20%2B%20%5Cbeta_nX_%7Bin%7D))%5E2%7D%7B2%5Csigma%5E2%7D%5Cright)%20%5Cright)

%3D%20-%5Cfrac%7Bm%7D%7B2%7D%20%5Clog(2%5Cpi%5Csigma%5E2)%20-%20%5Cfrac%7B1%7D%7B2%5Csigma%5E2%7D%20%5Csum_%7Bi%3D1%7D%5E%7Bm%7D%20(Y_i%20-%20(%5Cbeta_0%20%2B%20%5Cbeta_1X_%7Bi1%7D%20%2B%20%5Cbeta_2X_%7Bi2%7D%20%2B%20%5Cldots%20%2B%20%5Cbeta_nX_%7Bin%7D))%5E2

注意到上式中的第二项就是最小二乘损失函数(乘以一个常数因子 -%5Cfrac%7B1%7D%7B2%5Csigma%5E2%7D)。因此,在正态分布和独立同分布的假设下,最大化似然函数(或对数似然函数)等价于最小化最小二乘损失函数。这就是最小二乘法与最大似然估计法(MLE)在线性回归模型中的等价性。

由于最小二乘法既简单又有效,并且在正态分布和独立同分布的假设下与最大似然估计法等价,因此在线性回归中通常使用最小二乘法来估计参数。

4. 模型假设的验证

在实际应用中,我们还需要验证线性回归模型的假设是否成立。例如,我们可以使用残差分析来检查误差项是否服从正态分布、是否存在异方差性或自相关性等问题。如果假设不成立,可能需要采取相应的措施进行模型改进。

综上所述,线性回归的理论推导主要涉及到模型假设、损失函数、参数估计等方面。通过最小化损失函数,我们可以得到模型参数的估计值,从而实现对因变量的预测和解释。

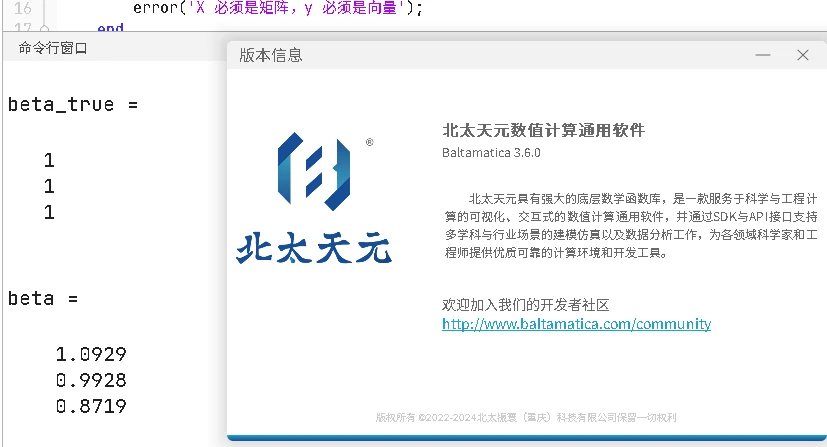
北太天元可以用polyfit 函数来实现最小二乘法, polyfit 是用多项式来拟合数据, 使用一次多项式即可, 大家可以用北太天元自己编程来实现。 

代码块
JavaScript
自动换行
复制代码
X= rand(10,2);
beta_true = [ 1 ; 1 ;  1 ] ; 
y = [ ones(10,1) X] *beta_true + 0.1*randn(10,1); 
[beta  ~] = my_fitlm(X,y);
beta_true
beta

function [beta, stats] = my_fitlm(X, y)
    % 检查输入参数的有效性
    if nargin < 2
        error('需要两个输入参数:设计矩阵 X 和响应向量 y');
    end

    % 确保 X 是矩阵,y 是向量
    if ~ismatrix(X) || ~isvector(y)
        error('X 必须是矩阵,y 必须是向量');
    end

    % 确保 X 和 y 的行数匹配
    if size(X, 1) ~= length(y)
        error('X 和 y 的行数必须匹配');
    end

    % 检查 X 是否已经包含截距列(即第一列是否全为1)
    if size(X, 2) > 0 && all(X(:, 1) == 1)
        % X 已经包含截距列,不做操作
    else
        % 添加截距列(一列全1的值)
        X = [ones(size(X, 1), 1) X];
    end

    % 最小二乘法估计系数
    beta = (X' * X) \ (X' * y);

    % 计算拟合统计量
    y_fit = X * beta;
    residuals = y - y_fit;

    % 样本数、预测变量数(不包括截距)
    n = length(y);
    p = length(beta) - 1;  % 减去截距项

    % 总平方和 (Total Sum of Squares, TSS)
    TSS = sum((y - mean(y)).^2);

    % 回归平方和 (Regression Sum of Squares, RSS)
    RSS = sum(residuals.^2);

    % 决定系数 (R-squared)
    R2 = 1 - RSS / TSS;

    % 调整后的决定系数 (Adjusted R-squared)
    R2_adj = 1 - ((RSS / (n - p - 1)) / (TSS / (n - 1)));  % 注意自由度是 n - p - 1

    % 残差标准差 (Residual Standard Error)
    RSE = sqrt(RSS / (n - p - 1));

    % 组装统计量
    stats = struct();
    stats.Rsquared = R2;
    stats.AdjRsquared = R2_adj;
    stats.RMSE = RSE;
    stats.DFE = n - p - 1;  % 误差的自由度

    % 输出结果
    fprintf('系数:\n');
    disp(beta);
    fprintf('统计量:\n');
    disp(stats);
end
复制成功
