
最近需要完成关于Document-Level Sentiment Classification任务的一篇短文写作,Introduction 和 Related Work两个部分需要多先前研究方法进行梳理和归纳,也由于之前缺乏对文本表征的系统学习,近期通过视频和生成式AI对该部分内容进行了整理,特整理成本篇博文,用于日后复习和查找。
在做文本表征之前,首先是更小单位的词的表示(Word Representation)。在此本文只对用于生成Embedding Matrix的Count-based Method进行介绍。Count-based Method需要根据语料库(Corpus)中的内容进行Basis vocabulary的构建,这个过程主要抽取对于语言表示更有作用的词纳入Basis vocabulary,而不在考虑停用词(如:the, I, you)。Basis vocabulary会包含Corpus中所有具有区分度的词语,而后用于对单个词语进行表示。若构成的Basis vocabulary为{W1,W2,...,Wn},那么某一个具体的词则根据Basis vocabulary进行表示。假设我们通过被表示词的前m和后m个上下文词语对关键词进行表示,在2m个Context Words中能够在Basis vocabulary匹配到的word则该词在词表征向量的对应位置为1,向量的长度为Basis vocabulary的长度。若L(Basis vocabulary) = |V|,则每个word representation vector的长度为|V|。示例:
... and the cute kitten purred and then ...
...the cute furry cat purred and miaowed ...
...that the small kitten miaowed and she ...
...the loud furry dog ran and bit ...
这四句话在去除停用词之后可以构建Basis vocabulary := {bit, cute, furry, loud, miaowed, purred, ran, small}。另外,kitten,dog,和 cat 的context word 分别是:
kitten context words: {cute, purred, small, miaowed};
cat context words: {cute, furry,miaowed};
dog context words: {loud, furry, ran, bit}.
所以可以得到kitten,dog,和 cat 的词语表征分别是:
kitten =[0,1,0,0,1,1,0,1]T
cat =[0,1,1,0,1,0,0,0]T
dog =[1,0,1,1,0,0,1,0]T 。
对于语料库内所有的词的表征都可以通过该方法完成,所有词表征向量组合起来即为Embedding Matrix。Embedding Matrix通常于某个词的One-Hot vector表示搭配,用于获取某个词语在Embedding Matrix内的具体表征。One-Hot vector可以看作是一个词语索引,向量内只有一个元素为1,即该词语在整个词汇表的位置。若词汇表的大小为|V|,那么One-Hot vector是一个包含|V|个元素的向量。
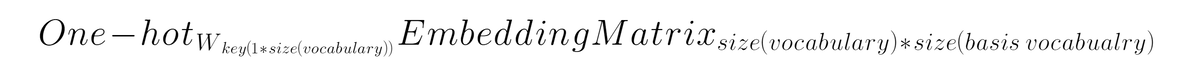
书归正传,明确了word representation之后,正式回归具体的Text representationd methods。
(一)N-Gram Method
N-Gram可以说是最基本的语言模型,常见的有unigram,bigram和trigram。其本意是用前面的词来预测后一个词,即P(Wn|Wn-1)。若为unigram,则词与词之间相互独立,语料库中的所有单个词的集合看做是一个词袋子,单纯统计每个词出现的次数,事实上难以包含有效的语义信息。Bigram和trigram分别以前一个和前两个词来预测目标词,建模时使用马尔可夫模型。
使用N-Gram Method做text representation时,首先对corpus进行N-Gram建模,而后对每个text中包含N-Gram的item的数量进行统计,然后表示相应的文本。
(二)TF-IDF (Term Frequency-Inverse Document Frequency)
首先给出TF-IDF的计算定义:
TF(t,d) = Numbers of times term t appears in document d /
Total number of terms in document d
IDF(t,D) = log (Total number of documents in the corpus N + 1 /
Number of documents containing term t + 1) + 1
TF-IDF(t, D) = TF(t,d) * IDF(t,D)
TF-IDF(t, D)得分表明term t 在整个corpus中的区分度,对于包含若干个词的document D, 我们可以对text中的每个词计算TF-IDF(t, D) 值,进而获得text的数值表示。
(三)Word2vec
Word2vec真正意义上实现了word representation可以对词语的语义信息进行表达。Word2vec的第一步就是对text中的每个词从Embedding Matrix中拿到表征(每个词的embedding representation通过One-hot vector 来检索获取),根据两种不同的策略(continuous bag of words and Skip-gram)对获得的词表证进行处理。如选择CBOW,需要对多个词的表征进行累加,然后送入Hidden layer对已有词语的表征进行重新线性变换,后对中心词进行预测。如选择Skip-gram则直接使用keyword的embedding representation传入隐藏层,对keyword左右的2m个context words进行预测。
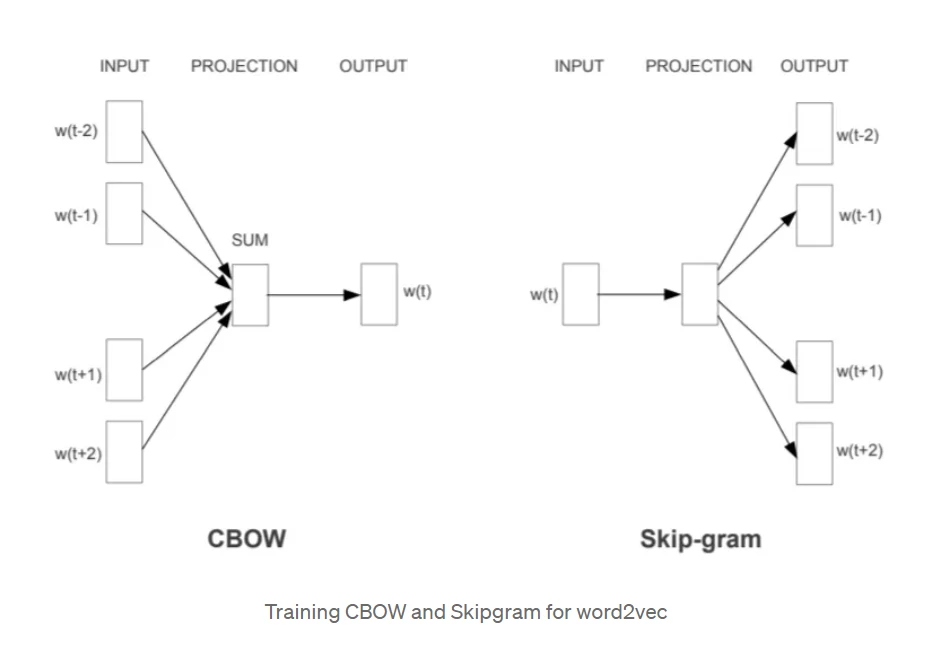
CBOW和Skip-Gram对应的损失函数的形态不一致,但均使用cross-entropy来对参数进行更新。更新的参数包含隐藏层的参数和Embedding Matrix的元素,当训练收敛后,获得匹配当前任务的模型参数。
Loss for CBOW:
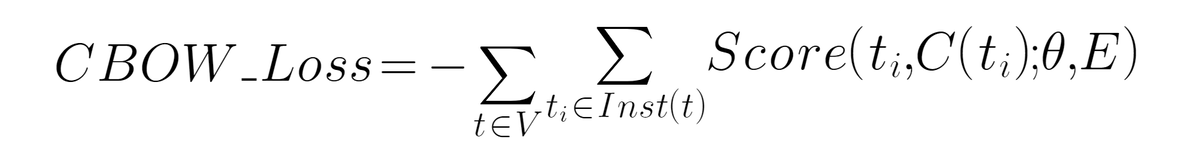
Objective for Skip-gram:
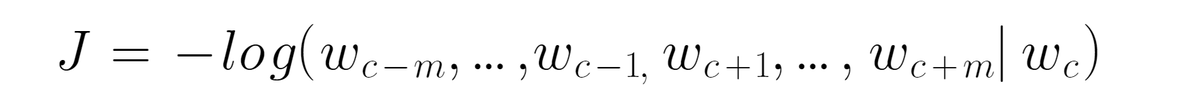
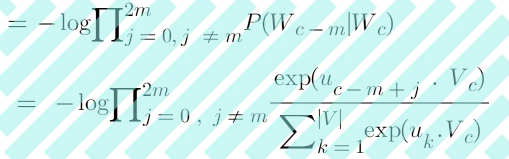
上述三种方法构成了文本表征的基础方法,随着深度学习的发展,文本表征开始使用CNN,RNN等网络结构来进行表示,目标函数和损失函数也会随着具体的下游任务进行更改。后续会针对具体深度学习网络结合具体任务学习文本表征进行归纳和总结。
