
好久没更新了,主要是我最近看的论文都比较硬,今天终于看到一个很有意思的论文,不会谈太长内容,只是说明下这个系列还是在更的。
更之前再吐槽一下今年的诺贝尔物理学奖,竟然给了神经网络早期研究者...这下学物理的和学AI的都沉默了。
论文就是这一篇:
1.先讲方法
方法说起来非常简单,就是重复输入一遍。
例如,你之前问ChatGPT“11+11是多少?”,现在只需要问“11+11是多少?11+11是多少?”
没错,就这么简单,将一个问题重复一遍,这样你就可以获得性能提升。
2.原理
这个原因说起来肯定是复合原因,大体上我猜测(其中一种是论文重点讨论的,也应该是主因)有三个原因:
(1)两遍确实是表示强调。这也不是没有根据的,毕竟prompt工程的目的就是不断调整输入使得输入尽可能“激发LLM的能力”,使之表现更好,包括但不限于威胁、利诱、进行性格测试并对症下药等,而重复一遍确实可能产生类似的效果,但大概率不是主因
(2)计算量确实增加了。输入长,那么计算量增加是很正常的,更多的计算量换更好的性能听上去是合理的,不过大概率也不是主因,因为本论文的输入也主要是短文本,长文本复制两份估计表现不会有很大提升,毕竟语言模型处理长文本的能力本来就比较差,有研究表明一些处理长文本的模型甚至需要专门辟出来一些attention头用以检索。
(3)之前谈attention的时候其实没谈过,就是在GPT这样的仅解码器Transformer中,attention有个特点,就是只能“向前看”,例如我写一段文本“爱丽丝家的狗爱上了卡盖诺家的猫”,那么“狗”就只能“看到”“爱丽丝家的狗”这些文本(可以看到自己),“爱上了卡盖诺家的猫”这是看不到的。之所以这样设置,是因为语言模型的唯一目的是“预测下一个token”,所以每一步的计算都必须为这个目标服务所以对于每个token来说需要保持计算的一致性,所以即使在知道输入的情况下也不会“往后看”。
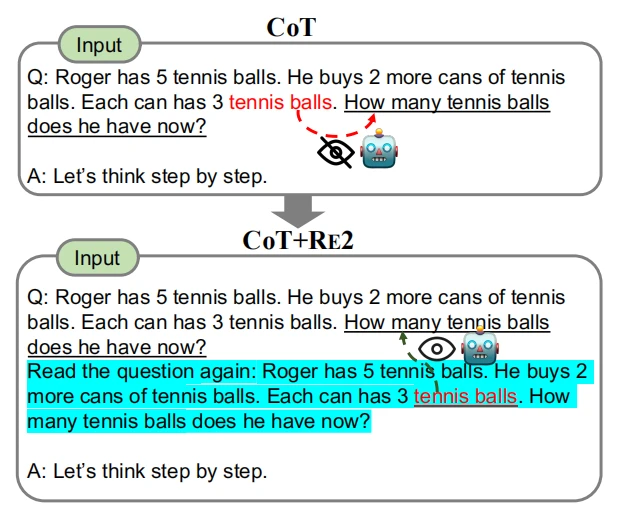
这就带来一个问题,即第一遍输入的时候其实很多地方是缺失“全局信息”的,而如果我们复制一遍的话,那么在第二遍处理的时候我们就可以获得第一遍的“全局信息”,性能就上去了,这就是主因。
3.结语
很可惜,本文好像只做了重复一遍,重复N遍的实验没有做,不知道多重复几次是否还有新的发现。
