
CosyVoice 介绍
CosyVoice 是阿里通义实验室发布的开源多语言大语音生成模型,提供推理、训练和部署全栈能力。
CosyVoice 是依托大规模预训练语言模型,深度融合文本理解和语音生成的一项新型语音合成技术,能够精准解析并诠释各类文本内容,将其转化为宛如真人般的自然语音。
CosyVoice 采用了总共超 15 万小时的数据训练,支持中英日粤韩 5 种语言的合成,合成效果显著优于传统语音合成模型。

CosyVoice 用途
CosyVoice 专注于自然语音生成,支持多语言、音色和情感控制。
CosyVoice 能够根据少量原始音频快速生成模拟音色,包括韵律和情感细节。
CosyVoice 支持跨语种语音生成和细粒度的情感控制。
CosyVoice 使用
CosyVoice 预训练模型说明
CosyVoice-300M——基底模型
CosyVoice-300M-SFT——经过SFT微调的模型
CosyVoice-300M-Instruct——支持Instruct微调的模型
一般来说,如果没有特殊需求,则直接使用 CosyVoice-300M 基底模型。

代码调用(引入 CosyVoice 的 Python 库)
请自行观看github的官方文档,指路-> FunAudioLLM/CosyVoice

图形化界面(启动 CosyVoice 的 WebUI 服务)
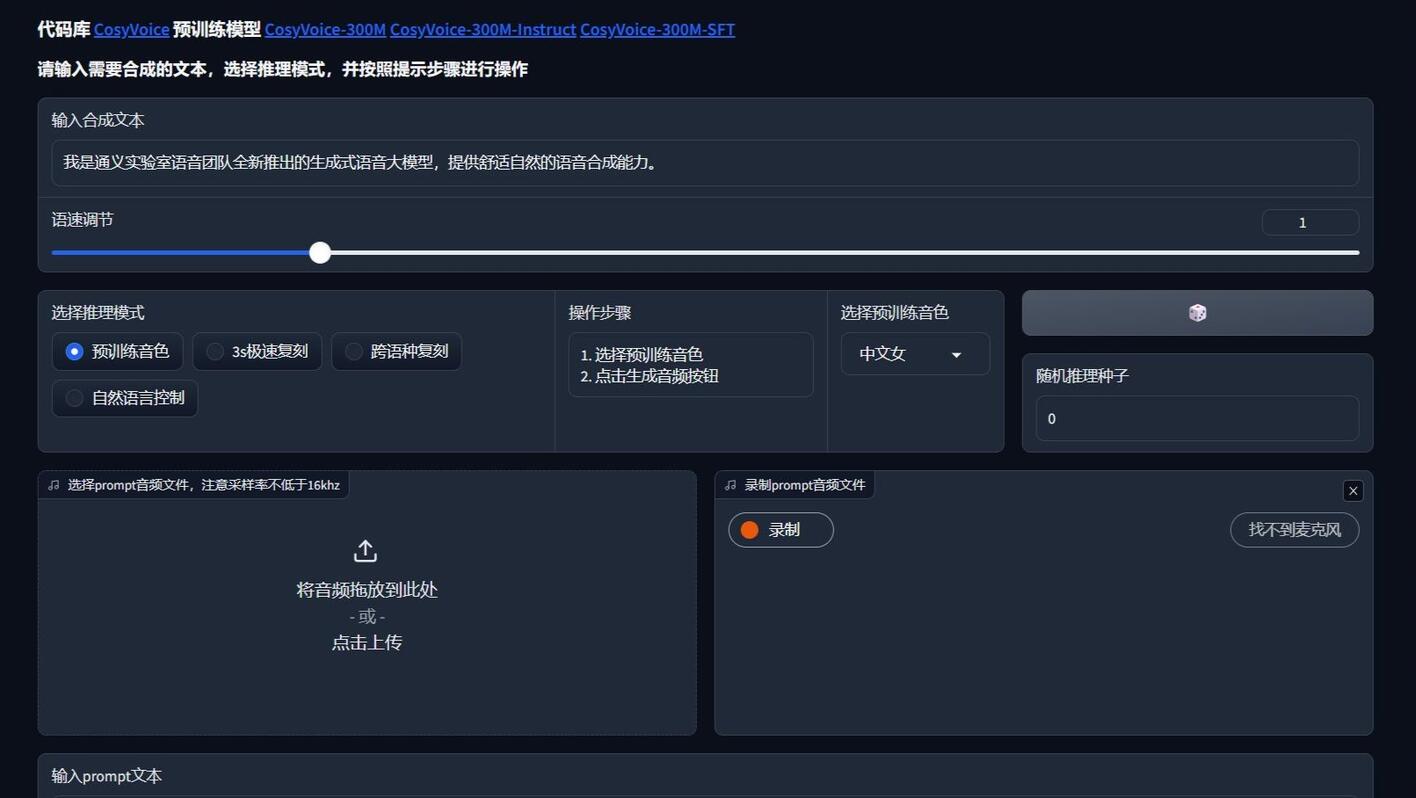
无论是自己本地部署的 CosyVoice,还是通过算力平台镜像部署的 CosyVoice,或者其他各种各样方式部署的 CosyVoice。只要最终执行的是 webui.py 这个 python 文件,那么就会进入这样的界面。

接下来我会依据使用步骤由先到后对此界面进行详细说明:
Step-1:输入合成文本,即需要生成音频的内容

Step-2:选择推理模式并阅读操作步骤
Step-2-1:推理模式:预训练音色(常用)
Step-2-1-1:选择预训练音色

Step-2-2:推理模式:3s急速复刻(常用)
Step-2-2-1:选择prompt音频文件,或录入prompt音频,注意不超过30s,若同 时提供,优先选择prompt音频文件(即想要复刻的声音)
Step-2-2-2:输入prompt文本(与音频内容一致,为了提高复刻的效果)

Step-2-3:推理模式:跨语种复刻(建议使用基底模型)
Step-2-3-1:选择prompt音频文件,或录入prompt音频,注意不超过30s,若同时提供,优先选择prompt音频文件(即想要复刻的声音)

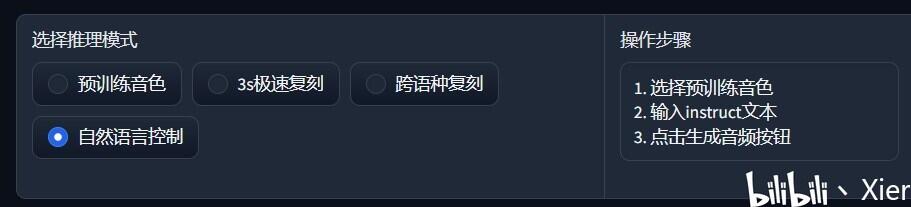
Step-2-4:推理模式:自然语言控制(建议使用Instruct模型)
Step-2-4-1:选择预训练音色
Step-2-4-2:输入instruct文本
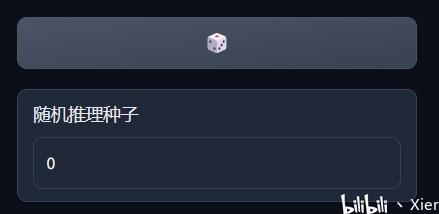
Step-3:设置推理种子,若无明确需求可以略过(一般不设置)
Step-4:语速调节

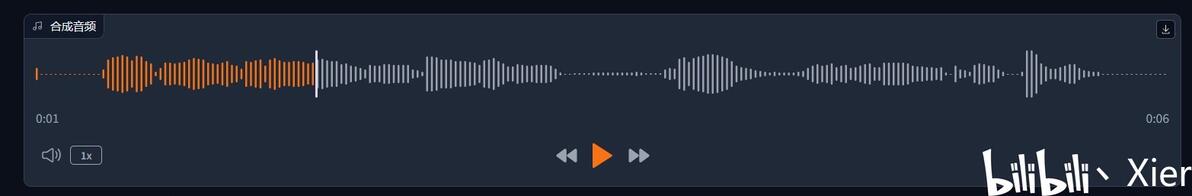
Step-5:点击生成音频按钮,等待生成音频

生成效果示意图
CosyVoice 视频教程
还没出,等我有空的时候会录制
