
ICE Lab Inc. Copyright 2024, All rights reserved.
本文共11250字
前排感谢某书纪Secsome在数据结构上的指(p)导(y)帮(jiao)助(yi),感谢Banshee在ModEnc上撰写的关于SHP文件数据结构的英语原文。
(b站把专栏改图文也就算了,还删我草稿箱,简直罪大恶极,审核别不过审,我错了)
SHP文件,你也可以叫它Shape文件。对于使用现成素材的modder来说,标题的问题只有一个解答:去搜索引擎寻找Open Source SHP Builder,并找到shp对应的色盘pal文件就可以了,而对于自己做素材的modder来说,可能使用帧合成时也会顺带下载一个ImageShaper。
在各种技术力蓬勃发展的今天,红警2在各路大神的逐代技术积累下,已经成为制作mod最简单的游戏之一,再加上红警2依旧是当今所有rts游戏中节奏较快,上手最简单的即时战略游戏之一,这也吸引了更多玩家加入到modder的阵营中来,同时这也让不满足于简单制作mod的人越来越多。不论是隔三差五就会冒出的3d重置红警2项目,还是各种底层重写与逆向修改,比如OpenRA,chronodivide,以及利用注射器跳板进一步写的更个性化的平台,完成这些新技术力创举的人无不例外的需要更深入地了解红警2在程序层面上的架构,因此,各路modder也开始更深入了解游戏文件里包含的各种东西的作用。
同时,由于互联网共享精神的消弭,某些电商平台上的“怀旧游戏安装”的商家越来越多,更有甚者开始做起了偷盗其他人的心血缝合低质mod然后以此盈利的不法勾当,这种现象过于普遍,以至于连某些受教育程度不低的人都不能意识到自己偷窃了一些素材师的劳动成果,这也让许多素材师开始对自己成果地流通与用途感到担忧。在ra2diy上,对vxl进行加密的倡议已经持续了一段时间,而shp的自定义色盘的特性又可以让pal可以成为shp天然的加密工具。不过,如果更多人能shp与vxl文件的数据结构进行详细了解,这或许能让素材的溯源更加方便,亦或者一些聪明人可以以此展开更多的思考,从而发现一种更好的加密方法。因此,我也就写了这篇笔记一样的专栏,以此来让自己在日后能以此基础知识为契机,为以后有时间的时候研究更深做好准备。
在ModEnc上,Banshee已经详细介绍过SHP文件的数据结构样式,但考虑到其全文为英语,且对于一些细节那篇文章讲的不够多,因此本文将以那篇文章为蓝本,结合实际操作的方式重写一个自己能方便查阅的新文章。
SHP数据结构ModEnc原文地址:
https://modenc.renegadeprojects.com/SHP (n.d., last edited on 2018.09.07 by anonymous user)
一. 数据结构基础
(为了降低这个文章阅读的难度,所以我添加了这一章,说的比较啰嗦,懂行的可以直接跳过。)
即使是一点没学过计算机具体知识的人,在日常使用计算机的过程中都会认识到文件具有两种属性:文件格式,文件大小。在一般人眼里,文件格式决定了这个文件具体是什么,文件大小决定了它会占用计算机的多少硬盘空间。然而,许多人也或多或少听说过计算机二进制的原理,也本能会知道自己电脑上的所有文件都是0与1。不过,知道0与1到底是怎么与实际使用的文件联系上的人就相对少了很多。而面对一个新文件,如果我们想使用自己的力量而不是现成的工具打开它,那么正确认识文件数据的具体构造一定很有必要。
0与1确实构成了计算机的所有文件的基础,而在计算机内,一个可以将自身状态切换为0与1的基本单位叫bit。不过,1bit信息包含量太少,所以文件存储的基本单位一般由8个bit构成,而8bit也就是1byte。对于人类而言,1byte如果以2进制的方式显示有点麻烦,因为它实在是太长了而不方便阅读。由于2^8=16*16=256,因此,人类将这种2进制下有8位数据的信息转换成了一种两位数十六进制信息,这也就是十六进制诞生的直接原因。
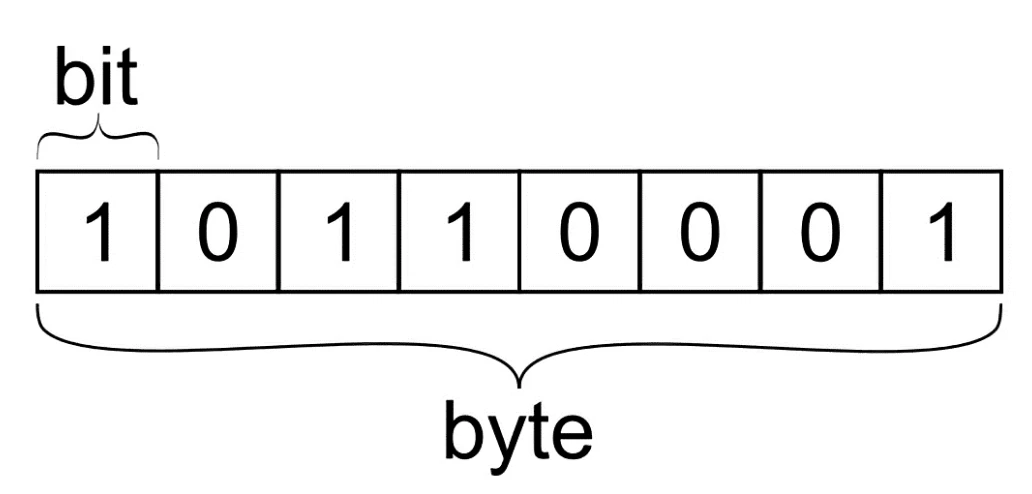
一个字节(byte)与比特(bit)的关系
那么,我们可以直接在电脑里认识到所有文件都是由byte构成吗?简单的证明方法是右键电脑中的任意一个文件,你都可以看见其大小的基础单位为字节,而字节也就是byte的翻译。
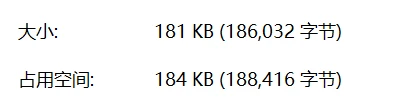
大小就是文件占用的字节数,占用空间指的是文件占用的扇区大小
当然,还有一种更直观的证明方式。去搜索引擎寻找关键词“十六进制编辑器”,然后将你一个明确大小的文件使用十六进制编辑器打开,你会发现文件大小的字节数与十六进制编辑器打开后的十六进制数字的数量一致,也就是说,每个十六进制数字也就刚好是文件的每个字节的数据。
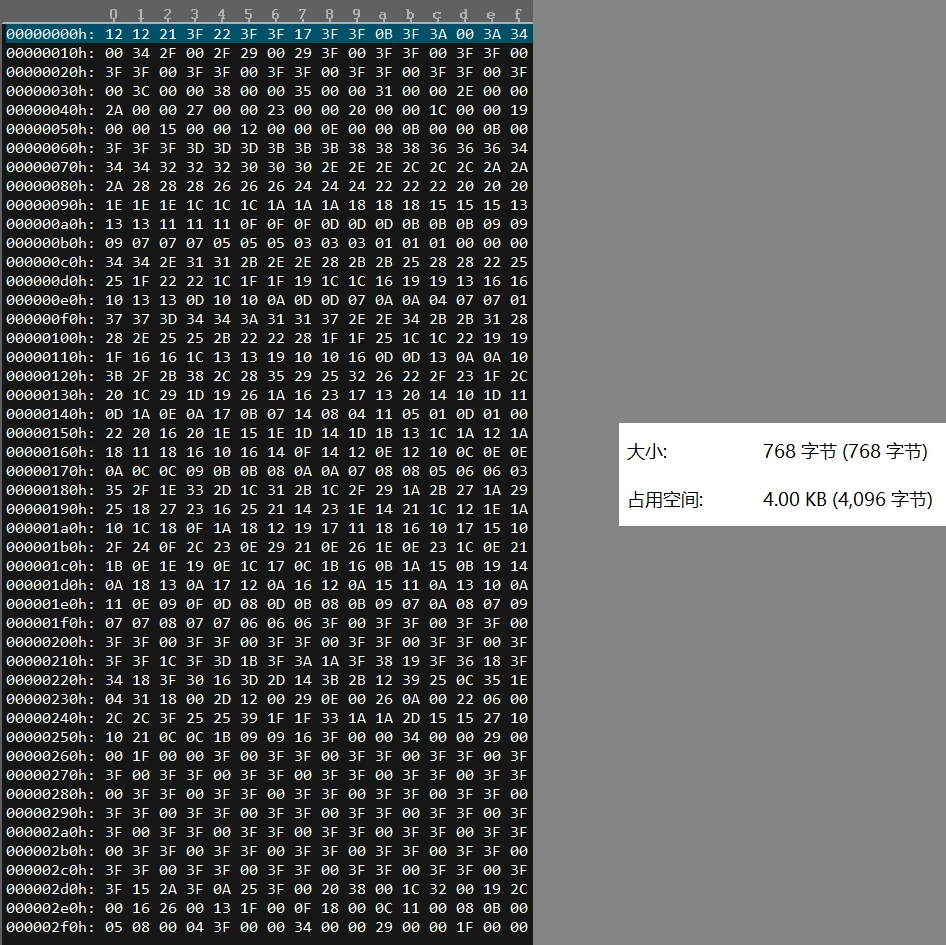
以Ultra Edit为例,左边是UE打开的某个文件,而右边是这个文件的大小与占用空间
所以相信一些聪明的读者就会想到一个问题了:读取一个文件是否等同于使用某个规则来将这些十六进制数据进行分类并读取每一类的信息呢?答案是肯定的。使用这个规则来解析一段十六进制数据的过程也就是文件的打开过程。
既然知道了这个基础知识,那么SHP文件是否就可以打开了呢?modder都知道,SHP文件要想正确显示,有一个离不开的组件叫“色盘”,也就是Palette文件。因此,在我们使用编写程序来打开SHP文件之前,一定离不开对Pal文件进行相关了解。
二.打开SHP文件的必要步骤——打开Pal文件
细心观察就能发现,红警2中任意一个Pal文件的大小都是768byte,768是256的三倍,而色盘又刚好有256种颜色。同时,每个byte的比特数256,刚好对应了8位RGB色彩空间中每种颜色的最大值。这不禁让人感到巧合:难道红警2的色盘文件,每三个byte刚好对应了一个颜色,而每个byte又刚好代表了某个颜色中的某种颜色分量?
Pal的真实结构确实是768byte的数据,以C#举例,当使用C#的 File.ReadAllBytes() 函数读取色盘文件时,色盘文件会直接转换为一个长度为768的byte数组,不过,这个数组的最大值为63而不是8位深度颜色的最大值255,而64是256的四分之一,这也意味着读取色盘文件后,数组的每个数值都需要乘以4才能代表色盘的真实单一颜色值。同时,Pal文件使用3个字节记录一个颜色数值时,其顺序为R分量,G分量,B分量。按照该要求读取数组并将数组大小全部乘以四并转换为颜色数组后,很容易看出Pal文件已经很好地转换成了相应的颜色。
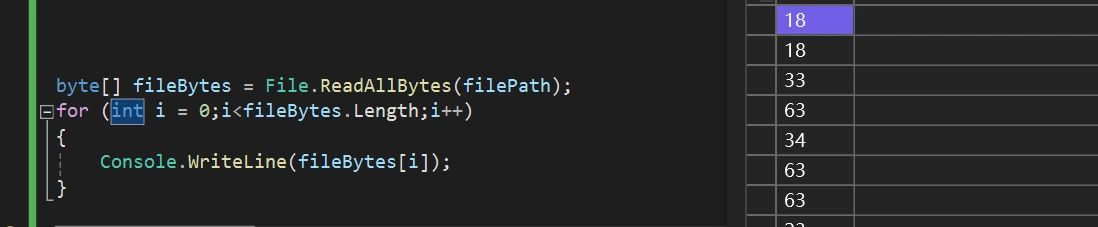
直接使用ReadAllByte读取pal文件,可以看见色盘格式就是非常朴素的每种颜色分量一个字节,一个颜色三个连续字节
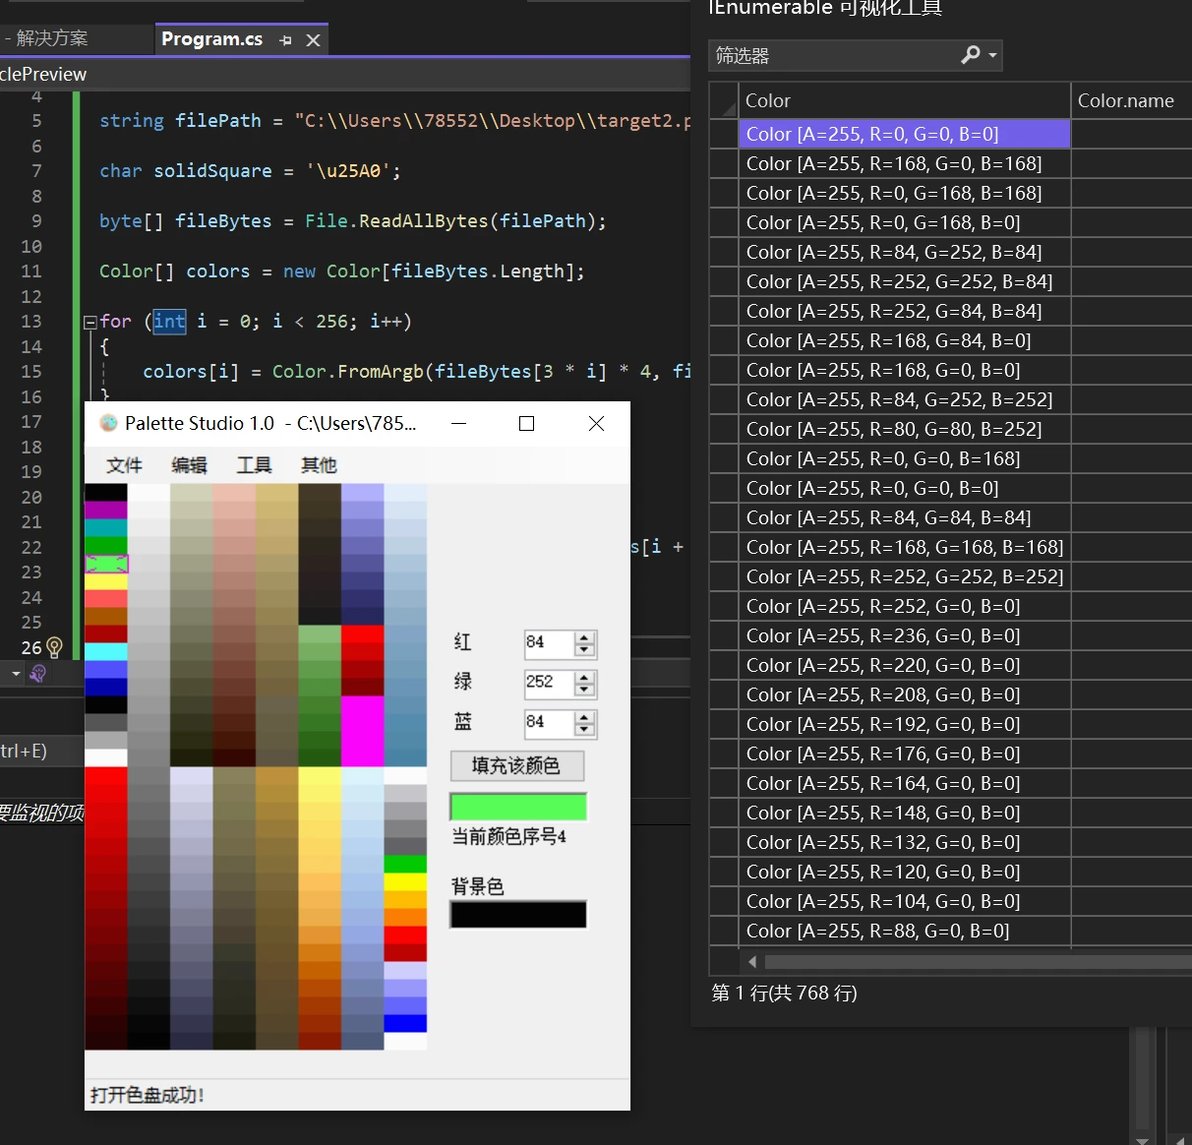
左边的色盘都转换成了右边的颜色数组
问题来了,为何红警2的色盘颜色设计是0-63乘以4而不是直接设计0-255呢?这是因为尤里的复仇的运行使用的是16位元色盘,而16位色的颜色范围就是0-63,而0-255的颜色范围就不是16位颜色了,那叫24位(没有Alpha通道)/ 32位(有Alpha通道)色了。玩家能直觉感受到16位色往往是在窗口化运行尤里的复仇的时弹出的那个框,弹窗上清楚可见的“本产品需要16位元色盘”让玩家能直觉感知尤里的复仇使用了16位色盘。
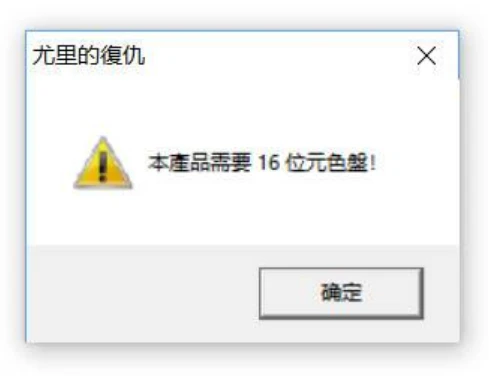
一个窗口化YR玩家们常常见到的弹窗,这就是YR使用16位颜色的力证
那么为啥尤里的复仇一定要使用16位元色盘呢?首先,YR是一个2000年的游戏。在那个计算机独显还是小破烂,内存还是按M算,处理器还刚从16位系统升级32位系统的年代,使用一个完整的字节存储一种颜色的某个分量是很奢侈的。还记得第一节中提到的比特与字节的关系吗,三个十六进制的字节,实际在计算机中存储是这样的:
10110000 11101100 01101000 = B0 EC 68
但是这三个字节的后面有一些在存储上没啥用的0,对于早期空间捉襟见肘的计算机来说,这些0会占用计算机更多的空间。于是乎,聪明的科学家们便在存放时将这些0合并起来,上面的数字也就转换成了下面的数字:
10110000 11101100 01101000 => 10110|000 111011|00 01101|000
=> 10110|111 || 011|01101 = B7 6D
这一下可是直接减少了33%的空间利用,同时由于计算机读取的时候又是按位来读取的,所以只要读取了合适的位,最后的数值也并不会有什么变化。唯一难受的是,如果要用两个字节代表三个颜色,这意味着有两种颜色只有32个级别的深度,而另一种颜色只能有64个级别的深度。考虑到人眼对任意颜色中绿色的变化比较敏感(这是因为人眼对亮度感知比对色度感知更灵敏),因此将5+6+5中那个6位比特给了绿色,其他俩5位比特则是给了红色与蓝色。
由此,这也就是为何红警2需要16位元色盘才能运行,同时红警2的全部颜色都需要乘以4才能转换为真实色盘颜色……吗?
事实上在16位元色盘构成的颜色里,红色与蓝色只有5位,换句话说,这俩颜色按道理说需要乘以8才是正常数值且其最大值应该是32才对。不过,色盘在存储一个分量颜色的时候还是实打实是使用了一个字节,同时游戏程序调用内存读取一个分量的颜色时会统一以每次读取6位比特为规则。也就是说,只是在打包进内存的时候红蓝两色变成了5位,而游戏为了方便6位读取,又把色盘里的所有颜色在三光色分量上存储为每种原色6个比特,因此,这也导致了TS引擎里一个比较难以发现的Bug——绿色溢出bug(该bug在PPM上由Apollo提出,同时该bug已经被收录进Pal文件的说明书里,提示用户需要在设计自定义色盘时注意这个问题),不过说这个是红警2的bug无疑是给西木找茬,因为这个bug纯粹是当年计算机容量不足,计算机制造者们做出的一些妥协罢了。下图演示了这个bug在游戏上的表现,可以看得出这个球以一个级别为一层,层与层之间的突变也就是游戏中颜色位深较少的体现,而边界旁边多出的浅绿色正是绿色因为读取了6位而溢出的证据。
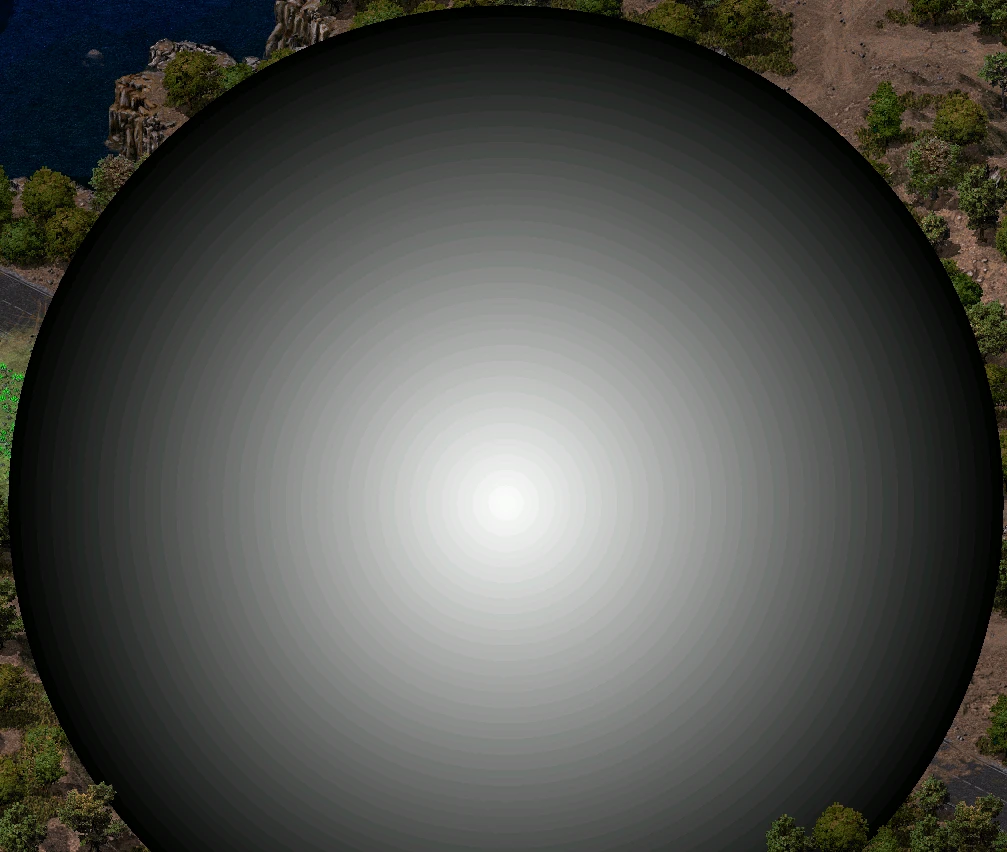
仔细看白色层级的边缘,有几分隐隐约约的绿色在提醒玩家这是16位元色盘
那么,说了这么多有什么用呢?除开使用程序读取时RGB的顺序,以及强度需要乘以4以外,上面的特性也深刻揭示了一点:由于色盘颜色读取限制,YR永远无法做出特别平滑的颜色过渡。换句话说,除非你把尤里复仇的色盘读取改成24bppRGB,否则即使是自定义色盘,也会出现丢色的情况。因此,只要没有修改红警2YR引擎读取规则,任何所谓的“高清化红警2”,其实只是一种更好看的素材转换罢了。当然,这里也没有否定素材师们的辛苦劳动成果,模糊的艺术本就是带着镣铐跳舞的艺术,而现代三渲二的流程与自定义色盘的普及,也一定程度上缓解了SHP颜色不够用的尴尬。更重要的是,一些新的渲染并不需要用户修改16位色来启动尤里复仇,我推测可能与色盘读取的规则更改有关(此处纯属个人推测并不可信,如果有比较了解这部分的读者可以分享你的见解)。
三. 拆解SHP文件格式并打开它
分析完Pal文件的打开以后,SHP文件也就基本可以呼之欲出了。从使用者的角度来看,SHP文件是一个包含多帧位图的文件集合。考虑到每一帧的信息都需要一段数据来记录,文件本身也需要一段数据来记录它的大小与帧数信息,所以每个SHP会在其文件数据的开头用一些字节来记录这些包含了自身信息的数据,这种记录文件信息的字节便被称为头数据。SHP的数据结构也非常简单直接,即每个SHP的总数据是由:文件总的头数据+所有帧的头数据+每一帧的详细数据按顺序组成。
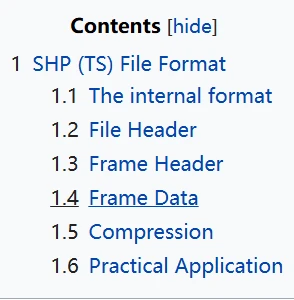
这也就是SHP文件结构的原文里,1.2-1.4节所代表的含义
Part 1.SHP头数据
SHP数据的第一部分是SHP文件的头数据。SHP的头数据由8个字节构成,其中每两个字节会构成一段信息。两个字节构成的非负整数在不同语言的环境下名字并不一致,在C/C++中是unsigned short,也就是ushort的全称,在C#与Java里则直接为ushort或是char,在Go或者MATLAB下,这种变量则叫做uint16。在SHP的头数据里,第一个ushort恒定为0,第二个ushort则表达了整个SHP的宽度信息,第三个ushort则表达了整个SHP的高度信息,第四个ushort则表达了整个SHP的帧数信息。
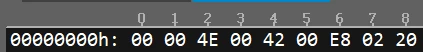
红警2里美国大兵的shp文件gi.shp的头数据信息
不过,当你按十六进制编辑器显示的顺序读取两个字节后,你会发现读取的实际数据与真实数据有出入,比如你导入的shp文件的图像宽度为2450,那么它转换为十六进制也就是992,存储时按理说是(0x)09 (0x)92。但实际上通常你在家里的电脑上读取的却是(0x)92 (0x)09。这是由于家用电脑默认存储数据的方式为小端序(Little-Endian)。小端序这个名词来源于格列佛游记里吃鸡蛋先嗑小头与先嗑大头的派系名字,总得来说,读取一个数字时,从低位能更好记录与运算一个数字的大小,这就好比我们使用竖式进行加与乘的运算时都是从个位数开始计算最后得到结果一样,计算机的运算会从数字较小的低地址开始逐个运算到高地址,因此,如果把整个数字按照低位存小地址,高位存大地址的方式存储与计算,那么它在十六进制编辑器里看起来就会像是反的一样(至于为啥每个字节内部的比特没有反过来,那是因为计算机读取单个字节时的顺序还是正序,读取是正着来还是反着来主要是看计算机本身如何设计,一般的家用PC上,小端序为主流设计)。
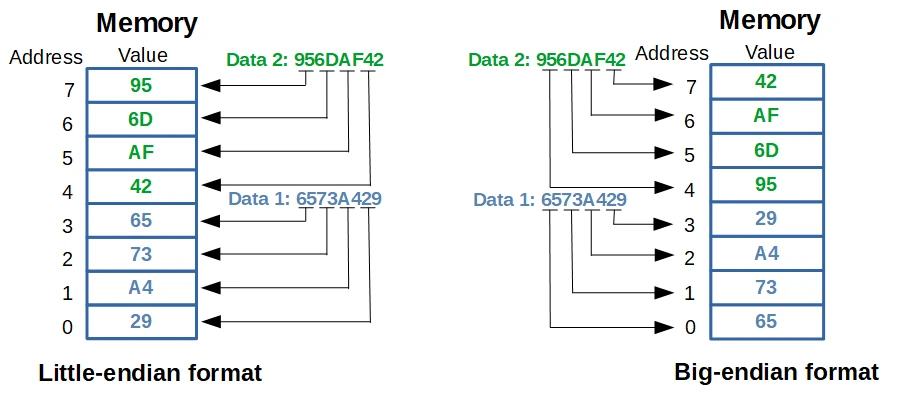
大端序与小端序示意图,图源自Open4Tech,侵删
所以,按照小端序读取后,上面美国大兵的头数据的翻译也就是这样:
开始的0:0x00 0x00
文件的图像宽度(Width):0x4E 0x00 => #004E = 0078
文件的图像高度(Height):0x42 0x00 => #0042 = 0066
文件的帧数:0xE8 0x02 => #02E8 = 0744
使用SHP Builder打开gi.shp以后,发现所有数据与头数据完全一致。
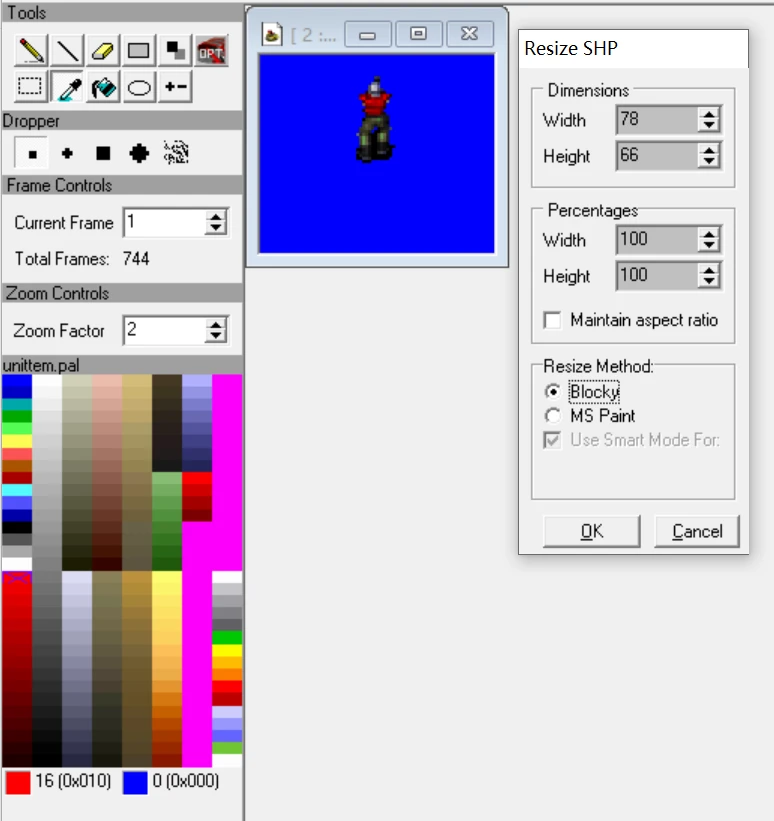
问题来了,难道我们只能手动读取byte然后将其反向吗?事实上很多语言的文件数据读取函数已经完成了小端序与大端序的智能识别,因此除非你使用的语言没考虑这个问题,否则使用系统库内的读取函数往往都可以帮你自动实现小端序读取多字节变量。以C#为例,当你使用BinaryReader的函数读取FileStream提取的文件数据时,函数内部会自动将其转换为小端序读取方式。下图表达了C#使用 BinaryReader.ReadUInt16() 时,系统内部所调用的函数详细情况。
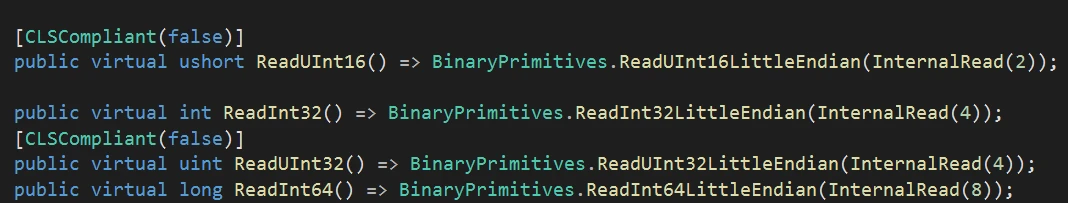
可以看到C#内部已经默认使用小端序读取了
Part 2.SHP帧头数据
帧头数据也就是每一帧的头数据集,一般来说,单一帧的头数据容积为24byte,其中包含的内容如下:
第一个为uint16:XOffset(2byte)
第二个为unit16:YOffset(2byte)
第三个为unit16:FWidth(2byte)
第四个为unit16:FHeight(2byte)
第五个为uint8/byte:CompressionFlag(1byte)
第六个为空位,空位为3个byte的0值,也就是(0x)00 (0x)00 (0x)00(3byte)
第七个为uint32:一个32位深ARGB颜色值,具体作用未知(4byte)
第八个为uint32:西木并没有使用这段字节,这段字节可以为任何数字(4byte)
第九个为uint32:FrameOffset(4byte)
读取他们的方法很简单,只需要按这些变量的种类顺序,使用指定的数据读取函数读取就行。以C#为例,读取每个帧的头数据的基于C#的伪代码如下:
FileStream.Seek(8, SeekOrigin.Begin); // 跳过开头的SHP头数据,直接从第9位开始读取第一帧
for...建立一个帧循环,从SHP头文件里获得帧的具体数量,循环帧数量的次数以读取每帧头数据
ushort x = reader.ReadUInt16();
ushort y = reader.ReadUInt16();
ushort width = reader.ReadUInt16();
ushort height = reader.ReadUInt16();
byte flags = reader.ReadByte();
reader.BaseStream.Seek(3, SeekOrigin.Current);(reader为BinaryReader类的变量)
uint color = reader.ReadUInt32();
uint unknownvar = reader.ReadUInt32();
uint offset = reader.ReadUInt32();
...下个帧循环
那么,这些数值分别是什么意思呢?XOffset,YOffset,FWidth与FHeight可使用下图清楚表明其详细作用。
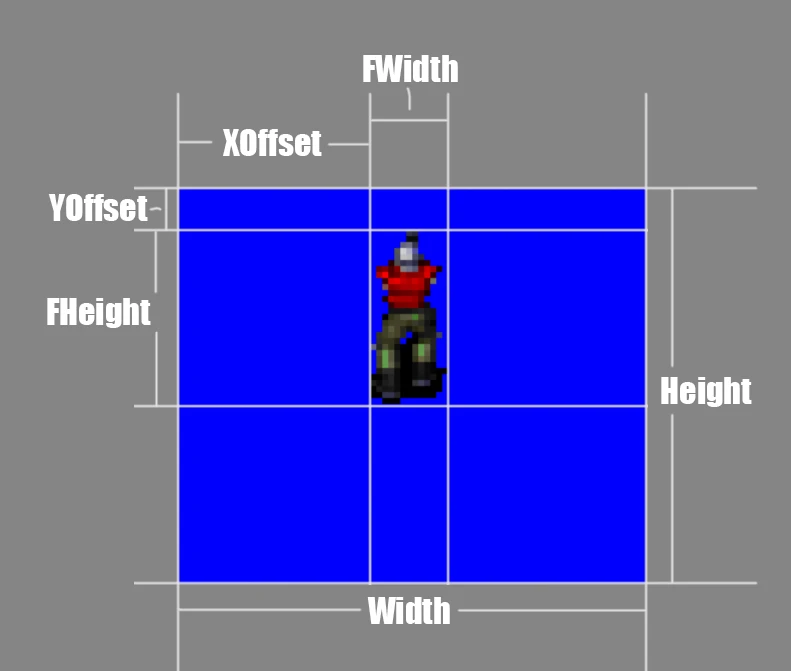
具体说就是,SHP的帧数据只会记录长宽范围在FWidth与FHeight中的数据,其他数据由于是空的(背景色0),所以在记录每一帧的时候就完全没必要把这些部分包含进来白白浪费空间。因此,每一帧的数据其实就相当于把一张长为FWidth,宽为FHeight的图在X轴上偏移了XOffset的长度,在Y轴上偏移了YOffset的长度,而图像总宽度为Width,总高度为Height,这也就是为什么在Banshee的文章里会提到XOffset + FWidth < FileHeader.Width与YOffset + FHeight < FileHeader.Height一样。当然,这里的符号其实是错误的,真实情况应该是XOffset + FWidth 与XOffset与YOffset + FHeight 。至于为啥banshee写成了小于,应该是因为循环从0开始读取一直到小于的程序习惯所致吧。
CompressionFlag决定了那一个帧使用什么方法存储。存储的方法有两种,分别为第一种与第三种(呃……),或者你也可以叫它逐像素存储法与压缩存储法。这两者的区别我在帧数据里会提到,CompressionFlag是一个byte/uint8变量,不过游戏读取它只会读取它的第二位比特,如果第二位为1,那么不管这个比特是00000010(2)还是00000011(3),游戏都会视作这一帧的SHP使用了第三种存储方法,也就是压缩存储法。那么这个第一种与第三种的称谓从何而来呢?不知道是否有人记得紫色逗逐在若干年前反馈的一个bug:鼠标指针的shp,也就是mouse.sha,只能使用SHP Builder保存选项里的Compression 1 Only来保存否则读取会花。没错,这个第一种也就是逐像素存储法的意思,这个bug也说明了这两种存储方法在实现细节上具有较大差异,很多modder并不知道SHP Builder这里的保存选项有什么差别,而通过Flag的含义我们可以轻松得到此处三个选项的具体意义:第一个选项Auto Detect Best Compression意思为保存一个帧时,将会自动选择逐像素存储法与压缩存储法中体积较少的方法来存储,换句话说所有帧的CompressionFlag在此项勾选时并不一定是一样的。Force Compression 3则是强制使用压缩存储法来保存每一帧,Compression 1 Only则是强制使用逐像素存储法来保存每一帧。
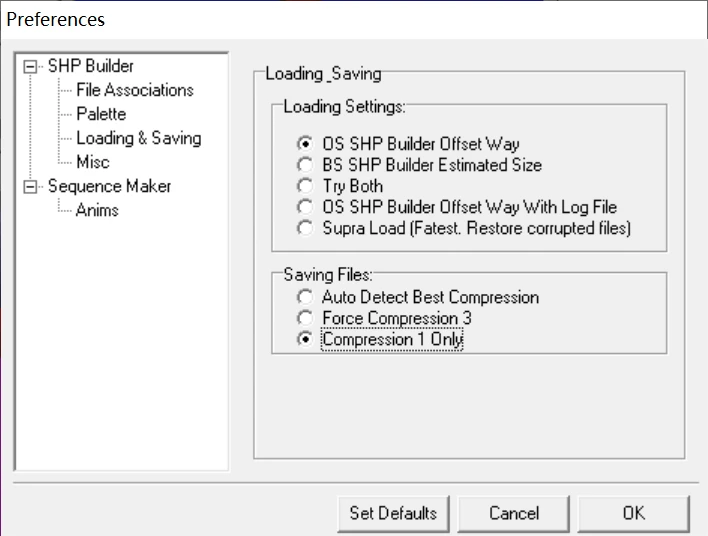
那么第三种方法都叫压缩存储法了,怎么还会在某些时候产生的文件比逐像素存储法体积大呢?这点本文将会在下一节提到。
最后一个uint32的Offset的含义代表了帧的记录位置偏移。简单来说,每一帧的数据都会在文件的一个部分记录,那么如何快速找到这一帧的数据从哪里开始呢?Offset便记录了这个数值。当Offset为0时,说明这一帧就是空的(虽然banshee是这么解释的,但是我推测了一下,一般不会存在这种情况),当某一帧的数据是第m个字节到n个字节的时候,Offset就是m-1。这个数值一般配合Seek函数使用,以C#为例,当我在帧的头获得了这个帧的Offset数据以后,直接使用Seek函数将读取地址偏移Offset的位置就可以从指定帧数像素数据的第一个字节开始读取了。
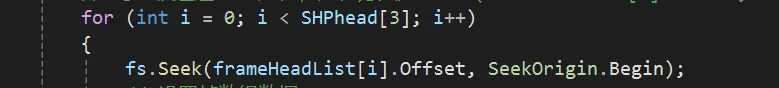
总结,每一帧的头数据大小为24byte,其中前8个byte分成4个uint16,参数分别为XOffset,YOffset,FWidth与FHeight。第9个byte记录了这一帧的保存方式,最后4个byte构成了一个int32,记录了该帧读取时应该从首位偏移多少个位置,而由于各种语言的数组也好地址也罢,第一项都是0,因此Offset的大小就等于其帧数据的第一个字节前面有的字节数量。
当然,每一帧的头文件里还有一段连续为0的部分,也就是倒数第8到倒数第5字节的那个uint32,据banshee所说,你可以在这里添加任意的数值,如果将SHP Builder改为读取到该段时若该段非0时用户需要输入与这个数值一样的数据才能打开这个shp,或许能做出一个在SHP Builder上上锁的功能?不过考虑到目前的SHP Builder没有这个功能,且自定义读取撰写程序时完全可以跳过这一段的读取,因此我目前感觉这一段是没什么作用的,当然,读者也可以自己做实验来验证一下帧头数据的这一部分到底有何用处。
Part 3.SHP帧数据
上文可得,CompressionFlag决定了某一帧使用什么方法存储,那么这两种存储方法到底有什么区别呢?下面我会用一个案例来比较两者的差别。
假设我们现在需要保存一帧的shp,该shp的单帧组成是这样的(没有写数字的地方为透明像素0):
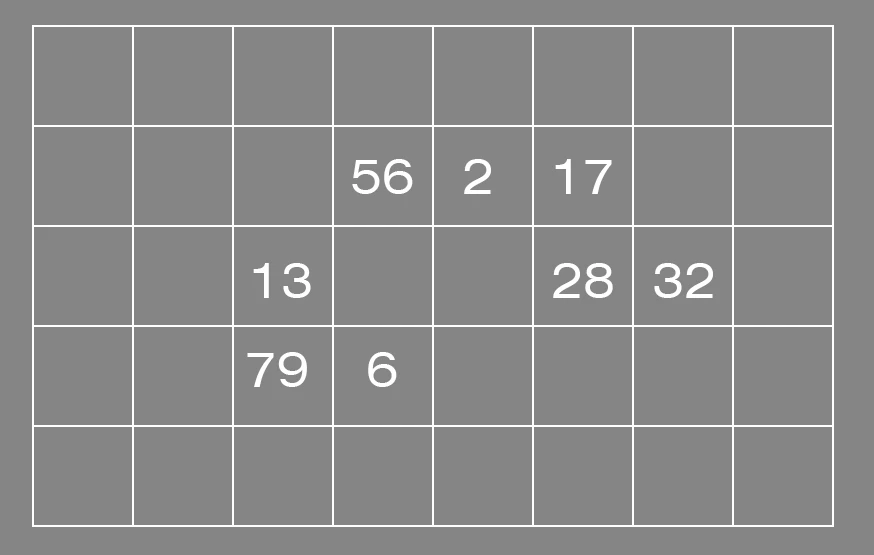
由于SHP需要色盘才能显示正确,因此,上图中的数字便是对应的相应色盘的号码,例如56就是第57号色(此处案例使用十进制而非十六进制),由于第一个颜色为0号色,且使用大多数语言读取为byte数组时,数组的第一个对象的号码都是0(点名MATLAB,唯一一个从1开始的奇葩玩意),因此任意一个像素的byte大小即可直接显示时换成相应色盘的颜色数据。
从上两节的定义可得,这张图的Width为8,Height为5,而由于从第三列开始某行有非0像素,因此该帧的XOffset为2,而由于从第二行开始某列有非0像素,则该帧的YOffset为1。同时,该图的第三列到第七列有像素非0,因此该帧的FWidth为5,该图的第二行到第四行有像素非0,因此该帧的FHeight为3。
假设我们使用横向读取法逐行扫描像素,由于第一行所有像素都为0,因此在读取时,第一行的数据会被整个跳过,同时,由于该图的前两列所有像素都为0,因此在从第二行开始读取时,前两列的像素也会被跳过。
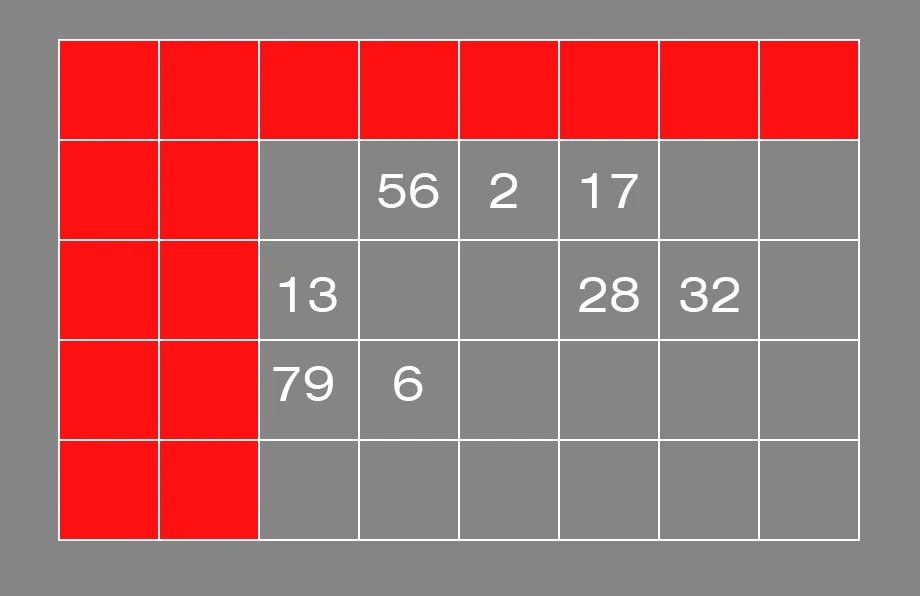
首先按照第一种方法:逐像素存储法,来统计一帧的数据。由于FWidth为5,因此每一行只有5个字节来记录。第一个像素为0,因此这一行的第一字节也就是00,第二个像素为56,因此这一行的第二个字节也就是38(十六进制),以此类推,这一行剩下的像素分别为02、11、00。五个像素结束,数量达到了FWidth,因此下一个字节也就是第三行的第三个像素(第1个+XOffset)。以此类推记录下一行为0D、00、00、1C、20,第三行为4F、06、00、00、00。行数达到FHeight,因此下一个字节记录的就是下一帧的相关信息。换句话说,这一帧的所有信息只有3 * 5 = 15 bytes。这也就是逐像素存储法的读取规则。
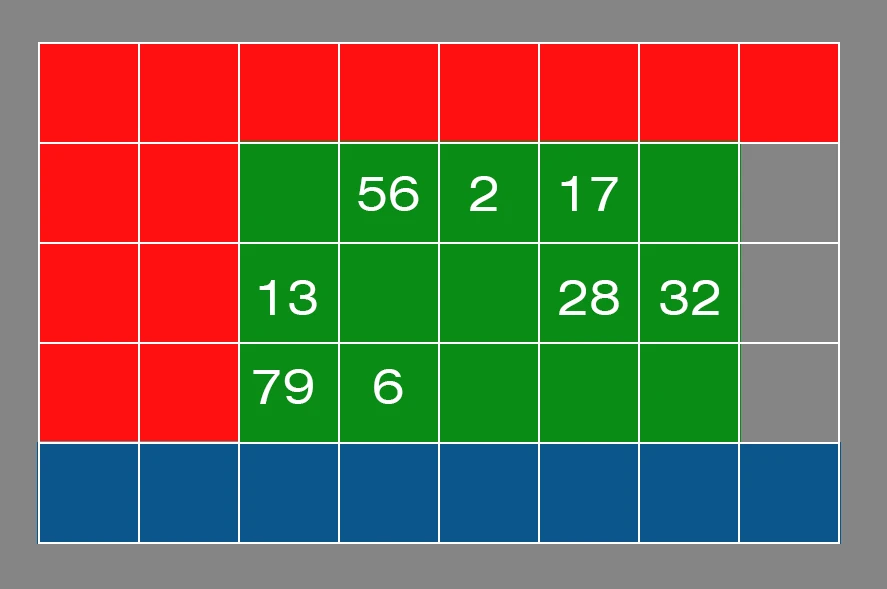
被跳过的,被略去的以及读取过的像素区域对比
第二种方法,或者叫“第三种方法”,则为压缩存储法。压缩存储的精髓在于合并所有区域内的单行0号像素连续区域为2字节的数据。但是,这种合并意味着每一行的数据并不为定值,因此压缩存储法的前两个字节记录了这一行所有数据的字节数。以第一个被扫描的行,也就是图像的第二行为例,假设这一行的字节数为XX,XX(两个byte用来存储这一行的字节数量,但目前暂时不知道这一行到底有多少字节,因此这里为未知数XXXX),由于第一个像素为0,且0号色持续1个后就是其他颜色,因此此处的记录为00 01,紧接着三个像素分别为56号色、2号色以及17号色,因此此处的记录依旧与第一种方法一致,为38、02、11,而由于下一个像素又是0号像素,且在出现一次0号像素后已读取的像素数量达到了FWidth,因此在11以后的这一行的数据分别为00、01。综上,这一行的像素数据一共为:XX、XX、00、01、38、02、11、00、01。字节数和为9,因此前两个字节分别为09、00(小端序)。第二个扫描行的第一个字节与第二个字节依旧暂时未知,而第一个被扫描的像素号码为13,变成十六进制即为0D,接下来有连续两个0号像素,因此这里的字节数据为00、02,接下来的两个像素28与32分别转换为字节就是1C、20,所以这一行的所有字节数据就是07、00、0D、00、02、1C、20,像素总数为7因此前两个字节的数据为07、00。最后一行除了第一个像素与第二个像素有数据以外后面三个像素都是0,因此第三行的所有字节数据为06、00、4F、06、00、03,像素总数为6因此前两个字节的数据为06、00。
下面来比较两种方法保存该帧时文件的大小比较:
逐像素存储法(共15字节):
第一行:00、38、02、11、00;
第二行:0D、00、00、1C、20;
第三行:4F、06、00、00、00。
压缩存储法(共22字节):
第一行:09、00、00、01、38、02、11、00、01;
第二行:07、00、0D、00、02、1C、20;
第三行:06、00、4F、06、00、03。
这也就是为什么压缩存储法不一定会比逐像素存储法体积空间更大。当shp内没有任何0像素点时,压缩存储法每一行都会额外使用两个字节来记录shp单行字节数量。因此此时压缩存储法保存的文件一定会比逐像素存储法保存的文件更大;而当shp本体较小,且0像素连续域每行小于2的时候,压缩存储法也不会比逐像素法更省空间。只有在FWidth到FHeight范围内每一行具有很长的0像素连续域的时候,压缩存储法才会比逐像素存储法更省空间。(也正是因为这样,SHP Builder设计了Auto Detect Best Compression来保存SHP文件,当逐像素保存法体积更低时就使用逐像素保存法,当压缩保存法体积更低时就使用压缩保存法)
此时,使用这个方法读取帧数目次数的帧数据,结合色盘即可还原每个帧的所有图像数据。同时,使用一个策略让跳过的所有像素都换成0号色或者是透明色,再输入一个在帧数号以内的数字,创建一个SHP画布大小的位图对象并该帧每个像素所对应色盘上的的RGB数值分别填入,SHP对象便可以使用位图的形式在图像上显示出来。

一个自定义读取SHP的作业:自定义读取SHP并可以生成shp的art数据的读取器
以上就是SHP文件打开的所有方法与注意事项。
四.后记
1. 大小限制
由于ushort的上限为65535,因此SHP的理论上限大小为65535*65535。然而,使用压缩存储法进行存储时,由于每行的字节总数上限为65535,因此如果一行内没有任何像素为空像素,那么使用压缩存储法存储的shp文件理论大小上限只有65533*65533。并且,随着现在制作爆炸特效的动画师们越来越多使用仿色处理边缘。这也会导致使用压缩存储法的效率大幅降低甚至文件大小大于逐像素存储法。每行每间隔一个像素就为0像素的时候,shp文件的上限长宽大约只有四万多。因此,使用仿色制作烟雾边缘与爆炸边缘的shp部分时候更适用于逐像素存储法进行存储,这样才会更省空间。
2. 专利趣闻
在2000年,电脑的计算能力还没有如今的电脑这么强大,因此,当时的游戏面对电脑的配置,或多或少做出了一些妥协,在SHP文件里便是体现为色盘文件的颜色位深不够,以及为了保证shp图像流不被压缩而采用的无损压缩算法。不过,查询资料可得,GIF文件使用的LZW无损压缩方式的压缩效率比SHP文件的压缩效率是要高得多的,那么为啥西木在制定SHP文件规则时,没有使用GIF那套压缩方案呢?很简单,因为LZW的专利在全世界直到2004年7月7日才全部过期(且不能续期),IBM持有的相关专利更是直到2006年才过期,因此,对于一个2000年的游戏而言,它也只能被迫使用这种效率但没有专利壁垒的方案对SHP文件进行压缩了。不过当时发明它的西木应该怎么也不会想到,十几年以后会有人使用shp文件做上万帧的32面的机甲载具,还会有人用它制作分辨率超过2000*2000的巨型飞船。在这个级别的shp上,shp压缩算法的作用已经非常有限,一个shp甚至可以占用将近0.7G的空间。或许,是时候让YR支持其他压缩算法的图像流文件了?
自此,关于SHP文件的所有谜团均已解开,这是一篇时隔一年半才写出的专栏,时隔如此之久我才能做出一点自己觉得稍有成就的小事,跟其他不断进步的modder比实在是进步太慢。在此,还是希望看到这篇文章的人都能天天进步,努力攀登自己的能力高峰。
