
国外有个神秘组织叫3blue1brown,起初因为用动画讲解线性代数火遍全网,这次,它们把手伸进了大模型领域,不久前发布了动画GPT系列,本想趁热乎翻译过来分享给大家,顺便蹭点热度,但仅仅一个下午,国内网站就陆续出现了译版,有的甚至没来得及翻译,不禁感叹国内自媒体同行是真卷啊!但这也间接反映了作品的质量。
既然抢占不了视频先机,那就转投文章。
视频分三部分。
第一部分,也就是本文,主要讲GPT背后的模型Transformer,先宏观概览Transformer的大致执行流程,然后掰开分别去详解Tokenlization、Embedding、Unembedding以及深度学习的基础知识。
第二部分,详细讲解Transformer的注意力机制。
第三部分,详细讲解Transformer中的前馈神经网络。
本文为第一部分。
有需要原版视频请到B站自行搜索或者在文章末尾留言。
目录
1.初识GPT和Tranformer
2.Transformer宏观概览
3.深度学习基础
4.Transformer四大件之一:Embedding
5.Transformer四大件之二:Attention
6.Transformer四大件之三:前馈神经网络
7.Transformer四大件之四:UnEmbedding
/ 01 /
初识GPT和Tranformer
GPT是generative pre-trained transformer首字母缩写。
第一个词很明显地指出了它是用来生成新文本的。
“pre-trained”表明模型需要经历在大量数据上预训练过程,这个词也暗示了模型后续在某个特定任务上继续进一步微调的可能。
最后一个词才是最关键的部分,“transformer”是一种特定类型的神经网络,一种机器学习模型,也是现今AI高速发展的核心创新。
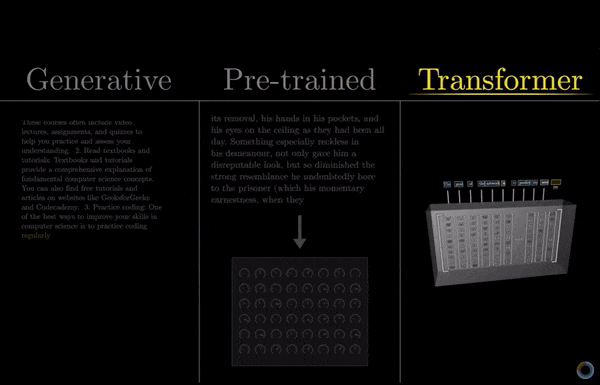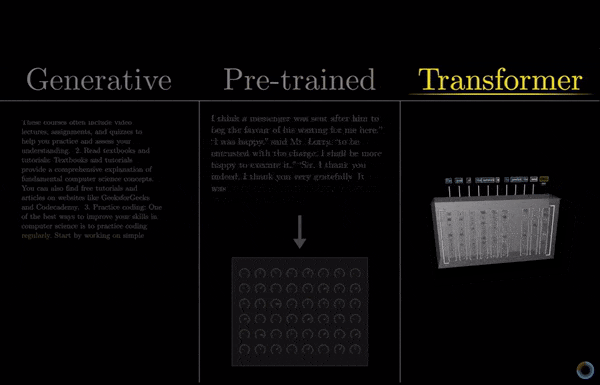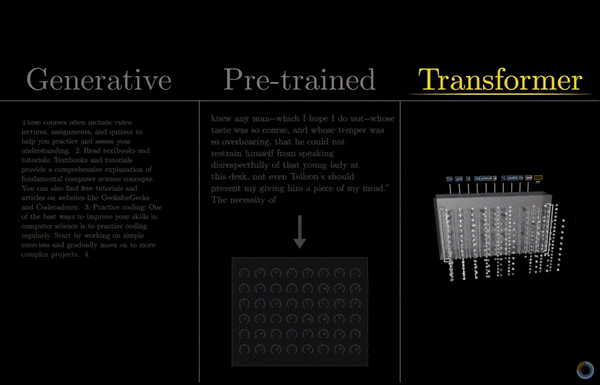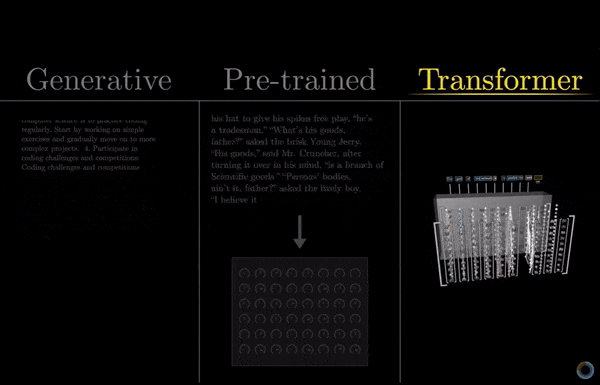
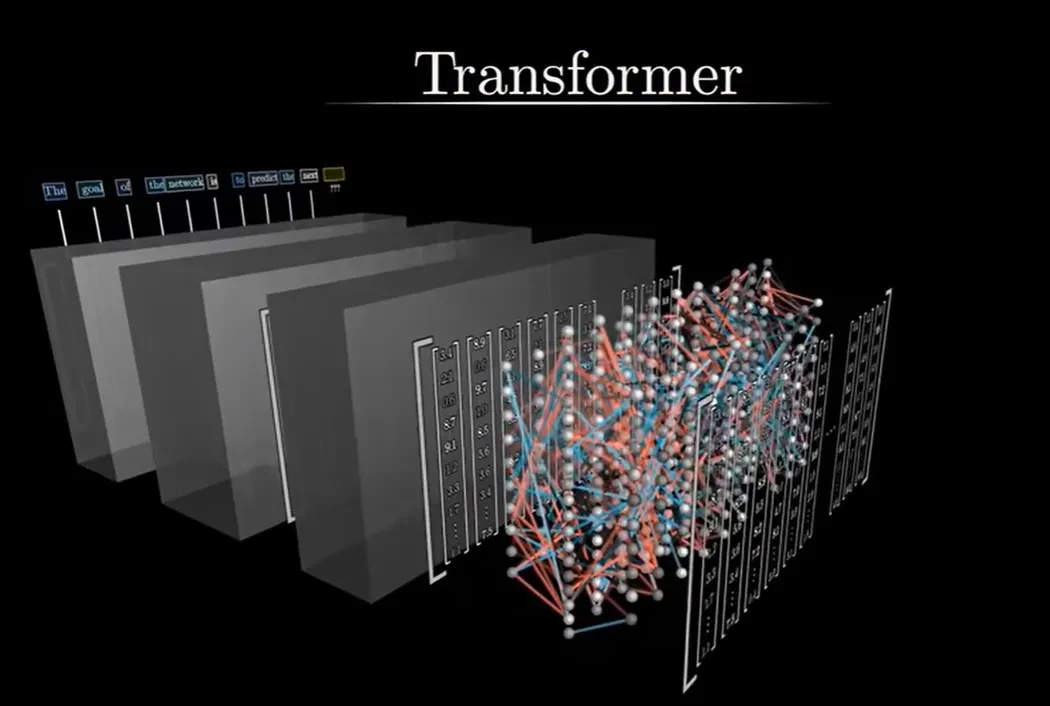
本文将通过可视化的方式探索Transformer内部原理,我们将逐步跟踪数据流经模型的整个过程。
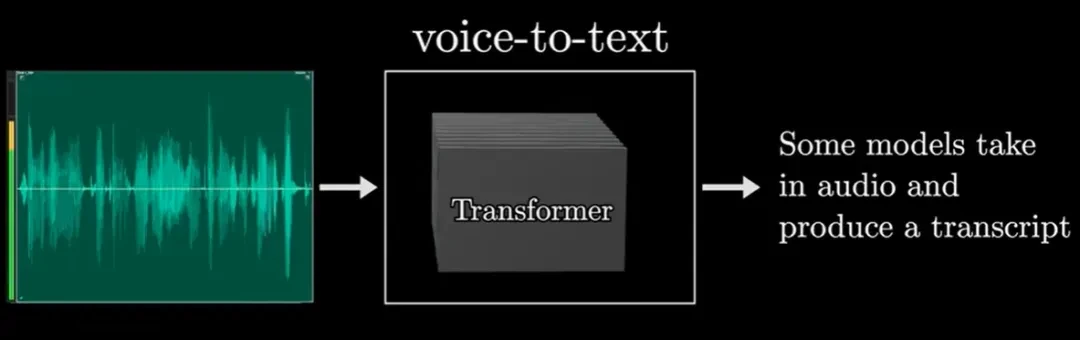
你可以基于transformer构建多种类型的模型,有的模型接受音频输入并生成文本。
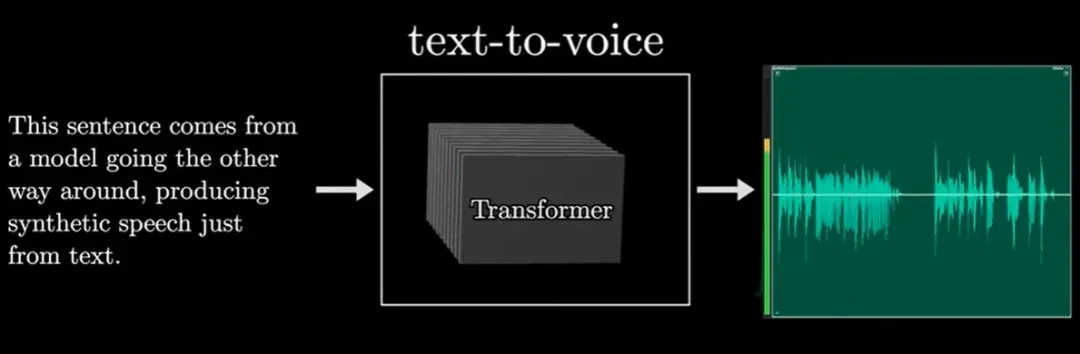
也可以是一个逆过程,根据文本生成语音。
在2022年风靡全球的绘画工具DALL-E和Midjourney,能够根据文本生成图像,也是基于transformer的。
即使有时我对它们生成的内容不是很理解,但我对此仍感到惊讶。
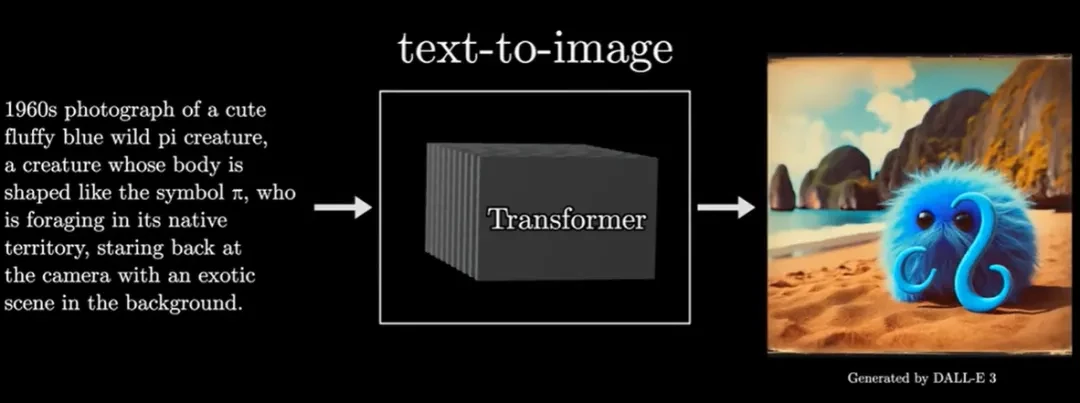
最初的transformer是由谷歌在2017年提出的,起初主要用于将一种语言翻译成另一种语言。
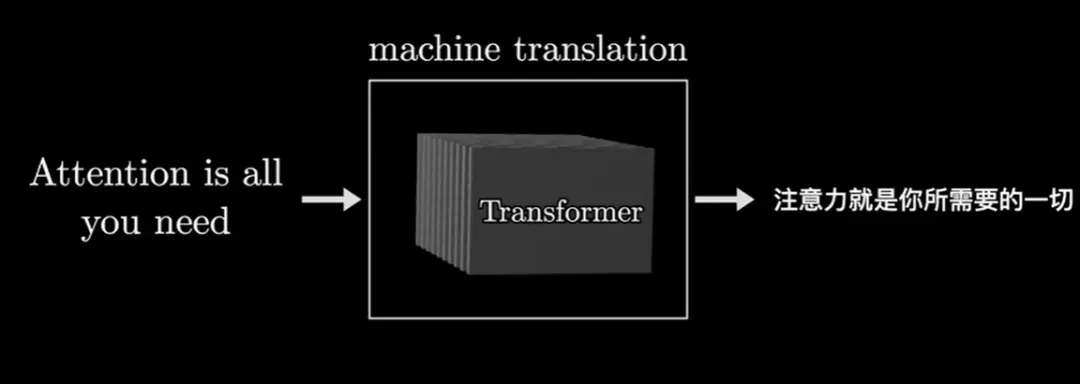
本文关注的则是它的一些变体,例如ChatGPT,一个可以接受一段文本(可能也会伴随图像和声音)的模型,然后生成下一个可能出现单词的概率分布,来预测文章后续内容。
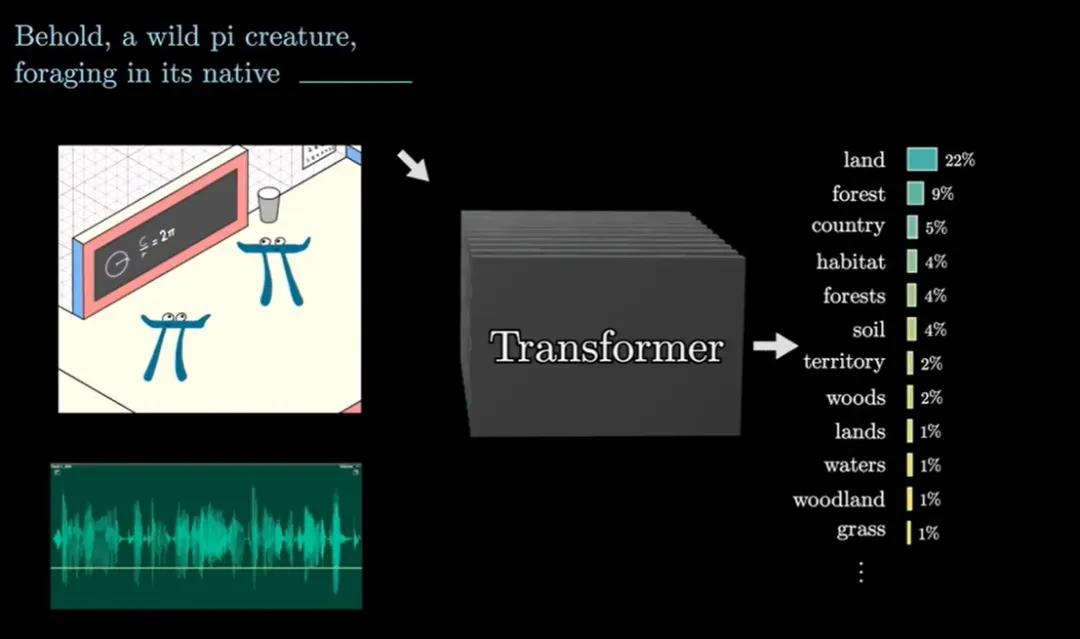
乍一看,预测下一个词与生成新文本并不完全划等号。
但事实证明,一旦你有了这样的模型,你就可以试着让它生成一段长文本,方法是给它一个初始文本片段,这个片段也被称为Prompt,然后从刚才生成的概率分布中选取一个样本,然后将这个样本追加到文本中。
接下来重复这个过程去继续生成新的预测,新的预测要基于所有的文本,包括刚刚添加的。
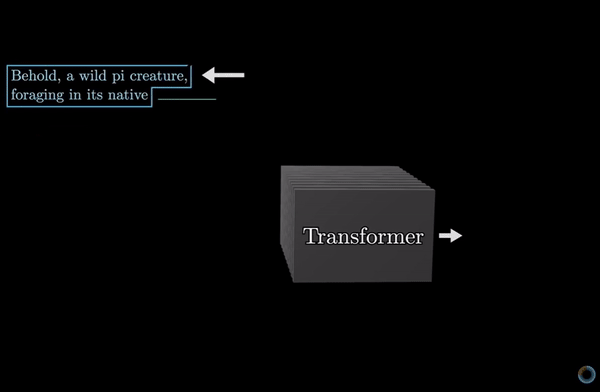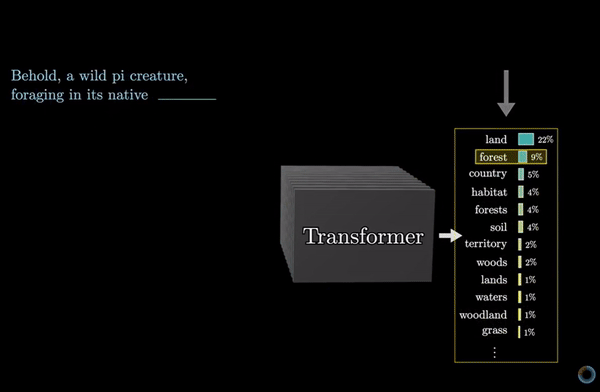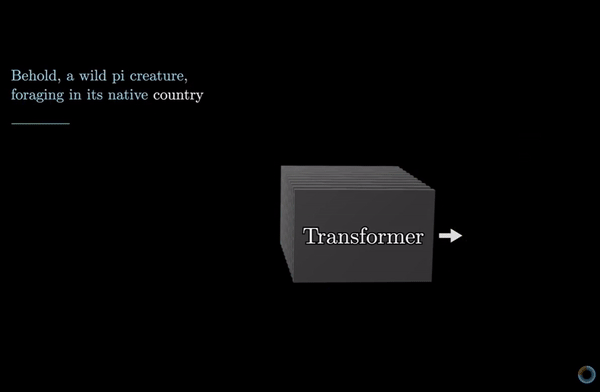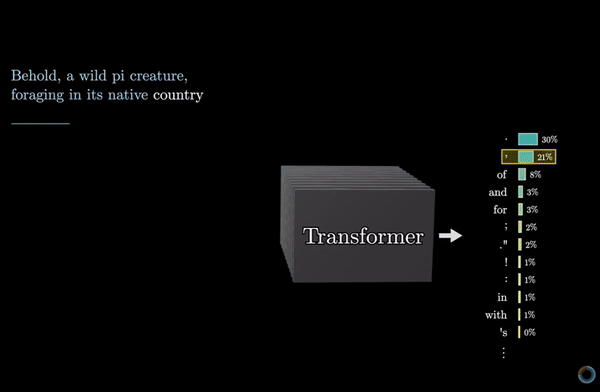
我不知道你怎么看,但我觉得这种方法的效果可能并不理想。
举个例子,在我的电脑中运行GPT2,然后尝试基于一段文本生成一段故事,让它不断地去生成下一个词,结果,这个故事基本没什么逻辑可言,但是,如果我换成GPT3,同样的模型,只是规模更大,突然间就像变魔法一样,不仅故事逻辑合理,甚至在故事中暗示一个Π生物可能居住在一个充满数学和计算的世界里。
了解了GPT的概念,接下来认识一下其背后的模型Transformer。
/ 02 /
Transformer宏观概览
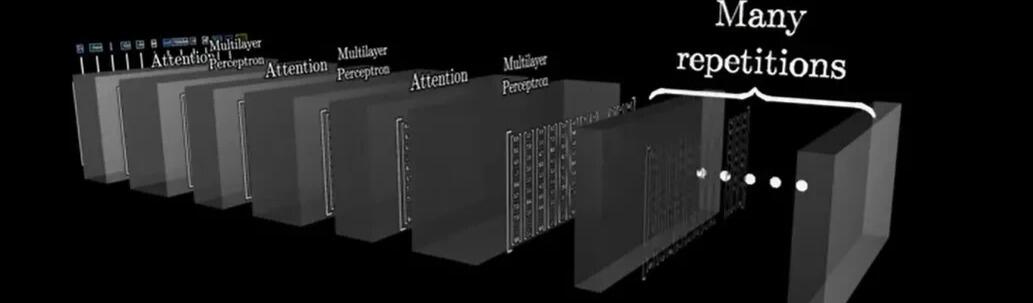
在此之前,让我们先从宏观上看数据是如何在transformer中流转的,然后,我们将详细探讨解释每一个步骤,并对其进行扩展。
大体上讲,transformer主要分为下面四个主要构成部分。
由于Attenion和MLP的复杂性和重要性,我会分别另起一篇去讲。
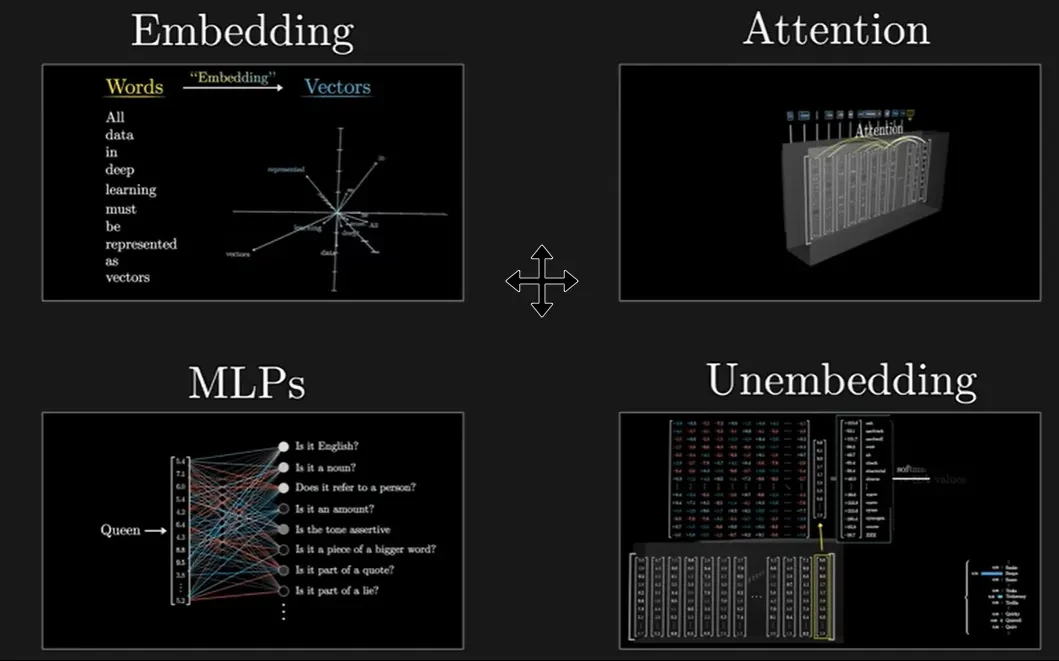
在正式讲Enbedding之前,还得先讲讲Tokenization分词,它不光是大模型,也是很多NLP任务的第一步。
Tokenization会把输入文本拆分成小片段,这些小片段被称为tokens,对于文本来说,这些tokens通常是单词或者单词的一部分或者是其它常见的字符组合。
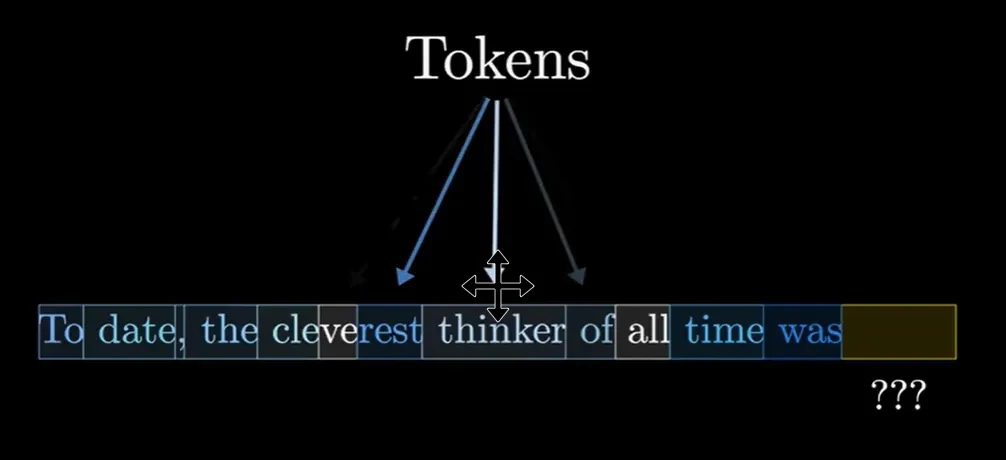
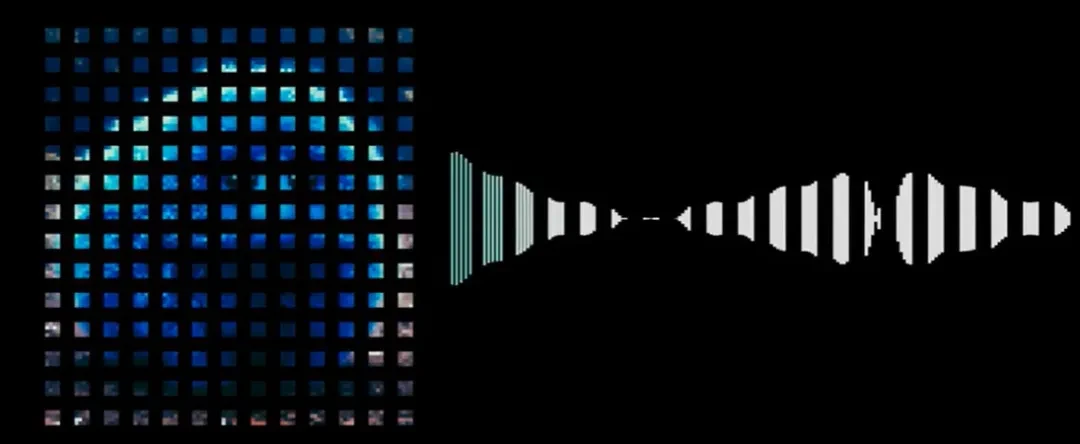
如果包含图片或者声音,tokens可能是图像被划分为一个个小patch,或者是声音片段。
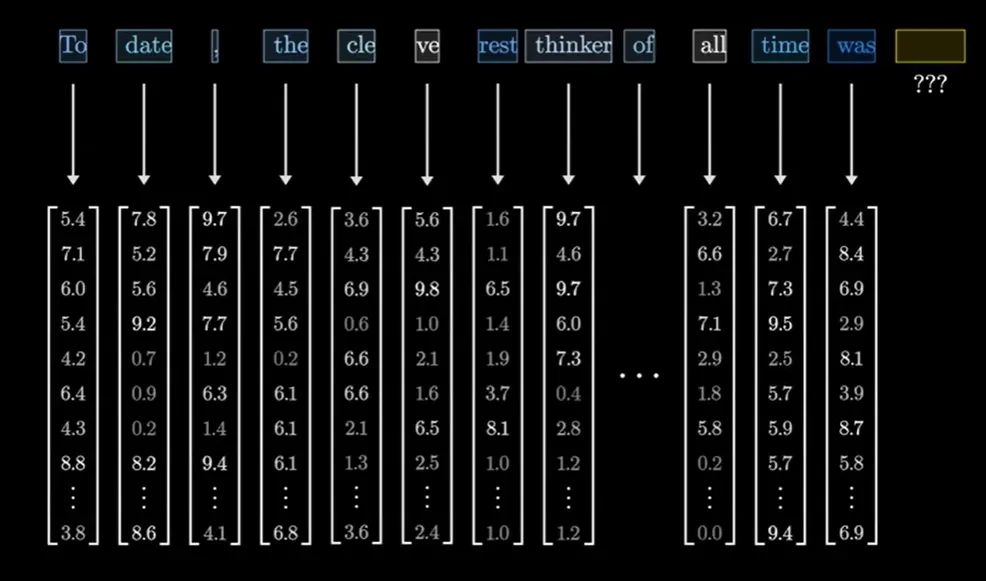
然后,每个token都对应到一个向量上,也就是一串数字,这串数字的意义是从某种方式来表达这个片段的含义。
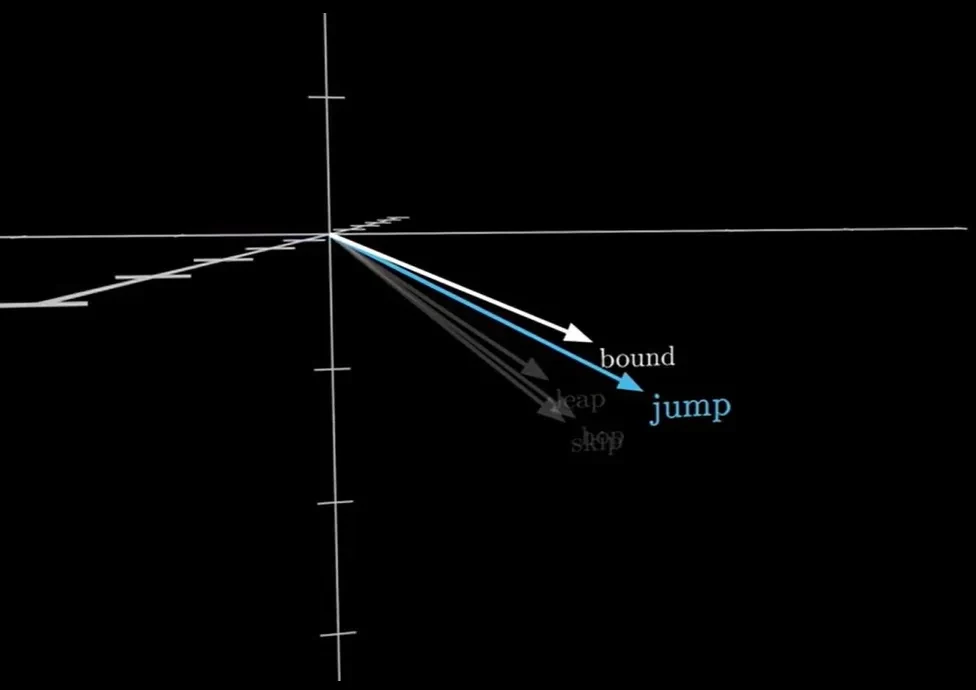
如果你把这些向量看作高维空间中的坐标,那么,含义相似的词汇对应的向量倾向彼此接近。
这些向量序列接下来会经过一个称为“注意力块”的处理过程,使得向量之间能够相互交流,并根据彼此信息更新自身的值。
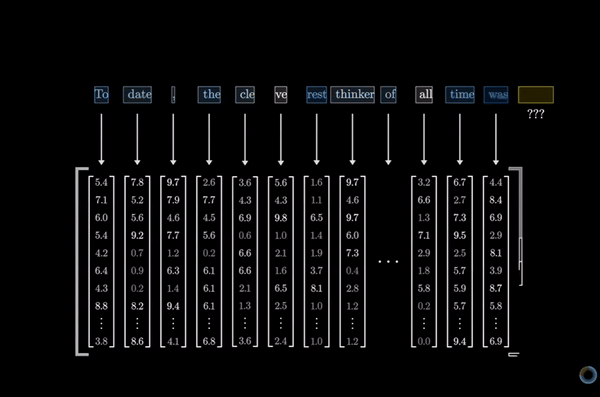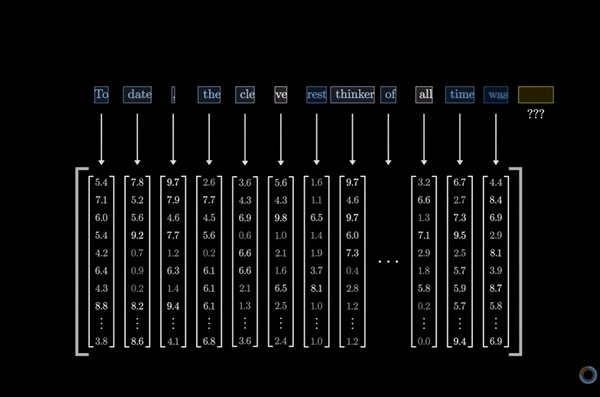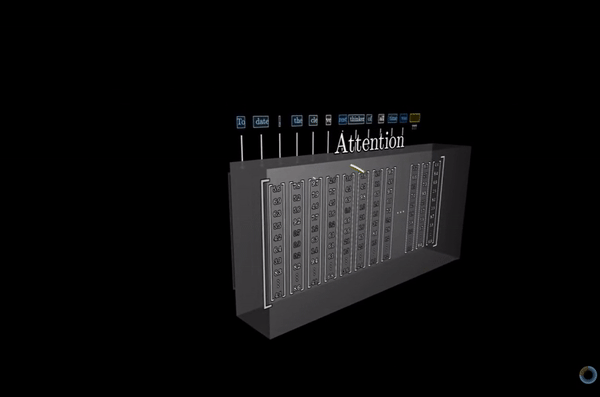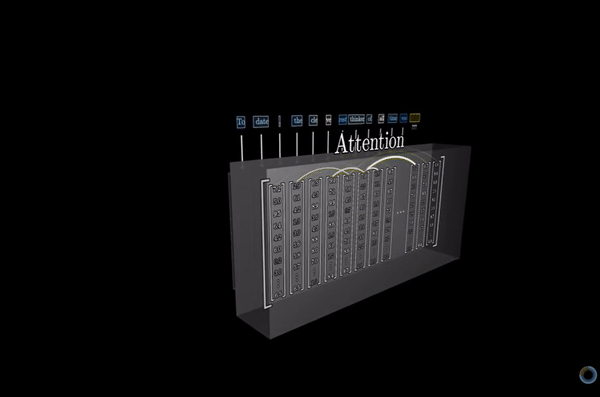
例如,model这个词,在machine learning model中的意思和a fashion model中意思是不同的。注意力块的作用就是确定上下文中的哪些词对更新其它词的意义有关,以及该如何准确的更新其含义。
每当我说到“含义”这个词时,完全是通过向量中的数字来表达的。
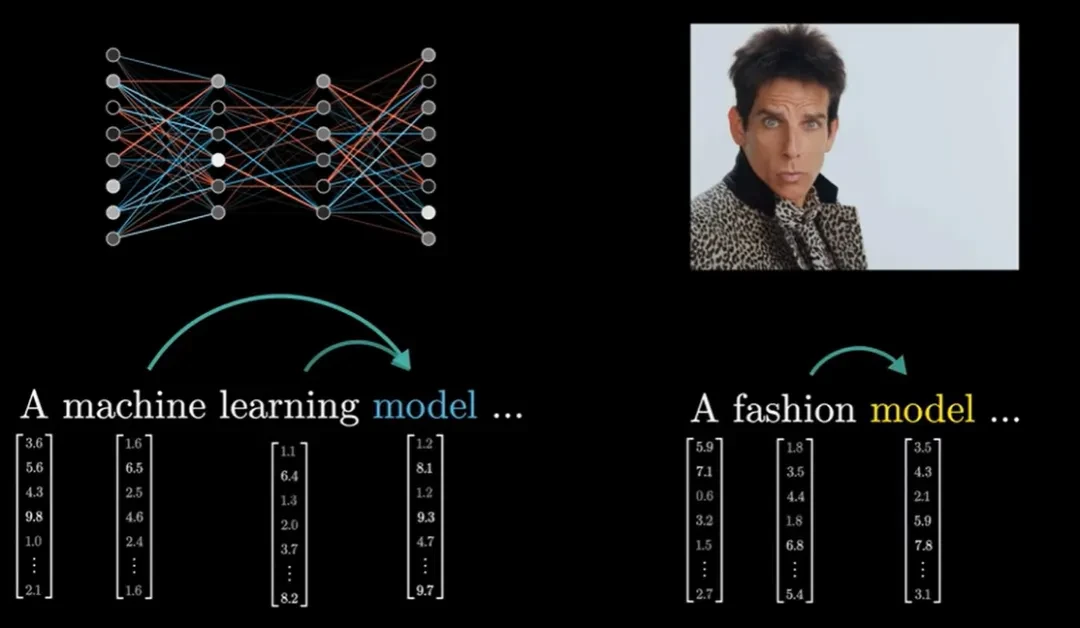
之后,这些向量会经过另一种处理,这个过程可以被称作多层感知机或者前馈神经网络,这个阶段向量之间不再产生交流,而是并行地经历同一处理。
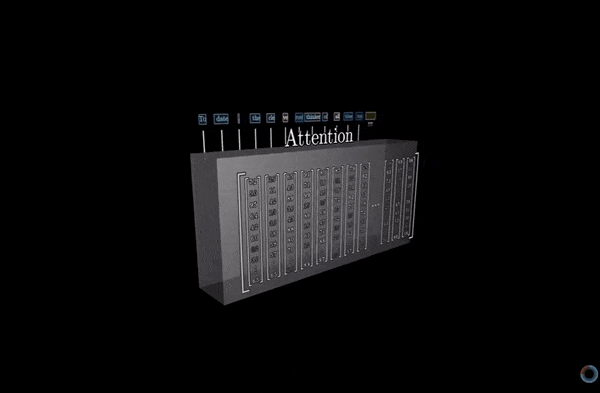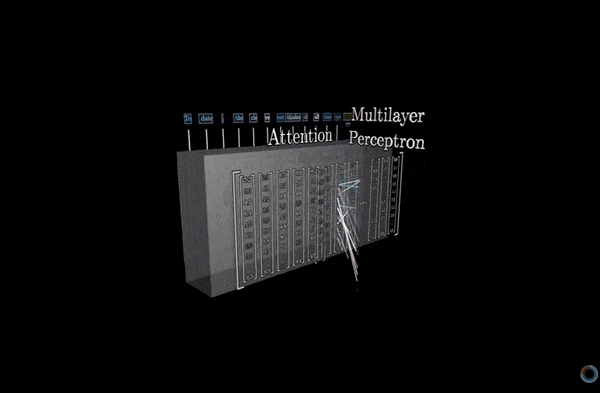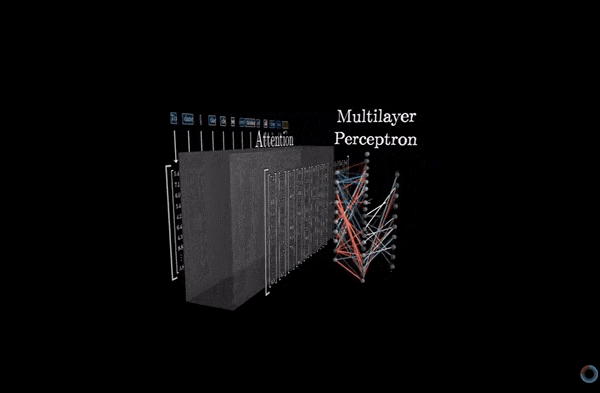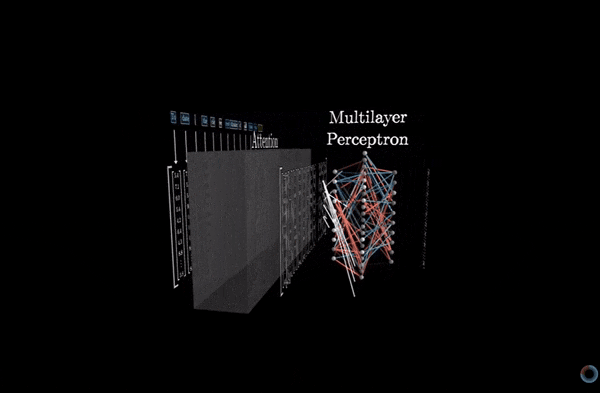
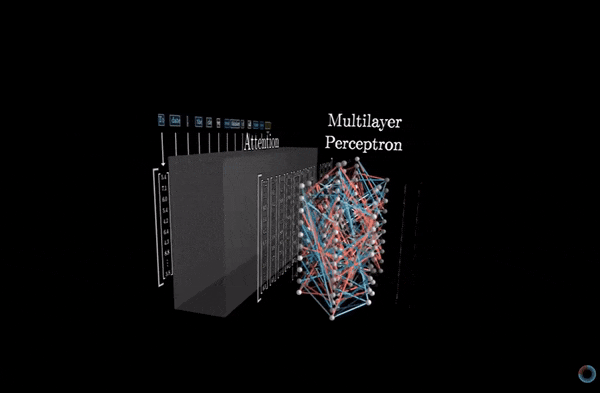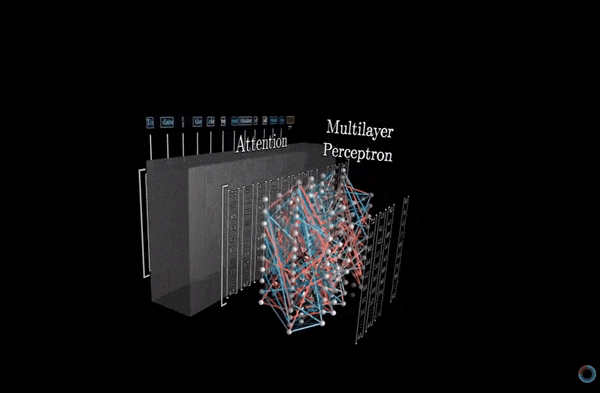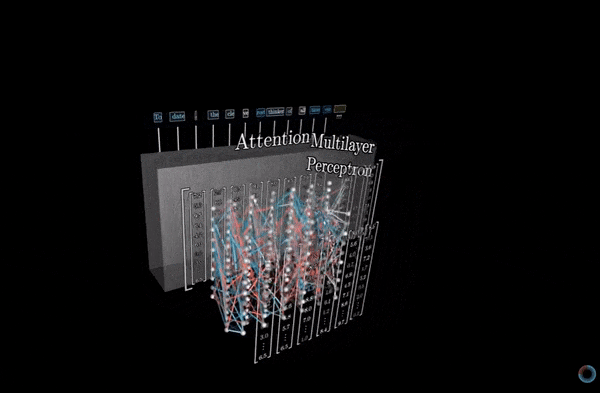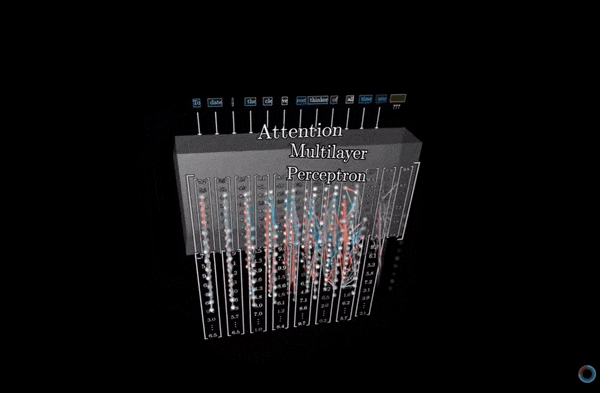
这个步骤比较难理解,我们会在后面文章中详细讨论。
MLP这个过程有点像对每个向量提出一系列问题,然后根据这些问题的答案更新向量。
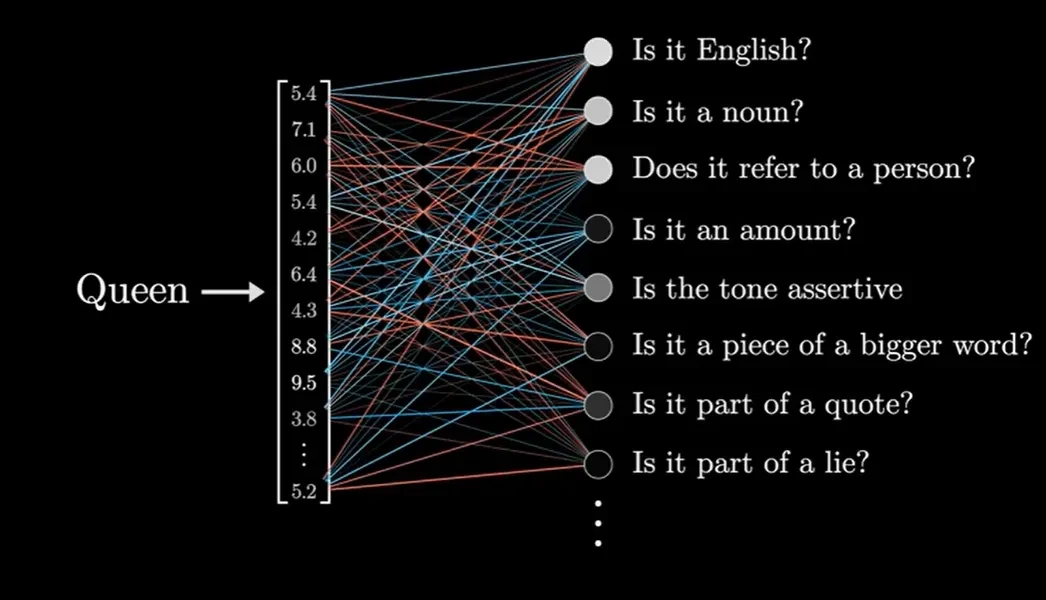
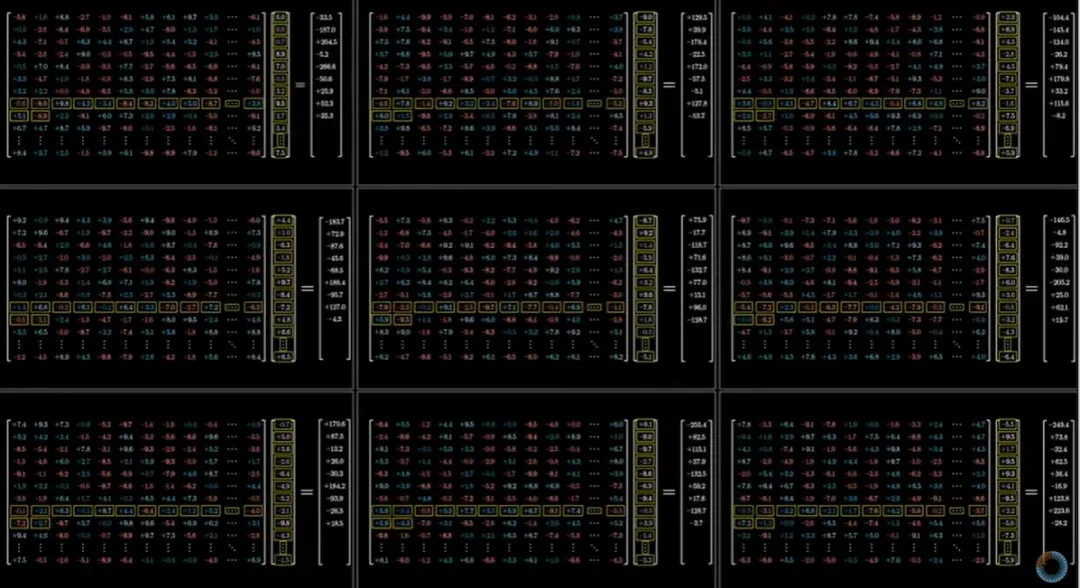
这两个处理阶段的操作本质上都是大量的矩阵乘法,我们主要的学习目标是:如何解读这些背后的矩阵。
因为Transformer是由多个重复的Transformer Block构成的,所以,接下来的过程就是重复的了,就是在注意力模块和多层感知机模块之间不断切换。
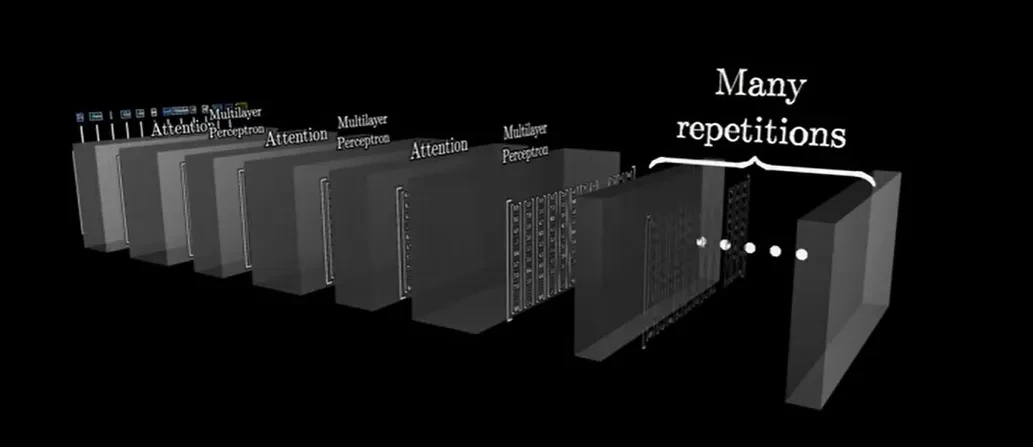
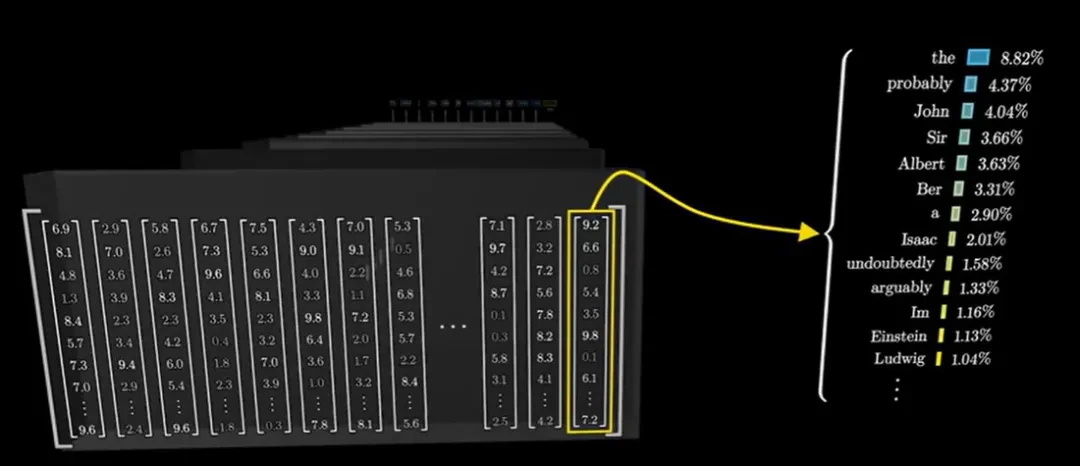
直到最后,我们期望通过某种方式,文章的核心意义已经被完全融入到序列的最后一个向量中,然后对最后一个向量进行特定操作,产生一个覆盖所有可能token的概率分布,这些token代表接下来可能出现的小段文本。
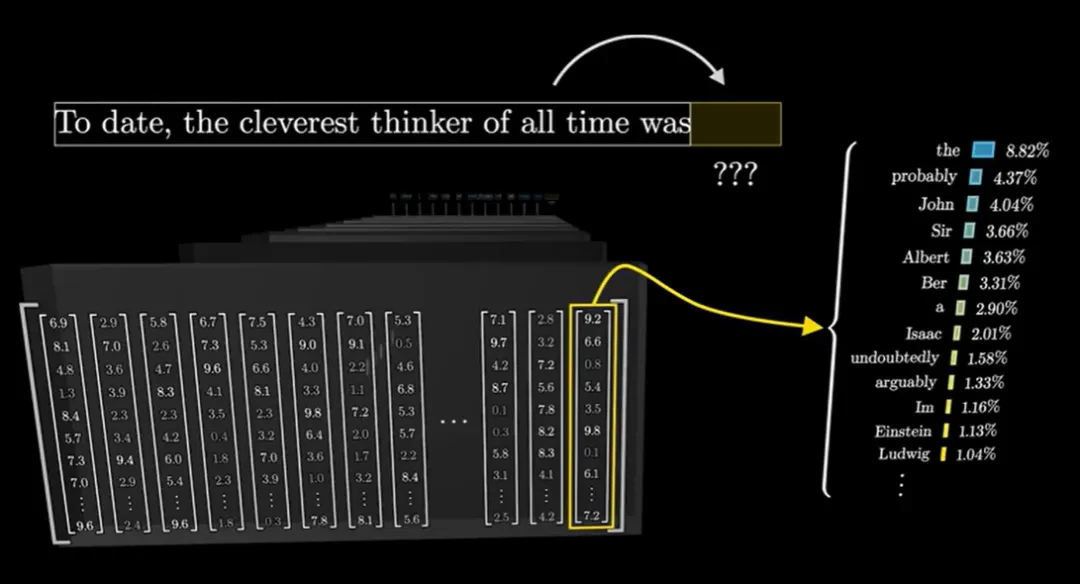
一旦你有了这样的工具,根据一段文本预测下一个token,你可以给它输入一段初始文本,然后从概率分布中取样获取下一个token,追加到现有文本中,然后不断重复这个过程。
将这样的工具转化为机器人的一个简单方法是,准备一段文本,设定一个场景,也就是所谓的系统提示,然后将用户的初始问题或者提示词作为对话的开头,接着让AI开始预测,这个有用的AI助手会就会做出回应。
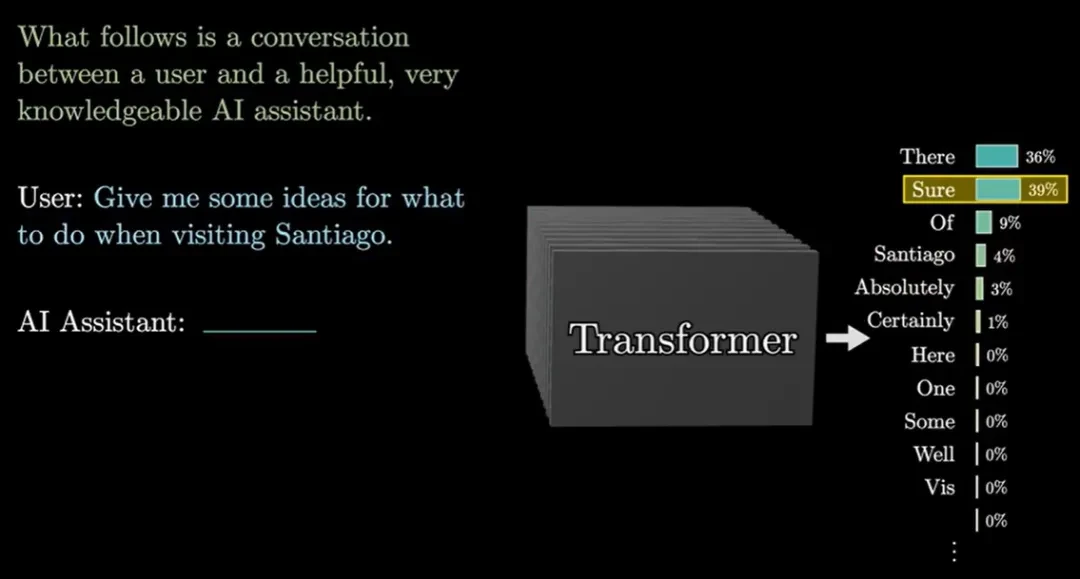
以上就是Transformer的基本运行过程了。
在正式探讨网络开头的Embedding和网络结束的Unembedding发生的事情前。先让我们花些时间回顾一些重要的背景知识,这些知识对于熟悉Transformer的工程师来说都是基础知识。
/ 03 /
深度学习基础
如果你对背景知识比较熟悉,而且迫不及待了解更多,你可以直接跳过本章节。
但是在深入研究Transformer之前,我认为有必要确保对深度学习的基本概念和模型有一些了解。
这里需要明确的是,机器学习是一种方法论,它涉及到使用数据来指导模型行为的模式。
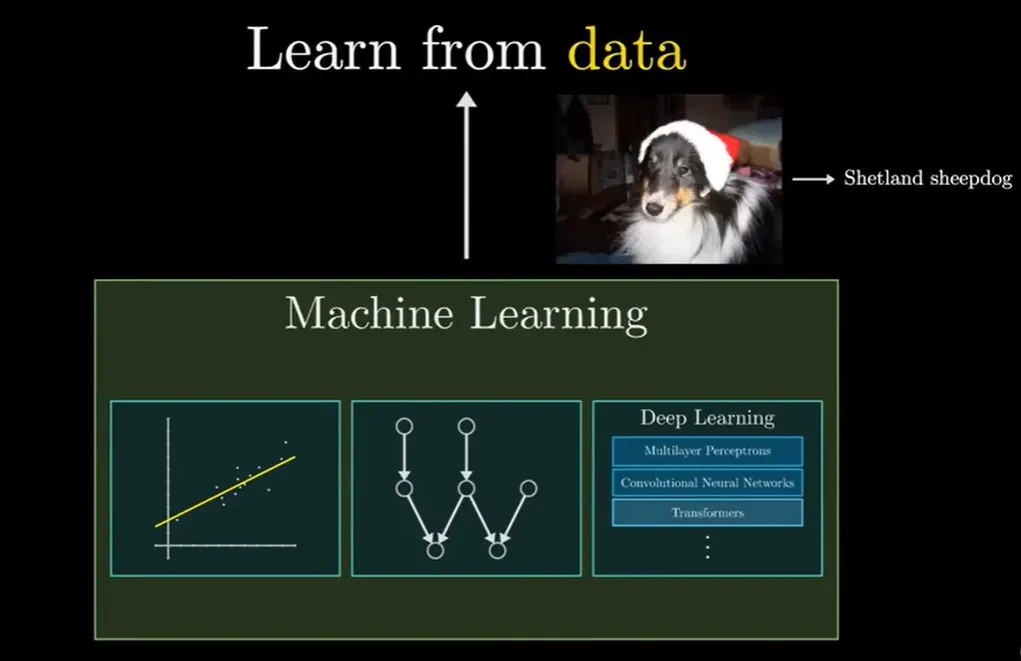
具体来说,你可能需要求得一个函数,使其输入一张图片,输出对应的标签描述,或者预测文本片段的下一个词,或者其它需要直觉和模式识别的任务。
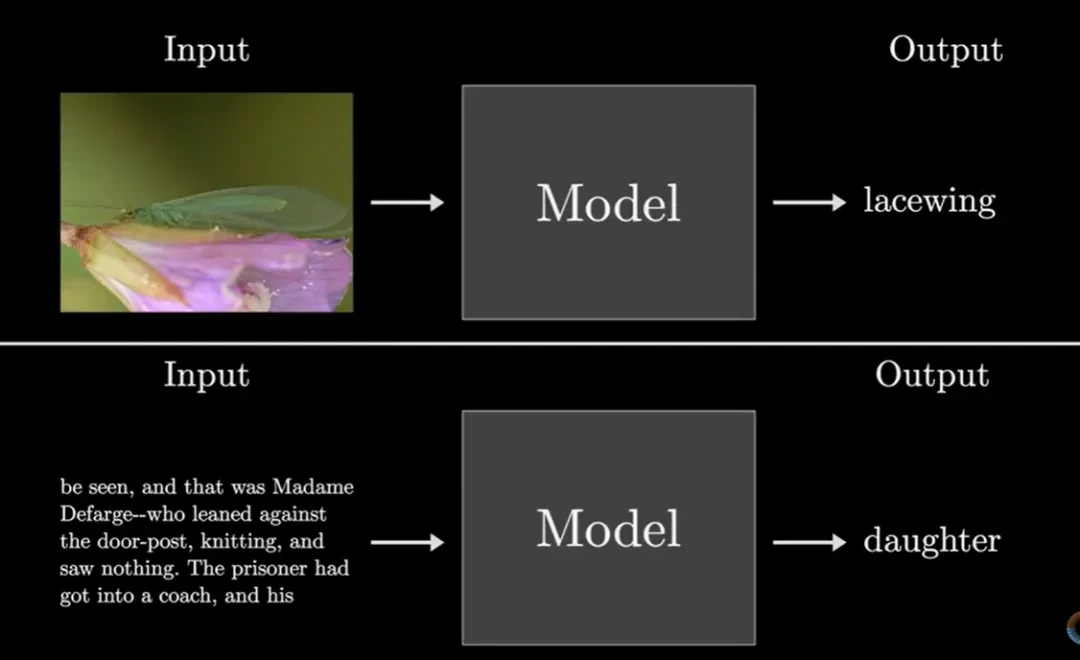
机器学习的核心思想在于,我们不再尝试去编写固定的程序来完成这些任务。
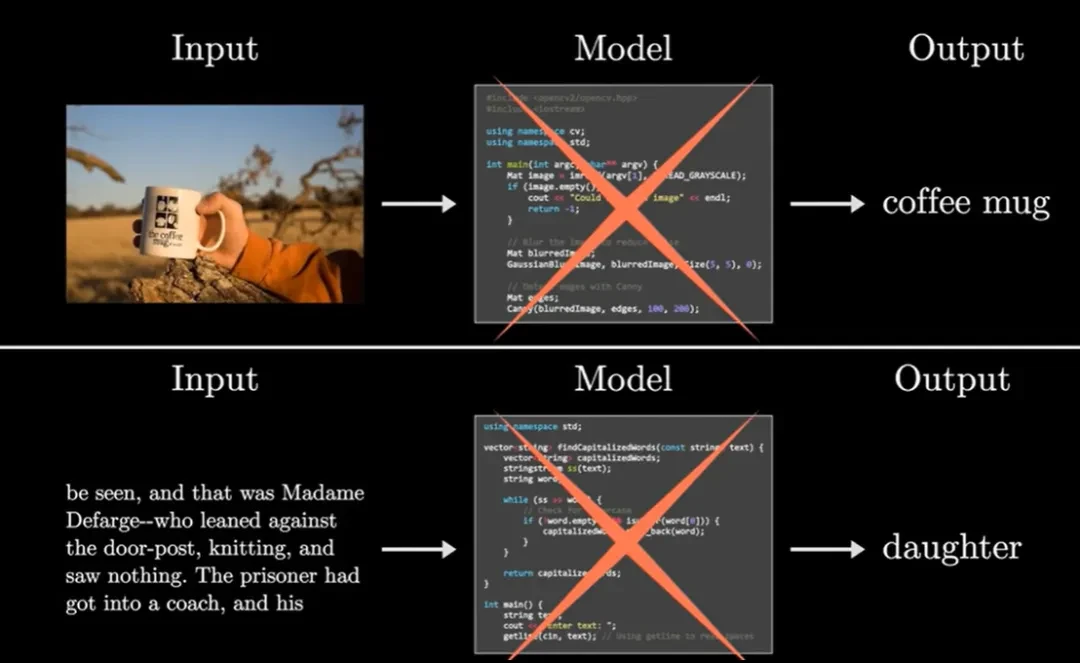
而是构建一个具有可调节参数的灵活结构,就像一系列旋钮和调节器,然后通过对大量实例输入和期望输出的学习,来调整和微调参数的值来模拟这种行为。
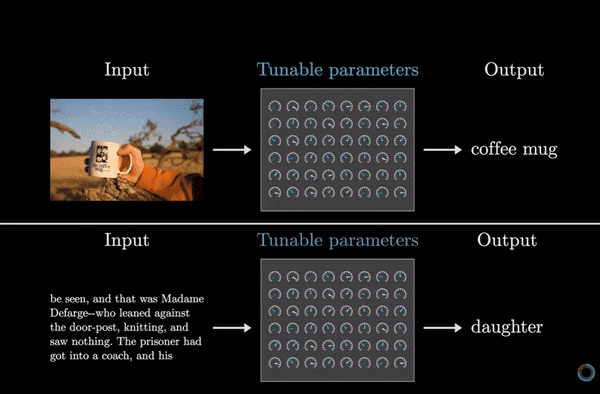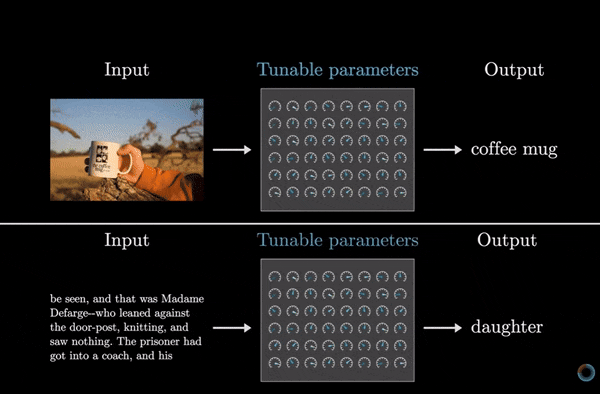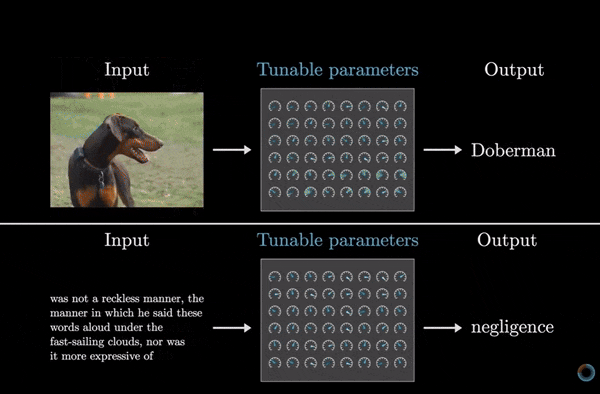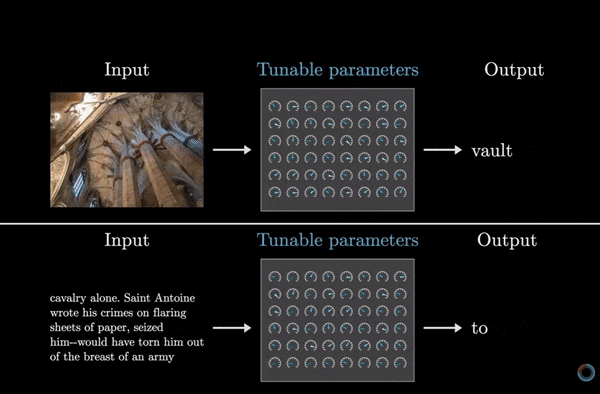
例如,最直观的机器学习模型:线性回归,输入输出都是标量数字,如房子的面积和价格,你要做的就是找到一条能拟合这些数据的线,以此来预测将来的房价。
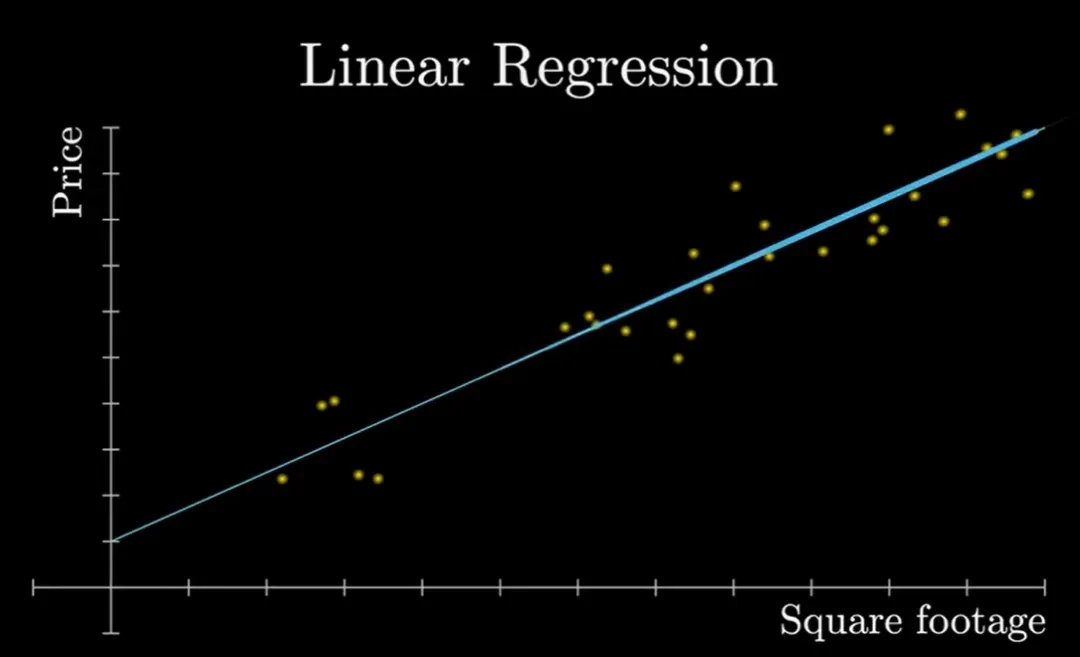
这条线由两个参数决定,即斜率和截距,线性回归的目标是,确定能够完美匹配这些数据的参数。
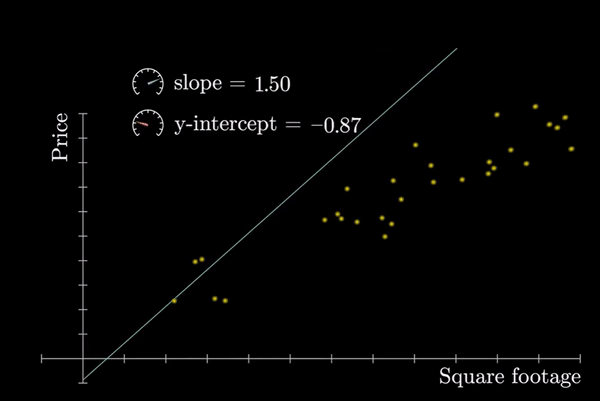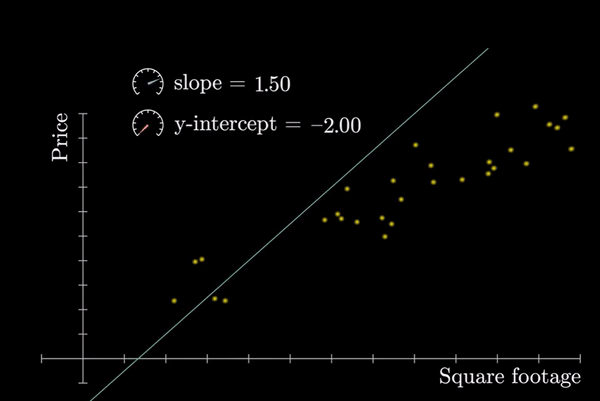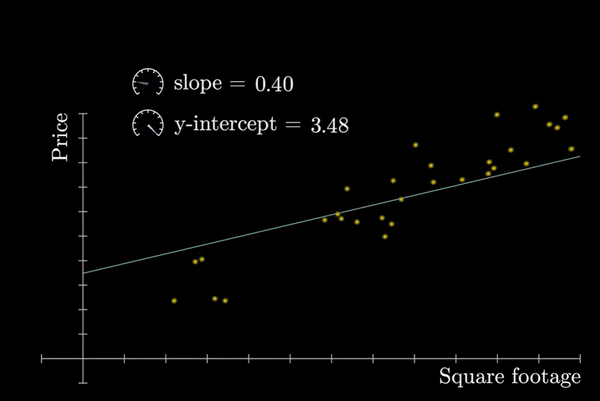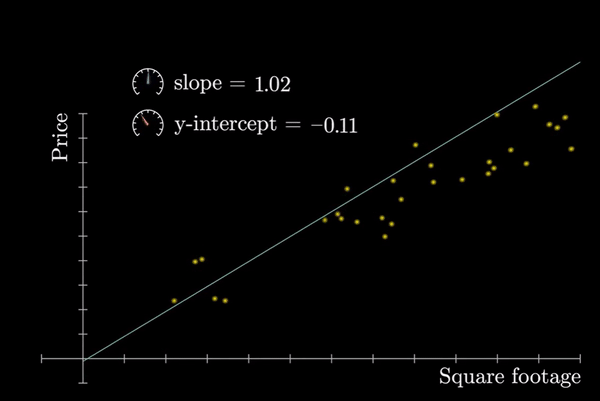
不用说,深度学习模型更加复杂,比如,GPT3有1750亿个参数,而不仅仅是两个。
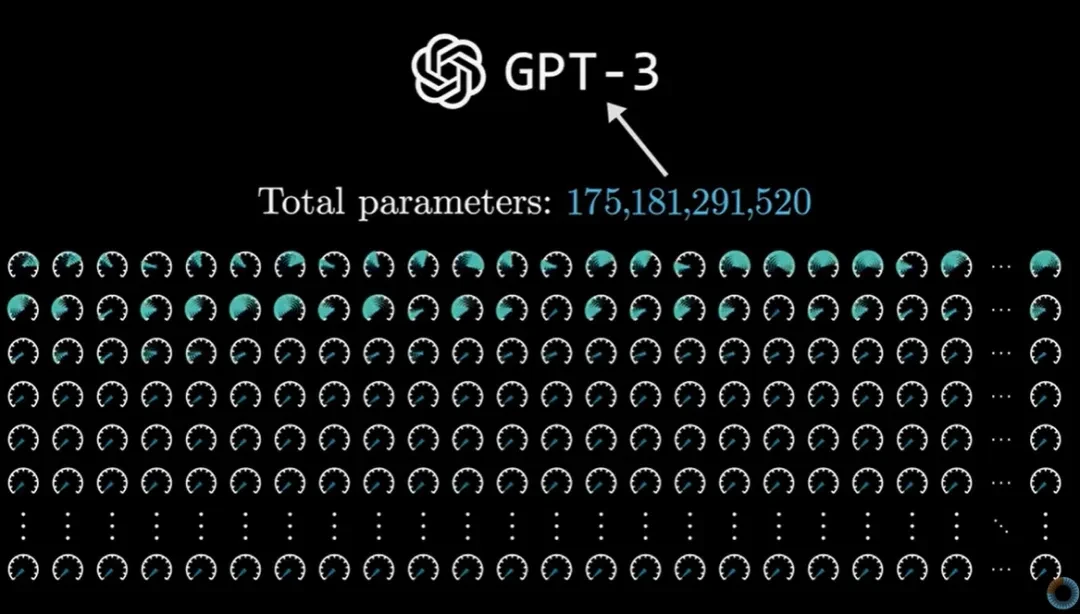
但值得注意的是,并不是模型越大参数越多越好,这样做可能会导致模型严重过拟合训练数据,或者训练起来极其困难。
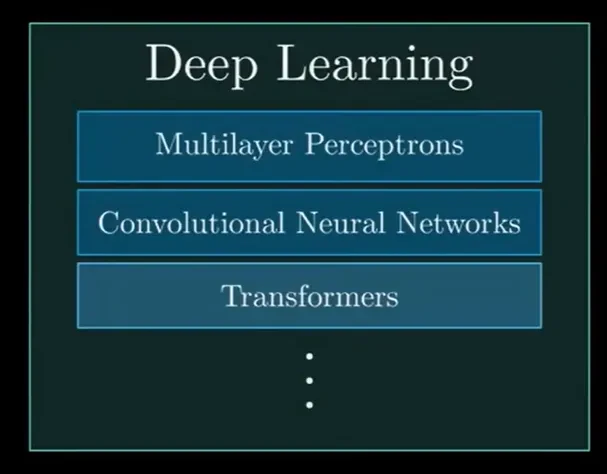
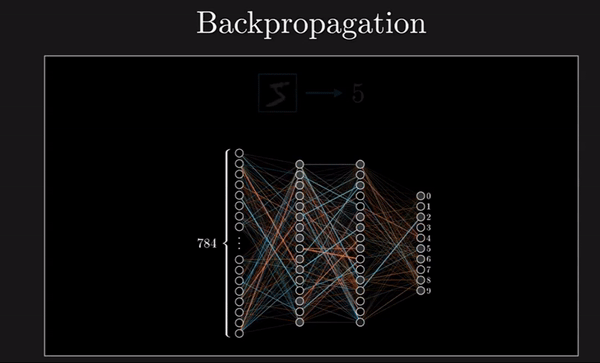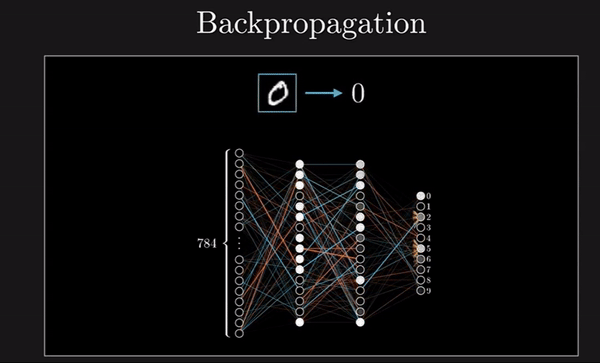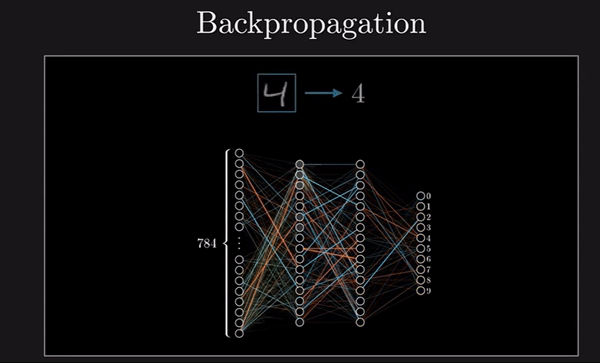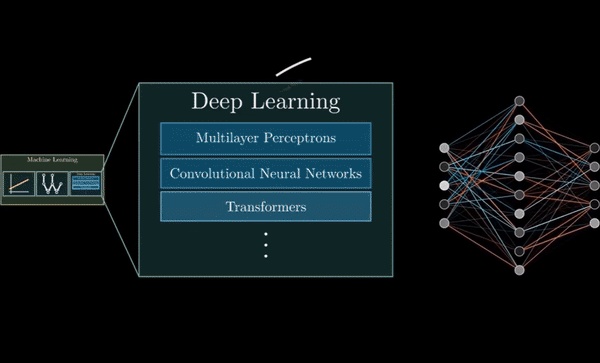
深度学习涵盖了一系列具有出色扩展能力的模型类别,它们之所以能够成功,关键在于都采用了相同的训练方法,即反向传播。
你需要理解的是,要让这种训练方法能在大规模应用中顺利进行,模型必须遵循一种特定的结构。
首先,不管你是构建哪种模型,输入必须是一个实数数组,这可能只是一个数字列表,也可能是一个二维数组。
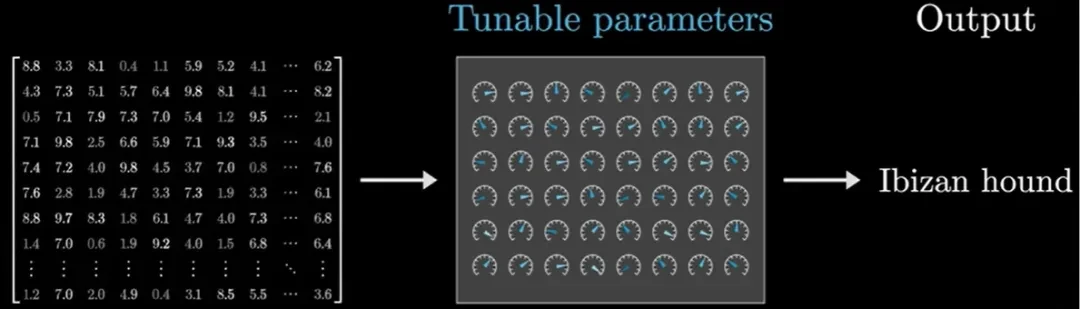
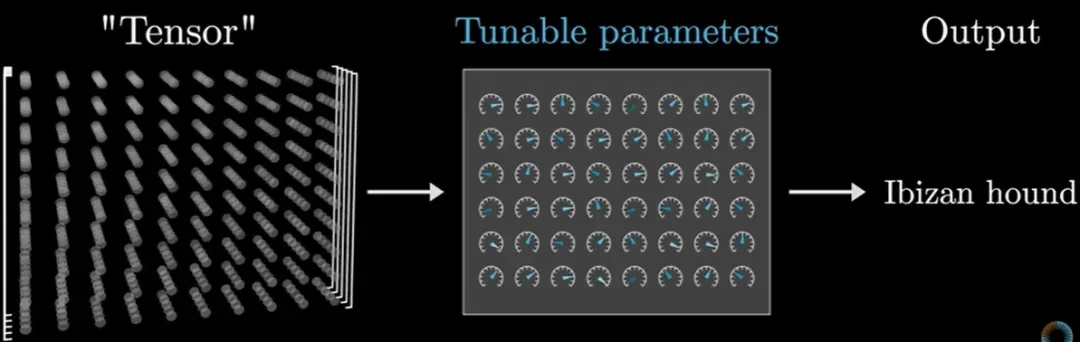
或者更常见的高维数组,我们通常称之为张量。
这些数据通常会被逐步流经多个不同的层,每一层的输出也可被组织成实数数组,直到最后一层,你可以视其为输出层。
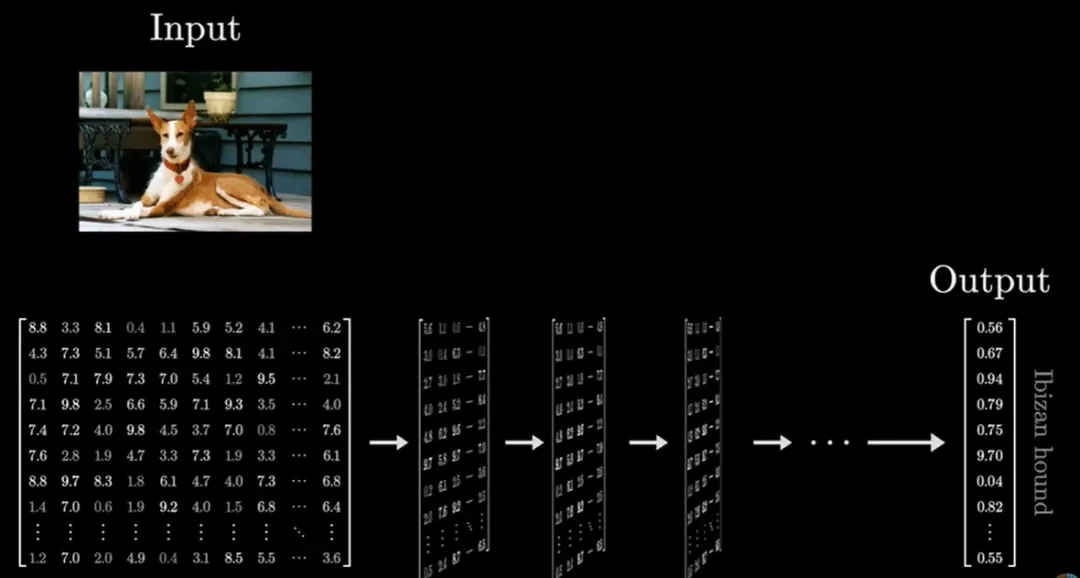
例如,我们的文本处理模型输出层最终输出一个数字列表,这些数字代表了所有可能的下一个词的概率分布。
在深度学习领域,这些模型的参数通常被称为权重,这样称呼的原因是,这些模型的一个核心特点是,这些参数与正在处理的数据之间的唯一交互方式,就是通过权重和,虽然模型中也会穿插一些非线性函数,但它们并不依赖这些参数。
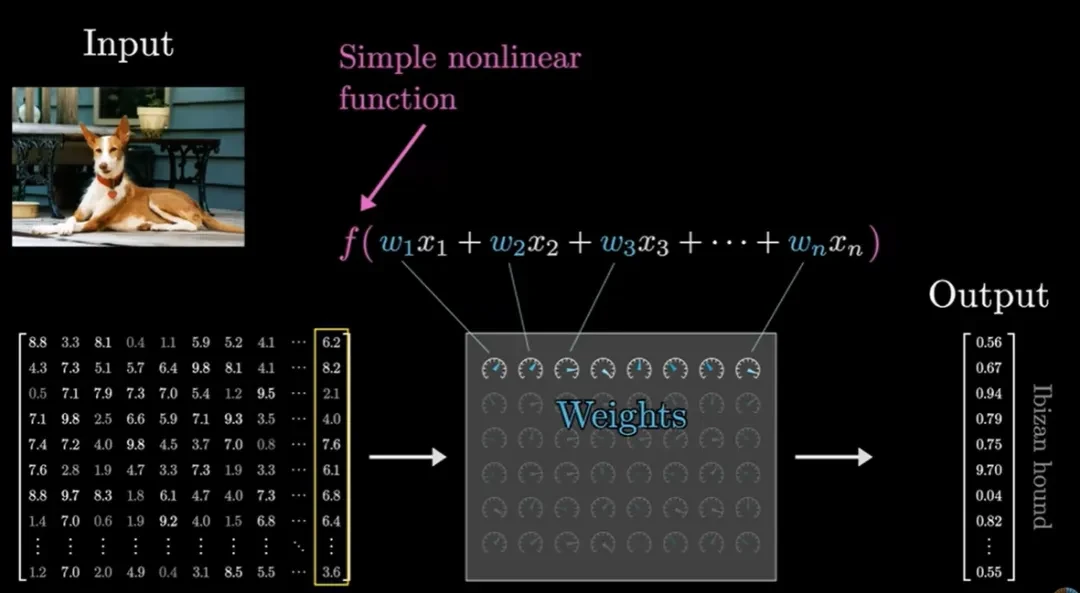
通常来说,我们不会直接看到这些权重零散的工作,而是被组织成矩阵向量乘积的形式。
如果你了解矩阵向量乘法计算规则,你就会发现这其实是表达同一种概念,输出的每一个元素就像是一个权重和。
更直观的方式是,可以将这些可调参数矩阵想象成对数据进行转换。
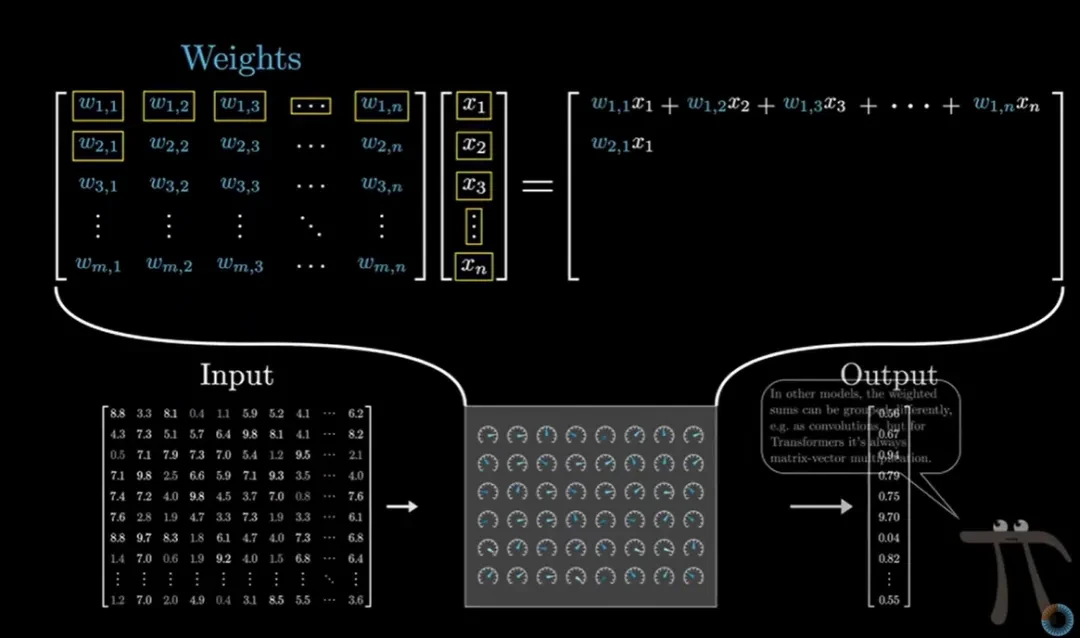
例如,GPT3中的1750亿个权重,就被组织在大约28000个不同的矩阵中,这些矩阵又被划分为八个不同类型,你和我将要做的就是逐一理解这些矩阵,了解每种类别的功能。
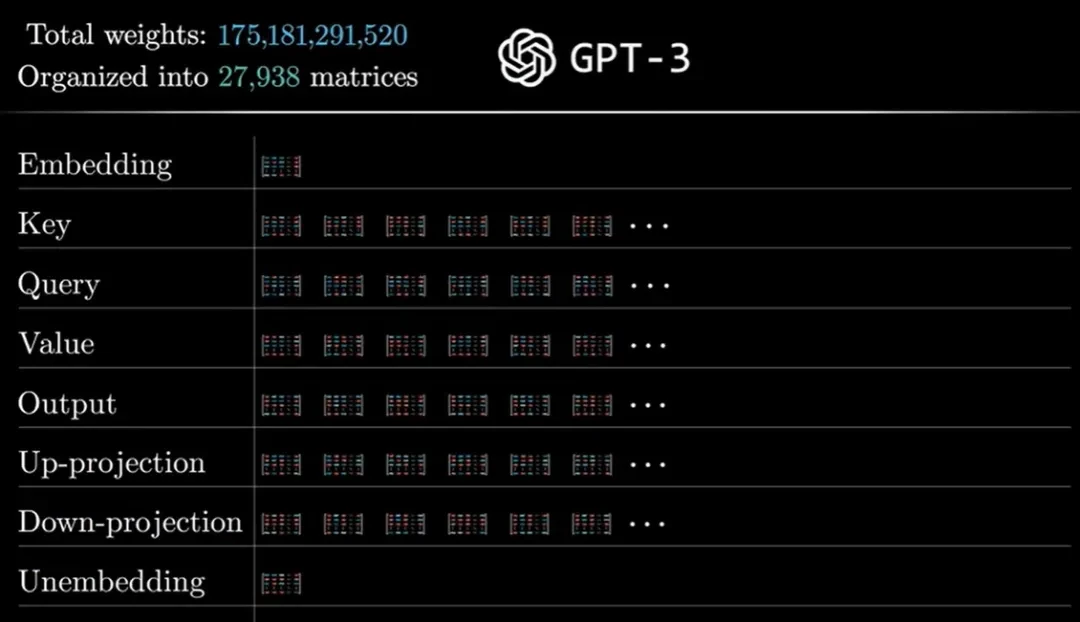
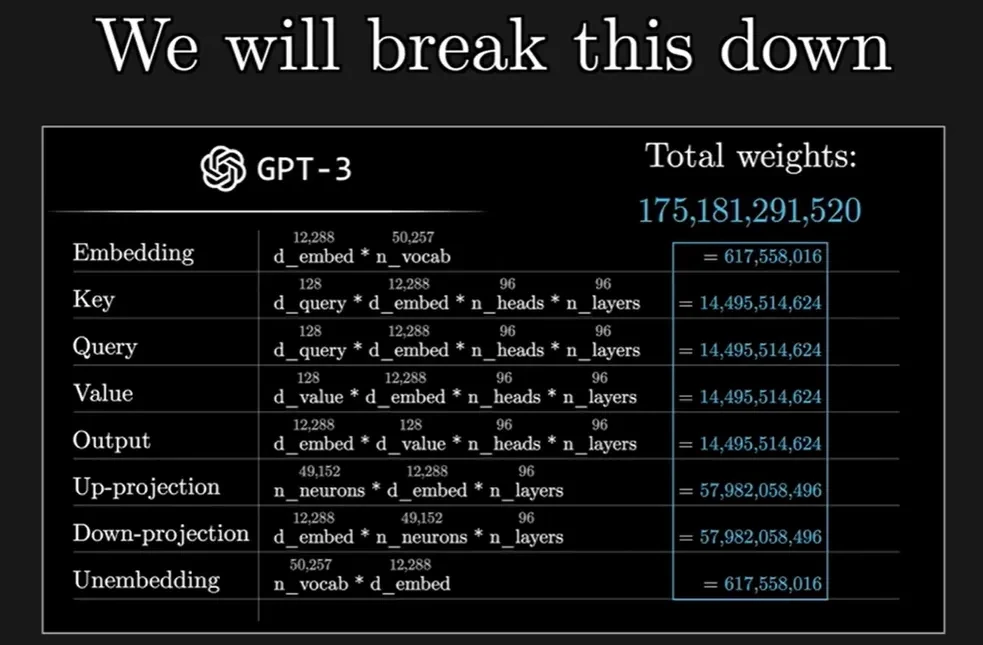
接下来的过程将会非常有趣,我们将参考GPT3的具体数据,来统计这1750亿个参数是如何分配的。
当你探索像ChatGPT这样工具的内部机制时,你会发现几乎所有计算过程都体现为矩阵和向量乘积。
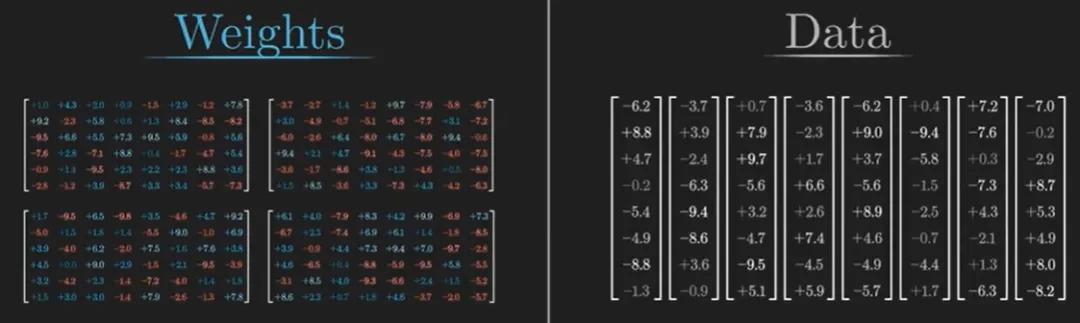
在这海量的数字中,很容易迷失方向,但你需要清楚区分两个概念:模型的权重(用红色和蓝色表示)和正在处理的数据(用灰色表示)。
权重是模型的大脑,它们在训练过程中会被修改,它们决定了模型的行为模式,而正在处理的数据仅仅编码了输入到模型中的具体输入。
/ 04 /
Transformer四大件之一:Embedding
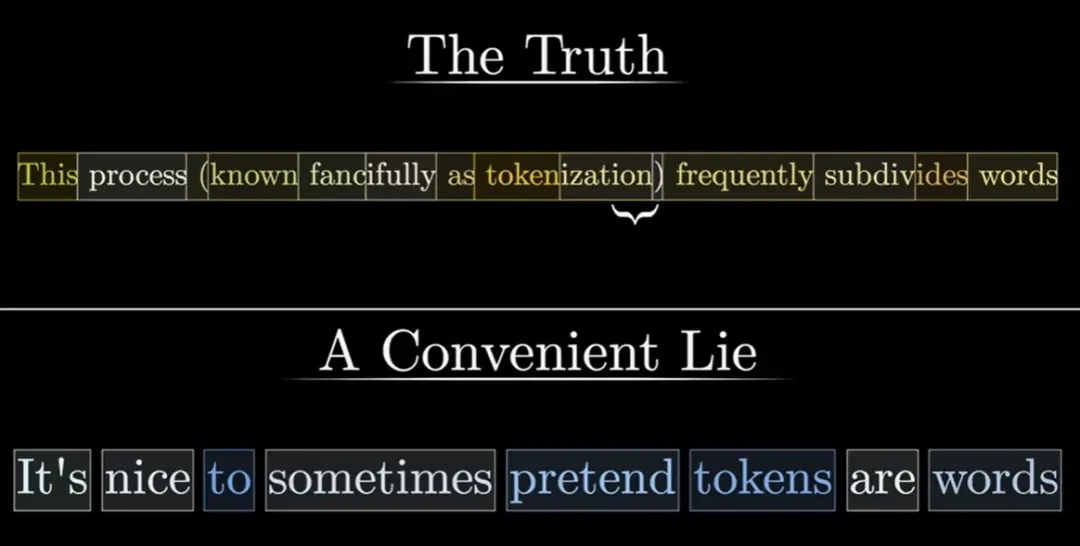
理解了上述基础之后,让我们深度探讨文本处理的第一步,将输入分割成小片段,将这些小片段转换成向量,我之前说过,这些小片段被称为token,它们可能是单词的一部分或者标点符号。
为了简化理解,假设它们按单词进行划分,因为人类就是按照单词进行思考。
通过一个小例子来解释每一步就能使这个过程更容易理解了。
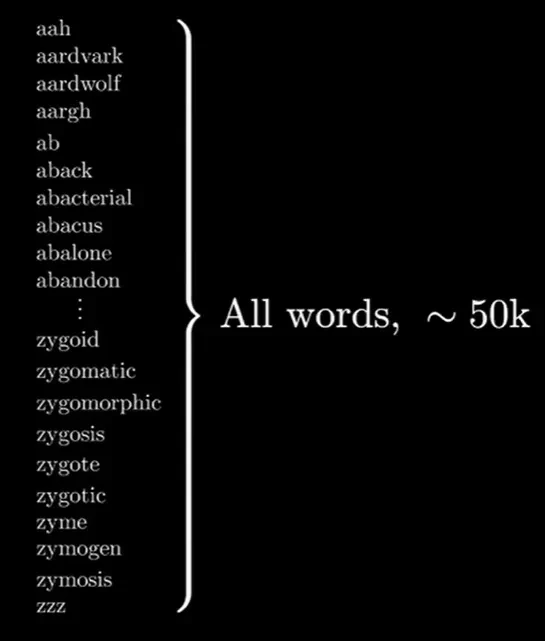
模型具有一个预设的词汇库,包含所有可能的单词,比如说有50000个。
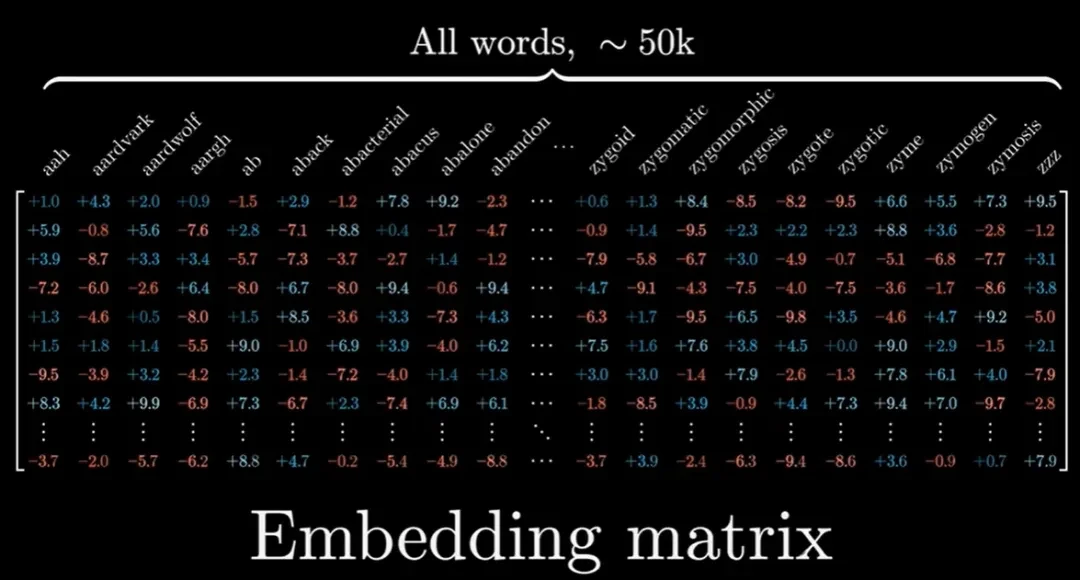
我们将首先遇到一个矩阵,叫做嵌入矩阵,它为每个单词都分配了一个独立的列,这些列决定了每个token会被转换成什么向量,跟其它矩阵命名规则一样,我们称这个矩阵为We。
它的初始值是随机的,然后在训练过程中基于训练数据进行调整。
在transformers之前,就已经有了这种单词转向量的方法,虽然对于初次接触的人来说可能觉得很奇怪,但它为接下来的一切建立了基础,因此,我们要花些时间来熟悉它。
我们通常称这种转换为词嵌入,这种表述可以让你从几何的角度理解这些向量,把它们想象成高维空间中的点。
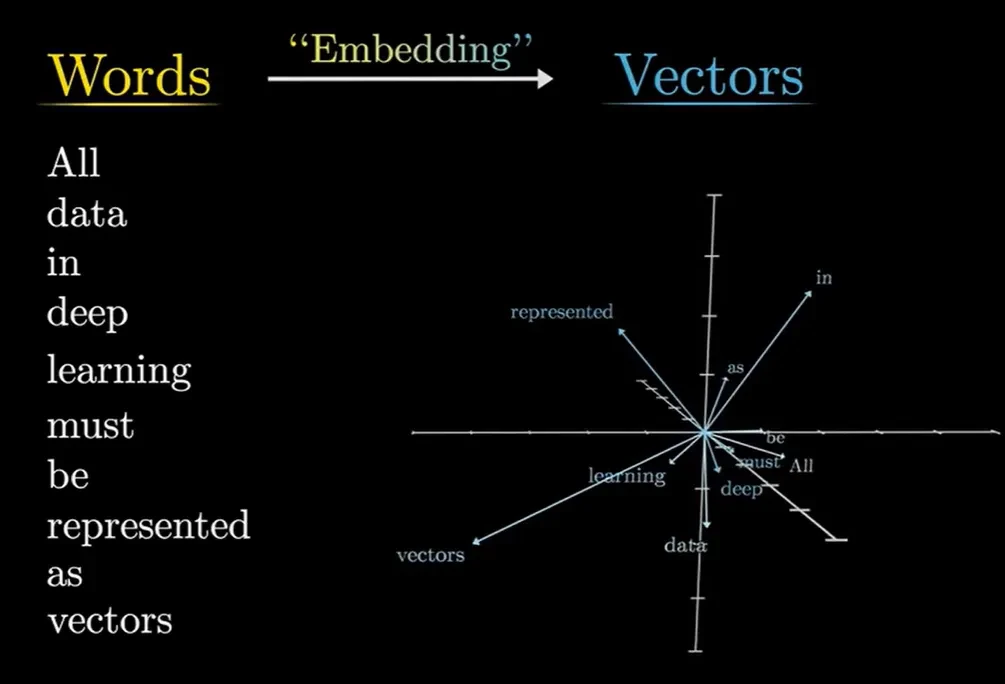
将三个数字看作三维空间中的坐标点很简单,但词嵌入的维度远超过这个范畴,GPT3的词嵌入维度为12288。
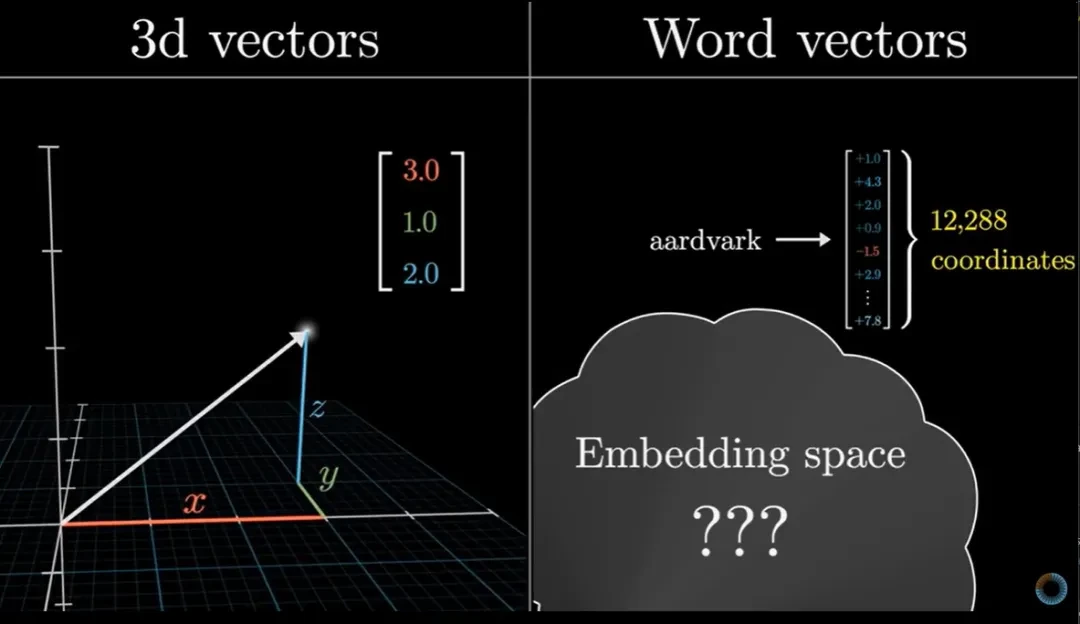
如你所见,就像你可以在3维空间选择一个2维切片,然后将所有点投影到这个切片上,为了动态展示词嵌入向量,我采用了相同的方法,从高维空间选择一个三维切片,然后将高维向量投影到这个三维空间进行展示。
这里的关键思想是,模型在训练过程中微调权重,以确定词如何被嵌入为向量,它会倾向于找到一组嵌入,使得这个空间中的方向含有特定语义含义。
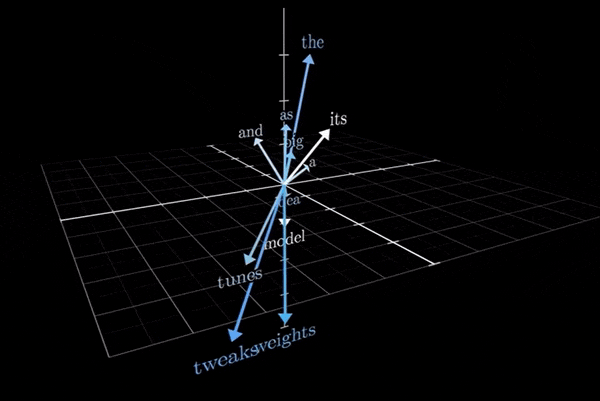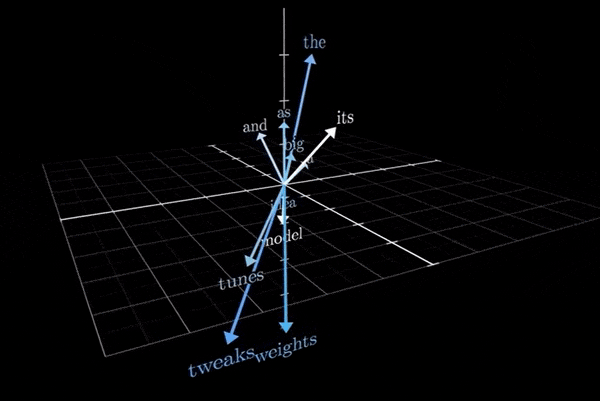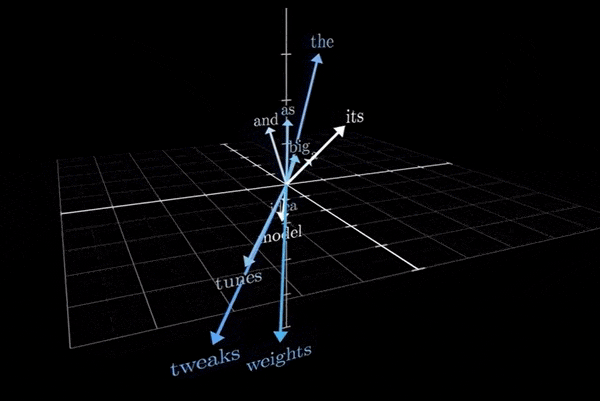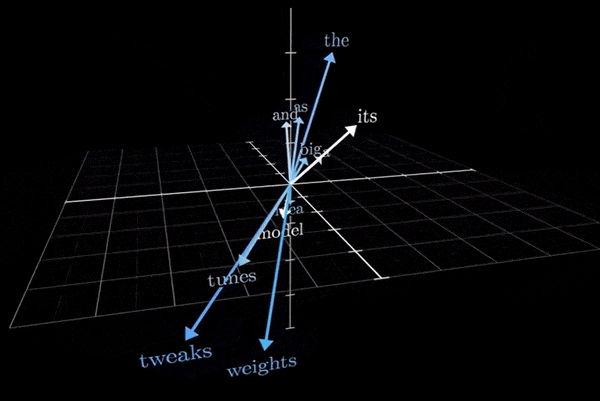
对于目前我运行的这个简单模型来说,通过搜索,找到所有与tower相近似的词向量,你会发现这些词都有着近似的tower属性。
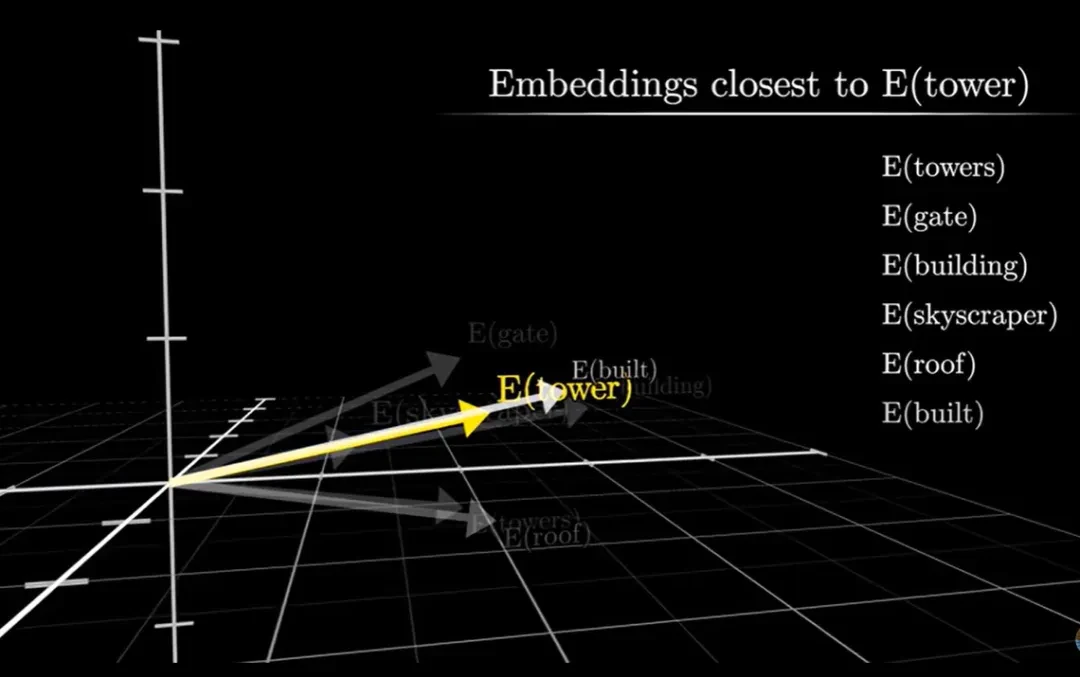
这足以说明一个观点,空间中的方向能够表达语义信息。
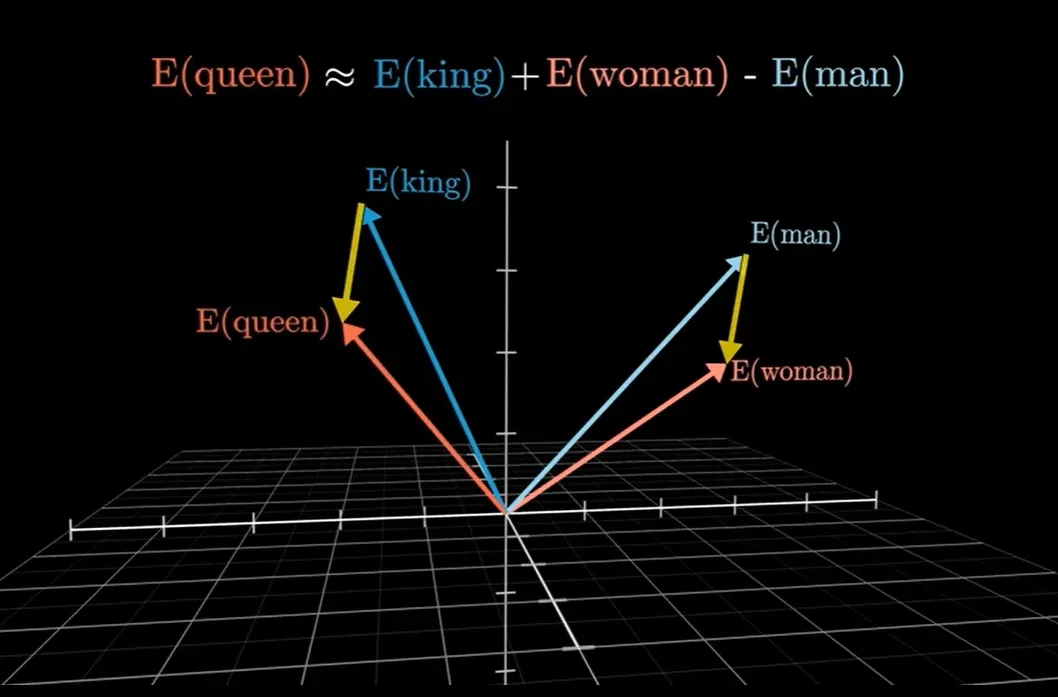
一个经典的例子是,计算woman和man向量之间的差值,它们的差也可以被可视化为一个向量,向量起点和终点分别是这两个词的顶点,这个差异和queen和king的差异很接近。
所以,假设你不知道表示woman queen的向量,你可以通过把king的向量加上这个差异向量,并搜索最接近这个点的向量找到它。
另一个例子是,如果你从意大利的向量表示中减去德国的向量表示,再加上希特勒的向量表示,结果非常接近墨索里尼的向量表示。
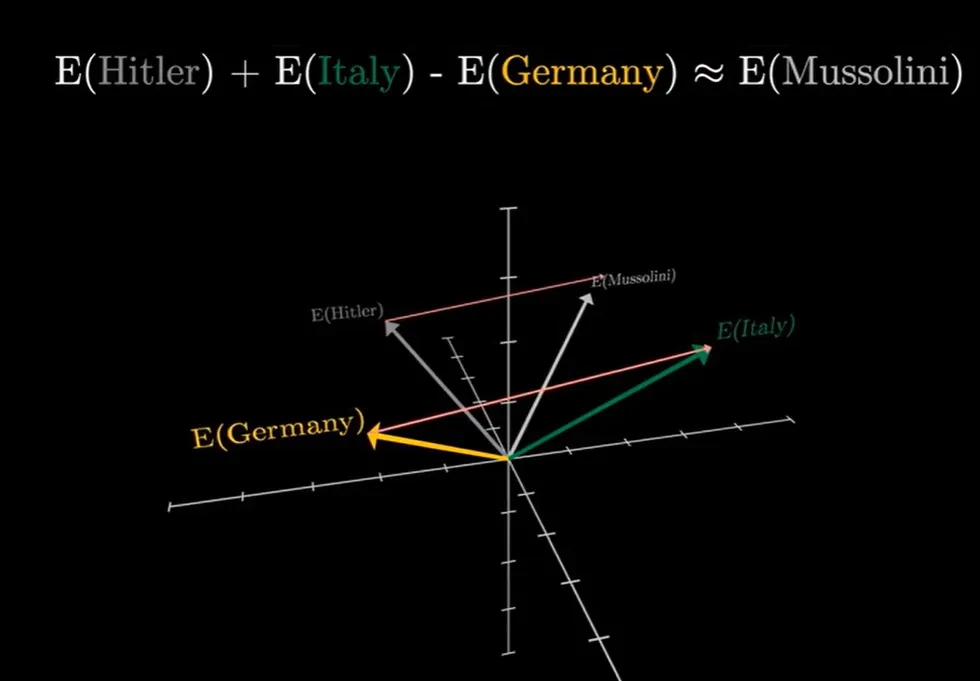
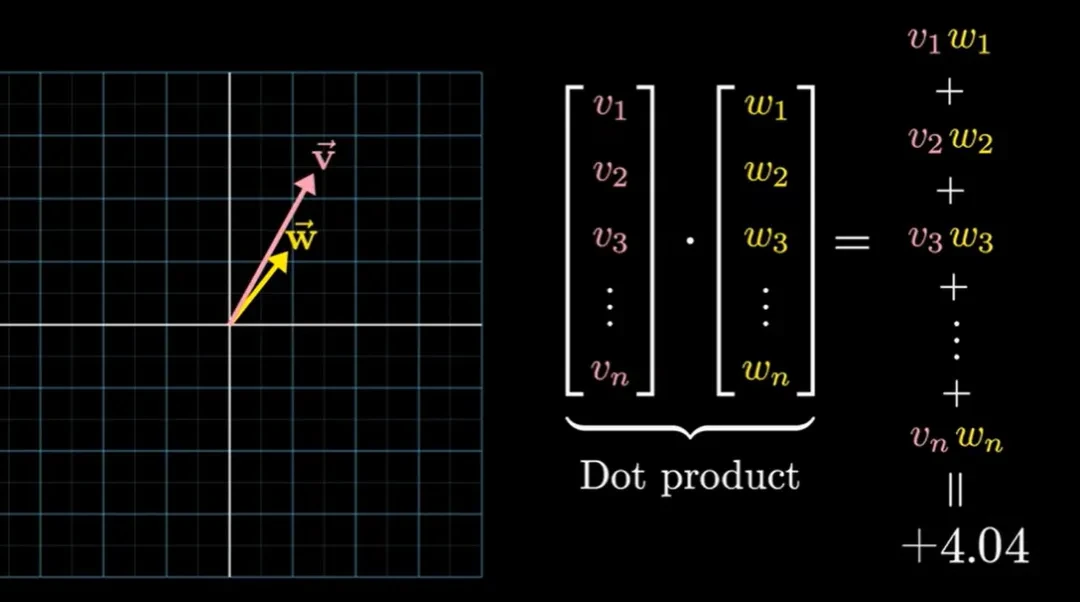
对于向量,有一个有用的数学概念,尤其对接下来的章节非常重要,那就是两个向量的点积点积可以视为一种衡量它们是否对齐的方法。
从计算的角度看,点积涉及逐一对应元素相乘,然后进行求和,这很好,因为我们的很多计算看起来就像是权重求和。
从几何角度看,如果两个向量指向相似方向,点积为正。如果相互垂直,点积为0,如果指向相反方向,点积为负数。
再次声明,单词的嵌入方式是通过数据学习得到的。
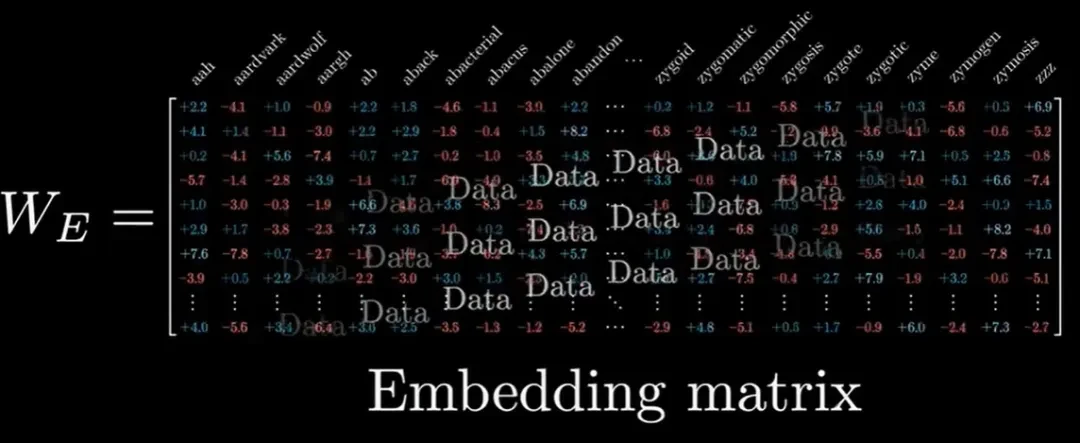
这个词嵌入矩阵表明了词汇的转换过程。
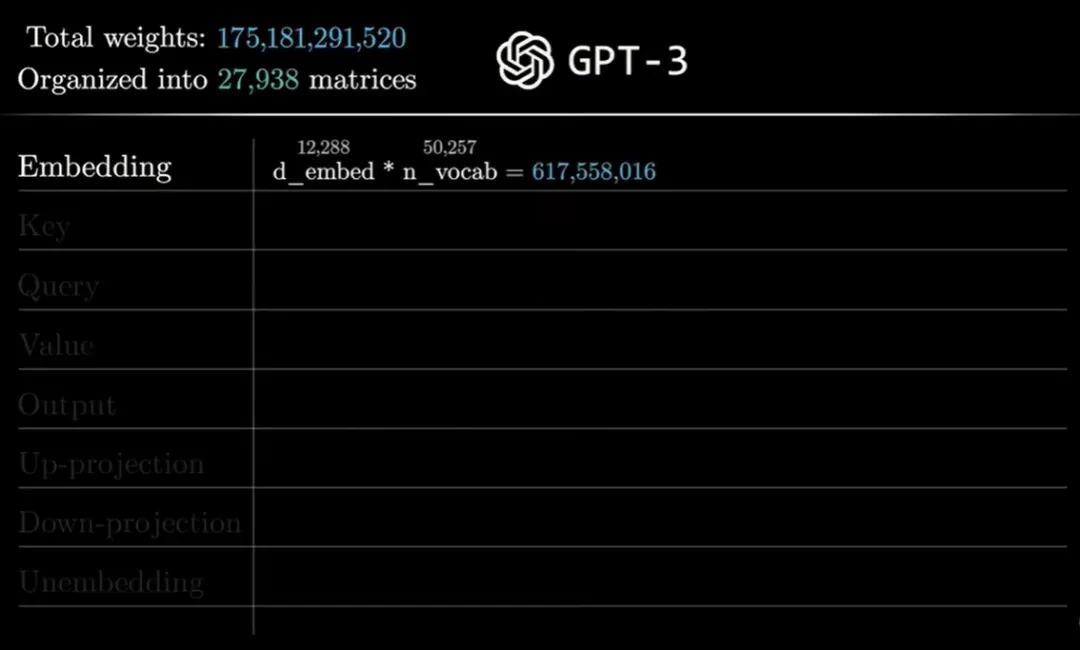
它也是模型的第一批权重,根据GPT3的数据,词汇量是50257,但要注意,实际上它指的不是单词本身,而是tokens,嵌入的维度是12288,将两者相乘,将得到6.17亿个权重。
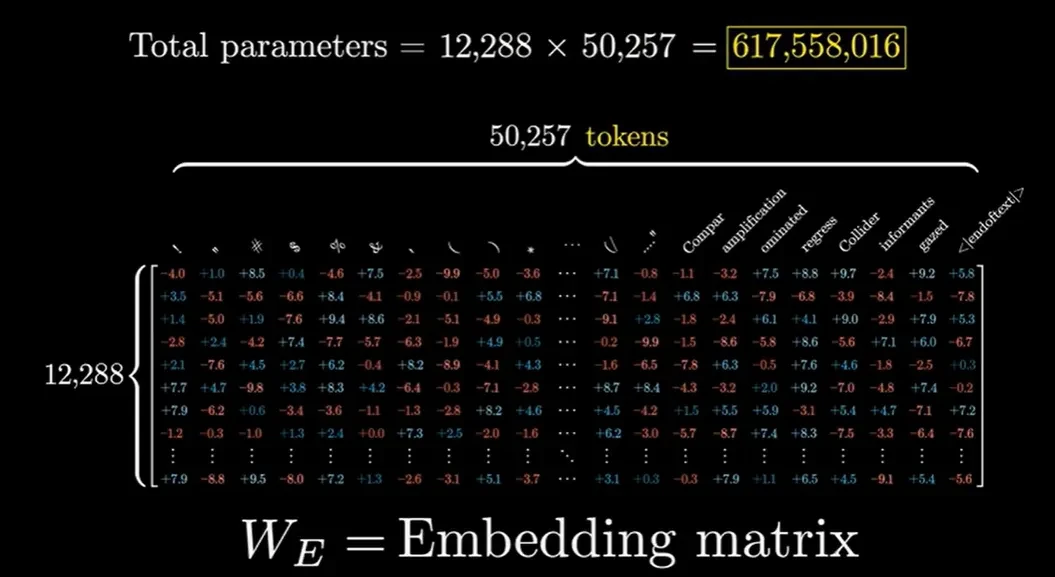
将这个数字加入到累计计数中,文章最后我们应该得到1750亿个权重。
其实,这些嵌入空间中的向量,还携带了词汇位置信息,这里就不重点说明了。
最关键的是,这些向量能够吸纳并反映语义信息。
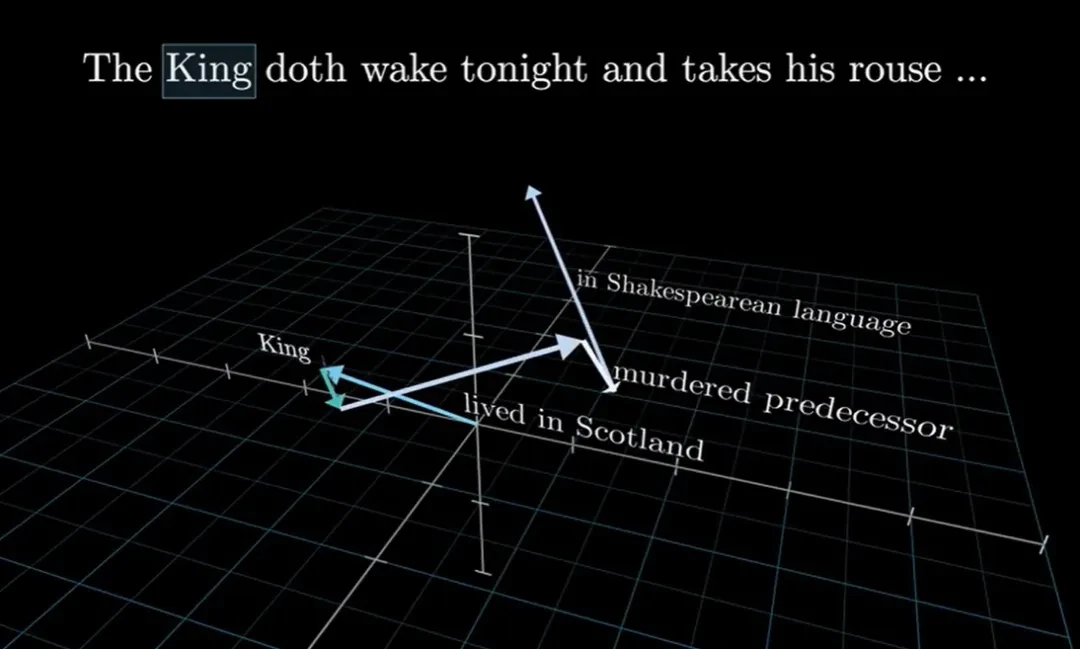
举个例子,如下图,一个最初代表国王的向量,经历多个transforner块后,在注意力和MLP的作用下,可能会逐渐变化,因此到最后,它指的方向会更具体更微妙。
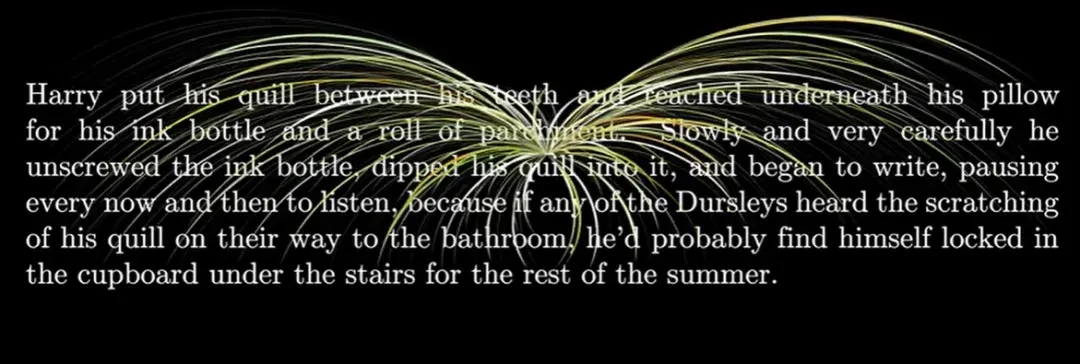
想想你对某个词汇的理解通常是怎么形成的,那个词的意义很大程度上是由其所处的环境决定的,有时甚至包含很远的上下文。
因此,在构建一个能预测下一个单词的模型时,关键目标就是让它能够高效地融合上下文信息。
明确一点,在第一步,当我们根据输入文本创建向量数组时,每个向量都是直接从嵌入矩阵选取的。
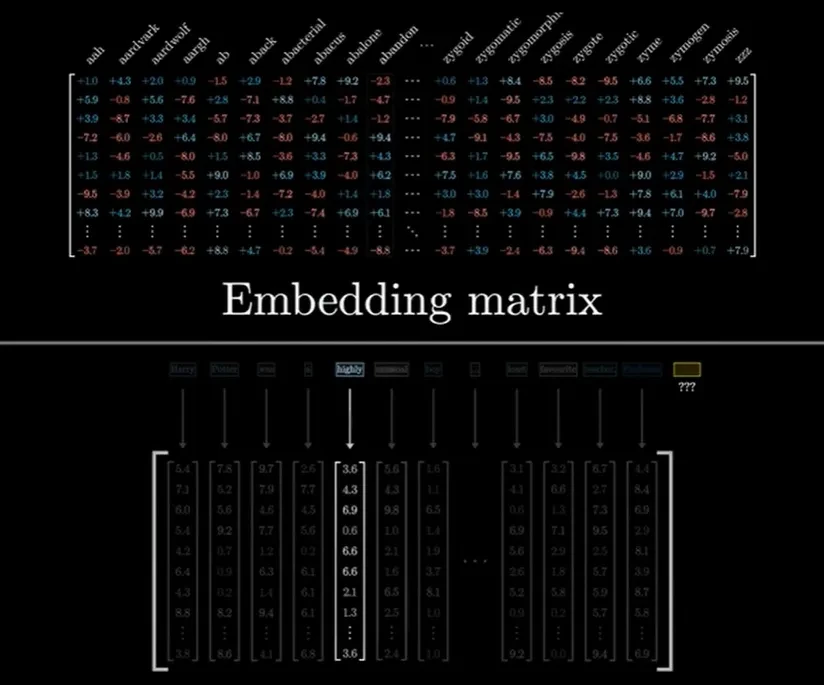
这意味着,起初,每个向量仅能代表一个单词的含义,而不涉及周边环境的信息。
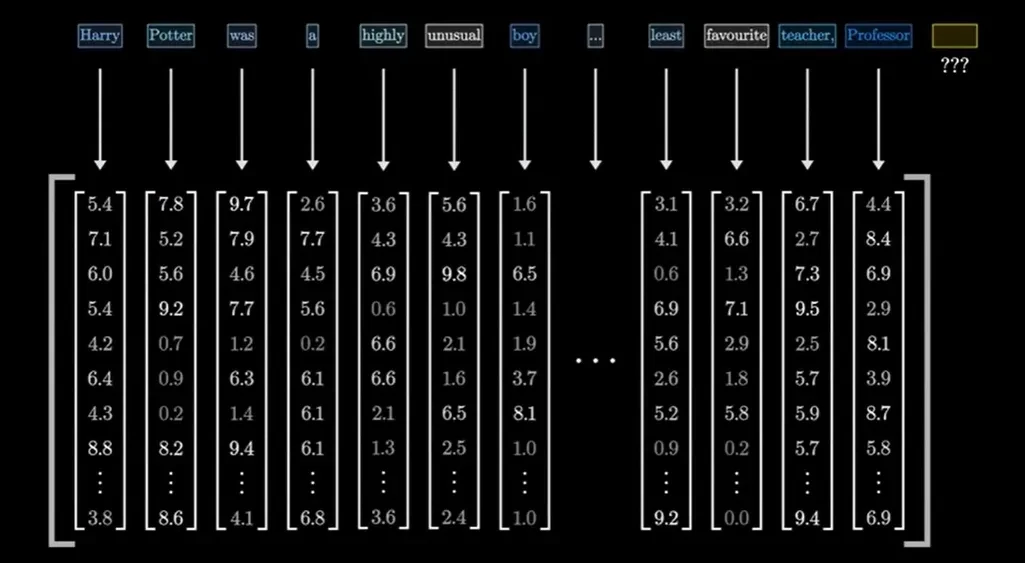
但我们的目标就是让这些向量通过网络的传递,使得每一个向量都能获取比单个词更丰富更具体的含义。
而能融合上下文信息的就是注意力机制。
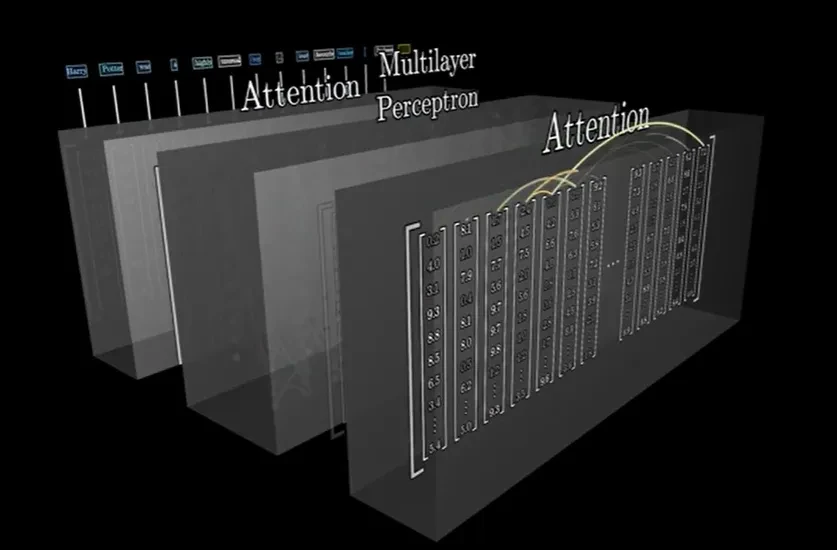
但网络每次能处理的token数量是有限的,这就是所谓的上下文大小,GPT3的上下文大小是2048。
意味着数据在网络流动时,总是看起来像一串2048列的数组,每一列都有12288个维度。
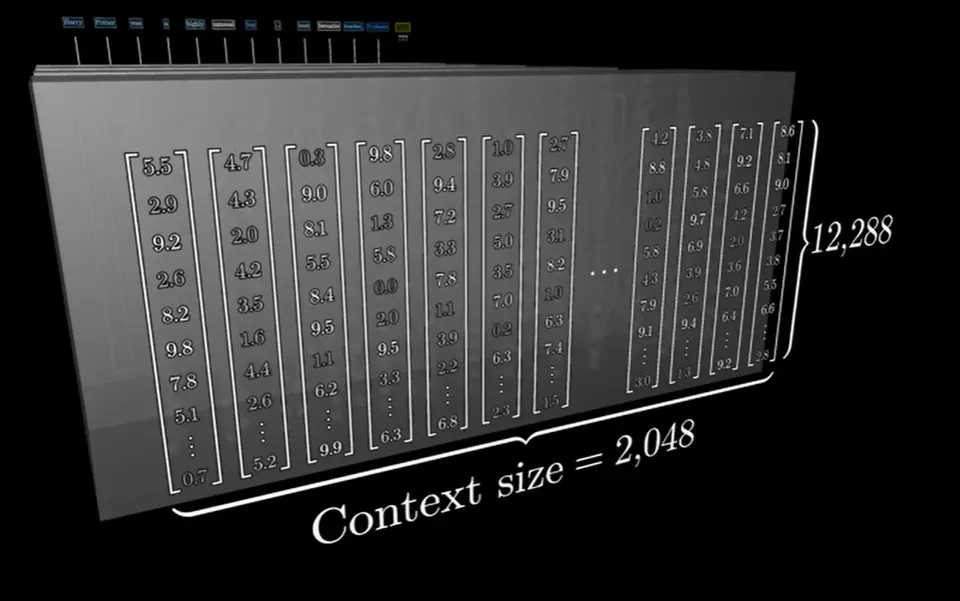
这个上下文大小限制了transformer在预测下一个词时可以纳入的文本量。
这就解释了,为什么如果和一些聊天机器人,比如,早期的ChatGPT版本,进行长对话时,你可能会觉得机器人在对话中迷失了方向,尤其是对话持续过长时。
/ 05 /
Transformer四大件之二:Attention
我们将在下一篇文章详细讨论注意力机制的细节。
/ 06 /
Transformer四大件之三:前馈神经网络
我们将在下下一篇文章详细讨论注意力机制的细节。
/ 07 /
Transformer四大件之四:UnEmbedding
终于到了模型的最终阶段处理过程。
请记住,最终的目标是产生一个概率分布,预测下一个可能出现的token。
举个例子,如果最后一个词是Professor,上下文中包含了Harry Potter等词语,紧接着出现的是least favorite teacher,那么,一个经过良好训练,并对哈利波特世界有所了解的模型,可能会给斯内普这个词一个较高的权重。
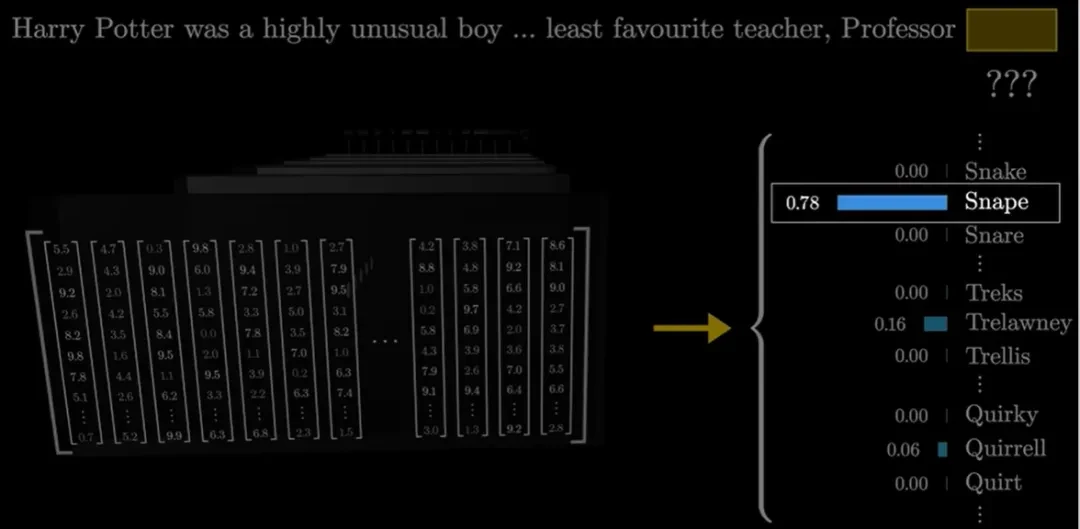
此过程涉及两个不同步骤。
首先,使用另一个矩阵,将上下文中的最后一个向量映射到一个包含50000个值的列表,词表中的每个token都对应一个值。
接着,通过一个函数把这些值转换成概率分布,这个函数叫softmax,我们将稍后讨论.
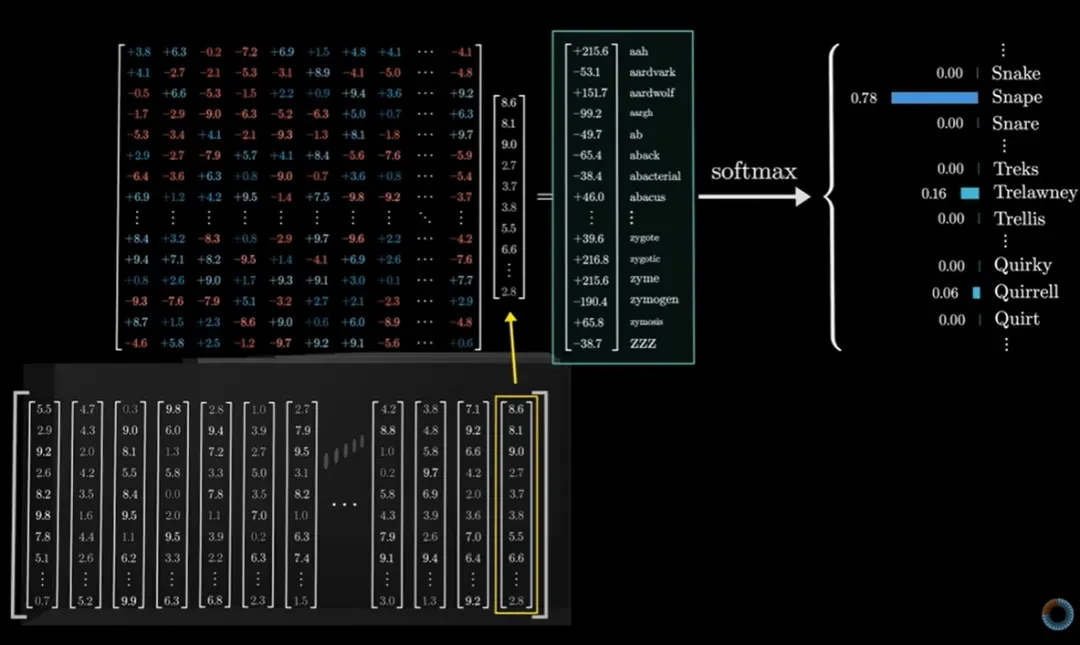
但在此之前,你可能会觉得,仅仅基于最后一个嵌入做决策似乎有些奇怪,毕竟在最后一层中,还有其它向量。
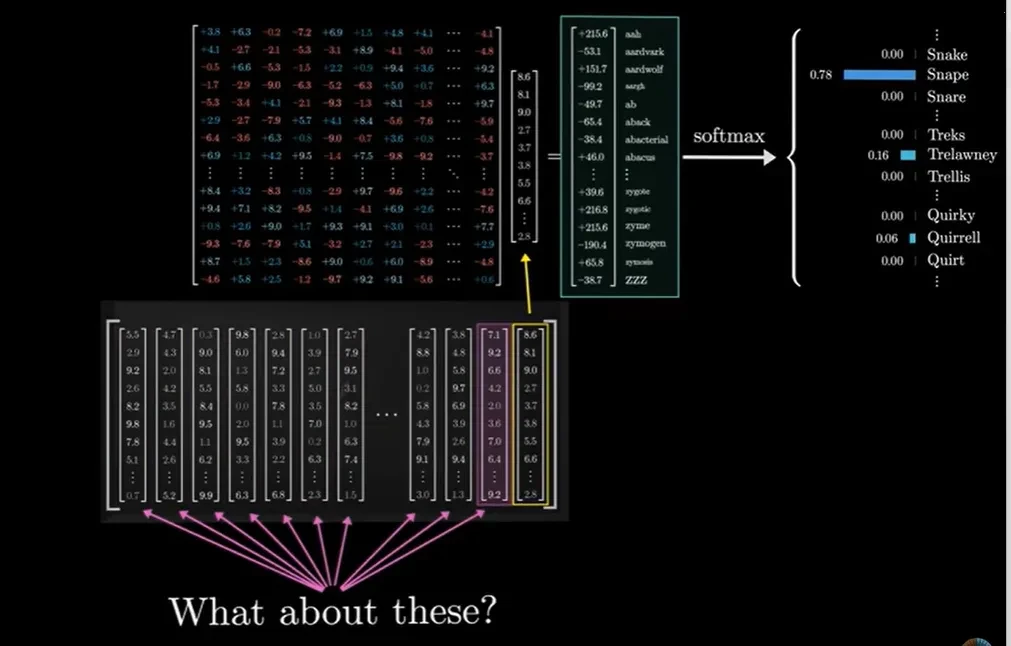
是的,在训练过程中,最后一层的每一个向量来同时预测其后可能出现的内容,被证明是更高效的方法。
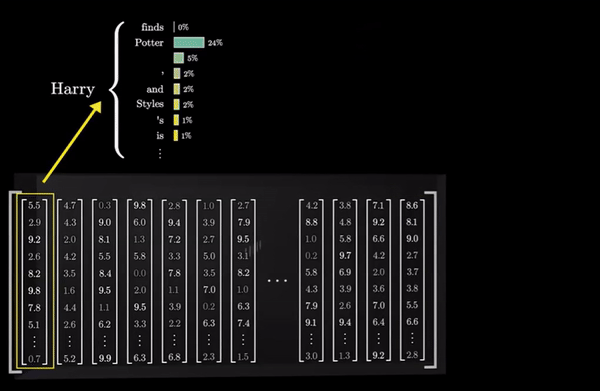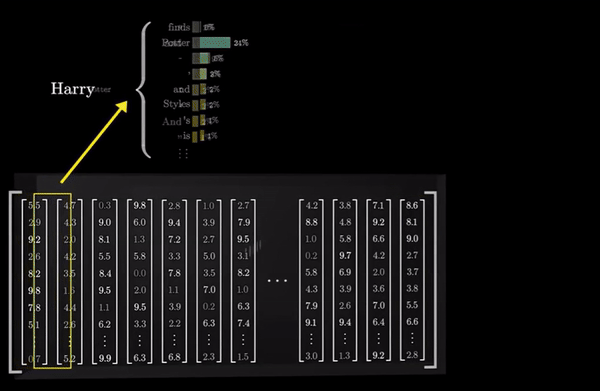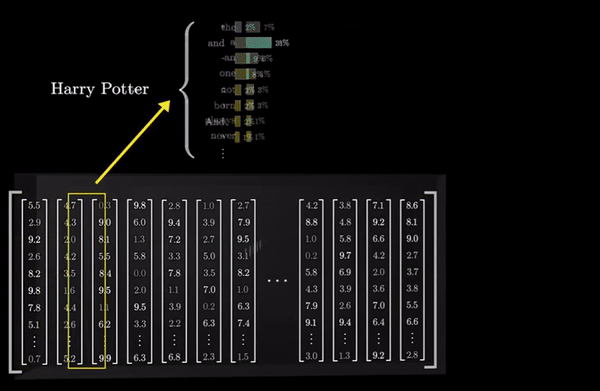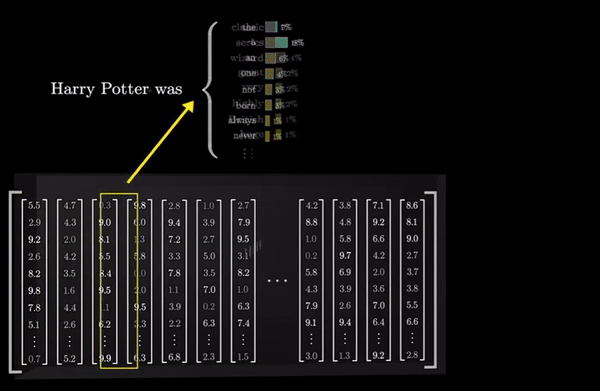
但推理时,却只能一个词一个词地预测。
这个矩阵被称为unembedding矩阵,我们用Wu来表示。
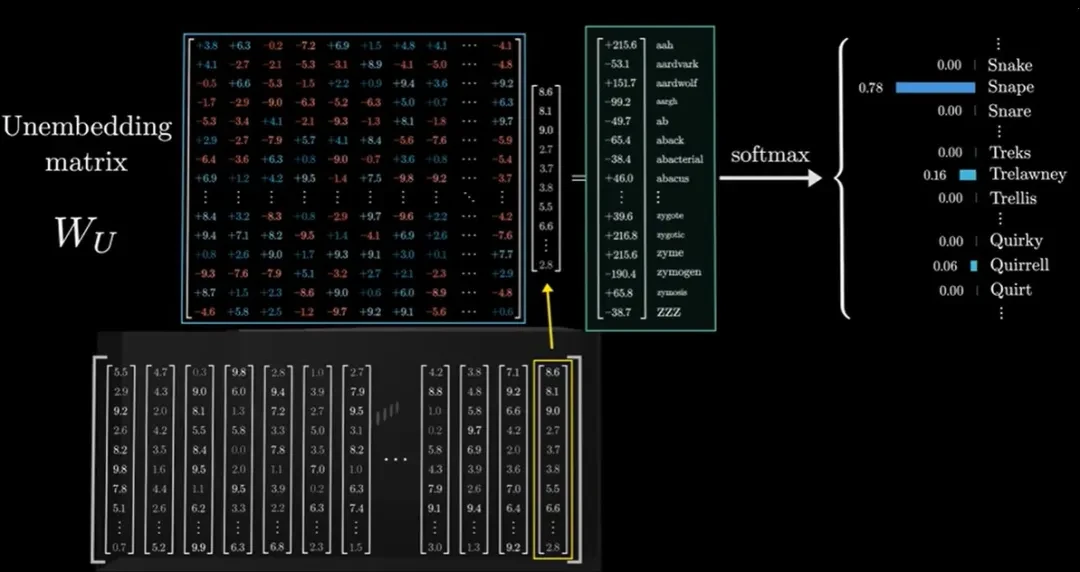
就像我们见过的所有权重矩阵一样,这个矩阵的初始值也是随机的,但在训练过程中这些值会被更新。
关于参数总数的统计,这个unembedding矩阵为词汇表中的每个词都分配了一行,每一行的维度与嵌入维度一样,12288。
这与嵌入矩阵相似,只不过是其逆过程,如果我们称enbedding是编码,那么unembedding就是解码。
最终,它为网络增加了另外7.17亿参数。
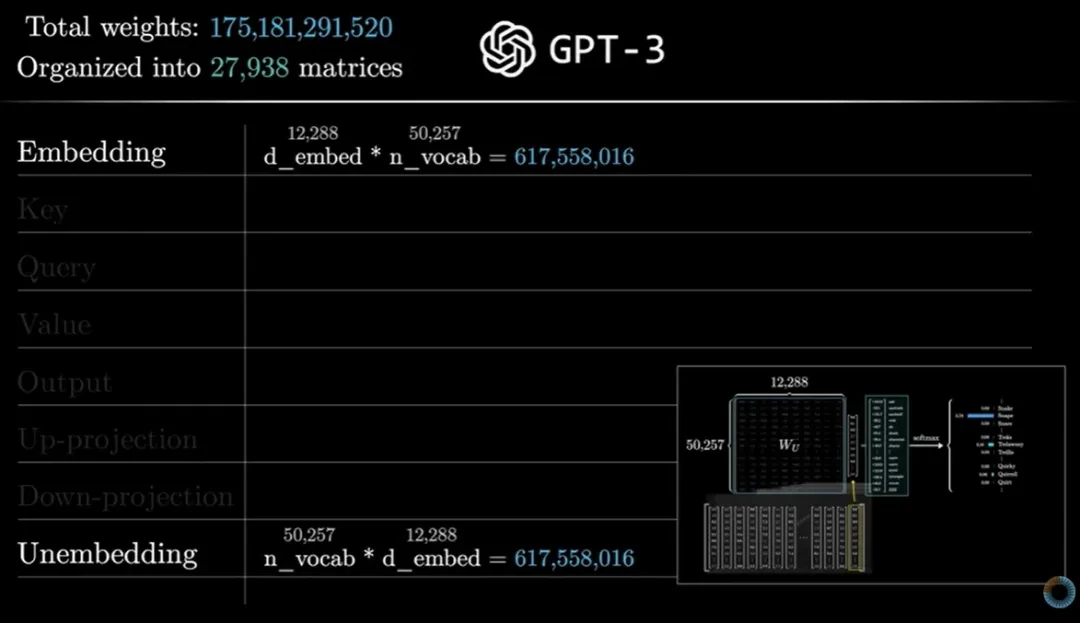
到目前为止,参数总数已经超过10亿,虽然是总参数量的一小部分,但却很重要。
在这章的最后一部分,我想介绍一下softmax,因为它在注意力机制中会再次成为焦点。
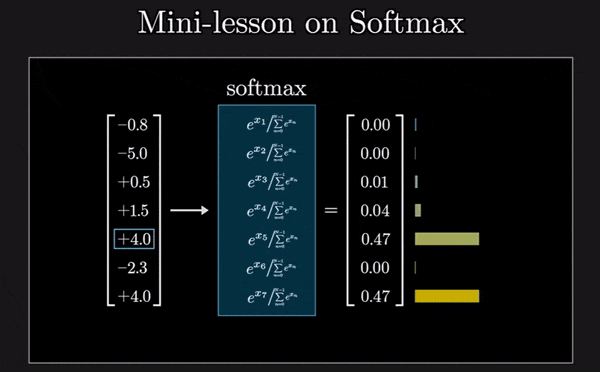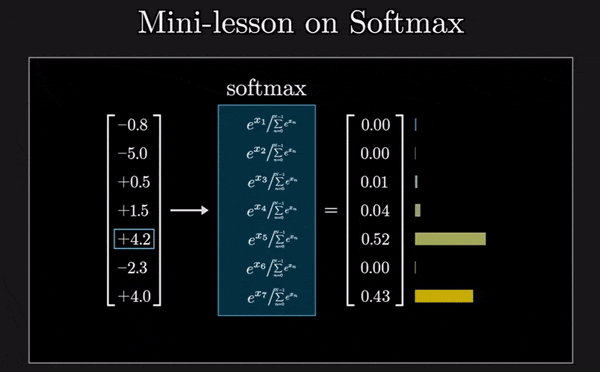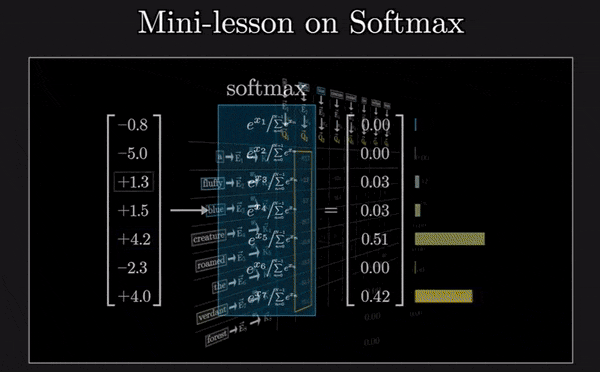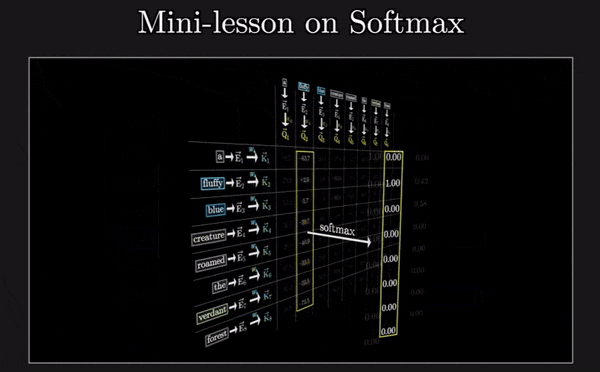
如果你想让一串数字成为概率分布,例如,预测下一个可能出现的词的概率,这些数字需要在0-1之间,且总和为1。
但是,如果你正在探索深度学习,你所看到的每一步操作可能看起来都是矩阵与向量的乘法,那么你得到的结果可能并不符合这个条件。
这些值可能是负数,也可能大于1。
而且加起来几乎可以确定不为1。
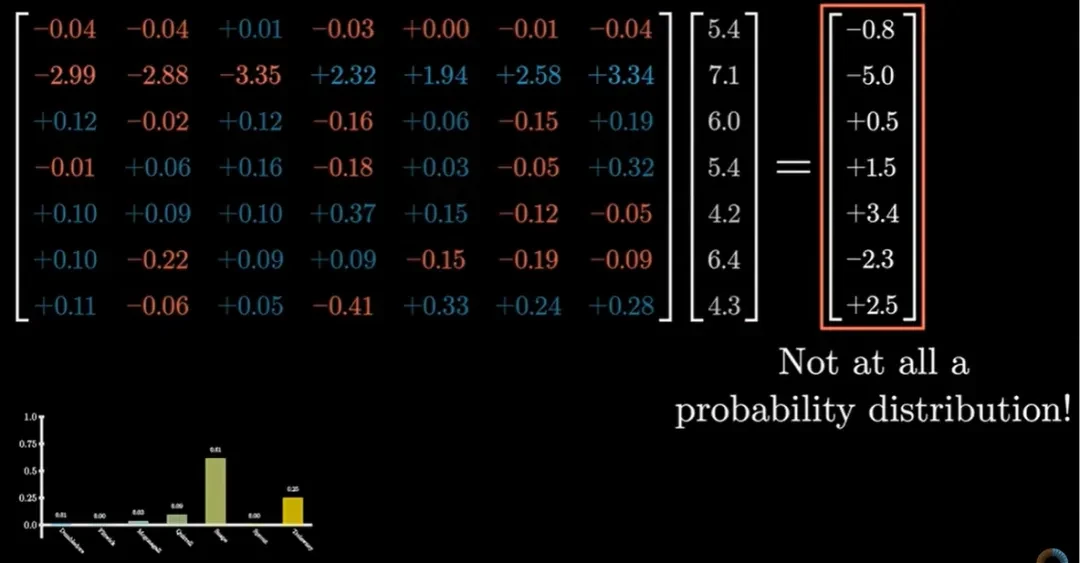
softmax就是一种标准方法可以把任意一组数字转换为一个概率分布,使得最大的值可能接近1,最小的值接近0。
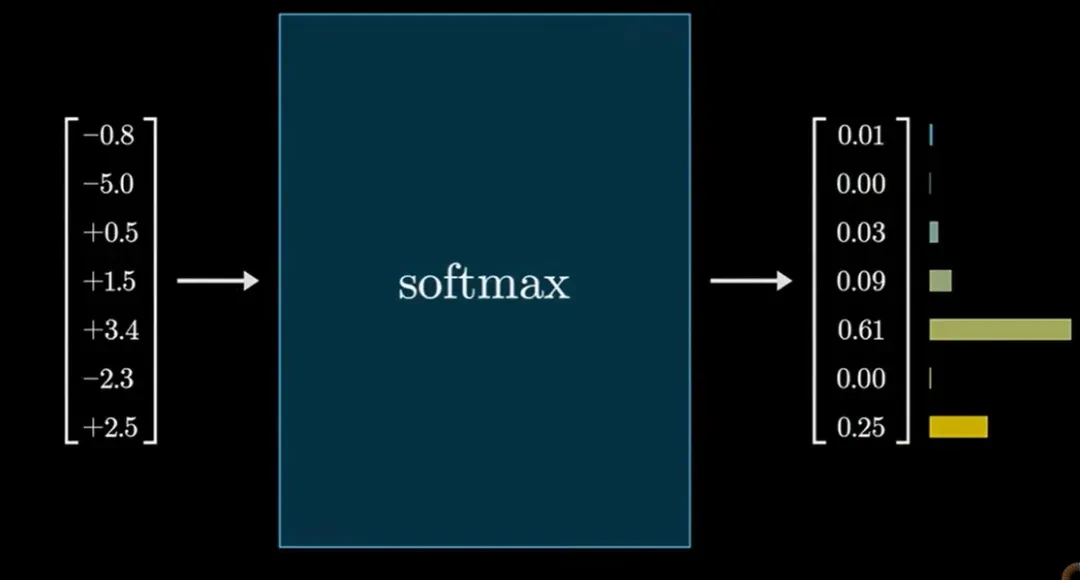
Softmax的具体工作原理是:首先对每个数字进行e的指数运算,这样就得到了一组正数,然后取所有正数的和,然后每个数字除以总和,这样就能把它们标准化为一个和为1的概率列表。
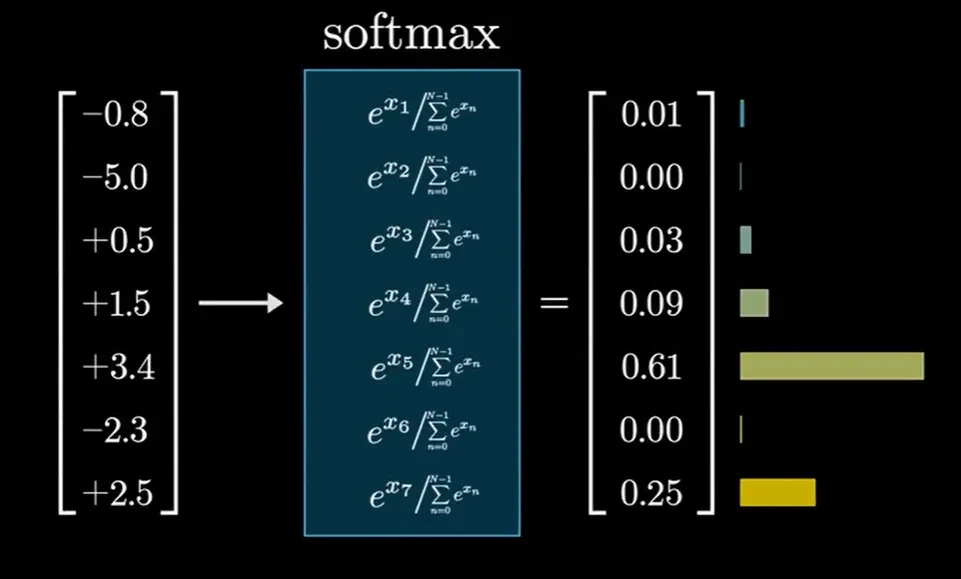
你会注意到,如果输入中的某个数值明显大于其它数值,那么在输出中这个值对应的项在概率分布中起主导作用,几乎可以确定,你在采样时会选取这个最大的输入值。
但通常会选择比直接选取最大值更细腻的方法,因为当其它值也接近最大值时,它们在分布中也能获取重要的比重,而且随着你不断地改变输入,一切都会连续地变化。
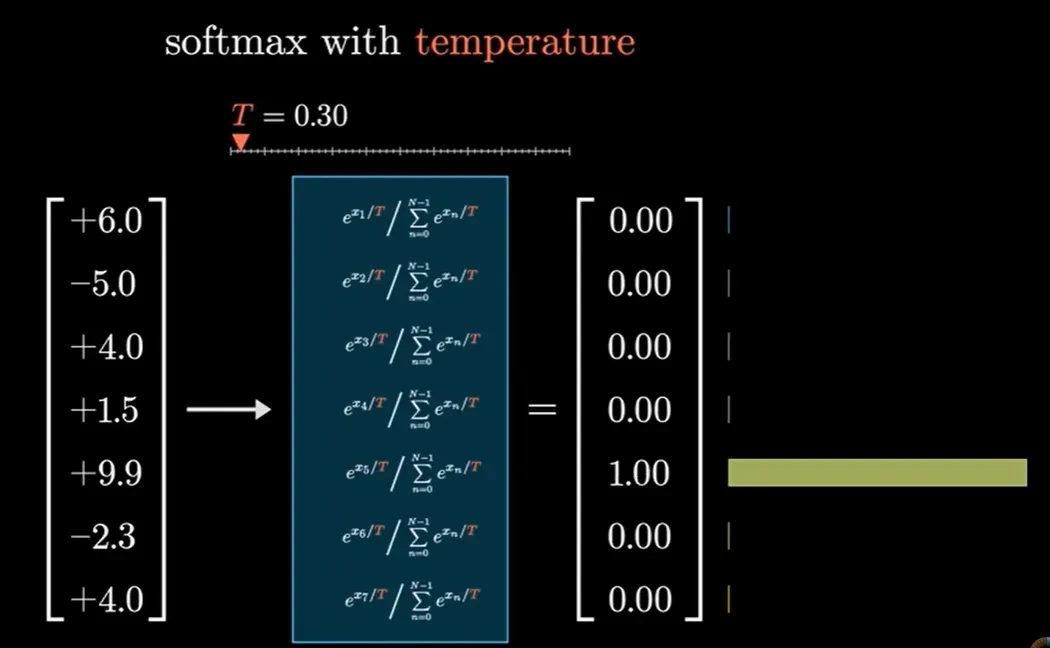
在一些情况下,比如,像ChatGPT利用这个分布选择下一个词时,可能会为这个函数增加一些额外的趣味,可以通过在指数的分母里添加一个常量t来实现。
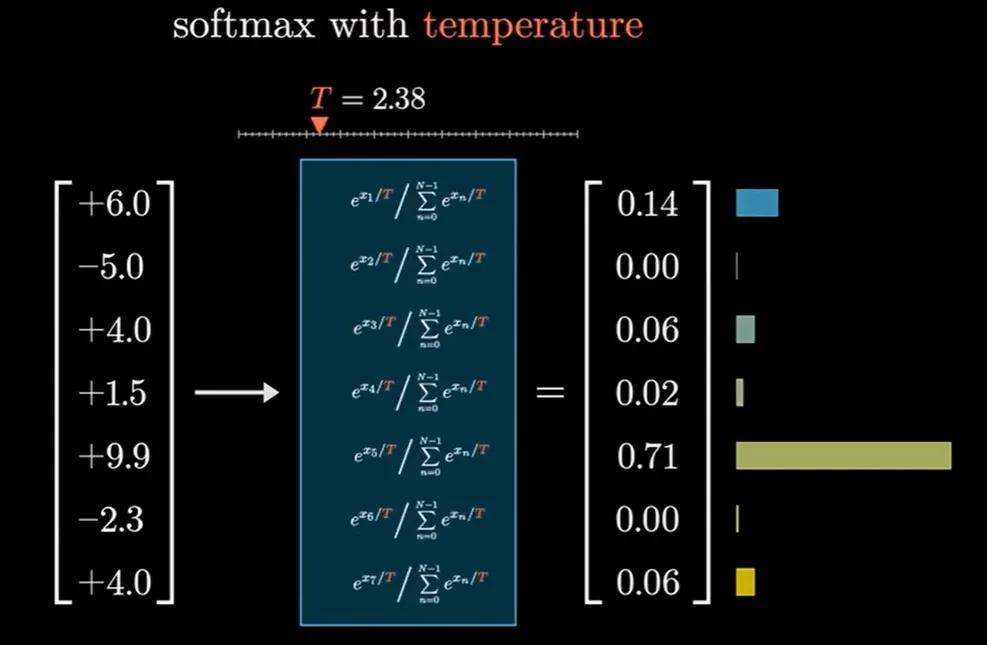
我们称之为温度,因为在某种程度上,与热力学方程中的温度作用相似。
它的效果是,当t较大时,会使较小的数值获得更多的权重,使得分布稍微均匀一些。
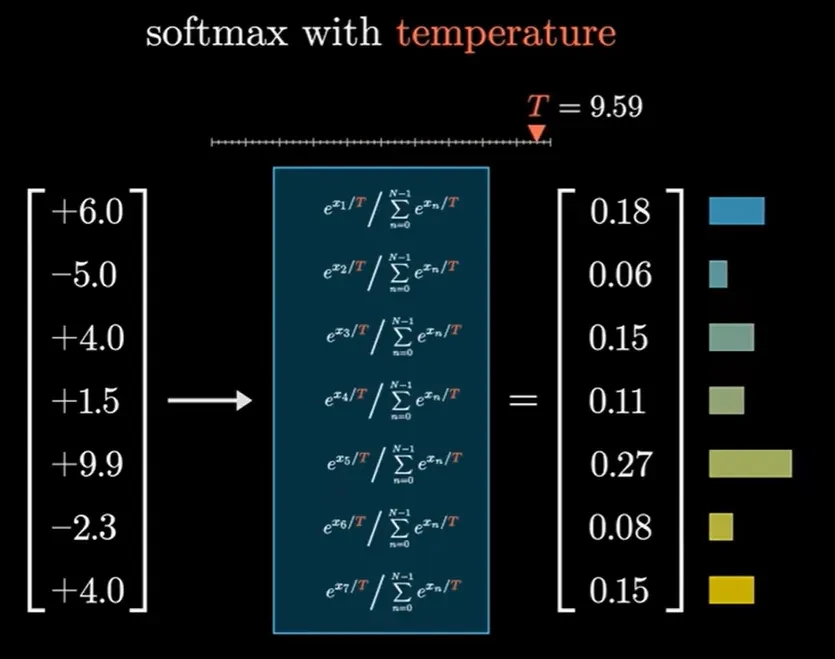
而t很小时,较大的值会占据主导地位,极端情况下,如果把t设置为0,所有权重都会集中到最大值上.
例如,用GPT-3生成一个故事,我会在每次测试中使用不同的温度,温度为0,意味着他总是选择最可能的词,而你所得到的结果就变成了一个陈词滥调的金发姑娘的故事。
较高的温度给它提供了选择不太可能出现的词的机会,但这也伴随着风险,在这个例子中,故事开始较为原创,讲述的是一位韩国年轻艺术家,但很快就变得毫无意义。
严格地说,API并不允许你选择大于2的温度,这个限制并没有数学上的根据,只是一个经验值,目的是防止产生过于荒诞的结果。
