
您的电脑中需要以下内容:GPT-sovits整合包,AU,UVR5及其模型,格式工厂,阿里云盘。
如果您已经获取了您想要的模型,请看本文后半截的“本地推理教程”即可。本文全篇3000字左右,希望可以帮到你。
云端训练教程:
1.准备数据集:
(1).从视频中提取音频
a.下载相应的视频素材
b.打开AU,新建多轨会话,将视频素材导入(文件)后再导出为WAV音频文件。(如果某段混响或背景音乐太大,请删除(按住ctrl加K切割,用鼠标选中不要的音频段按del键即可)
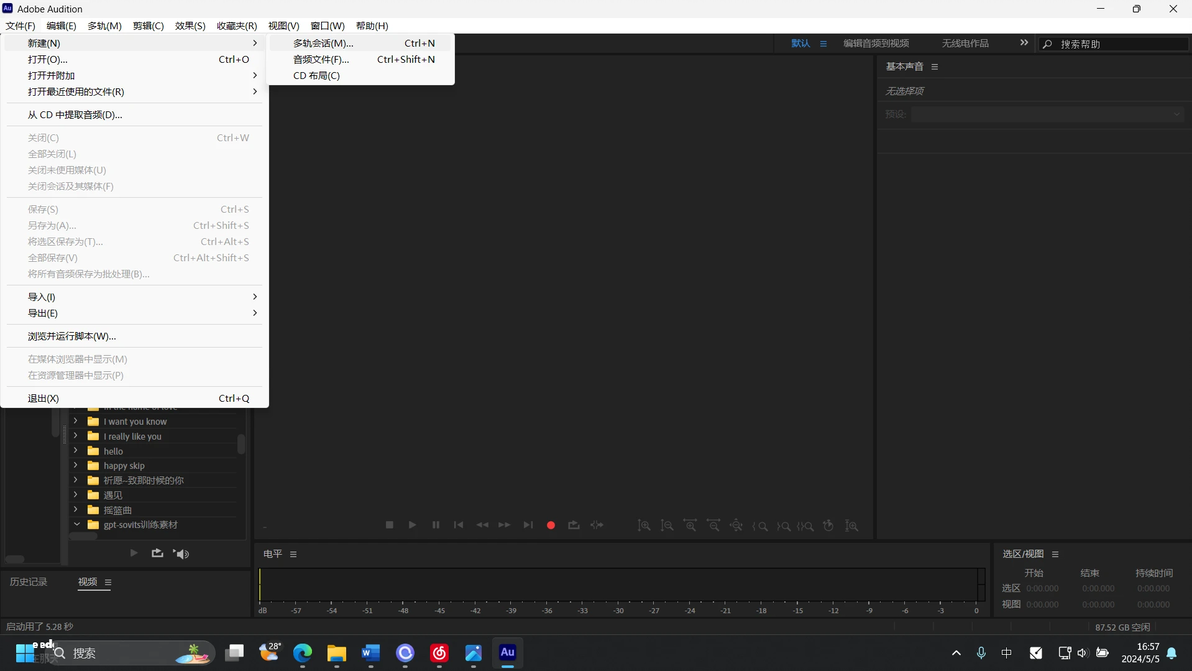
新建多轨会话
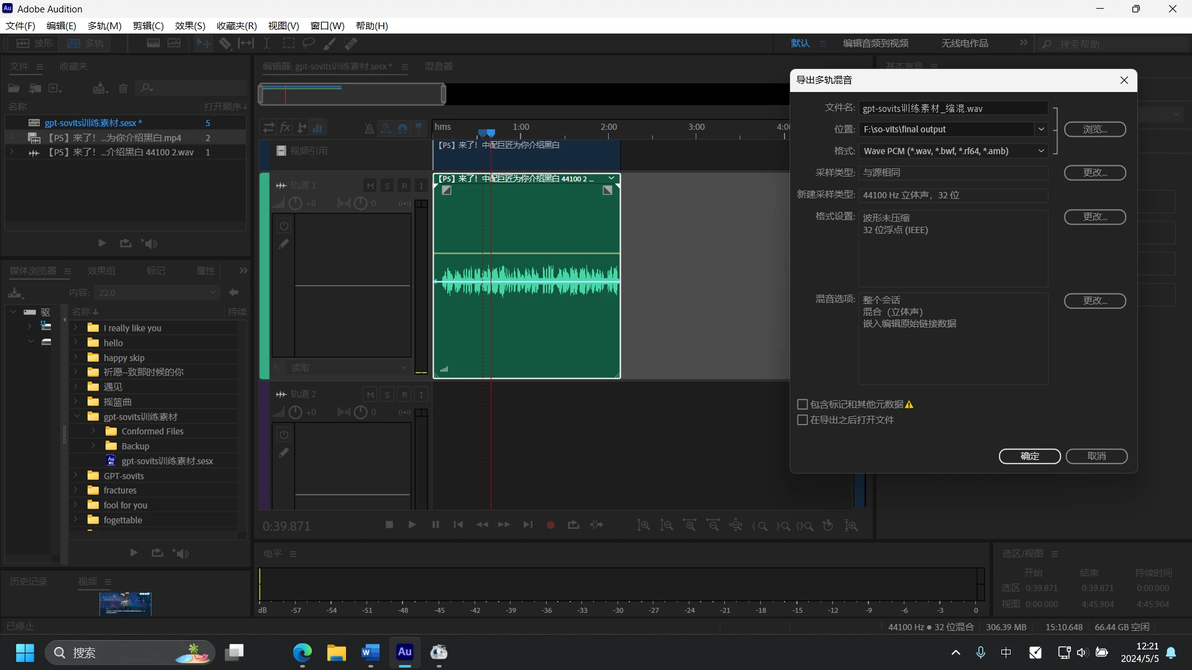
导出为WAV文件
c.使用UVR5提取出干声(UVR5教程请参见其他视频,如果您下载的视频仅含干声,如xxx角色语音鉴赏,请跳过这一步)
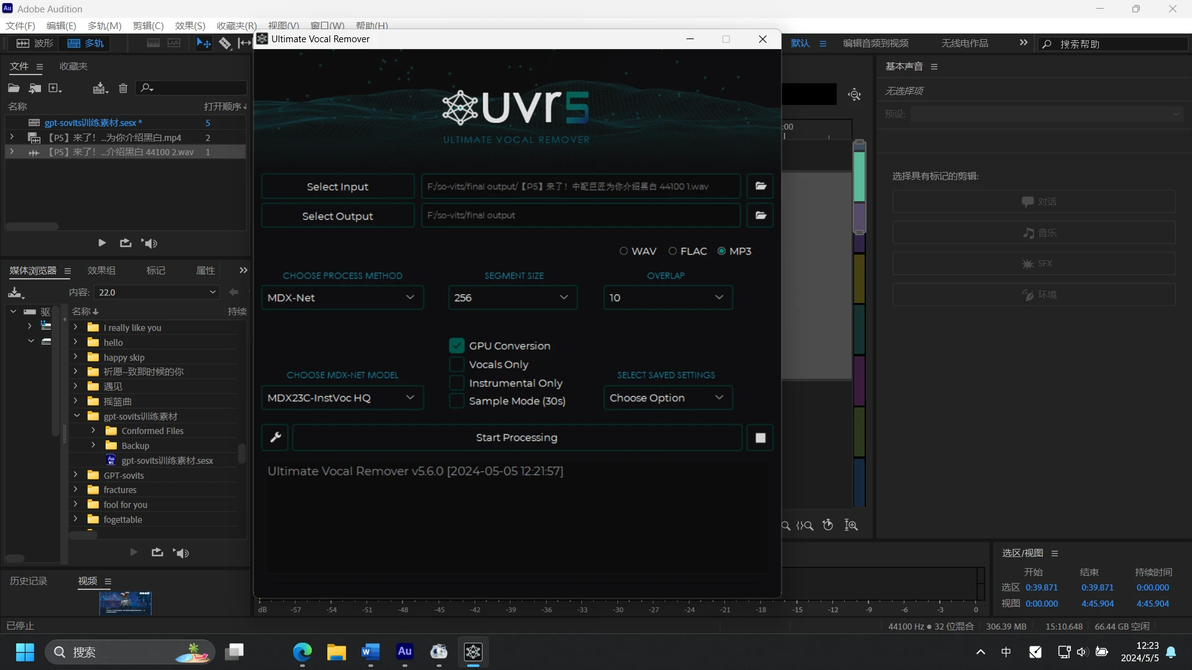
UVR5去背景音乐和混响
d. 由于响度太大或太小都会降低模型质量,所以我们应进行响度匹配。打开AU,将提取出的干声导入后,左键单击音频轨,右侧栏中分配音频类型为“会话”,点击“响度”,点击“自动匹配”再导出为WAV音频文件。
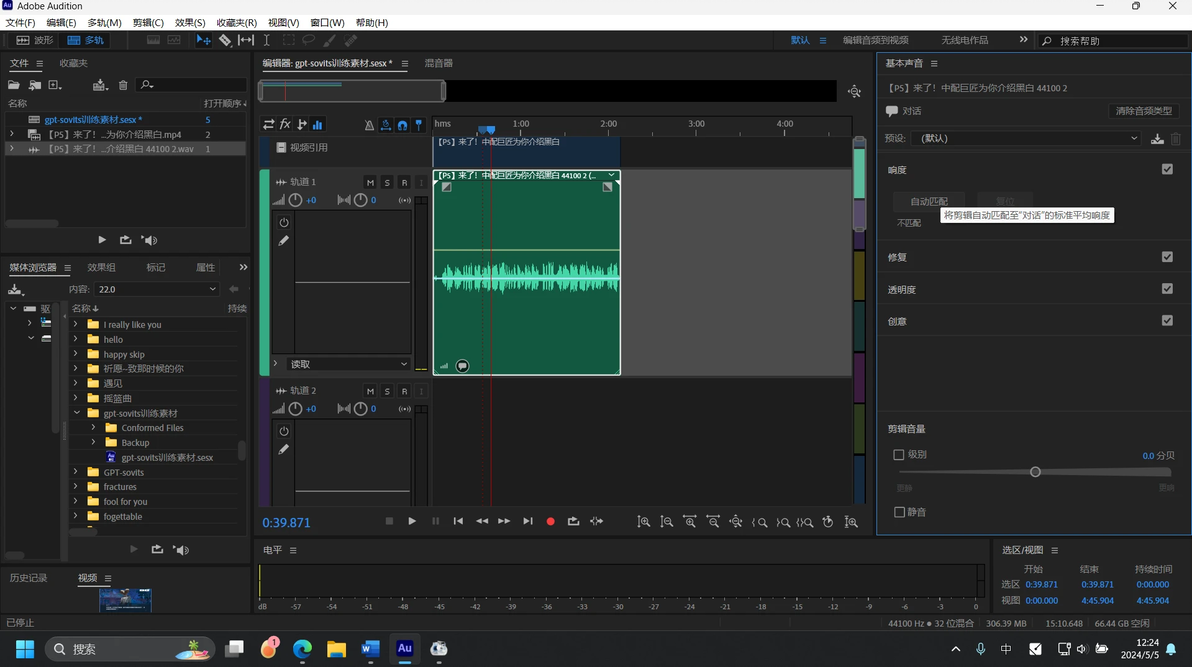
匹配响度
e.打开浏览器
f.打开整合包根目录,双击”go-webui.bat”并等待启动
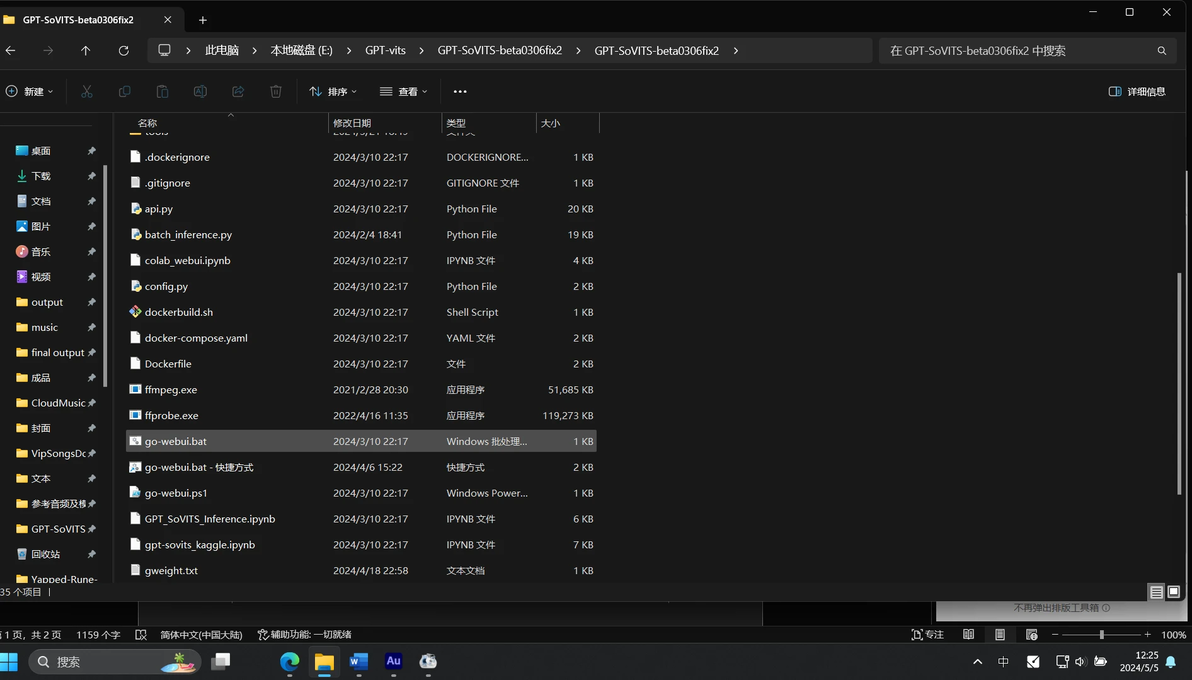
启动终端
g.左键单击选中干声文件,按ctrl+shift+c复制文件地址,按ctrl+v将其粘贴到“音频自动切分输入路径”栏,点击“开启语音切割”。切割完毕后你可以在 根目录/output/slicer_opt 中找到它们。
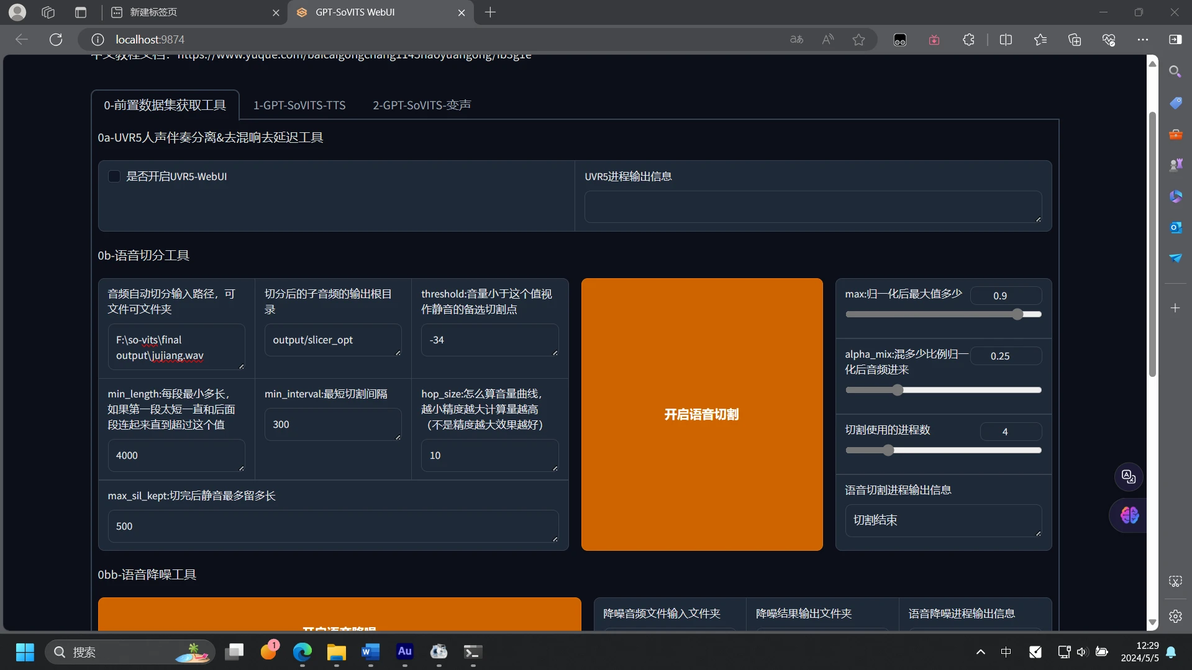
语音分割
h.新建文件夹(地址不限)并重命名为说话人名字,将切割好的音频剪切过来 。
i.压缩上述文件夹为zip格式,将其上传至阿里云盘(文件夹别删了,推理时找参考音频要用)
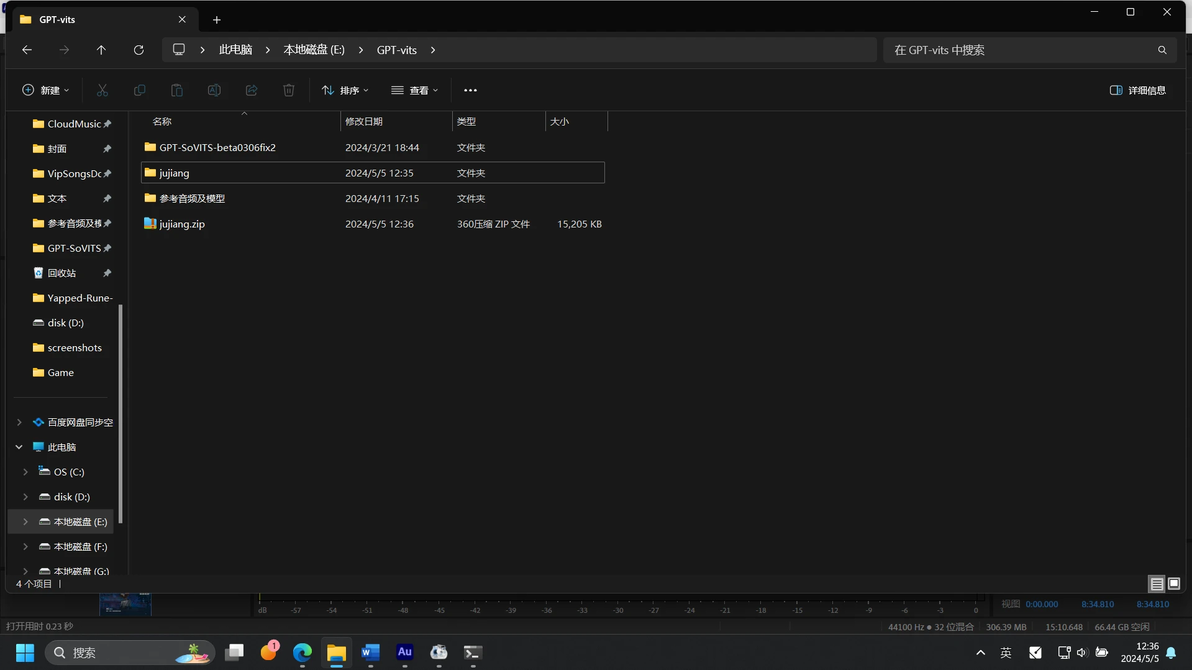
制作训练集
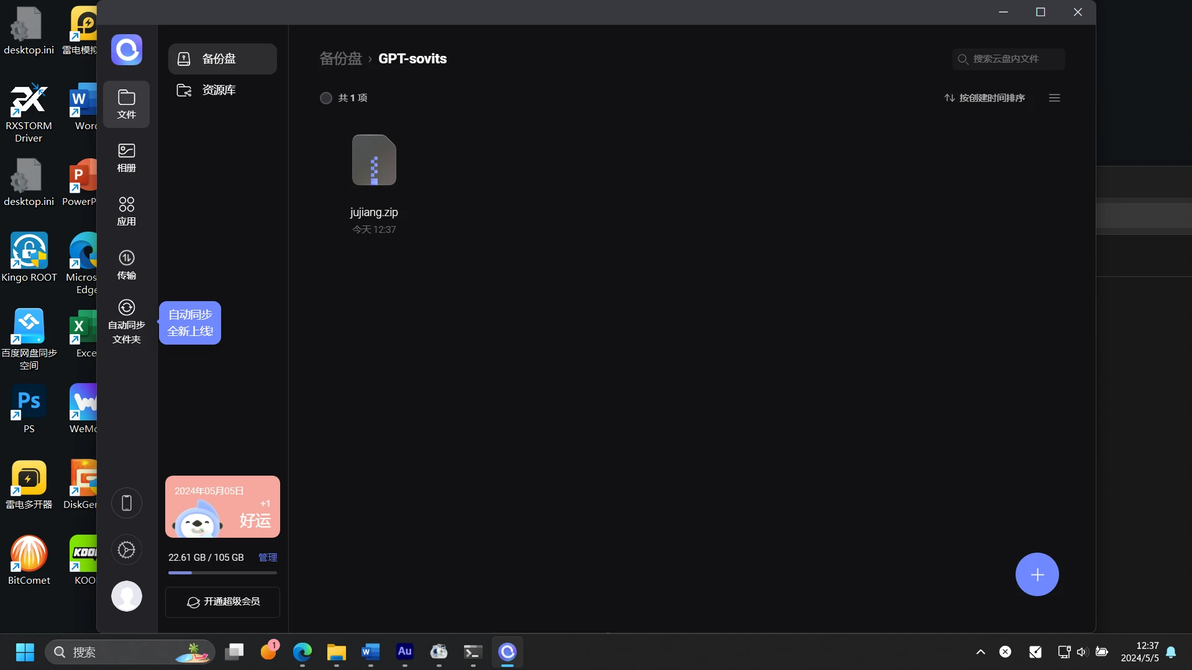
上传阿里云
j.关闭终端
注:训练集中的音频文件的文件名最好仅由英文大小写字母,数字,下划线组成。训练集中的音频文件最好是单语种,以避免可能导致的报错。
(2).从wiki中提取音频
如果您训练的说话人为某一游戏的某一角色,您很有可能在对应的游戏wiki中找到相应的语音文件,接下来我以角色“早濑优香”为例
a.在浏览器中输入kivo.wiki 进入
b.在角色图鉴中下载语音,注意:过短的语音不要下载(例如角色受击语音),时长大于等于24秒的不要下载。
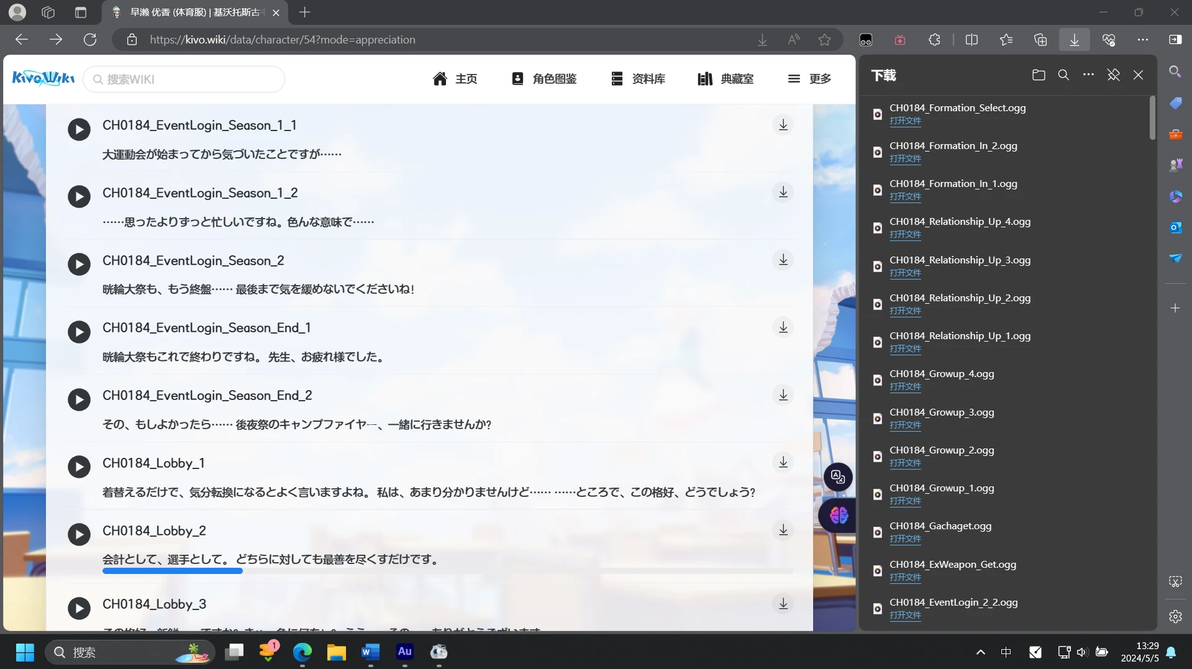
语音下载
c.打开格式工厂,在“音频”中选择“音频合并”,在输出配置中我们可以调节输出文件的格式和音量。我们将下载的语音集通过格式工厂合并成一个格式为WAV的长音频,将其导入到AU中(这个就不用新建多轨会话了,只是看一下最大响度而已,用于训练的文件最大响度最好在-6至-9db之间),如果响度太大,就将在格式工厂中将“音量”调小再次合并,直到最大响度在-6至-9db之间为止。我们发现音量调低至25%和50%时响度大小合适。
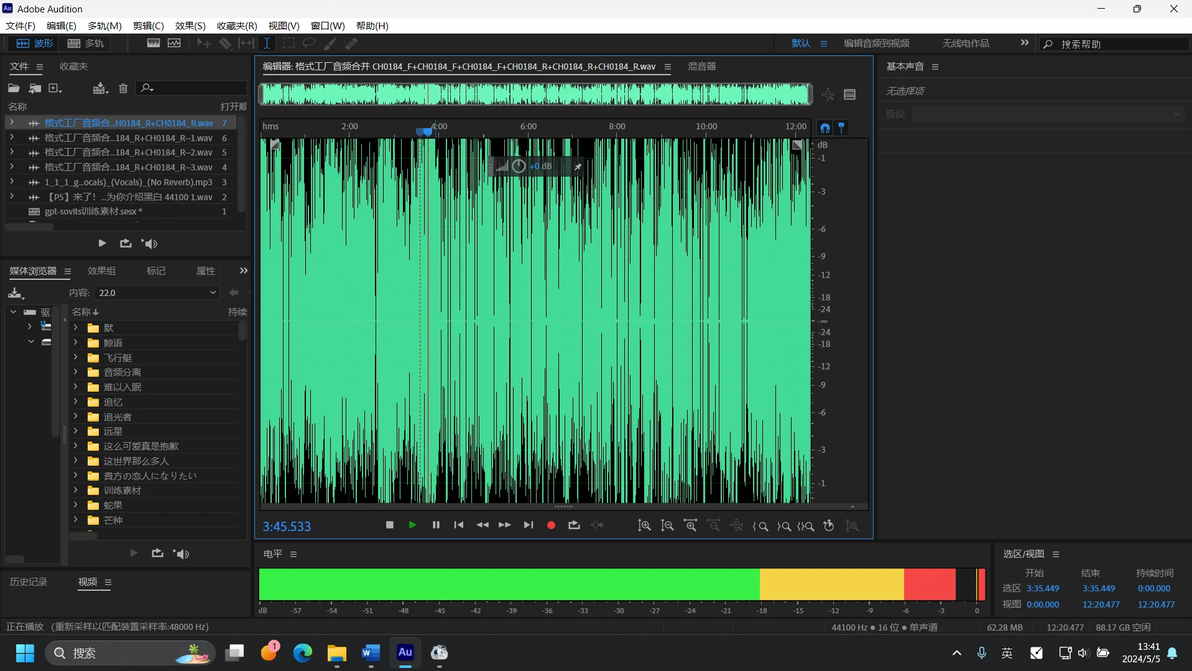
响度太大
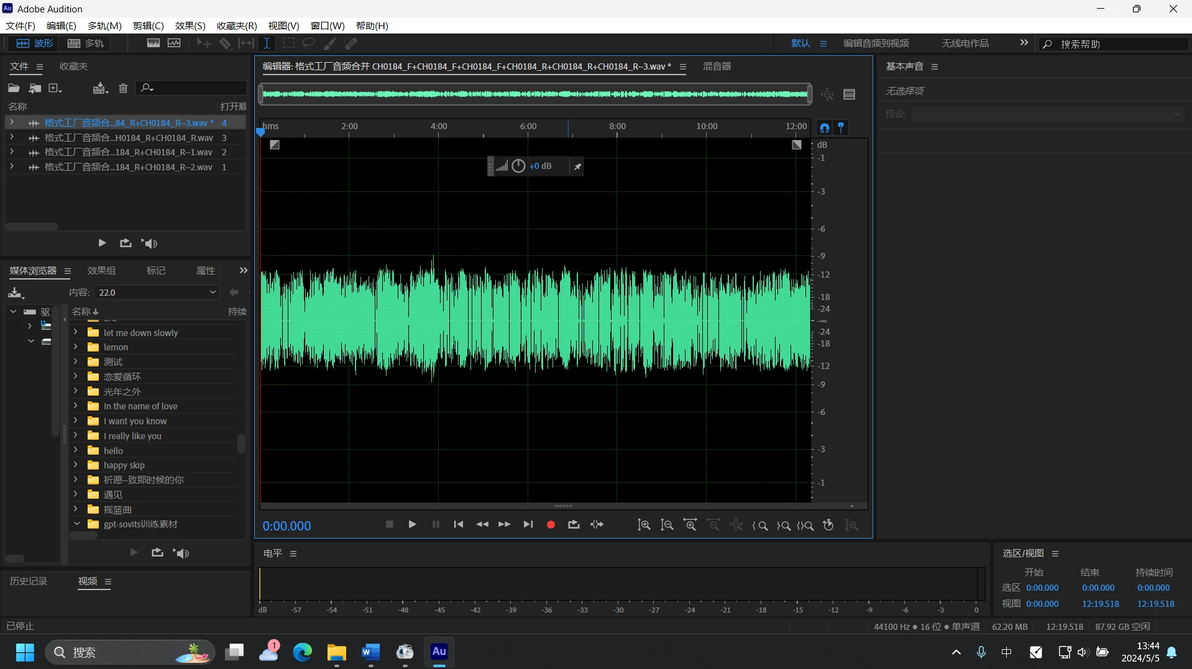
响度合适
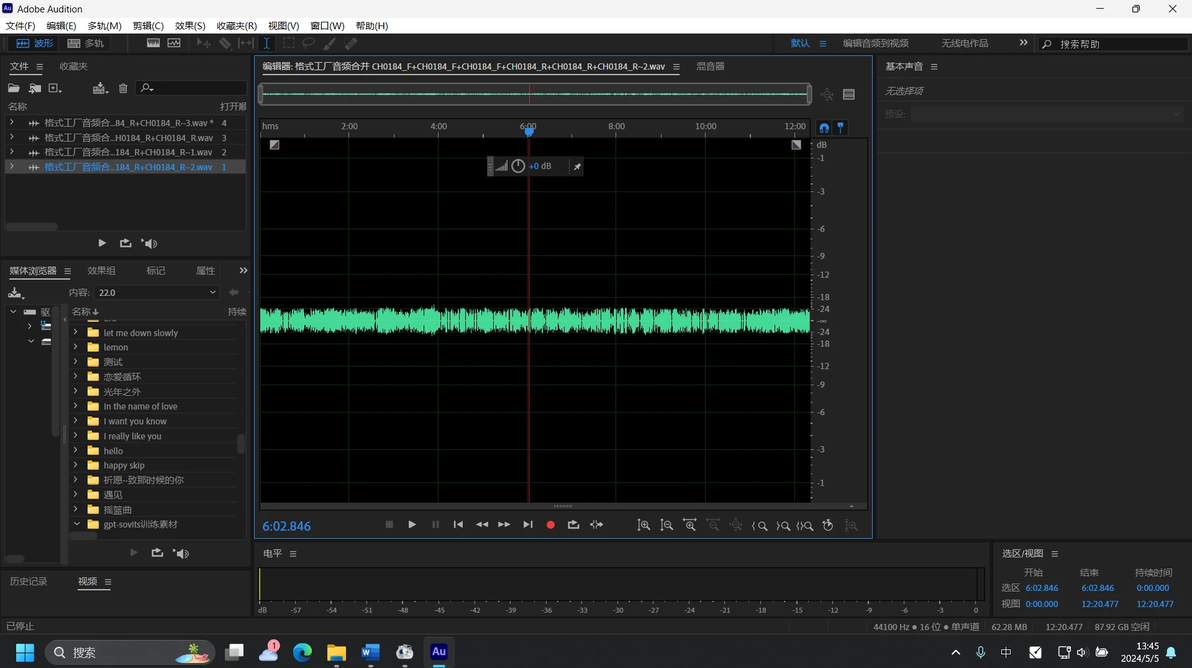
响度合适
d.在格式工厂中选择“->WAV“,将在下载的语音全部添加进去,在”输出配置“中采样率设置为44100Hz,音量为25%。(50%应该也行,但我个人喜欢25%)点击“确定”返回首页,单击“开始”进行格式转化。
e.新建文件夹(地址不限)并重命名为说话人名字,将转化好的音频剪切过来 。
f.压缩上述文件夹为zip格式,将其上传至阿里云盘(文件夹别删了,推理时找参考音频要用)
注:训练集中的音频文件的文件名最好仅由英文大小写字母,数字,下划线组成。训练集中的音频文件最好是单语种,以避免可能导致的报错。
2.云端训练
①租卡
a.浏览器输入www.autodl.com,回车。点击右上角“登陆”,微信登陆,扫码关注公众号,完成登陆/注册
b.充值,一般3~5元就够了
c.点击上方的“算力市场”,租一张卡,优先级为A5000>3090>4090D>4090(总之显存要大于等于24G,价格越便宜越好),都没有的话就再等等吧,一般而言晚上的卡会多一点。
d.点击租卡,GPU数量选择1,镜像选择社区镜像,GPT-SoVITS语音合成官方镜像,镜像版本选最新的就行。等待开机。
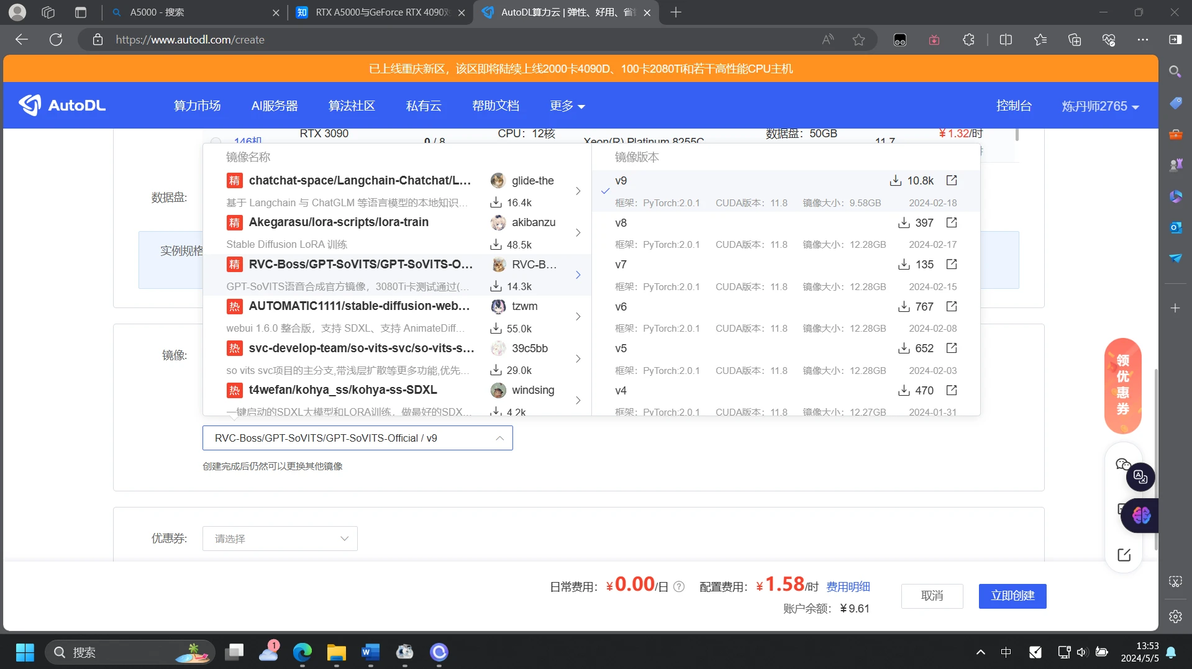
点击“立即创建”
②打标
a.点击“快捷工具”中的AutoPanel,点击公网网盘,独立访问密码随便设一个。手机端APP扫码登陆阿里云盘,将你的压缩包下载下来。
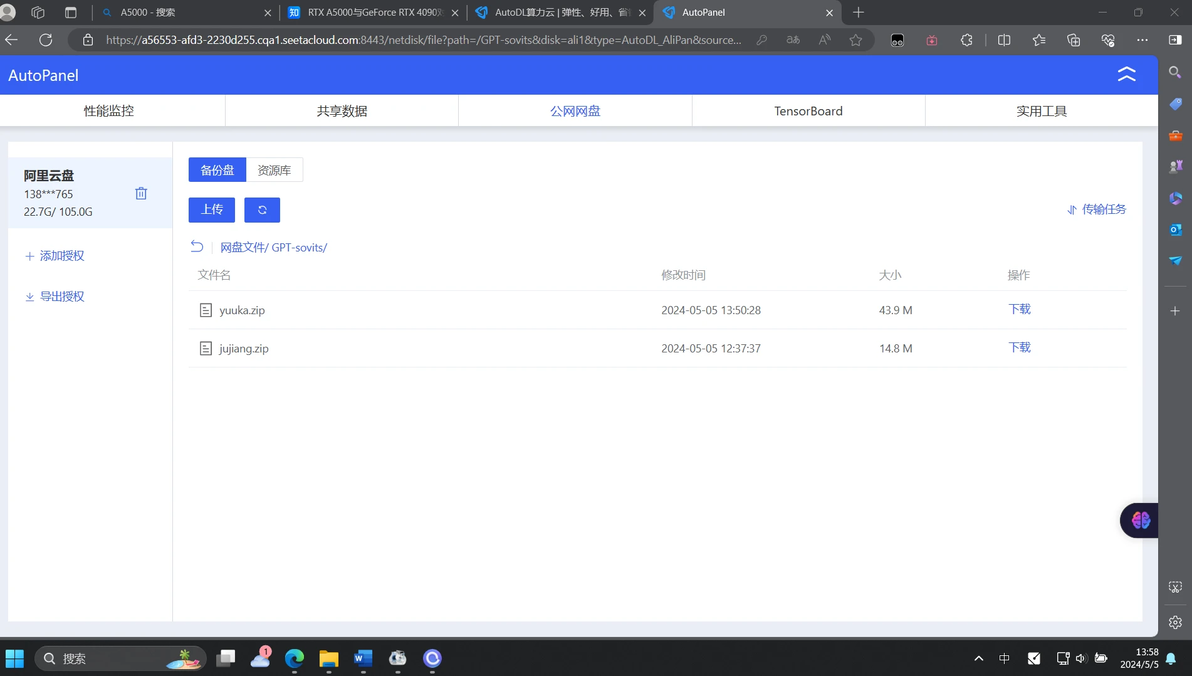
单击下载
b.点击JupyterLab进入如下网页,点击左上角文件夹图标以返回根目录。进入autodl-tmp文件夹即可找到你的压缩包。
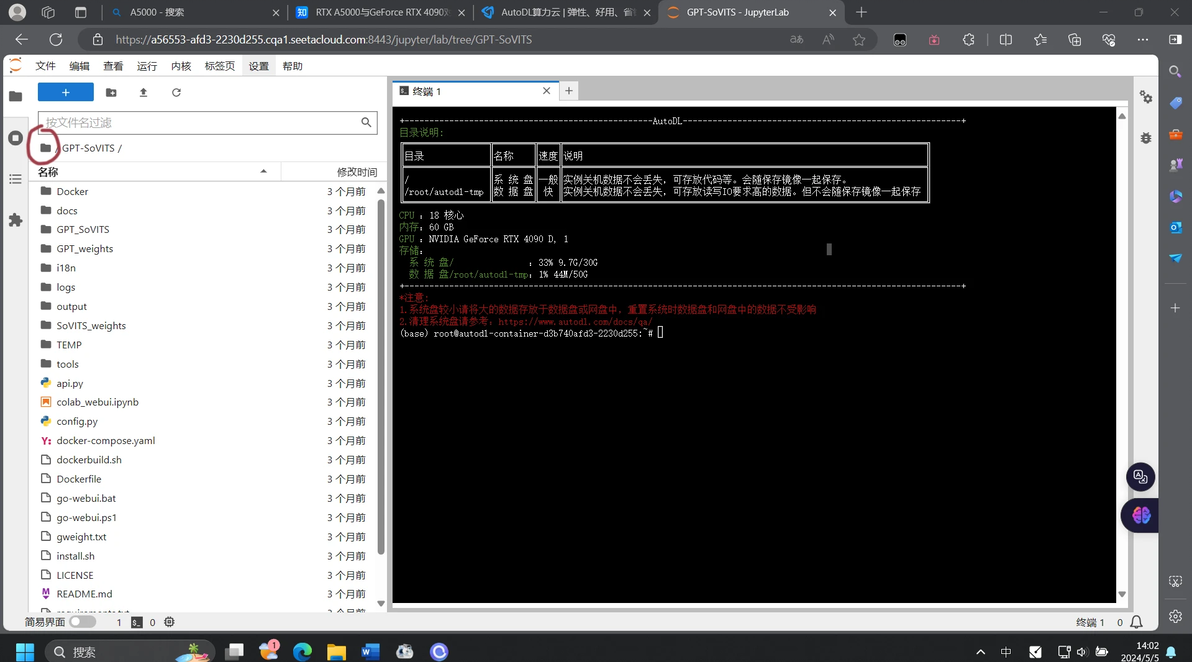
暗红色圈起来的这个
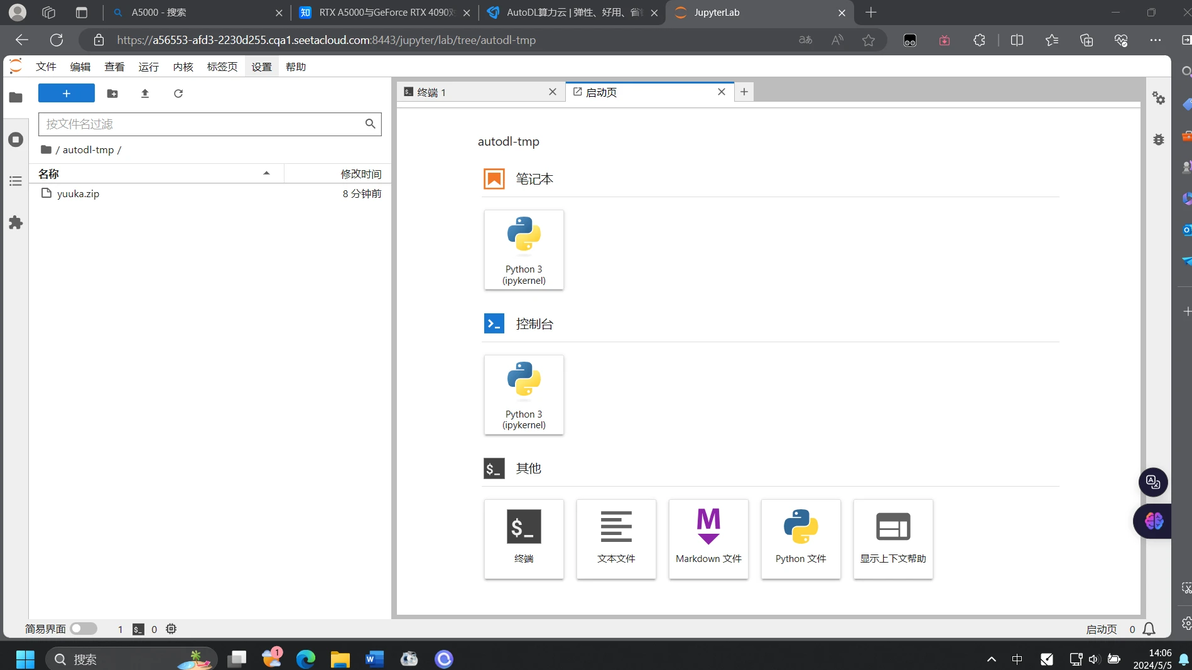
下载下来的压缩包
c.点击左上角蓝色框里的+号,在启动页一个终端,输入unzip[空格][文件名],按回车键执行该命令。执行完毕后关闭该终端。
d.回到GPT-SoVITS文件夹中,点击右上角“+号”,在启动页新建一个终端(不要关闭这个终端!!!),输入指令echo {}> ~/GPT-SoVITS/i18n/locale/en_US.json && source activate GPTSoVits && cd ~/GPT-SoVITS/ && python webui.py 按回车键执行。等待运行。之后点击下面这个链接以访问webUI。
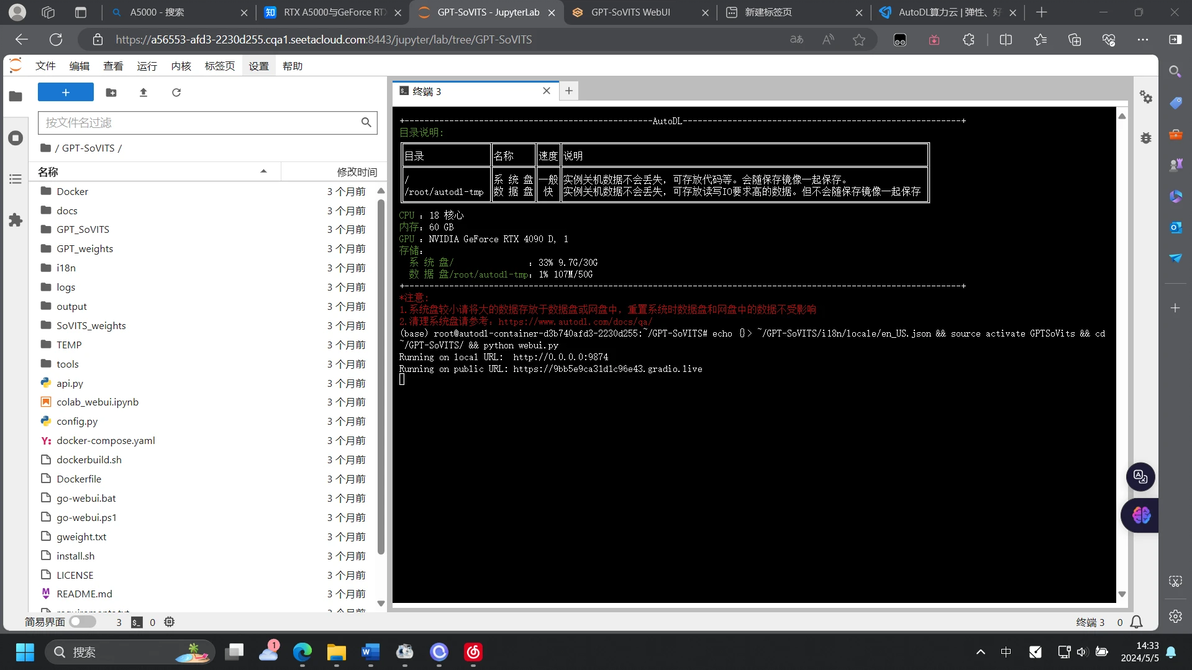
终端里下面的那个Running on public URL的链接
e. 找到之前您解压的文件夹,右键选中,点击复制路径。将其粘贴到0c栏,并在前面加上一个/root/。若训练集为中文,ASR 模型选择达摩ASR,若训练集为英语/日语,ASR模型选择Faster Whisper,ASR 模型尺寸选择large-v3,ASR 语言设置en(对应英语)/ja(对应日语),点击开始离线ASR。该过程需要等待一段时间。在终端中可以看到已用时间和预计剩余时间,若预计时间太长,请点击终止ASR进程,并重新开始。
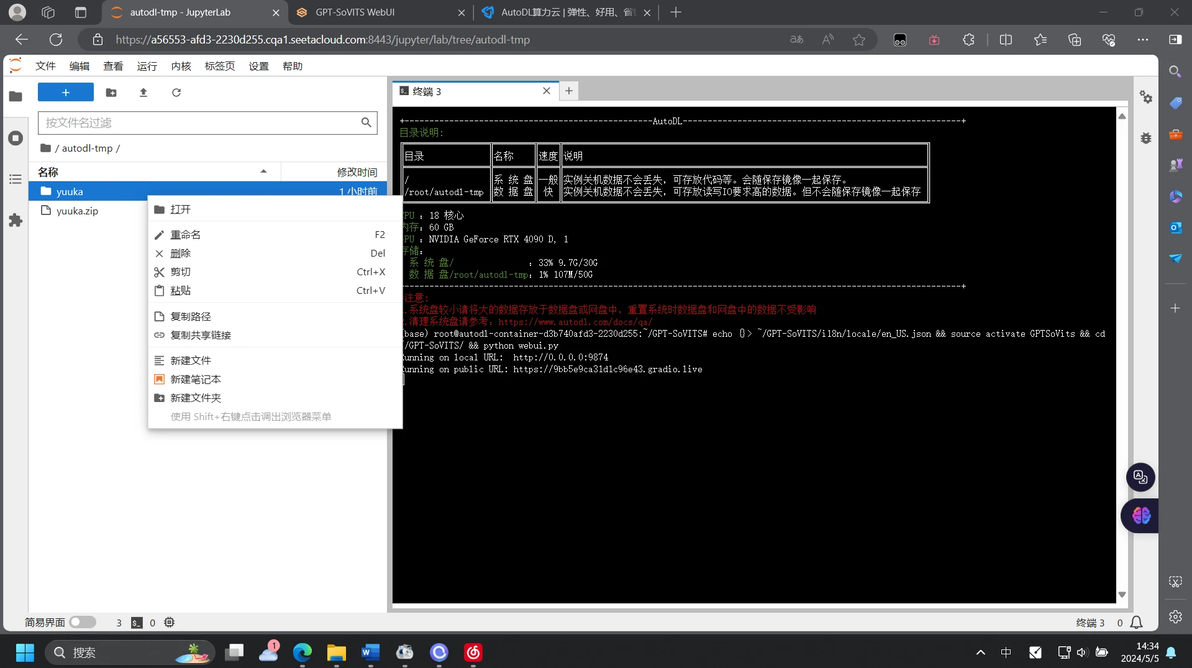
复制文件路径
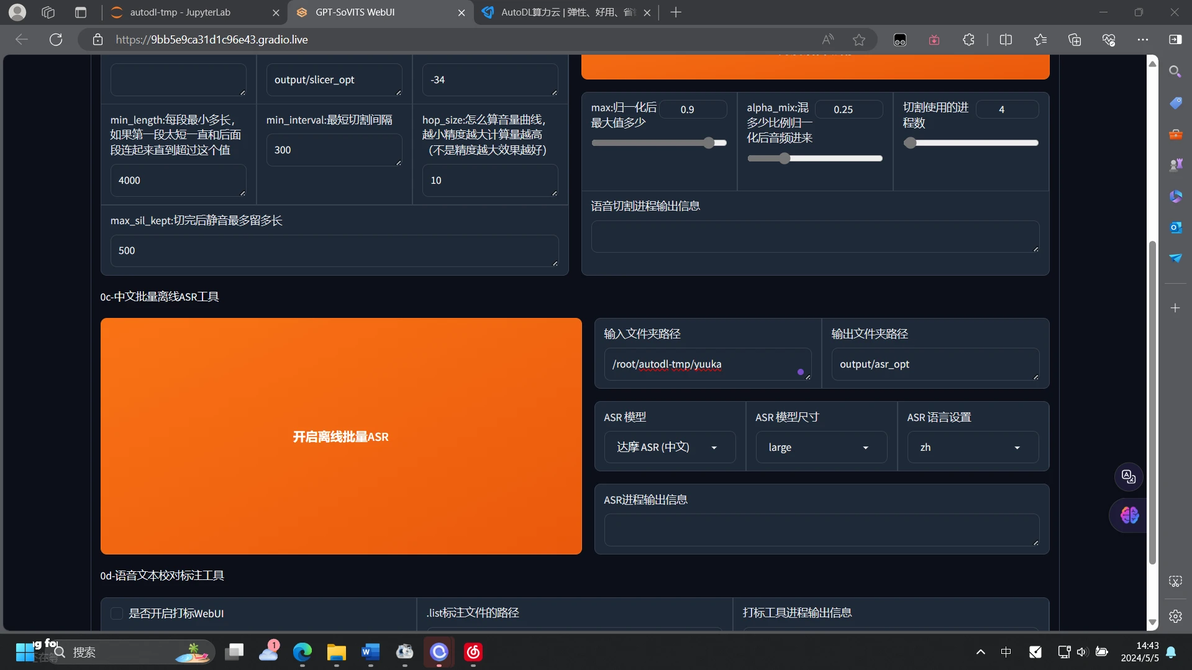
标注
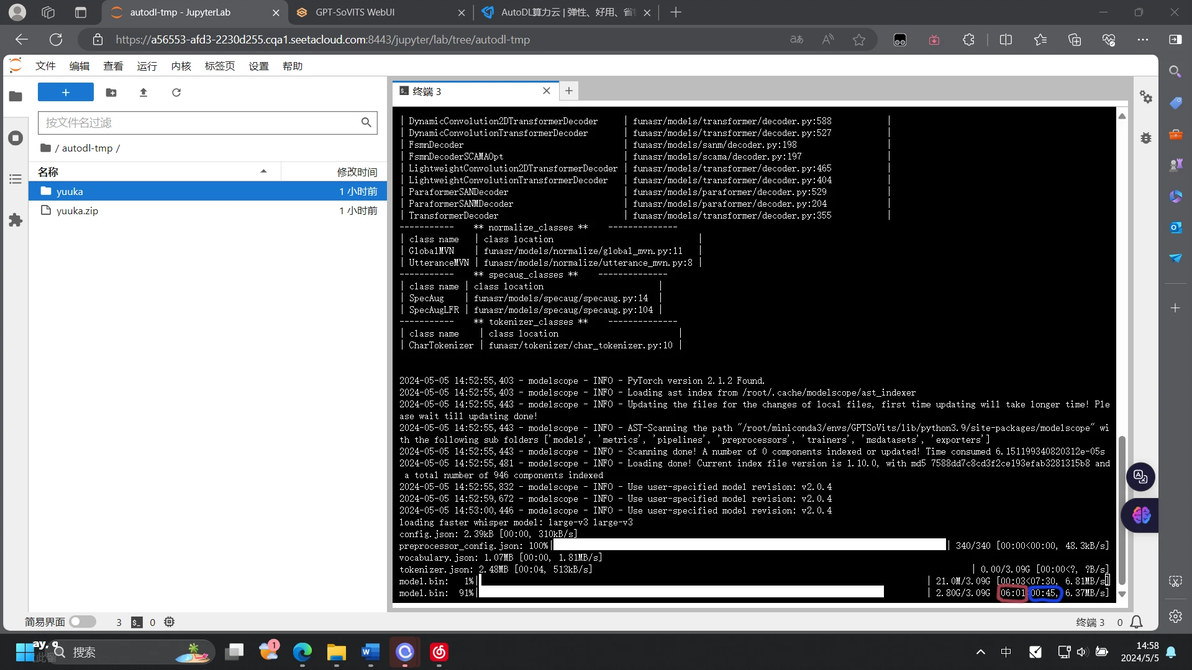
暗红色是已用时间,蓝色是预计剩余时间
③校对标注(这个步骤比较耗时,可选)
对于从视频中提取的音频:
以后单独出视频。
对于从wiki中提取的音频:
a.在GPT-SoVITS/output/asr_opt中找到你的标注文件,双击打开它。
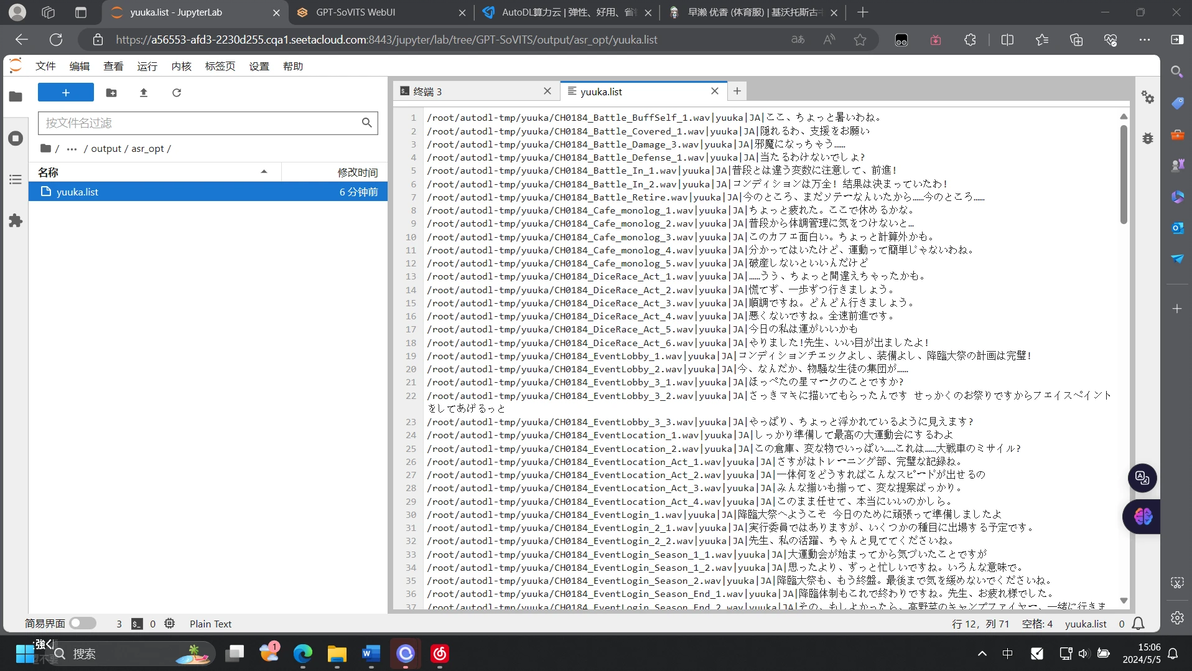
打开标注文件
b.对比标注文件中的文本和wiki上的语音文本,如果识别的标注文本有误,请复制对应的wiki语音文本覆盖过去。
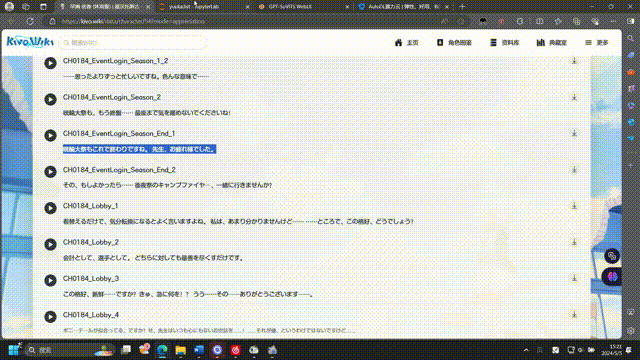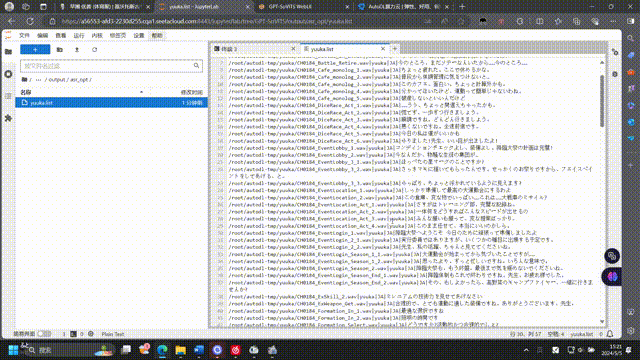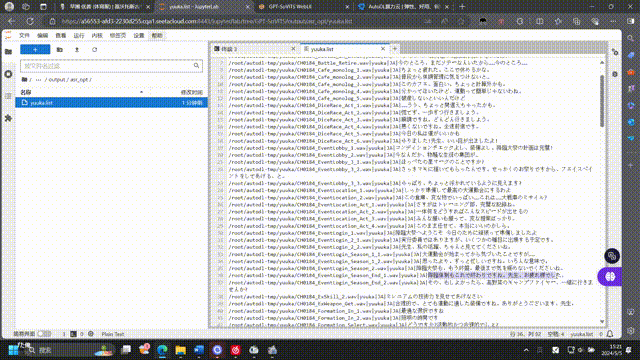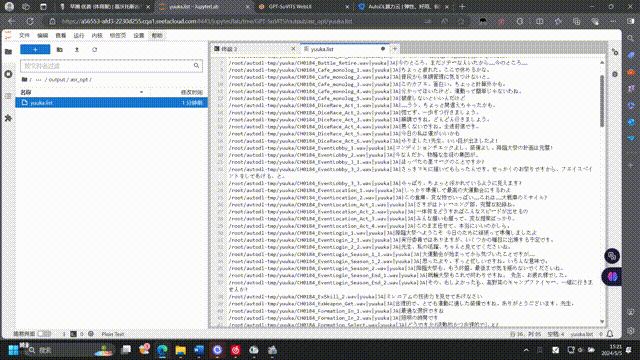
校对标注
c.关闭标注文件,保存修改
④训练模型
a.点击最上方的1-GPTSoVITS-TTS,模型/实验名输入你的说话人名字。
b.在终端中找到标注文件路径,将标注文件路径和之前您解压的训练集文件夹路径分别填入以下两行。点击最下方的开启一键三联。
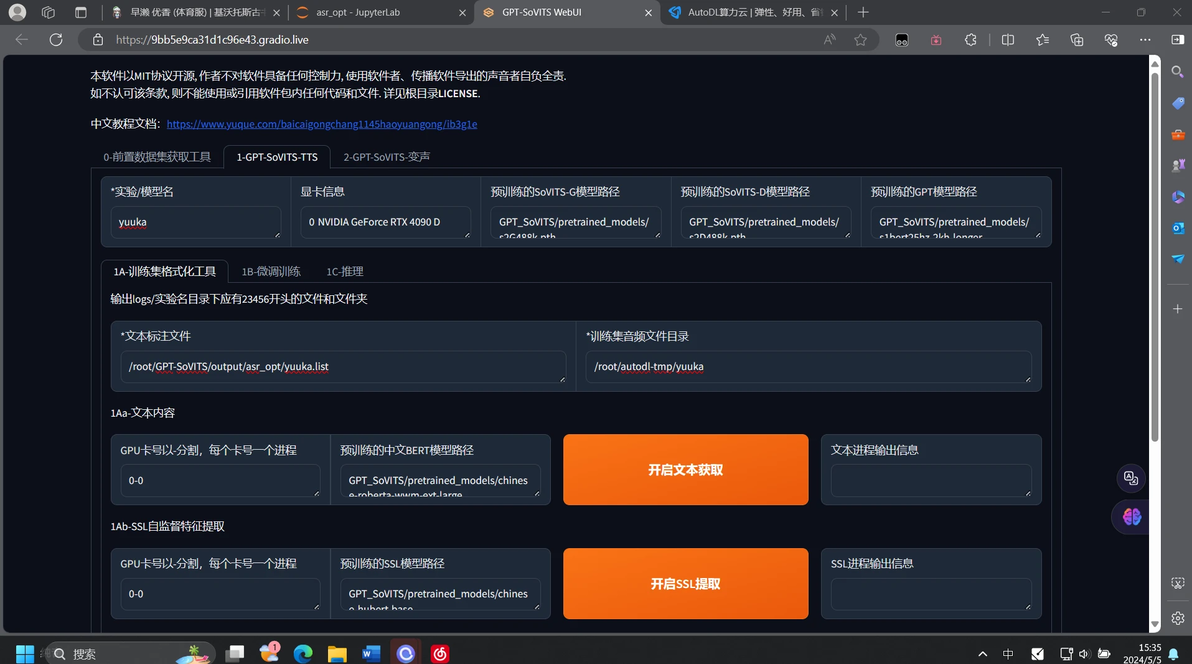
填写说话人
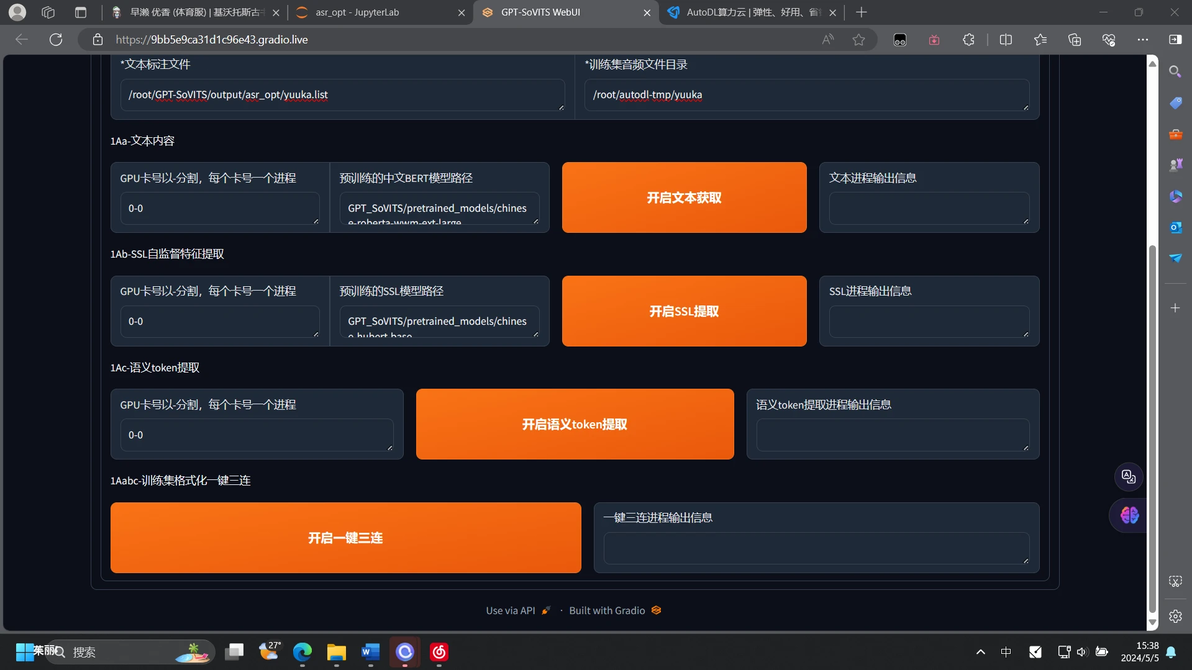
点击一键三连
c.当一键三连进程输出信息为“一键三连进程结束”后,点击上方1B-微调训练。个人推荐的训练参数如图,如果您没有进行标注校对或从视频中的提取的音频含有杂音,请不要启用dpo训练。点击开启SoVITS训练,在SoVITS训练完后再开始GPT模型训练。
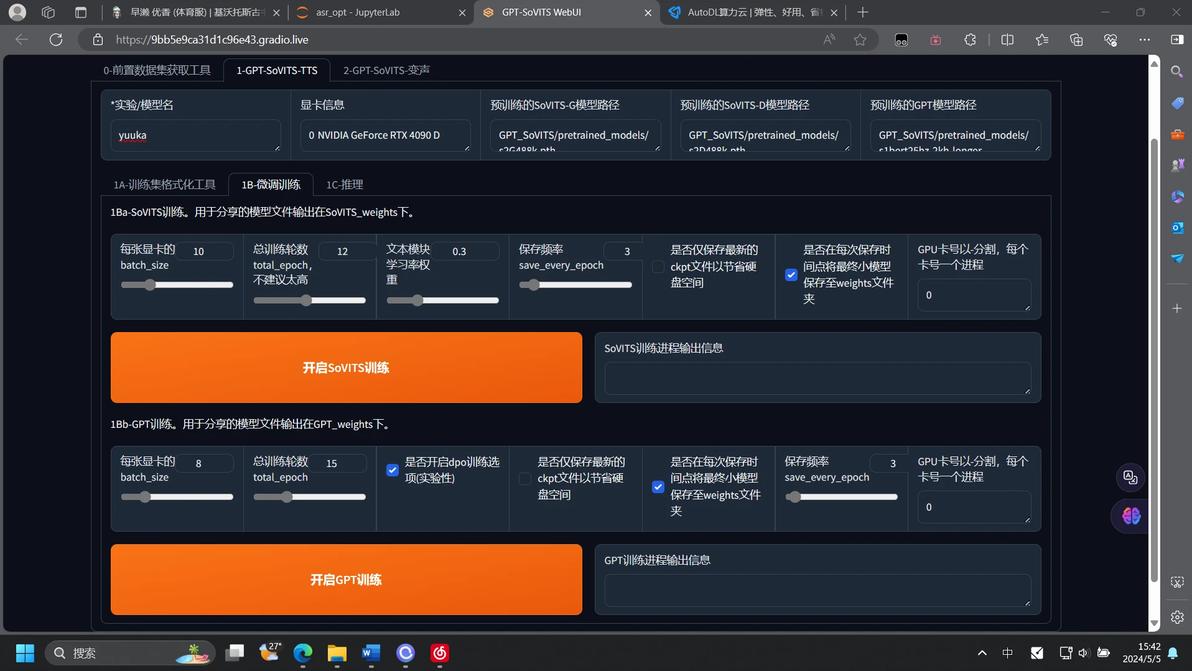
学习率最好在0.3至0.4之间
d.在两个模型都训练完后,点击上方的1C-推理,点击“是否开启TTS推理WebUI”。在终端中点击这个链接以打开推理webUI。在上方一栏可以切换模型。点击上传一段训练集中语气较为平淡,语速适中的3~10秒的语音。并填写参考文本和参考音频的语种。随便写一段话,点击合成语音即可。
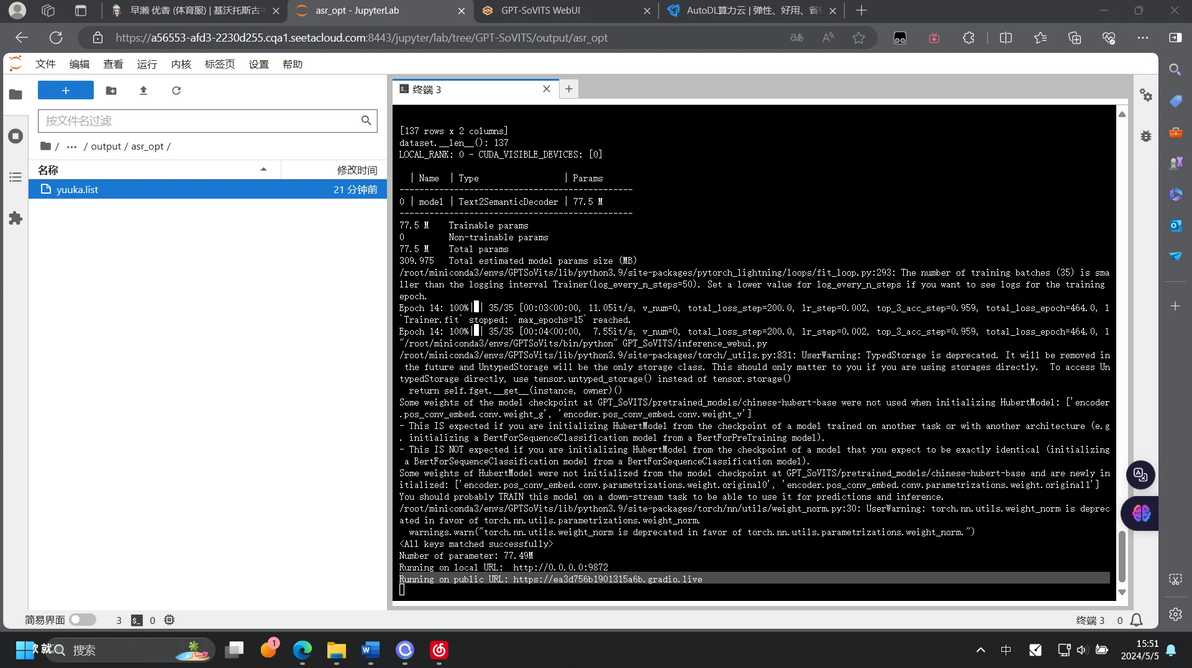
点击下面这个链接进入推理webUI
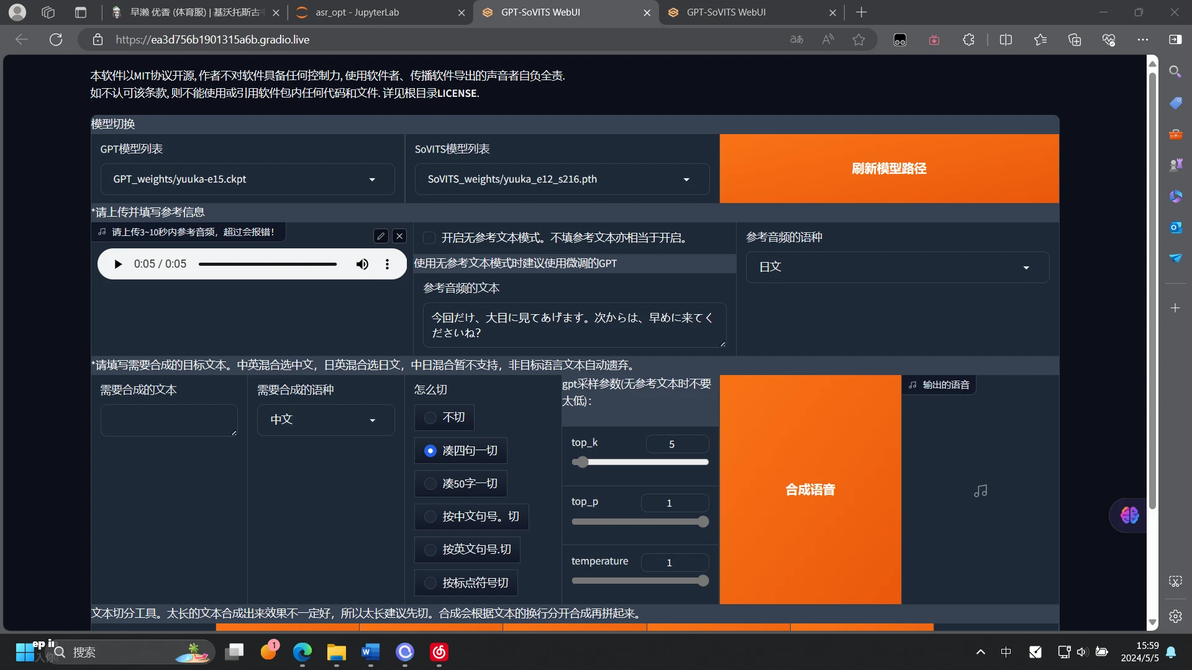
推理界面
e.带上耳机,听一下合成出来的语音。在训练出的模型里挑出一个效果最佳的组合,在/GPT-SoVITS/GPT_weights/中找到对应的GPT模型文件,右键选中,下载。在/GPT-SoVITS/SoVITS_weights/中找到对应SoVITS模型文件,右键选中,下载。
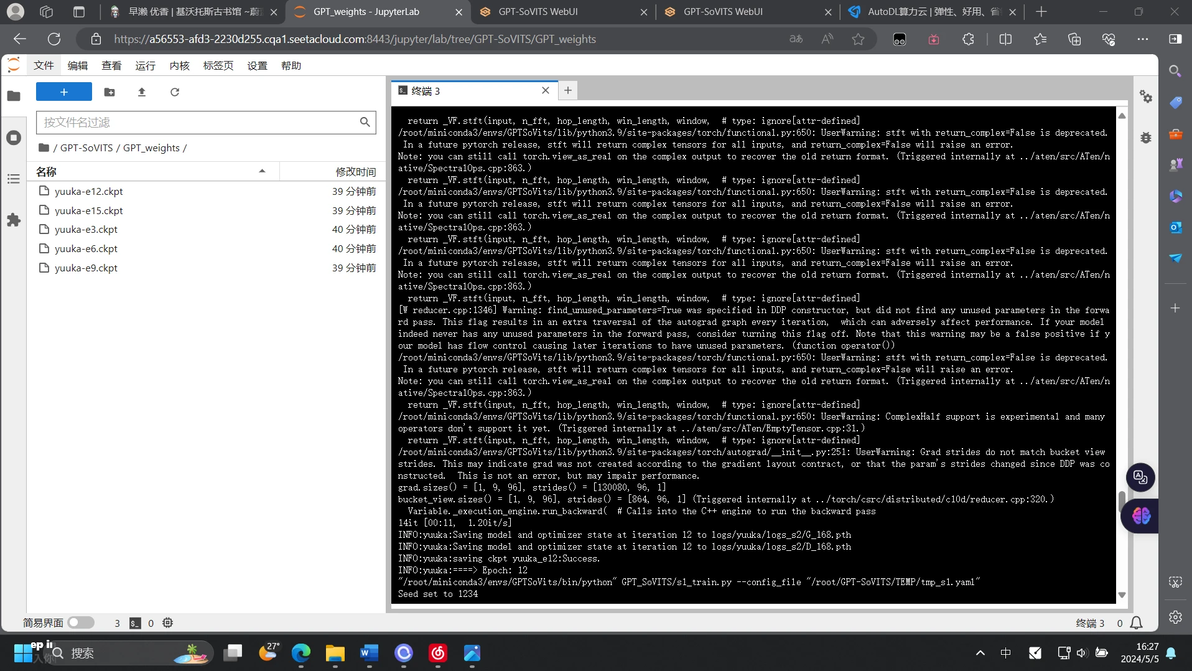
GPT模型文件夹
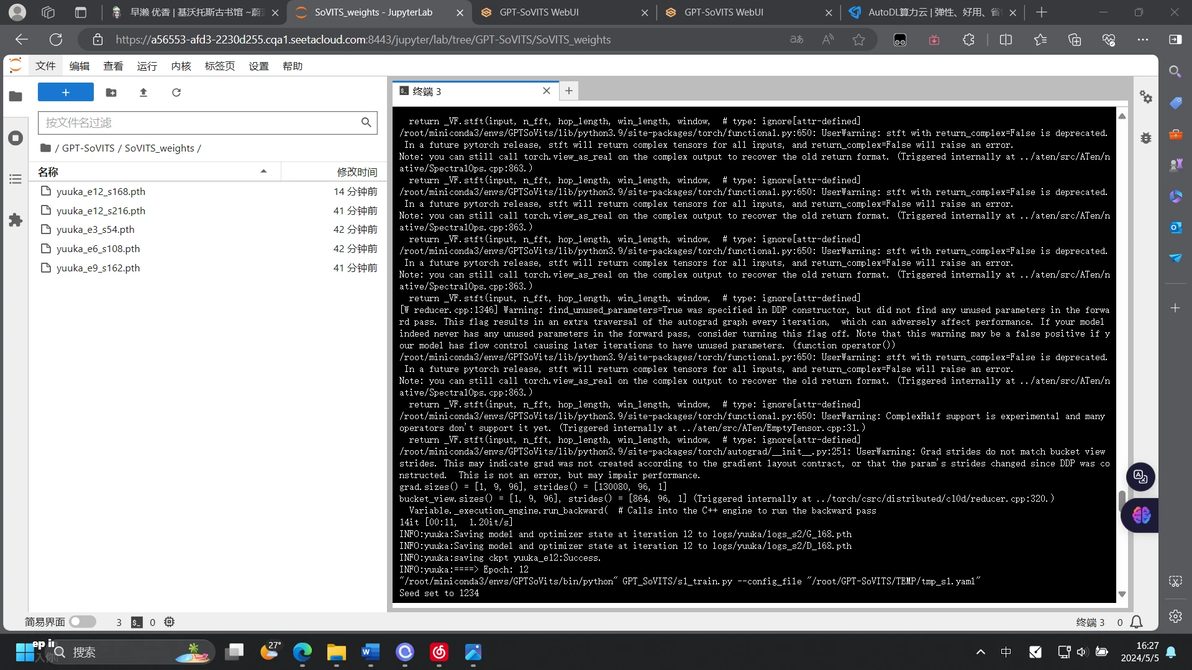
SoVITS模型文件夹
至此云端训练结束
关机,结束计费
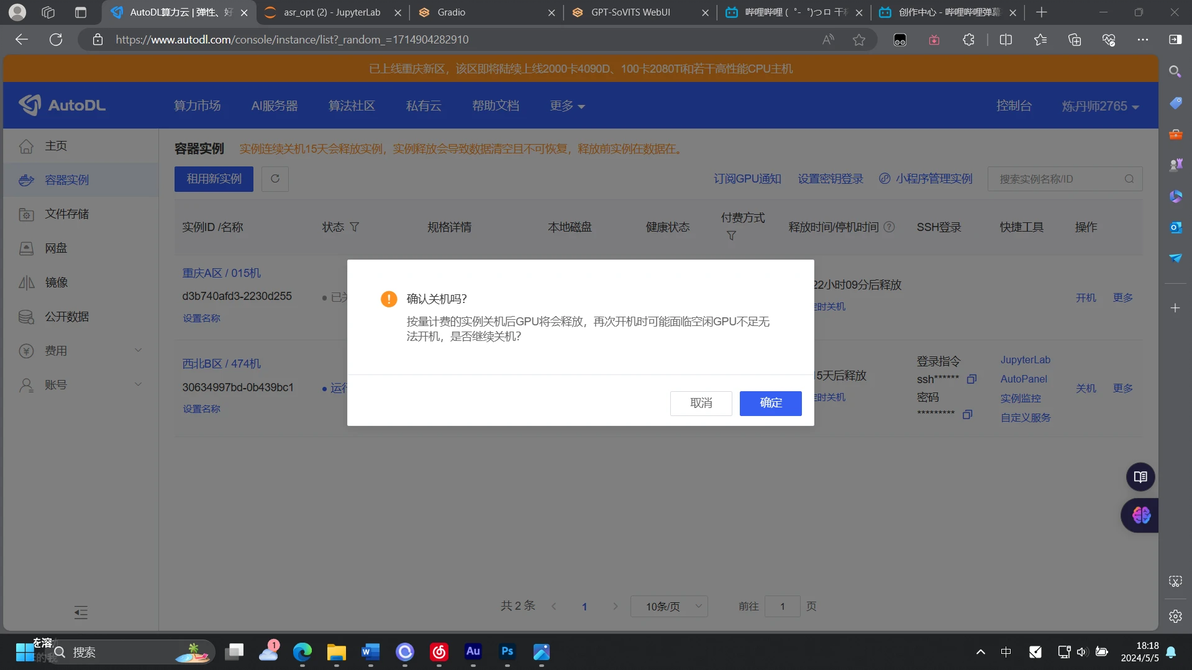
关机
本地推理教程
a.将后缀为pth的文件放入整合包中的SoVITS_weights文件夹,将后缀为ckpt的文件放入整合包中的GPT_weights文件夹。
b. 打开浏览器,在整合包中双击”go-webui.bat”并等待启动
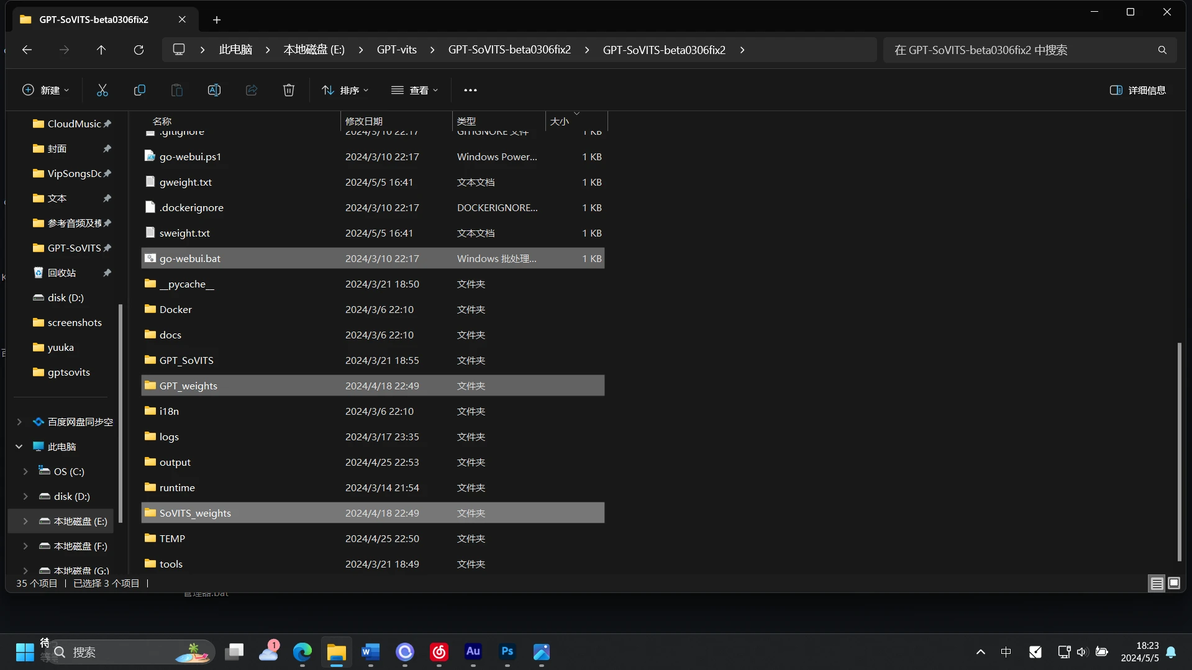
SoVITS_weights文件夹,GPT_weights文件夹和go-webui.bat
c.点击上方1-GPTSoVITS-TTS,点击1C-推理,点击“是否开启TTS推理WebUI”。等待webUI启动。

d. 在上方一栏可以切换模型。点击上传一段训练集或分享者模型包中的3~10秒的语音。并填写参考文本和参考音频的语种。写入想要合成的话,点击合成语音即可。
e.在“输出的语音”右端有三个点,点击它,即可下载合成的语音。
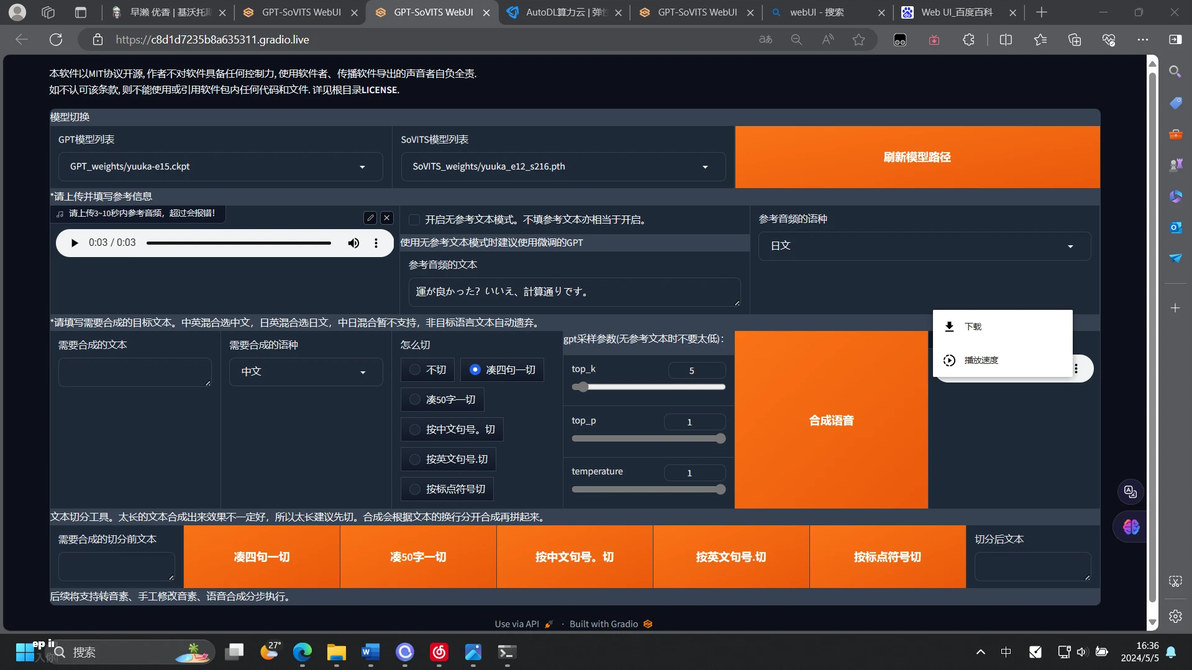
合成语音下载
麻麻省的,终于写完了,累死我了。
