AI实时交互之Stable Diffusion开坑

收录于文集
共5篇
实验编程AI与交互
AI实时交互是一直期待的事情。这个期待主要是指Stable Diffusion(详见后文)。
其实2021年起我在教学中就已经上StyleGAN的实时交互了。因为StyleGAN性能高、对电脑要求低,这两年一直是交互装置中较受欢迎的方案。
StyleGAN交互相关课程:
而对于Stable Diffusion,一直没做是因为在等它的效率提升。去年末其实也立了Flag,见 AI陷阱2024与实验编程教学计划。
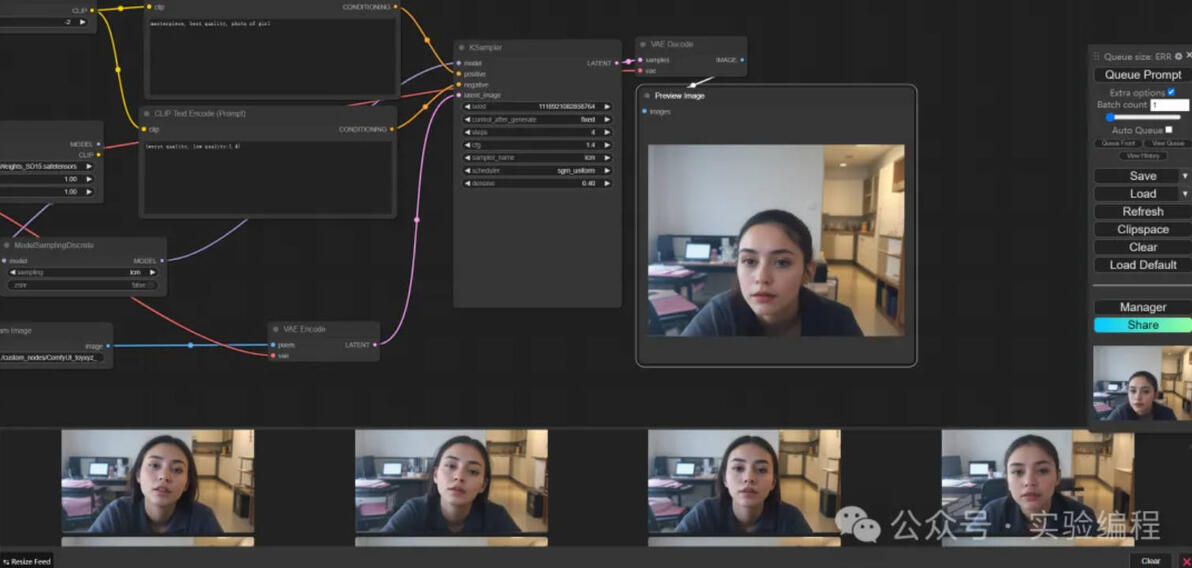
最近头一次跑了Stable Diffusion实时生成的Demo,算是正式开坑吧。
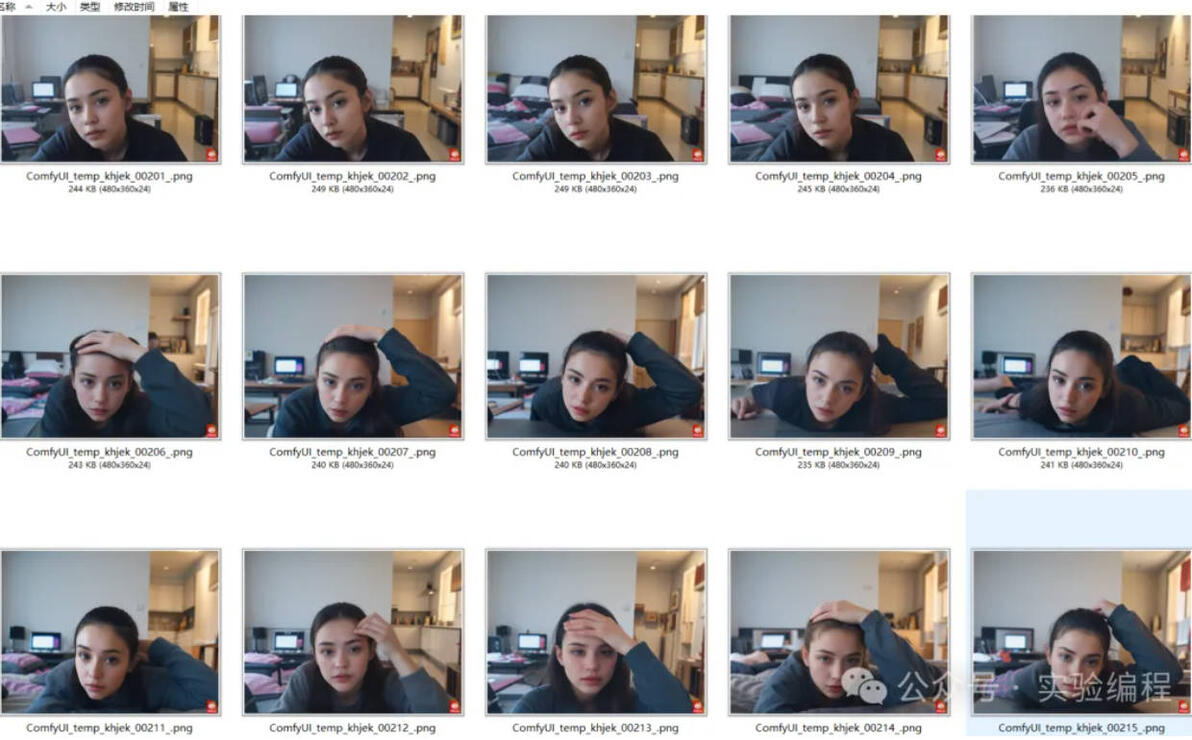
先看效果:
要点:
LCM LoRA模型
https://civitai.com/models/195519
插件:ComfyUI_toyxyz_test_nodes
https://github.com/toyxyz/ComfyUI_toyxyz_test_nodes
这个Demo没做任何优化,就是很低效的通过摄像头存截屏文件,然后以SD图生图的模式不停的生成。
文件存取对硬盘的IO性能考验较大,我用的是一块高速硬盘。
后续准备试一下把文件存取的方式,换成直接读取视频流。以及ComfyUI搭建好工作流后,可以启用API模式。这样应该会更流畅一些。
本文为我原创,未经授权禁止转载
cv33990678
分享至
投诉或建议
