
大模型的面试,正在变得越来越卷!
我见过不少这样的同学,背景出奇的一致:非科班、转行、普通学历,很努力的想入行大模型。
他们刷过网上很多教程,跑过GitHub热门项目,常见八股也都能吟唱。
结果呢?简历投出去,石沉大海。偶尔拿到面试机会,问深一点就露怯:
你这个项目的数据量有多大?
项目如何做的技术选型?
线上服务的延迟要求是多少?
有没有遇到过什么线上问题,如何解决的?
答不上来。
于是,大模型行业出现了这样的阶层固化
很多非科班普通背景的同学,自身很好学,看各种技术文章、视频、八股、项目,却始终迈不过简历上缺少企业级项目这个门槛。
想想也是,网上绝大多数项目确实就是demo,没什么含金量,缺乏技术挑战,你再怎么钻研,又能做出什么花儿来呢?
因此在接触了大量这样背景的同学后,我总结出了这些同学逆袭的关键要点:
一条体系化的学习路线,学习过程不走弯路,不留技术短板。
完整经历企业级大模型项目的开发流程,从技术选型,架构设计,项目开发,到最终上线,彻底打破"阶层固化"。
简历面试的深入打磨:学的内容要能体现在简历上,面试中能“抖”出来。
🔍我的大模型训练营的特点
🎯 真实企业级项目驱动
✅ 没有项目是非科班同学的“死穴”,课程包含3个独家原创企业级项目,绝非市面上的demo。
✅ 我会还原公司里做项目的真实情况,从技术选型,架构设计,分模块开发,测试验证,最终上线。
✅ 这个过程中,会同步讲解我们在项目中踩过的坑,遇到的问题,尝试的思路,解决的方案。
✅ 项目讲解:杜绝对着代码干讲,核心代码全部手写,边写边讲思路,为什么要这样实现。
🚀 完整的大模型技术体系
✅ 有的同学会问:师兄你讲不讲这个,讲不讲那个。实际上大家根本不用问,不仅会讲,而且会在项目中实战。
✅ 之所以用真实项目,就是在这里面会遇到大量技术挑战,进而可以完美的将各种大模型技术运用到项目中进行实战。
✅ 无论是大模型应用开发、大模型算法、多模态大模型,都会匹配完整的大模型技术体系,确保你整个技术栈没有短板。
🧩 定制化的学习路线
✅ 学习路线散乱,是不少同学中途放弃的原因之一。因此一条系统学习路线极为关键。
✅ 我会根据你的背景定制学习路线,无论你有没有基础,无论你是找实习/校招/社招,都有匹配的学习路线。
💥 大厂面试题深入讲解
✅ 绝不是照本宣科的讲解八股,那样毫无意义。通过我的讲解你可以看到,即使是“问烂”的面试题,依然有拉开差距的高分回答。
✅ 还有大厂面试官最喜欢的连环炮追问:这个模块如何改进?还能进一步优化吗?为啥用A不用B?
✅ 场景题也是大厂面试最喜欢考的一类题目,给一个场景,如何设计?如果换一个场景呢?
💻 线上生产经验分享
训练效果不好怎么办?指标上不去怎么调?
✅ 实际公司里做项目一定不是一步到位的,你会遇到各种问题,踩各种坑,在解决问题的过程中积累经验。
✅ 我会讲我们在做项目的时候,踩过的坑,遇到的问题,尝试的思路,解决的方案。
✅ 实际生产问题,往往是面试官最感兴趣的,通过学习,你可以完整吸收这些经验,成为你面试的核心竞争力。
🧑💻 开源框架源码带读
✅ 如果要有深厚的技术功底,那么必须阅读优秀开源框架的源码。课程除了注重实战能力外,也注重底层内功的积累。
✅ 我会带你阅读DeepAgent、Self-Play R-ZeRo、GOLD TRL等优秀源码,并且授你以渔:面对一份开源项目源码时,应该怎么读?
✍️拒绝复制粘贴,图解复杂概念+手推公式
✅ 我最讨厌对着 PPT 干讲,PPT 做的再精美也没用。
✅ 最好的授课效果,就是大白话结合图解,代码现场手写,公式现场手推,只有这样才能把复杂技术讲明白。
⌨️ 拒绝干讲,现场手撕代码
✅ 讲完原理,马上带大家手写代码,边写边讲实现思路,出了问题现场debug。
✅ 这个过程中,你可以从代码层面进一步理解这个技术,学习我的代码风格,以及我遇到问题时的排查思路。
💌 实战驱动的学习效果反馈
✅ 阶段最后会安排一个综合案例实战,其含金量放其他机构都可以当作一个独立的项目。
✅ 你需要独立完成,才算真正掌握这一阶段的内容。
📝学习内容和课程大纲
大纲比较长就不在这里展示了,想直接看大纲的同学可以点下面链接:
丁师兄大模型训练营 · 课程大纲:
✅ 阶段一:NLP 核心技术 & 大模型的前世今生
✅ 阶段二:LLaMA全系列大模型精讲和实战
✅ 阶段三:Deepseek 全系列大模型精讲和实战
✅ 阶段四:LLM 预训练 & 继续预训练精讲和实战
✅ 阶段五:大模型 Mid-Train & SFT 和 Model Merging 精讲与实战
✅ 阶段六:强化学习核心算法和 DPO 精讲与实战
✅ 阶段七: LLM+RL 后训练精讲与实战
✅ 阶段八:Agent开发精讲与实战
✅ 项目实战:基于自进化+对抗降噪的 DeepResearch Agent 项目实战
✅ 项目实战:基于 Qwen3-VL 后训练的智慧寻车项目实战
✅ 最终的历练:基于端到端 Agentic RL 构建出行规划场景下的Long-Horizon Agent
阶段1:大模型核心技术精讲与实战
📚 学习内容
统计语言模型,神经语言模型,预训练语言模型
第一代预训练技术 word2vec,Glove 词向量
第二代预训练技术 RNN,LSTM,ELMo,Transformer,BERT,T5
第三代预训练技术 GPT,上下文学习,ChatGPT三阶段训练范式
代码实战:手撕注意力机制,自注意力,掩码注意力,多头注意力
Transformer分词器,位置编码,FFN,编码器,解码器,损失函数,采样策略
🚀 解锁技能
掌握LLM必备的NLP基础,对大语言模型的前因后果,前置基础有完整掌握
通过算法原理图解和代码实战,能够手撕Transformer核心代码
阶段2:LLaMA全系列大模型精讲与实战
📚 学习内容
✅ 掌握LLaMA大模型技术演进,Dense模型架构设计,并全部手撕代码:
LLaMA1:RMSNorm,ROPE和FFN_SwiGLU
LLaMA2:显存优化之KV Cache、GQA、MQA
LLaMA3:大模型Tokenizer编码效率,结构化剪枝和知识蒸馏
LLaMA4:超长上下文训练,Scalable-Softmax和iRoPE
阶段实战:完成 LLaMA3 的代码手撕
🚀 解锁技能
掌握LLaMA大模型的核心技术,理解Dense模型最经典的架构设计
通过图解和代码实操,不仅能吃透原理,也能完成代码手撕
阶段3:DeepSeek全系列大模型精讲与实战
📚 学习内容
DeepSeek-v1:讲解Scaling Law以及如何用Scaling Law做模型选型
DeepSeek-v2:讲解MOE架构,MLA注意力,YaRN长度外推
深入剖析MOE架构,从原始的MOE,Mixtral-MOE,讲到DeepSeek MOE
代码手撕讲解 MLA 在 Prefill,Decoding的差异
DeepSeek-v3:讲解MTP训练,v1/v2/v3三个版本MOE负载均衡是怎么做的
深入讲解 DeepSeek-V3.2 稀疏注意力 DSA 技术
案例实战:手撕 Deepseek-Distill-Qwen(适用于7B/14B/32B)
🚀 解锁技能
掌握DeepSeek模型的核心技术,理解MOE架构最耀眼的设计和模块
能在面试场上讲出DeepSeek关键模块细节,并手撕核心代码
阶段4:LLM预训练 & 继续预训练
📚 学习内容
讲解大模型预训练的语料构建,数据收集,数据清洗,数据配比
讲解如何基于MinHash+LSH做大规模语料快速去重,实现高质量打分模型
讲解大模型Tokenizer训练,词表扩展和训练词表的经验
讲解大模型选型,模型的结构超参如何设计,模型训推的显存和算力如何估计
讲解预训练模型如何评价,从困惑度计算到benchmark评测怎么做
讲解大模型分布式训练框架 DDP 和 DeepSpeed 的原理和使用
案例实战:从零到一完成 Qwen3 大模型预训练
案例实战:在预训练的 Qwen3 模型基础上,完成医疗领域Continue-Pretraining
🚀 解锁技能
能够从数据构建,清洗打分去重,数据配比设计,词表训练,模型选型和资源预估,分布式训练,模型评价,去完成一个大模型的预训练,以及继续预训练
上述过程全部亲自动手实操,边干边学,理解更深
阶段5:LLM Mid-Train、SFT与Model Merging
📚 学习内容
讲解Mid-Train的三个核心技巧:上下文扩展,训练退火策略,如何注入推理能力
讲解有监督微调:从全参微调SFT到参数高效微调
讲解LoRA及其衍生算法:QLoRA、VeRA、Delta-LoRA、LoHa&LoKr、DoRA、EDoRA
讲解拒绝采样微调RFT,以及如何用COT合成推理数据
讲模型合并,球面插值到 Task Arithmetic 到 DARE 算法
代码手撕:Qwen3 模型的中期训练和全参 SFT 训练
阶段实战:从零到一完成 Qwen3 大模型预训练和医疗领域CPT
阶段实战:Qwen3 大模型 SFT 在任务型对话场景中的意图+槽位联合抽取
🚀 解锁技能
✅ 在预训练阶段的模型上,继续完成中期训练,并从中期阶段中实现长度外推
✅ 利用模型合并,在不训练模型的情况下,实现现有业务大模型效果的显著提升
✅ 掌握SFT,独立完成垂域大模型微调训练和评估
阶段6:强化学习核心算法精讲与实战
📚 学习内容
强化学习基础讲解:马尔可夫决策过程,价值函数,贝尔曼最优方程
讲解两种估计方法:蒙特卡洛方法和时序差分(TD)
Value-Based算法讲解:DQN模型和过估计的问题
Policy-Based算法讲解:Policy Gradient,REINFORCE,手写推导策略梯度公式
Actor-Critic算法讲解:PPO模型的前世今生,从TRPO,重要性采样,GAE,PPO-penaty,到PPO-clip
讲解直接偏好优化DPO,以及两个代表性改进算法ORPO和APO
案例实战:中期训练和SFT后,实现Qwen3模型的DPO后训练对齐
案例实战:基于Phi4+DPO的广告文案生成优化实战
🚀 解锁技能
✅ 从原理上吃透RL,而不是强背八股,DPO算法能现场推导,模型来龙去脉完全口述。
✅ 学会真实场景下如何构建 DPO 的 pair 数据,掌握 DPO 后训练实战能力。
阶段7:LLM + RL 后训练精讲与实战
📚 学习内容
RLHF-PPO讲解,从奖励模型训练,ORM,PRM 讲到 RLHF
RLHF-GRPO讲解,GRPO的改进,K3估计,GRPO训练加速
深入讲解 Deepseek-R1-ZeRO 和 Deepseek-R1 算法原理
讲解 GRPO 的后续优化:DAPO,GSPO,SAPO算法
讲解左右互搏 Self-Play:R-Zero算法从原理到源码,以及改进方向
讲解大模型蒸馏,从 offline 蒸馏到 online 强化蒸馏,从 GKD/ULD 到 GOLD 算法优化
源码带读:阅读 Transformers TRL库的 GOLD 源码
代码手撕:Reward Model,PPO、GRPO、DAPO、GSPO,On-Policy RL Distillation
阶段实战:Qwen+GRPO后训练实现复杂医疗推理和疾病诊断
🚀 解锁技能
✅ 从原理→代码→优化,彻底吃透大模型 RL 后训练。掌握 Self-play,在线强化知识蒸馏等技术。
✅ 掌握奖励模型以及 RLVR 的设计,能用 GRPO 动手完成一个真实数据的模型后训练
阶段8:Agent应用开发精讲与实战
📚 学习内容
Agent三大经典范式:ReAct,Relection,Plan-And-Solve
LangChain/LangGraph实战:从StateGraph,Midleware,Memory 到 Multi-Agent
实战 Agent RAG、GraphRAG、 多模态RAG
Agent 进阶技术:从上下文工程到 MCP、A2A、ANP
深入拆解“龙虾”背后的技术:Agent Skills
手把手带你开发MCP Server 和 Client,如何写好Skills
个性化 Memory 如何管理,有哪些方式,上下文压缩和隔离
DeepResearch核心原理,从零到一实现一个DeepResearch
源码带读:深入阅读 DeepAgents 底层源码
阶段通关:基于 DeepAgents+Skills 的 Text2SQL 实战
🚀 解锁技能
✅ 深入理解 Agent 技术 ,能够自己设计并实现一个复杂 Agent
✅ 掌握 Agent 框架核心源码,面试核心竞争力
项目实战:构建自进化+对抗降噪的DeepResearch Agent
📝 项目介绍
✅ 项目背景:项目源于企业里的Agent系统实战,技术栈囊括多Agent编排,Planning,长上下文压缩,跨Agent memory管理,红蓝对抗,文本降噪等最新Agent实战技术
✅ 讲解形式:先讲整体架构,再分模块讲解。每个模块采用图解设计思路+现场手写代码的方式,边写边讲实现思路,杜绝念PPT、念代码
✅ 项目收获:学完可作为真实 Agent 项目经验,拿下大模型应用岗offer
📚 学习内容
✅ 多Agent系统设计实现:多Agent架构 :Supervisor+Research Agents + 对抗Agent
✅ 报告提纲生成:意图理解,生成报告大纲和研究简报
✅ Supervisor+Planning: 任务规划,Task分解和委派Sub-Agents
✅ Researcher Agent:进入ReAct Loop,URL去重,调用web工具,执行深度研究
✅ 上下文管理压缩:抽取摘要,压缩Research Notes,实现长上下文Auto-Compact
✅ 红蓝对抗:引入对抗Agent,找出行文逻辑漏洞 & 关键信息缺失,降低报告噪声和幻觉
✅ 报告质量评估:综合多维度得分,打分意见进入主循环,实现自进化
🚀 项目收获
✅ 掌握复杂Agent & Mult-Agent系统的设计能力,大模型应用岗 & Agent 开发岗必备
✅ 掌握如何定制研发一个成熟的Agent产品,hold住实际项目中的各种大小"坑"
项目实战:基于Qwen3-VL后训练的智慧寻车项目
🎯 项目介绍
本项目是一个真实项目,训练数据都是真实的,对应产品已在公司上线。
项目流程包括数据在线降噪,SFT冷启动微调,难样本挖掘,DPO/KTO后训练对齐,指标调优过程,benckmark测试
最终识别效果跟现在 Top 商业多模态大模型对比,各方面指标均远高于 Gemini /豆包/ Qwen(课程最后会做效果评测)。
模型可部署端侧,实现低显存占用,低FLOPS和高吞吐serving能力
🚀 项目收获
完整实战公司做多模态大模型后训练项目流程,从数据质量优化,数据配比,到SFT冷启动,难样本挖掘,到DPO/KTO调优,每一步是怎么做的。
吸收我在项目过程中踩过的坑,积累你在面试中的核心竞争力,真实线上问题,是面试官最兴趣的部分。
学完可作为真实多模态项目经验,拿下大模型和多模态岗offer
🔍 项目讲解
业务背景:首先讲清楚为什么有这个项目,会用到哪些场景,具体如何应用。
模型选型:分析现有SOTA模型的优劣,当前业务场景要考虑哪些因素,有哪些限制,以及为什么要选它。
Qwen3-VL的原理:对核心的vision encoder,merger,deepstack,以及Interleaved-MRoPE做细致拆解,确保没有学过多模态的同学也可以看懂。
项目数据集:讲数据的分布,正负样本的混合比例,这份数据的挑战性在哪,以及在其他成熟OCR模型上的测试结论分析。
架构设计:讲清楚项目整体架构设计思路,本项目核心要解决的问题,以及针对这些问题是怎么去做的。
代码实操:老规矩,从0到1,从第一行代码开始,一步步添砖加瓦,把整个项目开发完成。模块级开发,模块级测试,最后端到端联调。
项目评测:最终模型后训练完成后,会和现在最先进的多模态大模型在同一份测试集上做横向对比,从多维度指标的提升来验证我们最终的效果。
最终的历练:基于端到端Agentic RL构建出行规划场景下的Long-Horizon Agent
🎯 项目介绍
✅ 项目以真实出行规划为背景,通过RL提升Agent在复杂环境(8个工具调用)多约束(2~5个)下的任务规划与执行能力
✅ 真实工具接口,高德POI搜索,周边搜,路径规划,Google 搜索 ,Tavily等多种查询工具
✅ 实现Long Horizon Agents(长程智能体),最高可达50次工具调用
✅ 真正意义的从零到一:数据构建,格式修复和校验,打分清洗,数据筛选,冷启动,Agentic RL分布式后训练,指标评估等全部流程
✅ 完全端到端的强化学习agent模型优化,超长上下文+混合多工具调用使得任务极具挑战性
✅ 学完可作为真实 Agentic RL 项目经验,拿下大模型算法岗offer
🔍 项目讲解
✅ 数据构建:数据是后训练最重要的一环,如果跑现成开源数据,虽然省去了实际研发过程中70%的工作量,但毫无意义。所以这里我会带大家,从无到有构建数据。
✅ 数据过滤和筛选:企业标准的漏斗式过滤准则,多级过滤和数据修复,先验rule+模型打分结合的方式,最终产出一份高质量后训练数据。
✅ 工具环境构建:
每个工具如何实现,如何申请key,以及key的验证
大规模调用下为提升RL环境稳定性,如何实现多key轮训、重试机制、工具batch调用
从提高工程效率角度做代码演示和一步步验证,注重可落地性
✅ 数据rollout:
讲解多轮工具如何调用
对于边界case,超出max长度上下文,tools调用失败等各种异常问题如何处理
✅ 冷启动:
筛选一批高质量的数据去continue 训练模型
结合多卡分布式训练(8卡A100 / H800 / Pro6000),快速拿到实验结果,并做训练后模型验证
【数据这里到时候会重点讲踩过的一个坑,我会讲到是怎么发现这个问题,又是怎么解决的,这绝对是你是否亲手做过真实后训练的分水岭,靠编是编不出来的】
✅ Agentic 后训练:采用异步强化学习框架多卡训练,最大化训练效率,实现online RL。
RL阶段的训练数据如何挑选,和SFT冷启动阶段有何不同。
如何设计复合reward,推理过程奖励+结果奖励,另外开放域判别(非数学/代码这种有确定性答案)无疑是给项目增加了挑战,如何克服这个问题。
稳定训练的技巧,训练前期,中后期的reward重心如何调整
✅ 代码实现:从安装环境开始,一步步带你做完这个大项目。每讲完一个模块就去项目环境进行代码实操,实操的同时讲实现思路,现场训练模型,展示我训练后的结果,最后去测试验证。
📝 项目题库
✅ 这部分讲解会采用大厂面试的连环炮风格,多轮拷问,深挖细节。
✅ agentic RL有很多细节可以深挖,比如:
数据部分:如何构建高质量的数据,有哪些必备的清洗策略和trick
Reward设计:如何高效对齐目标,同时又要能避免Reward hacking
模型训练:这块甚至可能牵出对算法原理的理解和优化,最新的论文工作,工程实现上的优化,同步/异步解耦/buffer/流水线/延迟梯度等等
🚀 项目收获
做大模型算法必须掌握 Agentic RL,而不是停留在背八股,跑开源数据。你需要在真实场景下,从零到一去自己动手实战,本项目可以帮你完整实现。
你的真实场景 RL 建模能力,数据&算法实战能力、架构设计能力、后训练调优设计能力会达到另一个Level,校招/社招降维打击
💁 训练营服务
🎯 1v1 简历和面试辅导
学到这里,你已经扎实掌握了课程技术和项目,积累了一身雄厚的"内力"。那接下来,就是如何把这一身功力展现出来。
我会从简历、算法、八股、项目四个方向,手把手带你把会的东西,变成实实在在的 offer。
✅ 简历优化:如何把技术和项目"高大上"的包装到简历,让面试官眼前一亮。
✅ 力扣算法题:大厂高频题路径,该刷哪些、怎么刷,不做无用功。
✅ 大模型八股:精选500+道面试真题,直接瞄准高频考点,不用大海捞针。
✅ 大模型项目:项目怎么写、怎么讲、面试官会追问什么,提前准备好,面试时心里有底。
🎯 1v1答疑辅导
✅ 学的过程中卡住很正常,尤其基础薄弱的同学,有时候一个问题能卡一两天,自己死磕效率极低。但实际上,很多问题有人指点,一捅就破。1V1答疑的好处就是我能帮你快速定位问题、答疑解惑,避免一个小卡点拖慢你的整体进度。
🎯 1v1 职业发展规划
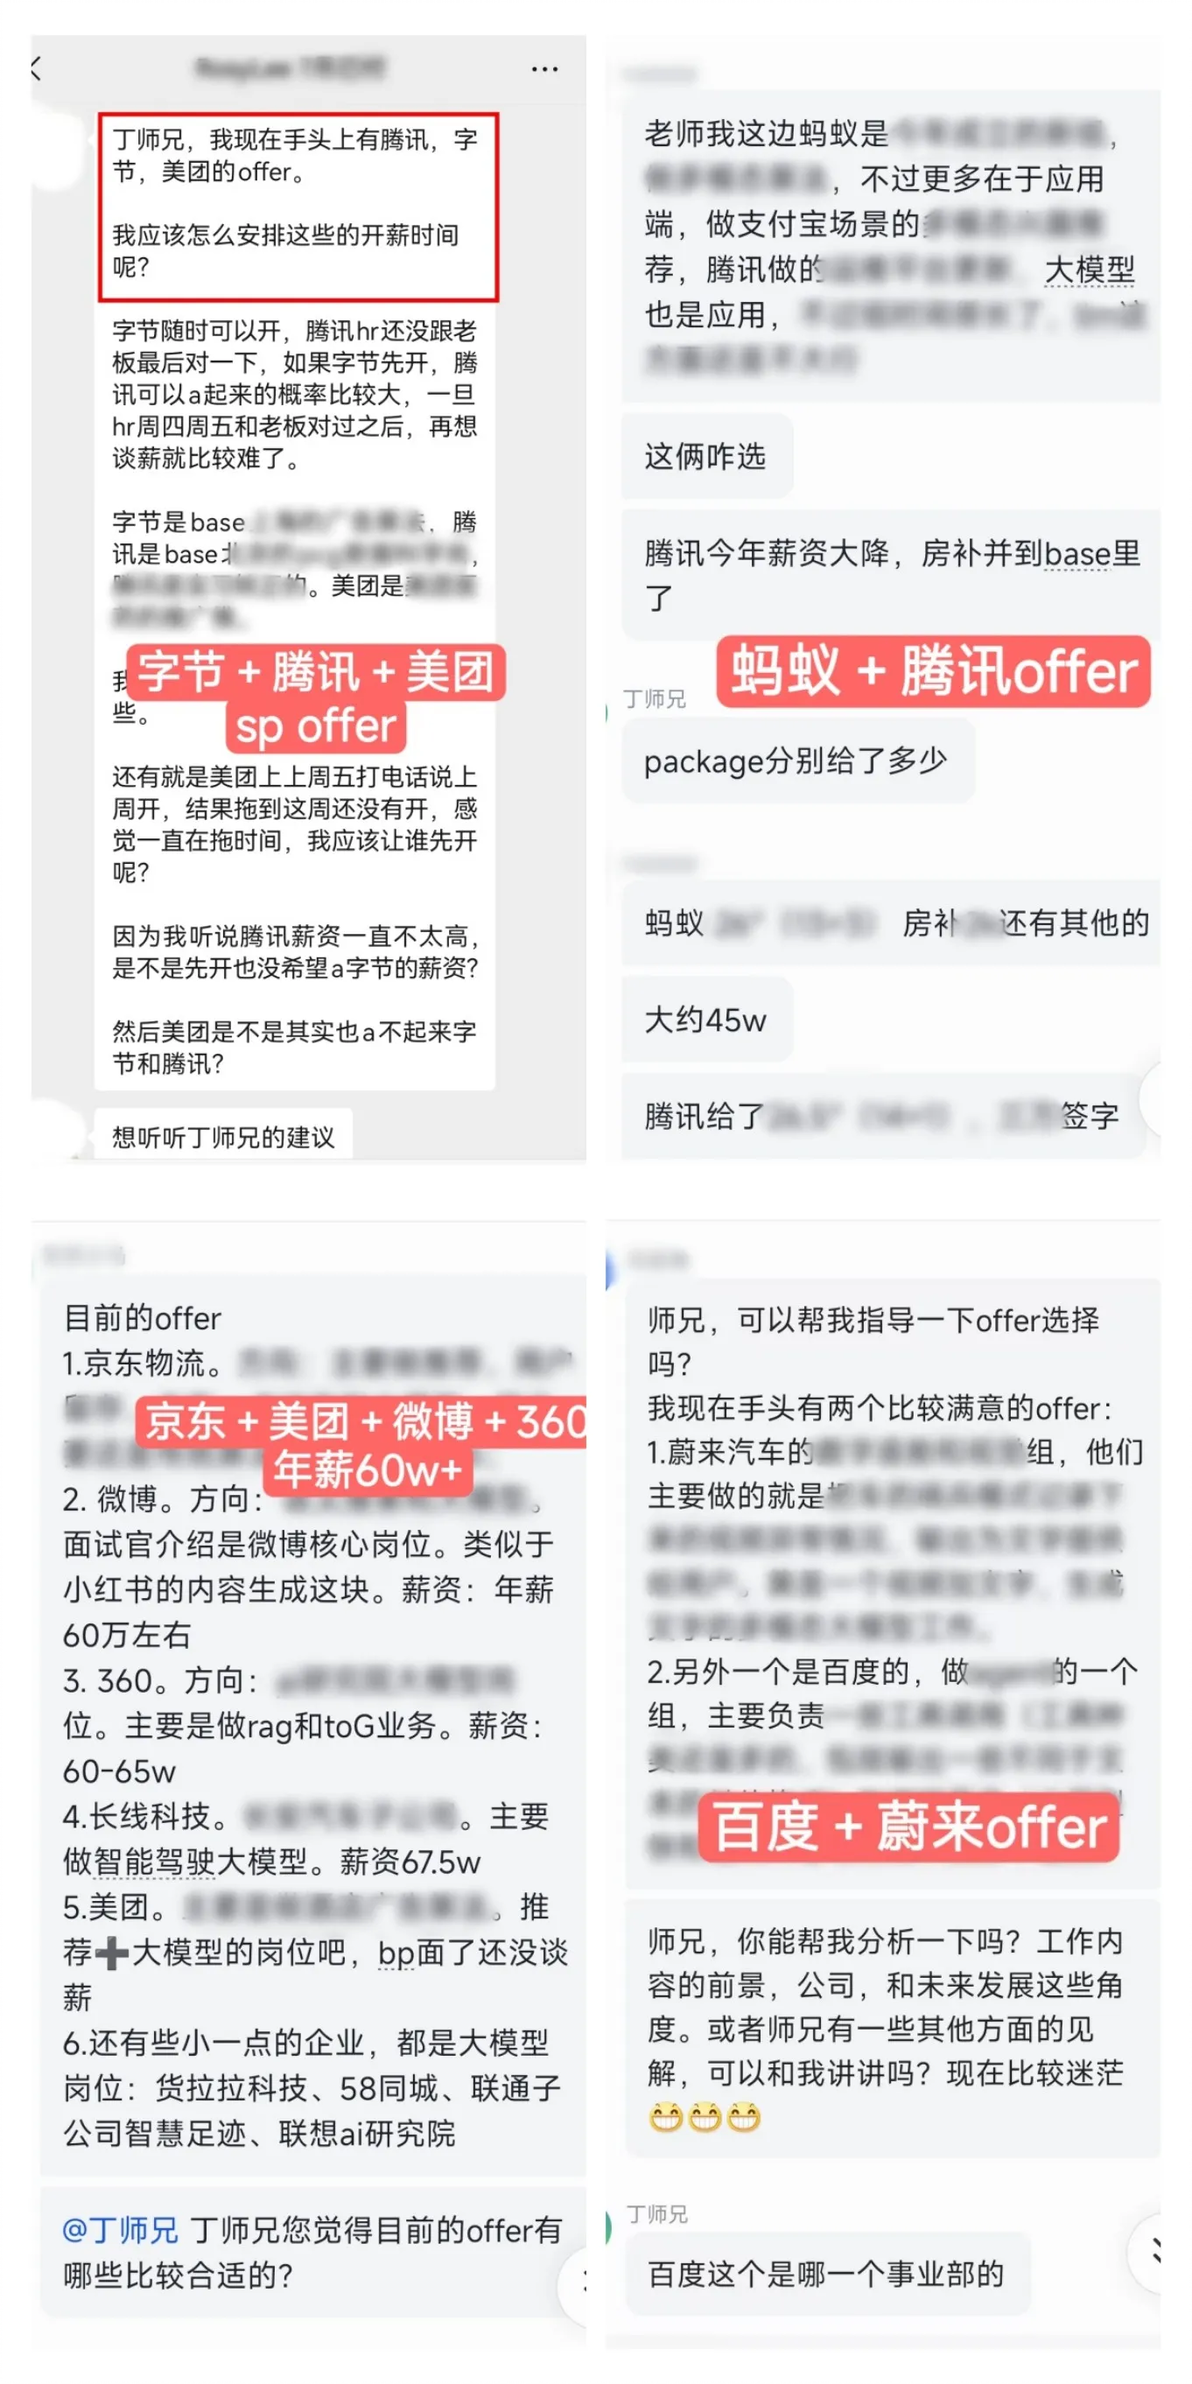
✅ 除了学习上的指导,一些职业发展规划的问题也可以问我,比如最重要的,怎么选offer?
✅ 我的建议可能会让你少走很多弯路,避开一些大坑,以下是部分学员的offer选择咨询:
🏆 目前取得的成果
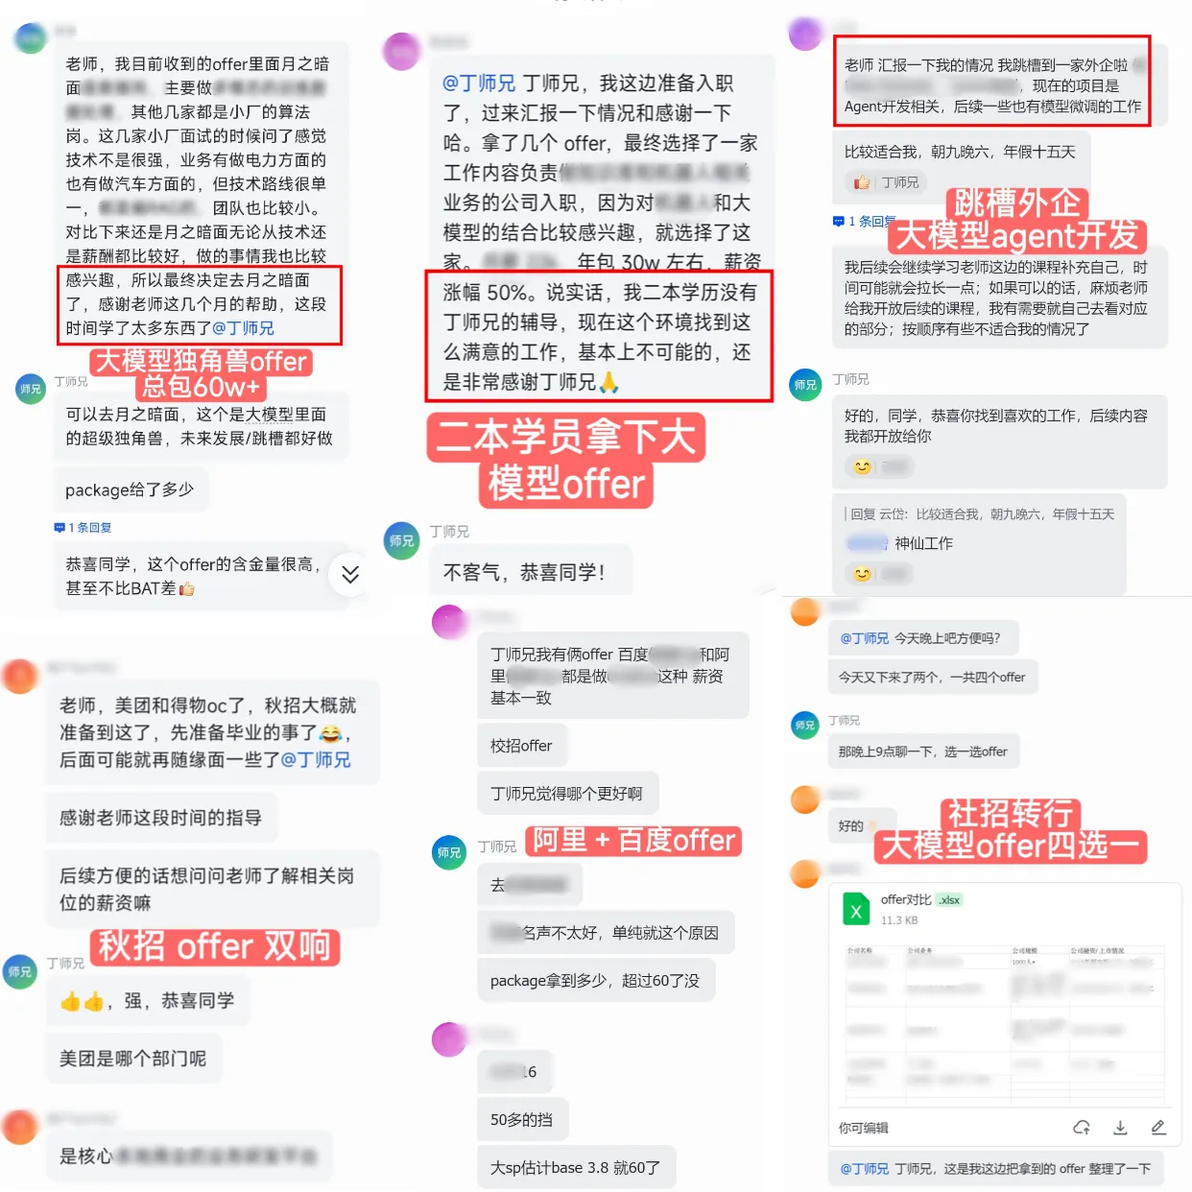
✅ 目前已帮助大量学员成功拿到 offer,不少非科班/转行/学历一般的同学,通过自身努力+辅导,成功逆袭,进入大模型赛道。
✅ 学员去向覆盖字节、阿里、腾讯、美团、月之暗面、Meta、华为、小红书、智谱AI、MiniMax、拼多多、京东、小米等国内外中大厂。
部分学员offer:
💡 授课思路 & 课程试看
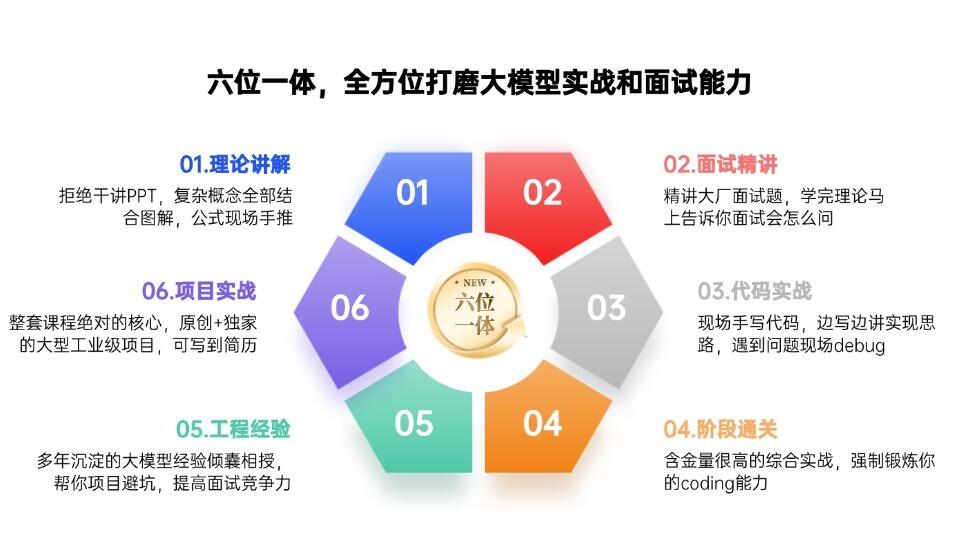
课程采用六位一体的授课思路,包括理论讲解、面试精讲、代码手撕、阶段通关、生产经验、项目实战,全方位打磨你的实战和面试能力。
📖 理论讲解
拒绝传统机构那样对着 PPT 念的形式,复杂概念全部图解,复杂公式现场手推。
🎯 面试精讲
精讲大厂面试题。学完理论,马上告诉你面试会怎么问?如何回答才能和别人拉开差距?
✍️ 代码手撕
我不会像其他机构那样,写好代码对着讲。而是直接带你现场手写代码,边写边讲实现思路,遇到问题现场debug。
🔓 阶段通关
阶段最后的综合实战,含金量放在其他机构都可以作为一个项目,但在我这边只是前菜,真正的"项目大餐"还在后面。
💼 生产经验
我会讲我们在做项目的时候,踩过的坑,遇到的问题,尝试的思路,解决的方案。
🚀 工业级项目
整套课程绝对的核心,项目都是原创独家的大型工业级项目,绝非市面上的demo。
项目讲解延续之前的风格,核心代码全部手写。
⭐ 导师介绍
✅ 10年工作经验,前阿里算法专家。
✅ 现专注于智驾大模型,同时对NLP、强化学习、对话识别、多模态内容理解,也有大量实战经验。
🎯 课程适合谁?
⚠️ 非科班出身,自学大模型感觉杂乱无章、没有方向。
⚠️ 学历一般,简历过不了筛,需要靠硬核项目来弥补差距。
⚠️ 做过一些网上的demo项目,但面试时一被深挖就扛不住。
⚠️ 简历含金量不够,投出去总挂,需要做针对性打磨深挖。
✍️ 写在最后
✅ 课程不是银弹,不是报名就拿到了大模型入场券,即便是葵花宝典,也要花时间炼化。
✅ 这个时代人人都在追速成,但学习恰恰是不能速成的。我只能保证你整个学习不走弯路,但该你走的路,该你积累沉淀的地方,一处也不能少。
✅ 如果你抱着速成心态,希望像某些机构宣传那样,两三周就拿到结果,那么抱歉,本课程不适合你
✅ 但如果你愿意坚持,能沉下心来,按我规划吃透每个技术点、面试题、代码、项目。
相信我,这套课程将改变你的命运
☎️ 如何报名
请直接扫码或添加丁师兄微信:dsxaigc,备注【B站】