
😬【AIGC每日新闻】
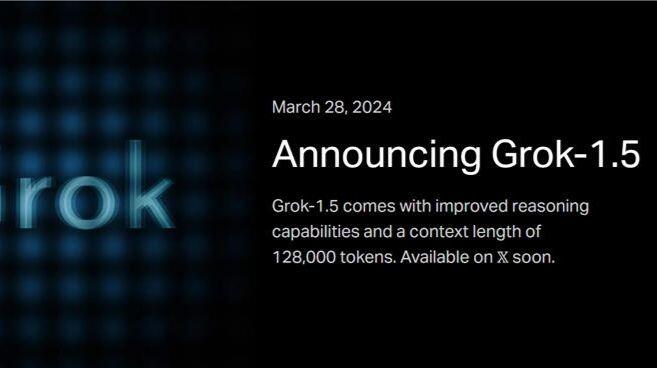
【X.AI推出Grok-1.5,性能大幅提升】X.AI宣布推出了Grok-1.5,这款模型的上下文长度达到惊人的128k,不久将在X平台上提供服务。在多项基准测试中,Grok-1.5展现出卓越的性能:在MATH基准测试中达到了50.6%的得分,是上一代成绩的两倍,且接近GPT-4等顶尖模型的水平。在HumanEval基准测试中,以74.1%的得分超越除Claude 3 Opus以外的所有模型。而在GSM8K基准测试中,更是取得了90%的成绩,优于Mistral Large、Claude 2等模型。在MMLU测验中,Grok-1.5获得了81.3%的成绩,这表明该模型在理解各种语言任务上的能力有了显著提高。此外,Grok-1.5还展现出强大的文本内嵌检索技术,能够在高达128k标记长度的文本中实现精确检索,进一步确认了其AI领域的领先地位。参考博客链接:https://x.ai/blog/grok-1.5
【阿里巴巴发布Qwen1.5-MoE-A2.7B模型,性能媲美7B模型】阿里巴巴Qwen团队近日发布了新型人工智能模型Qwen1.5-MoE-A2.7B。这一MoE(Mixture of Experts)模型虽然仅拥有27亿激活参数,它却在一系列基准评估中达到了7亿参数模型的性能水平。更值得一提的是,与7亿参数模型相比,Qwen1.5-MoE-A2.7B在训练成本和推理速度方面都有显著优势,这标志着在成本和效率上取得了重大突破。参考博客链接:https://x.com/Alibaba_Qwen/status/1773371904679608700?s=20
【AI21推出首个生产级Mamba模型Jamba,技术结构先进】AI21宣布正式推出了世界首个Mamba生产级人工智能模型:Jamba。这一模型采用了革新的SSM-Transformer架构,是一次在模型设计上的重大创新。总结其特点,它具有52B的参数规模,在生成时有12B参数处于活动状态;在其生成过程中的16位「专家」中,仅有2位处于活跃状态。Jamba融合了所谓的Joint Attention机制和Mamba技术,支持长达256K标记长度的上下文理解能力。更令人印象深刻的是,在一台搭载A100 80GB显存的单个计算单元上,它最多可容纳140K标记长度的上下文。性能方面,与Mixtral 8x7B模型相比,在处理长上下文时,Jamba模型的吞吐量提高了3倍。Jamba的设计目标是弥补纯SSM模型在处理复杂模式时的不足,并保持Transformer在处理复杂语言模式和依赖关系上的强大能力。这样的结合使得Jamba在处理长序列数据时既高效又能保持高度理解能力,对自然语言处理领域来说无疑是一次突破。参考博客链接:https://www.ai21.com/blog/announcing-jamba 😻【今日份Prompt技巧】 When you need clarity or a deeper understanding of a topic, idea, or any piece of information, utilize the following prompts: -Explain [insert specific topic] in simple terms.当您需要清晰或更深入地理解某个主题、想法或任何信息时,请利用以下提示: - 用简单的术语解释[插入特定主题]。
