


AI-GitHub,分享GitHub上有趣、实用的AI开源项目。
小编为大家梳理了本周最受大家欢迎的AI-GitHub开源项目。
1. 想动哪里点哪里!创新图生视频模型“Follow Your Click”开源!
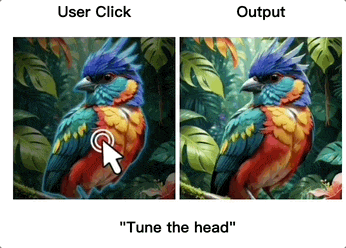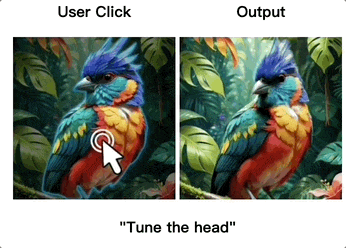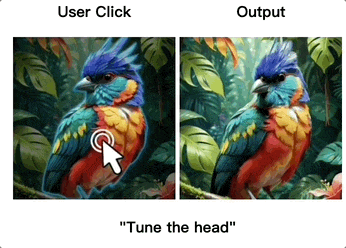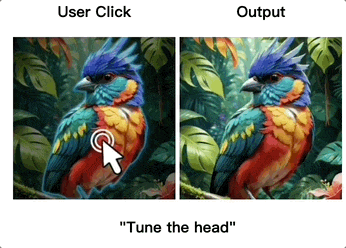
腾讯混元、清华大学和香港科技大学联合推出了新的图生视频模型Follow-Your-Click。
其操作方法非常简单。用户将任意一张照片输入模型,只需点击对应区域,加上少量简单的提示词,就可以让图片中原本静态的区域动起来,一键转换成视频。
项目主页:https://follow-your-click.github.io/
论文链接:https://arxiv.org/pdf/2403.08268.pdf
GitHub:https://github.com/mayuelala/FollowYourClick
2. 马斯克说到做到!自研3140亿参数的巨无霸模型Grok已开源!
3月18日凌晨,马斯克的人工智能初创公司 xAI 迈出了重大一步,开源了其大型语言模型Grok。
目前,Grok的代码和模型权重已上线GitHub。官方信息显示,此次开源的Grok-1参数量达到了3140亿,远超OpenAI GPT-3.5的1750亿。是当前的开源模型中参数量最大的一个。
Grok-1采用的是Apache 2.0 license,这意味着企业家、程序员、公司和个人现在可以访问 Grok 的权重和文档,从而允许他们将该模型的副本用于各种目的,包括商业应用。
开源地址:https://github.com/xai-org/grok-1
官网地址:https://x.ai/blog/grok-os
3. 一键生成原创BGM!图像转音乐AI爆火出圈!
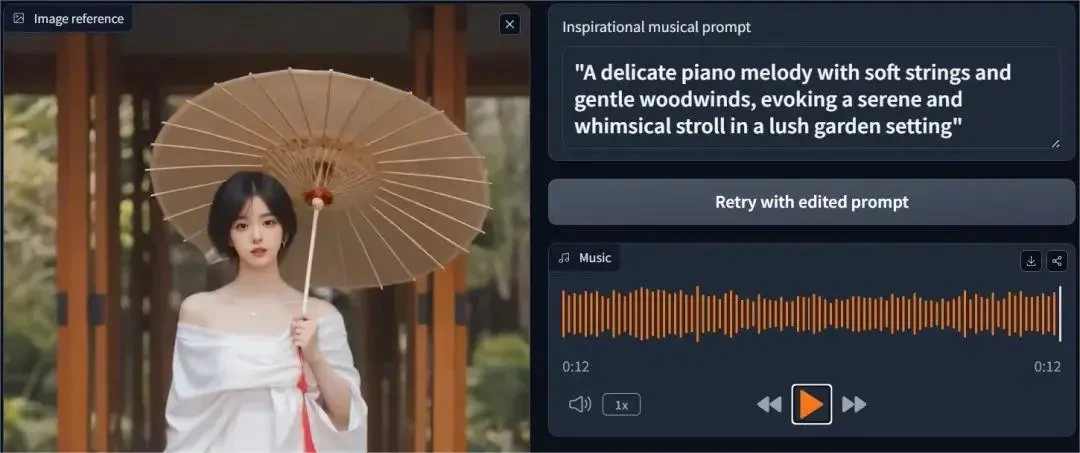
Image to Music V2是一款将图像转换为音乐的生成AI工具,用户只需上传一张图片,就可生成一段时长一分钟的音乐片段。
这款应用还为用户提供了不同的音乐生成模型供其选择,网站预设有布鲁斯、EDM、吉他、钢琴、管弦乐、爵士乐等各种音乐风格,不同提示词配上不同的风格,就能得到各式风味的原创音乐。可以更好地匹配个人喜好和创作需求,提供个性化的音乐创作体验。
体验地址:https://huggingface.co/spaces/fffiloni/image-to-music-v2
开源地址:https://huggingface.co/posts/fffiloni/484223631728087
4. 全球首个类Sora视频生成模型开源!两天斩获6.5k星!
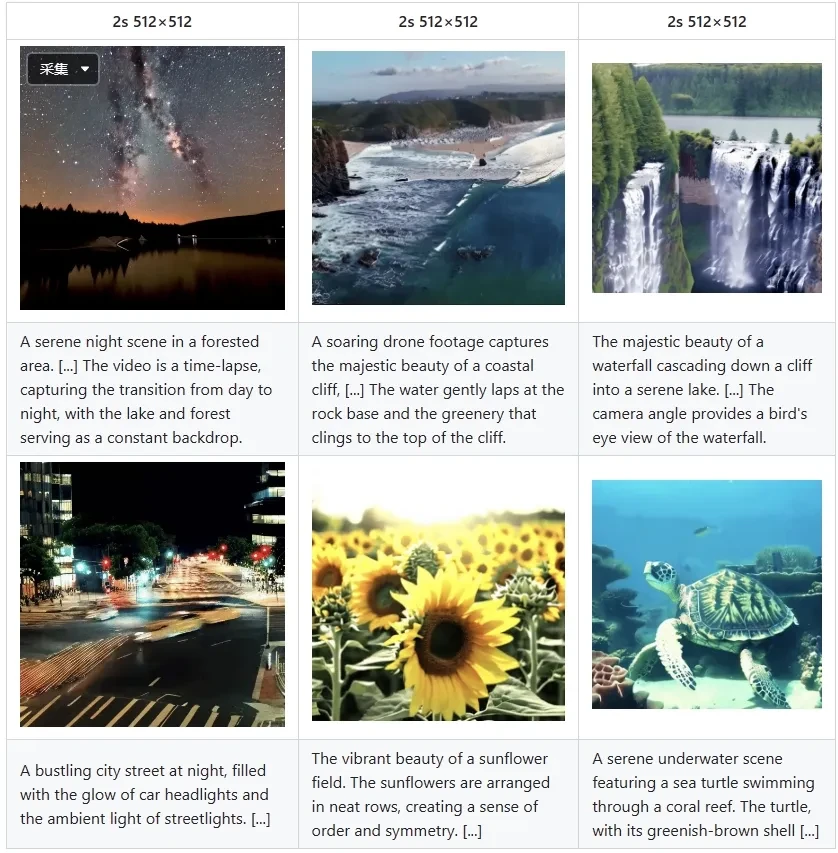
Colossal-AI团队开源全球首个类Sora架构视频生成模型「Open-Sora 1.0」。本次开源的内容涵盖了整个训练流程,包括数据处理、训练细节和模型权重。
模型支持完整的视频数据预处理、加速训练、推理等,只需 3 天的培训即可制作 2 秒 512x512 视频。
开源地址:https://github.com/hpcaitech/Open-Sora
5. 百变人像:cog-become-image!
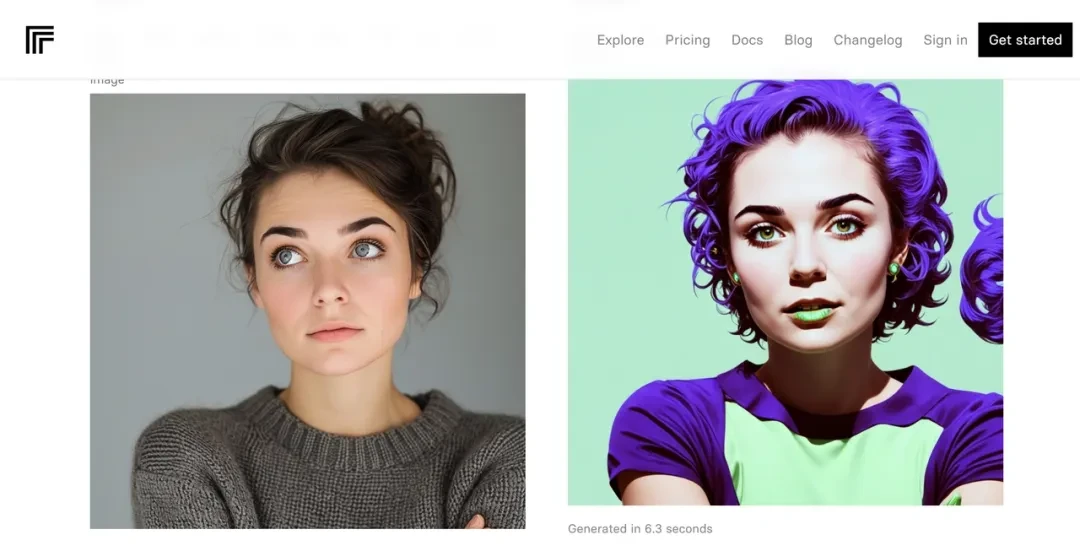
输入一张包含人脸的图片,再选择另一张带有风格的图片,就可以把原始图片转成符合风格图片的样子。
用户可以根据需求调节各种参数,如保留原始人脸图像的程度、强度控制以及样式应用等,当然也支持输入提示词,辅助风格化结果的生成,从而定制出符合个人需求的图片。
体验地址:https://replicate.com/fofr/become-image
开源地址:https://github.com/fofr/cog-become-image
6. 网易有道开源的本地化知识库!像 "chatgpt" 一样的体验!
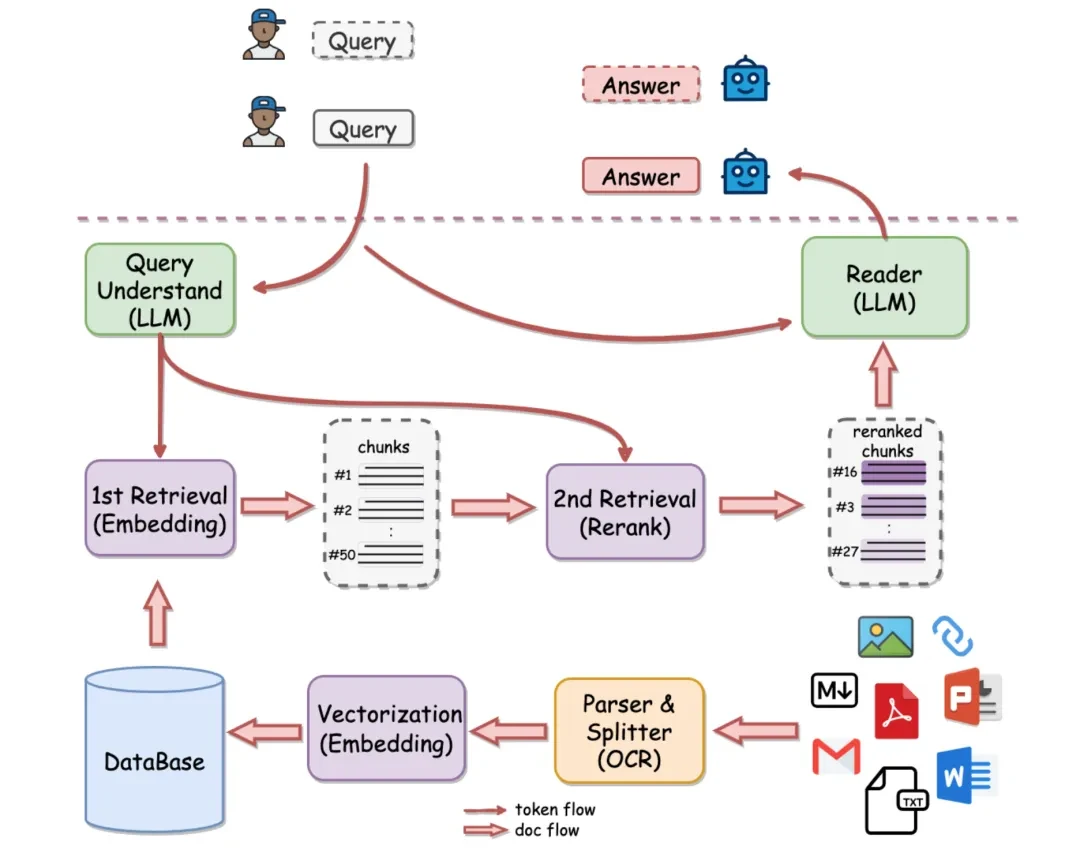
网易有道开源了其RAG引擎QAnything,这一举措使用户能够像使用"chatgpt"一样,通过传入各种类型的文档,如doc、pdf、图片、ppt、excel等,进行问答。
该开源项目包含了embedding、rerank、LLM和向量数据库等所有必要的模型和系统模块,用户可以轻松地一键下载,并在本地搭建一个强大的大模型问答系统,随时开始使用。
开源地址:https://github.com/netease-youdao/QAnything/releases/tag/v1.1.0
7. 开源视频神器NewPipe!海量视频手机观看!已获28.1k星!
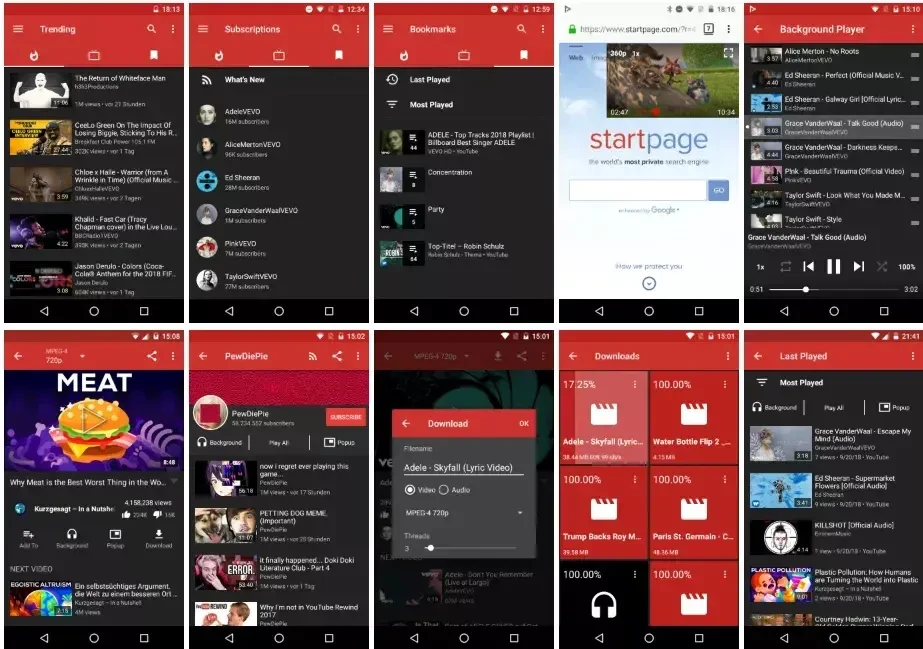
NewPipe是一个开源的、轻量级的、用于Android 的YouTube视频和音乐流媒体播放器。该播放器在没有Google服务的设备上也能运行。占用系统资源极少,适合资源有限的设备。还具备去广告和离线观看的便捷操作。
官网地址:https://ostechnix.com/newpipe-a-lightweight-open-source-youtube-client-for-android/
开源地址:https://github.com/TeamNewPipe/NewPipe
8. 清华大学计算机系课程攻略!程序员们的福音来了!已获31.7k星!
计算机都要学哪些课程,有什么先后顺序,如何快速持续的提高技术水平?
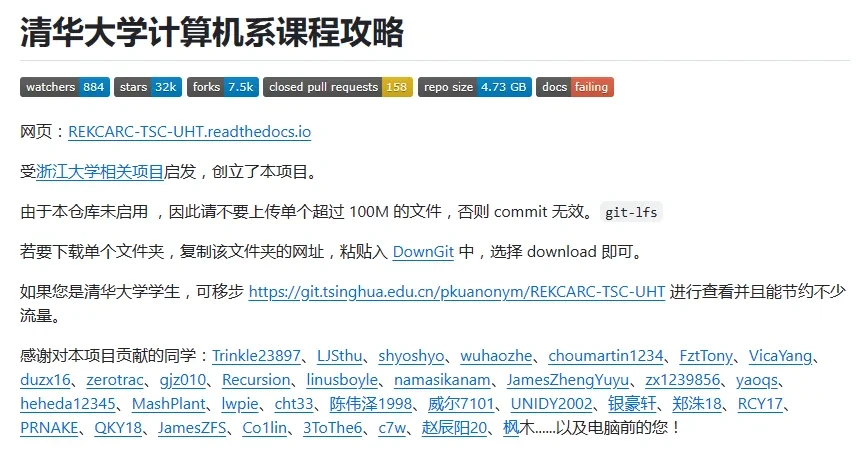
有类似疑问的小伙伴,可以一起来看看Github上的清华大学计算机系课程攻略。
提供了大量有关课程的资料和学习方法,里面包含了清华CS专业,大一到大四的课程以及推荐书籍资源等。同时欢迎学生们贡献内容来提升资源的完整性和质量。
今天你学习了吗?
开源地址:https://github.com/PKUanonym/REKCARC-TSC-UHT
9. 一键翻译漫画文字!二次元福音Manga-image-Translator!
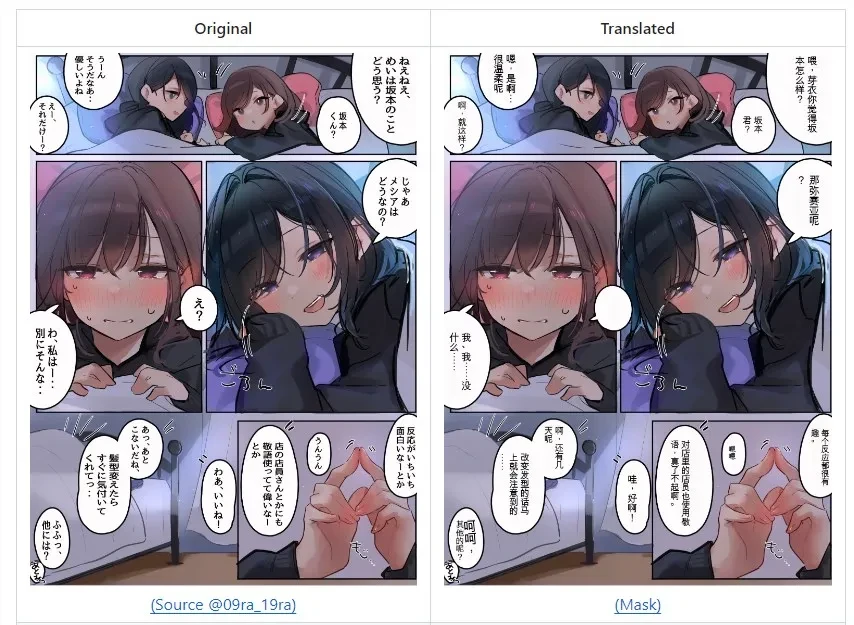
Manga-image-Translator这个开源工具,专门用于翻译漫画或图片中的文字。把所谓生番变成熟番,主要设计用于翻译日语文本,但也支持中文、英语和韩语。利用高效的OCR和AI翻译技术,它能够自动识别和翻译任何图片中的文字,并支持多种语言。该工具不仅可以翻译文字,还可以对去除文字后的区域进行修复和上色,以及重新渲染翻译后的文本。
体验地址:https://cotrans.touhou.ai
开源地址:https://github.com/zyddnys/manga-image-translator GUI版本:https://github.com/dmMaze/BallonsTranslator
10. 免费、强大的笔记软件 !开源笔记本软件Joplin!已获42.3k星!
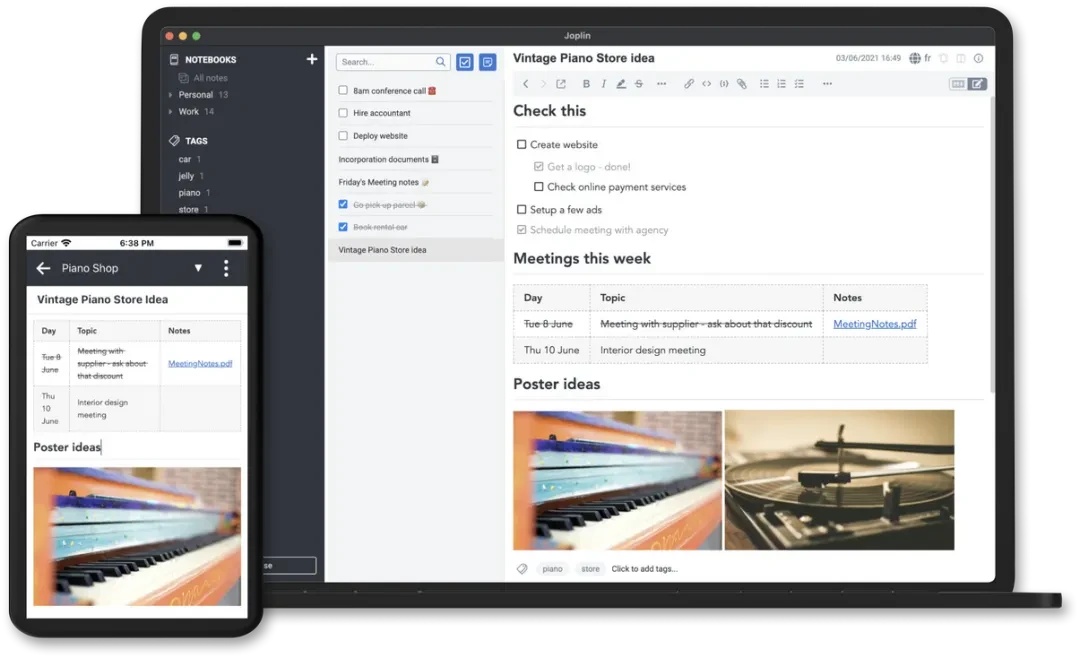
Joplin 是一款免费的开源笔记软件,能够方便地管理待办事项和处理大量笔记。
Joplin的界面非常简单,没有花哨的功能和各式各样的广告。功能出色,支持加密。其数据可以本地保存,也可以选择使用 Dropbox 、OneDrive、 NextCloud 或 WebDAV 来同步你的笔记。
它是跨平台的,可以在 Linux、Windows、macOS、iOS 和 Android 上使用,并且采用 MIT 许可开源。
官网地址:https://joplinapp.org/
开源地址:https://github.com/laurent22/joplin
11. 视频生成速度提升十倍!字节跳动发布AnimateDiff-Lightning!
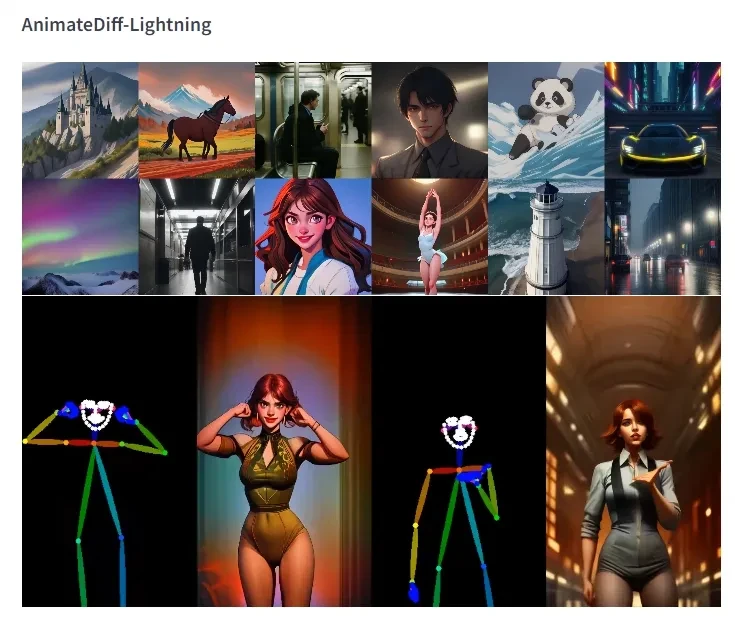
AnimateDiff-Lightning能够更快地根据文本描述生成视频,比起原来的AnimateDiff模型,速度提升十倍以上。除了能够根据文本生成视频之外,AnimateDiff-Lightning还可以进行视频到视频的生成,比如可以将现有视频转换成不同风格的视频,包括真实风格和动漫卡通风格等等。
此外,AnimateDiff-Lightning还支持多步骤蒸馏模型,用户根据自己的需求,在生成视频的速度和质量之间做出选择,以平衡生成速度和视频质量。
开源地址:https://huggingface.co/ByteDance/AnimateDiff-Lightning
论文地址:https://arxiv.org/html/2403.12706v1
12. 真正的神笔马良!AI实时绘画系统发布!
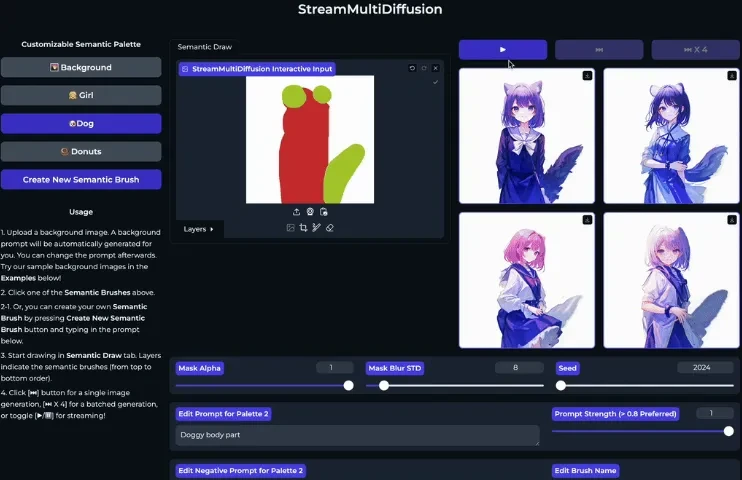
Stream Multi Diffusion是一个实时、交互、多文本到图像生成平台。
用户可以即时的与系统交互,并通过在多个特定区域内分别输入不同的文本提示来指导AI画图。
例如,用户可以在红色区域生成人物,在耳朵和尾巴区域标记为狗,系统就会根据涂抹的区域生成长着狗狗耳朵和尾巴的人物。
体验地址:https://huggingface.co/spaces/ironjr/SemanticPalette
开源地址:https://github.com/ironjr/StreamMultiDiffusion?tab=readme-ov-file
论文地址:https://arxiv.org/abs/2403.09055
13. 会议画图神器!70.7k星的开源白板工具!
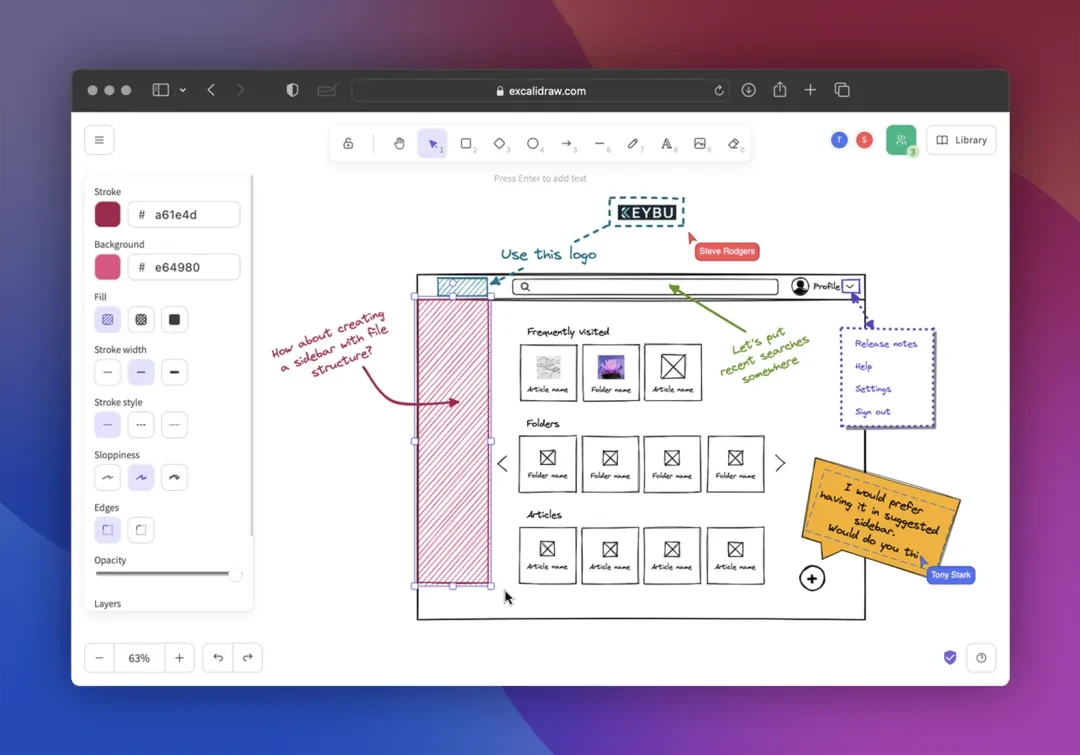
Excalidraw 是一款手绘风格的白板 Web 应用。无论是 Windows / macOS / linux还是手机,打开浏览器就能使用,它能简单地画出美观漂亮的流程图、示意图和开发架构图等常用图片,也可以作为会议画板使用。提供了自由绘制、多种工具、导出 PNG、实时协作、共享链接、自动保存等多种功能。
简单好用,有画图界的 Markdown 之称。
开源地址:https://github.com/excalidraw/excalidraw
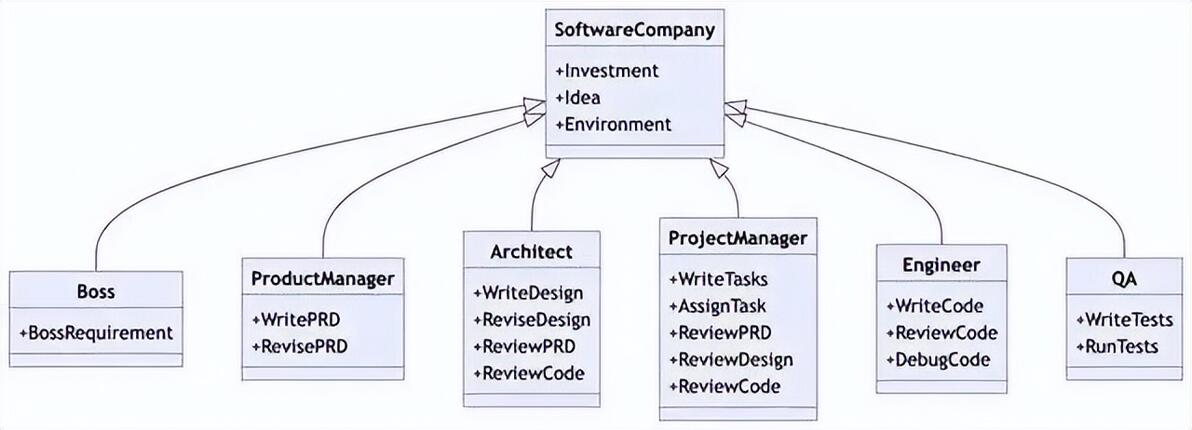
14. Github 3W+⭐️项目:以GPT模型为基础,实现AI驱动的元编程技术! MetaGPT是由geekan团队主导研发的一款基于GPT模型的元编程框架。它旨在利用大规模预训练模型的能力,通过理解、生成和优化代码,推动AI在编程领域的自动化与智能化进程。 开源地址:https://gitcode.com/geekan/MetaGPT
15. AnimateDiff!成熟的图生视频sd插件!sora用不了可以先用这个替代! 扩展文生图模型生成动画的框架-AnimateDiff AnimateDiff是由上海人工智能实验室、香港中文大学和斯坦福大学的研究人员推出的一款将个性化的文本到图像模型扩展为动画生成器的框架,其核心在于它能够利用从大规模视频数据集中学习到的运动先验知识,可以作为 Stable Diffusion 文生图模型的插件,允许用户将静态图像转换为动态动画。该框架的目的是简化动画生成的过程,使得用户能够通过文本描述来控制动画的内容和风格,而无需进行特定的模型调优。 体验地址:https://huggingface.co/spaces/guoyww/AnimateDiff 开源地址:https://github.com/guoyww/animatediff 项目主页:https://animatediff.github.io
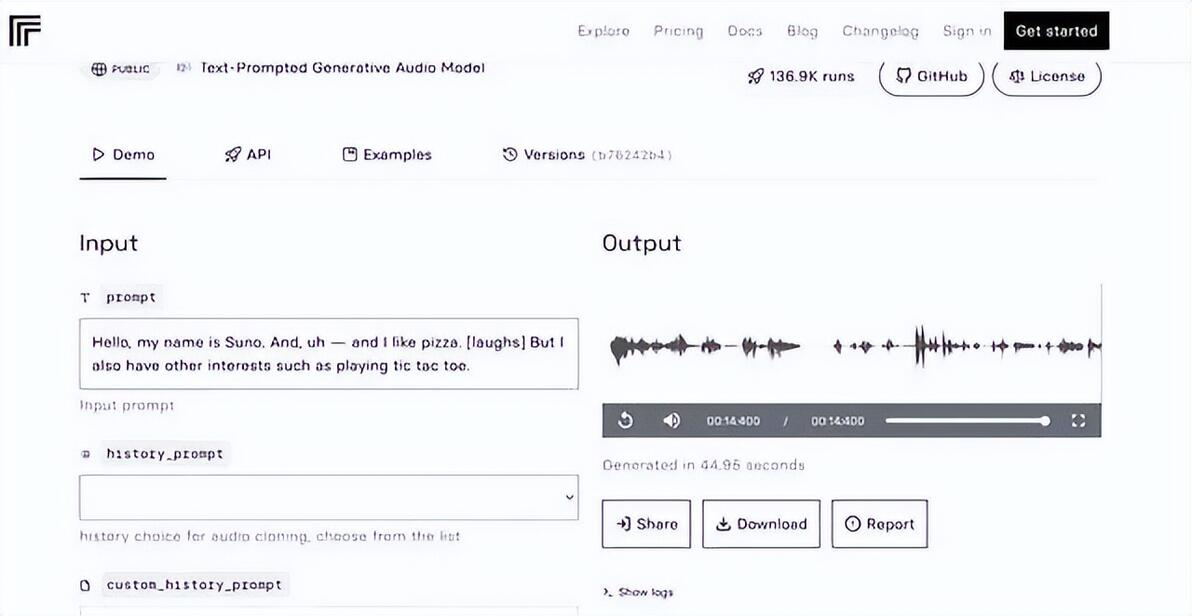
开源后已2.5w星!这款开源的文字转语音的AI项目太牛了! bark模型来自一家专门从事音频人工智能研发的公司suno,它能够生成高度逼真的多语言语音以及其他音频,包括音乐、背景噪音和简单的音效。此外,该模型还可以产生非语言交流,例如笑声、叹息和哭泣等,效果接近真人的表现。自推出以来备受关注,目前已经在GitHub上获得了超过2.5万赞。尽管试用过程中可能会有一些金属音的问题,但相对于其他音频模型而言,其效果有了显著提升。 体验地址1:https://huggingface.co/spaces/suno/bark 体验地址2:https://replicate.com/suno-ai/bark
开源地址:https://github.com/suno-ai/bark
以上就是本周的热点汇总了,有你感兴趣的项目吗?赶快去试试吧!
你对哪些方面的项目感兴趣呢?欢迎在评论区留言噢~
关注AI-GitHub,获取前沿AI资讯。
