
序
近些时候,大语言模型(LLMs)的兴起使得机器翻译领域有了前所未有的快速发展。迄今为止,已经有大量冷门、小众、年代久远的游戏在大语言模型的帮助下有了可用的翻译,这是生成式人工智能为全人类带来的巨大价值的缩影之一。
应当注意到的是,很大一部分翻译补丁使用的是 OpenAI 的 GPT 系列模型。虽然 GPT 系列模型有着强大的通用能力和较为合理的性价比,然而也有显著的缺陷:
对于大量文本,成本仍然是需要考虑的问题。
翻译特殊内容时,容易受到限制,无法或需要特殊技巧绕过。
不具有模型控制权。模型能力的变更不透明。
这些限制为实际使用带来了很大的麻烦。
拥有一个在本地运行的、速度与能力在可接受范围的、无限制的、具有完全控制权的中日翻译模型特化一直是许多了解与关注 Galgame / 轻小说 新作、冷门作品且不熟悉日语的玩家,共同的愿景。
而今天,2024 年 3 月,这个曾经遥远的梦想,也许已经快要迎来,它实现的时候了。
测试模型与免责声明
本测试采用的是当前 Sakura 13B 的最新测试版本:基于 Qwen1.5 微调,具体为:
sakura0.9_13B_Qwen1.5_iq4xs_1.3.gguf · shing3232/Sakura13B-LNovel-v0.9-qwen1.5-GGUF-IMX at main (huggingface.co)
本次测试不是一个经过系统设计的研究,作者也仅具有非常有限的日语支持。模型提示词设计较为简易,更多的是希望为读者展示当前最新模型的一些输出示例,不会有过多的评价。
测试数据与结果
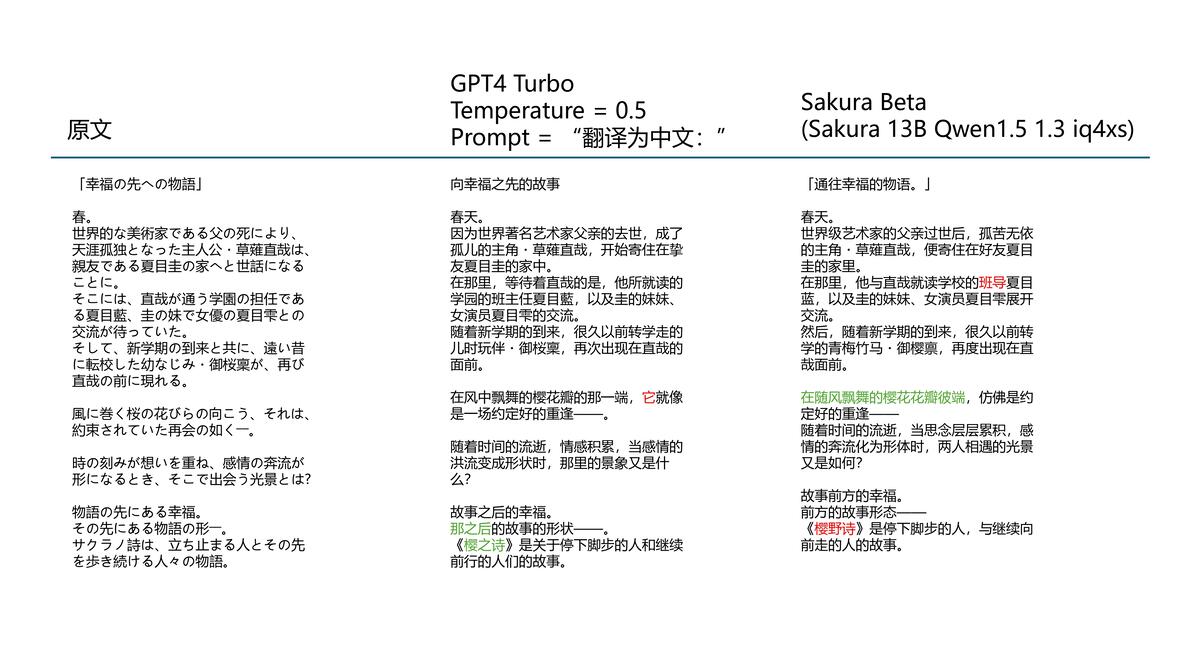
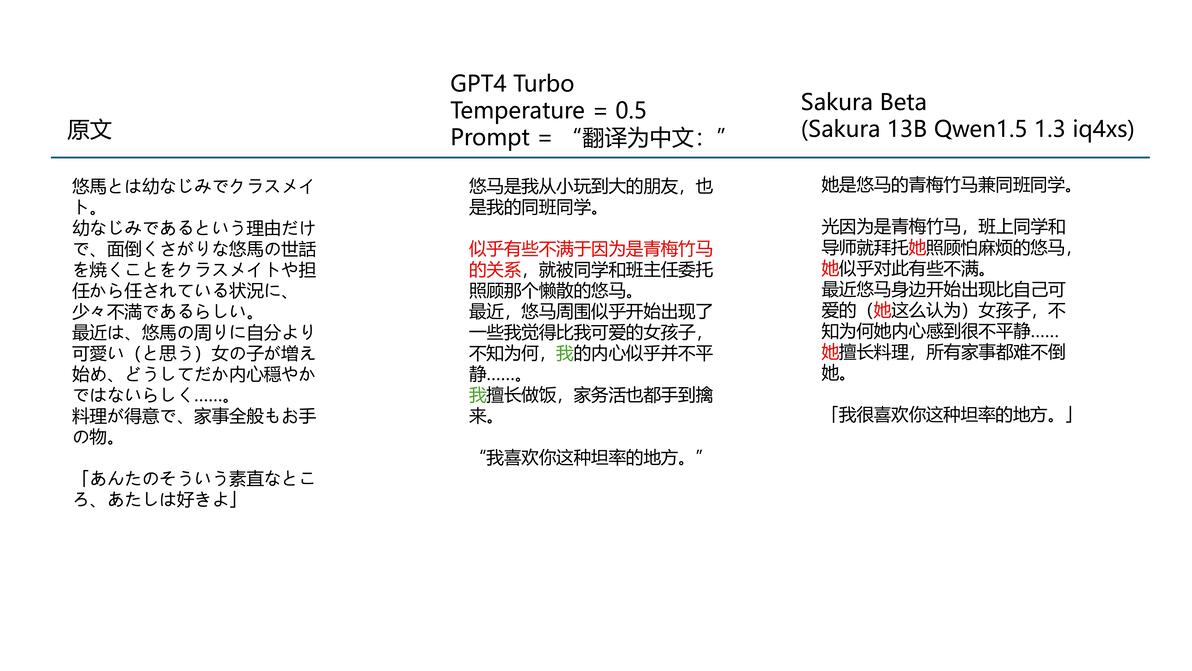
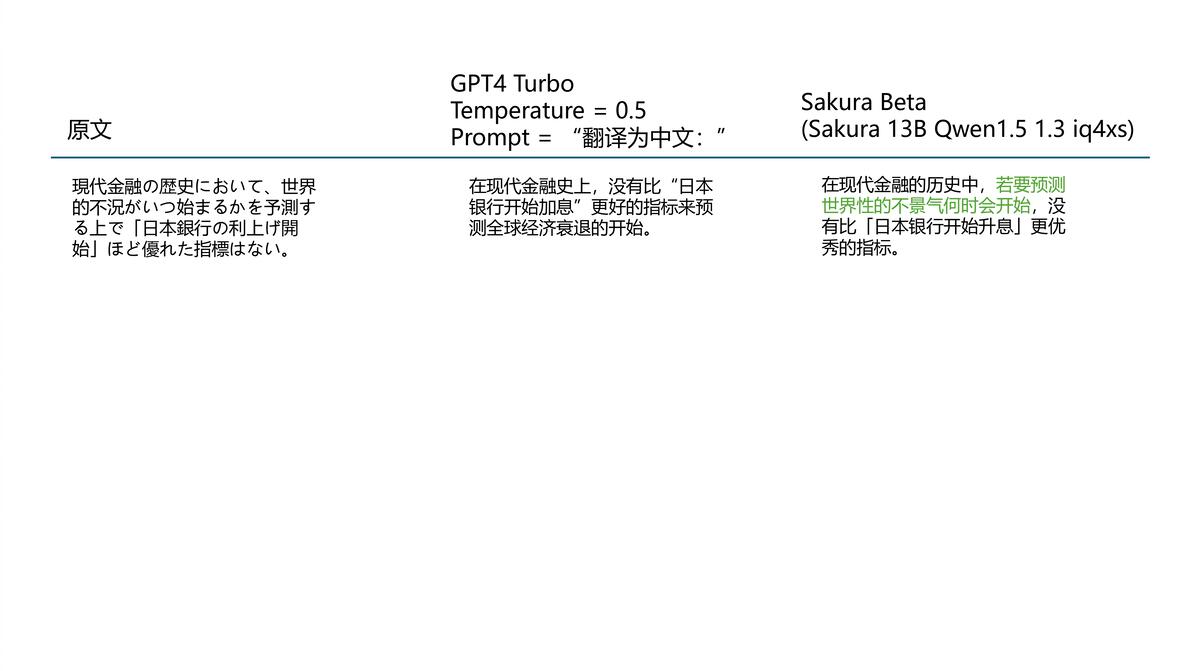
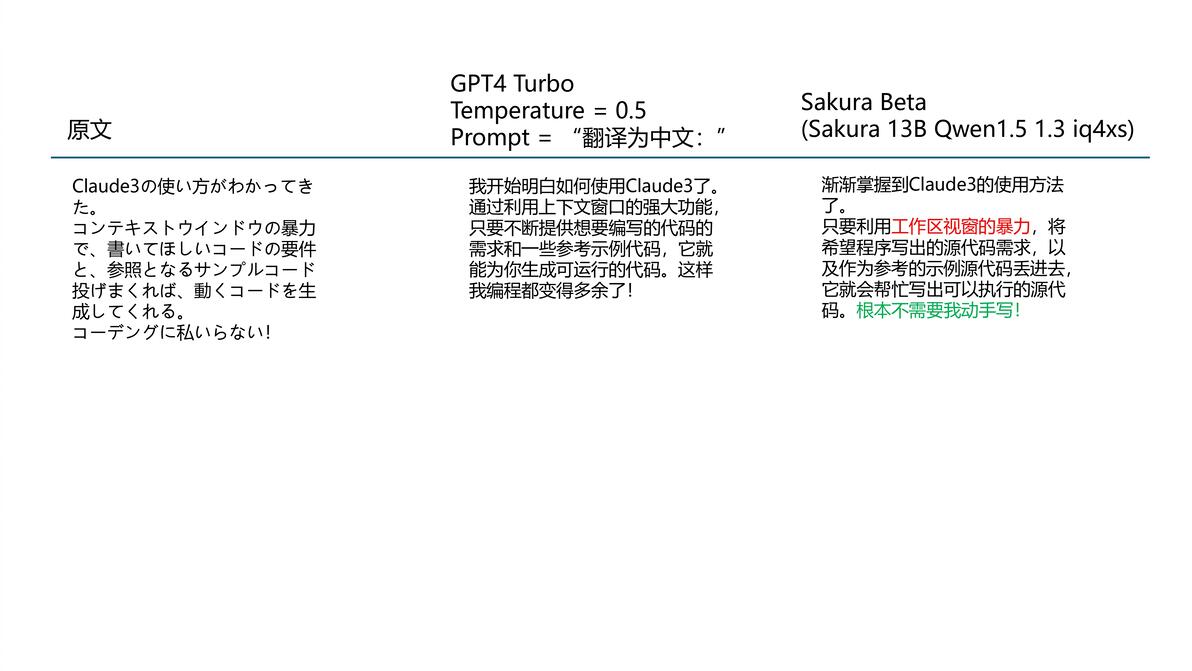
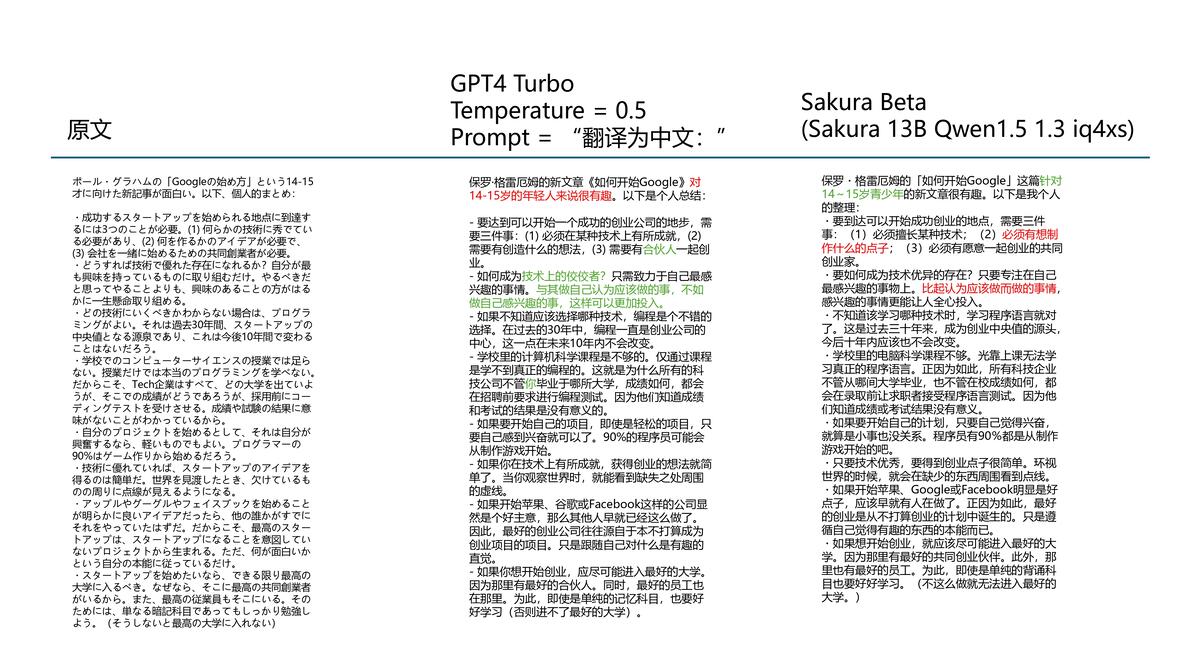
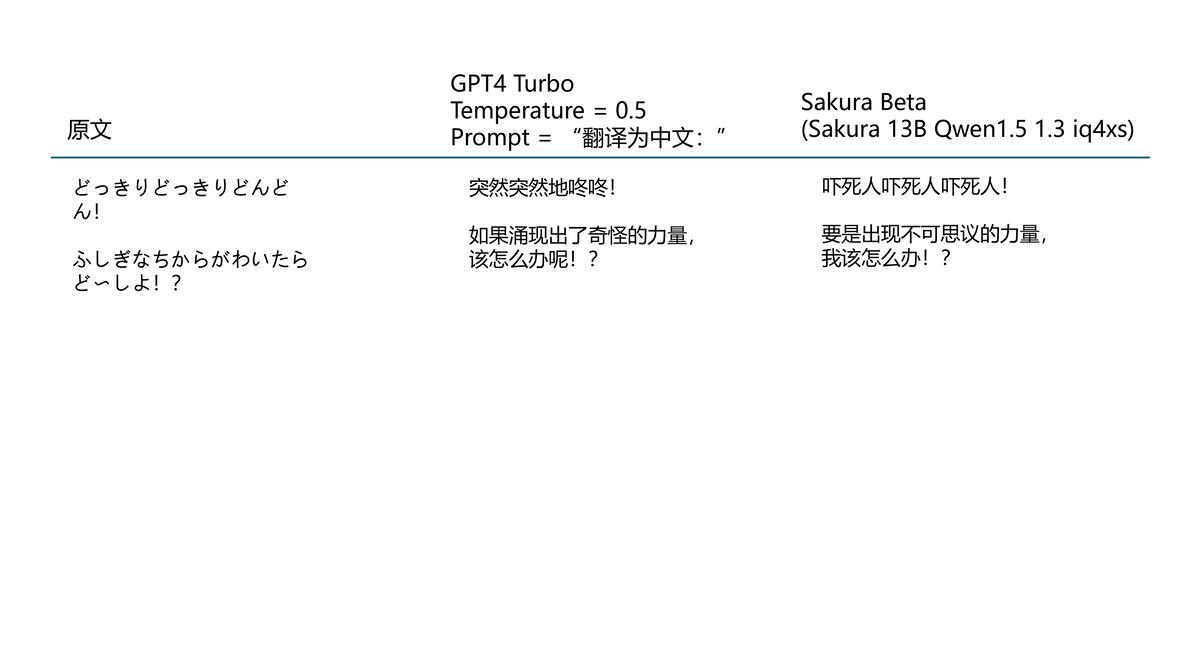
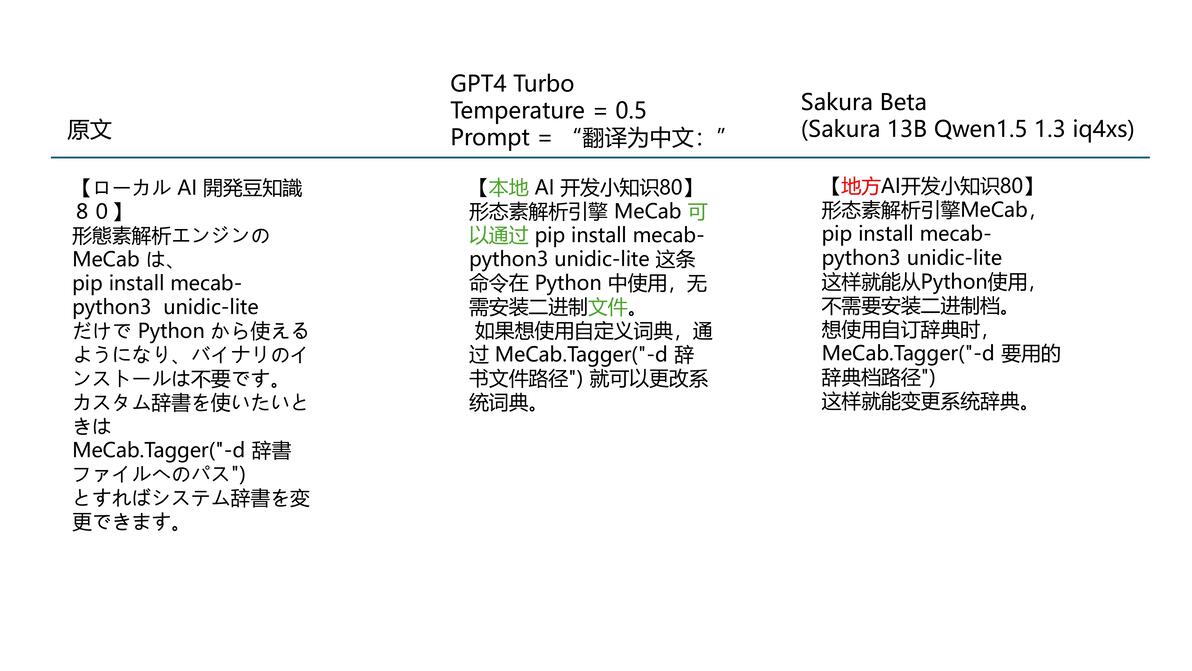
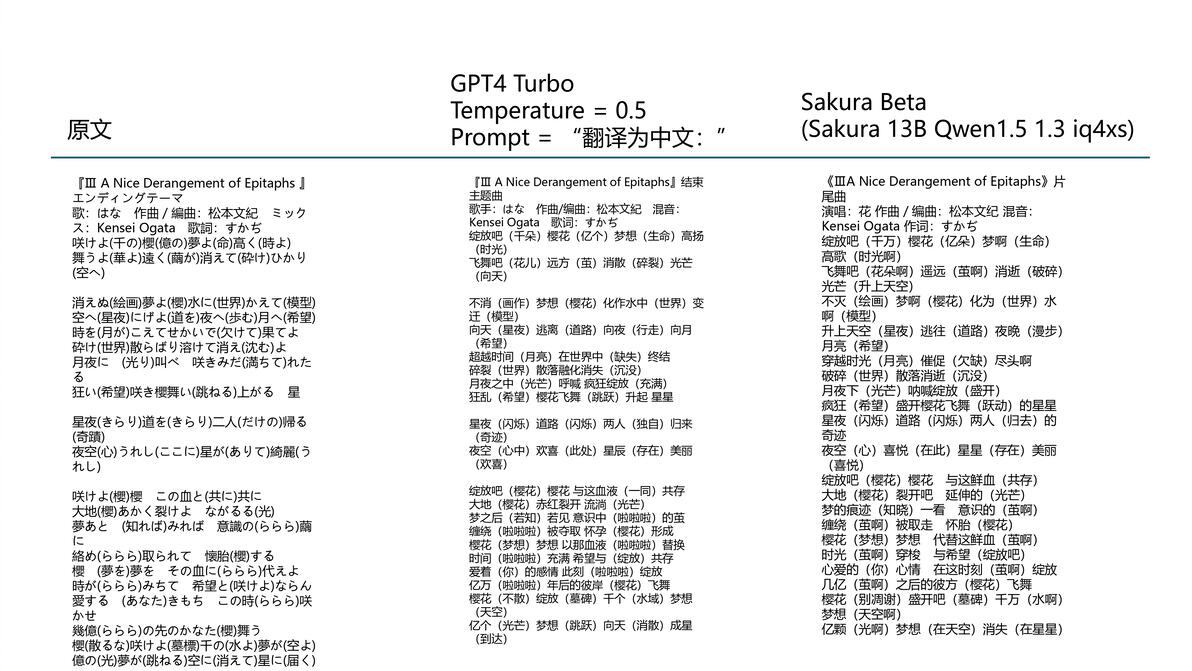
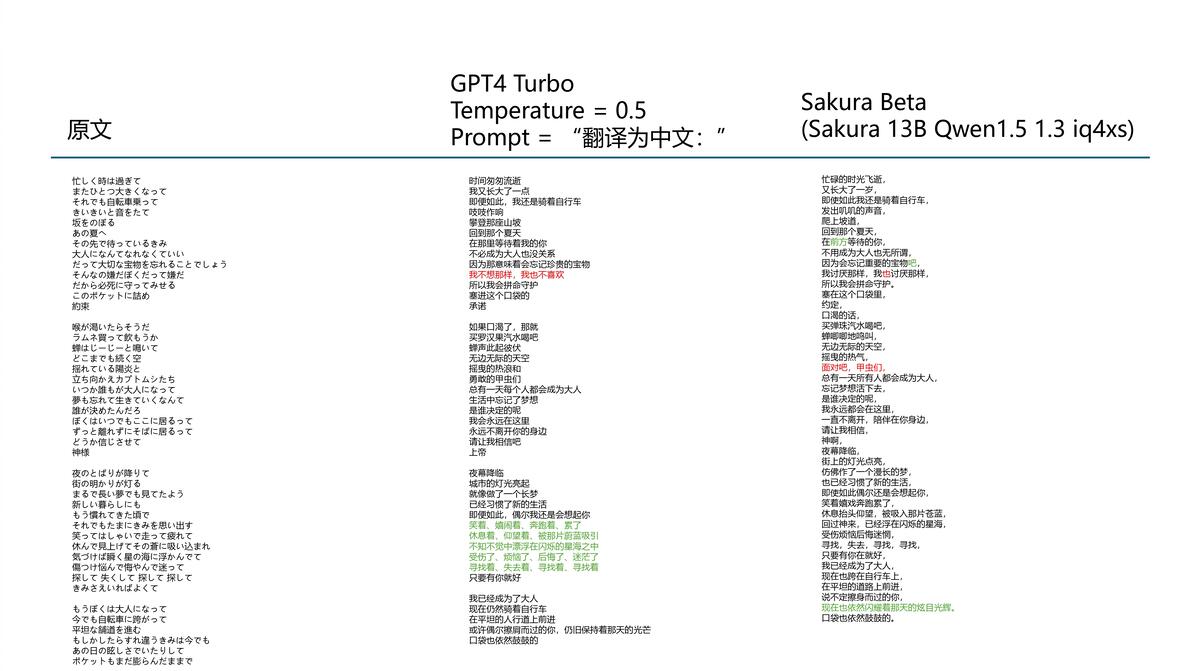
本次测试将 Sakura-13B 与 GPT4 Turbo 直接进行对比。语料主要有几个来源:
Galgame 的介绍语
日语歌词
推特上的一些近期日文内容
最后一条是为了避免命中训练集中的数据设置的。
所有文段和结果展示如下,其中,绿色标注是作者认为该模型翻译正确/出彩的位置,而红色则是不通顺或有错误。
结果总结
作为一个只有 130 亿参数,量化后占用显存在 12G 左右的语言模型,Sakura 13B 最新测试版达到的效果可以说达到让我震撼的程度。尽管在正式文本中其词汇量、部分句式排列仍逊于 GPT4,但也有许多自然而出色的翻译。而这一切的一切,都是在本地的一张小小的显卡上完成的。
我想,未来,我们应该对小参数的、特定领域的特化模型,更有自信一些。
尾
世界映射在语言中。语言承载着人们的喜怒哀乐、历史与未来、悲伤与希望、更重要的,思想与羁绊。我们生活在一个幸运的时代:借由半导体技术与计算理论,我们,不同的人们,相互的联系与思想的传递,将比以往任何时候都更深刻与便捷。
开源模型的发展是互联网精神的重新体现。再一次见证这久违的风景实在令人感慨。
NeterOster,
2024/03/20.
