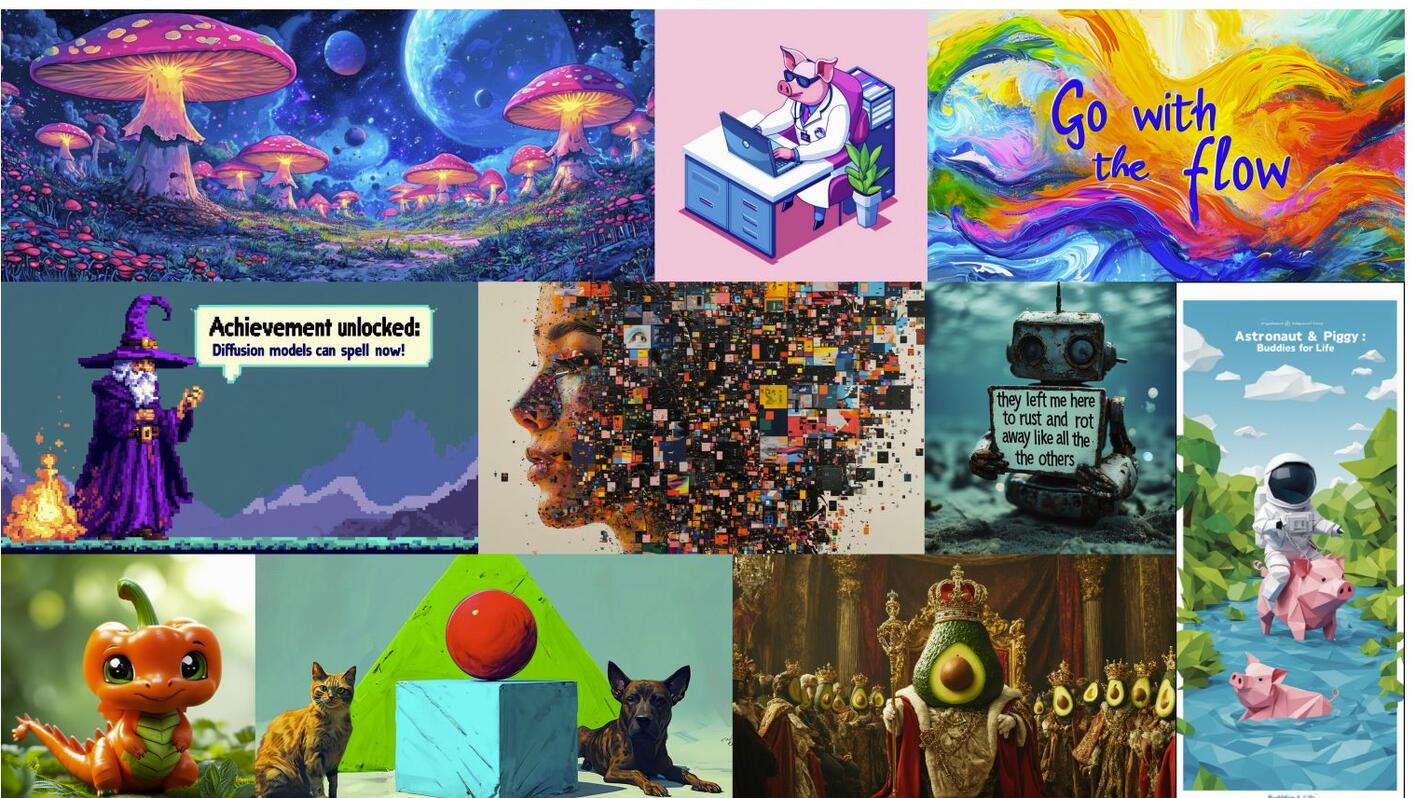

稳定扩散3(Stable Diffusion 3,简称SD3)的研究论文展示了很多技术细节。SD3在多个关键领域超越了当前的最先进系统,如DALL·E 3、Midjourney v6和Ideogram v1,特别是在排版和遵循提示方面。其新颖的多模态扩散变换器(MMDiT)架构,通过为图像和语言表示使用独立的权重集,显著提高了文本理解和拼写能力。此外,SD3展示了在视觉美学、遵循提示和排版方面的卓越性能,基于人类偏好评估胜过其他模型。通过改进的矩形流(Rectified Flow)和灵活的文本编码器,SD3在保持高效性的同时,进一步提升了生成质量和速度。 论文:Scaling Rectified Flow Transformers for High-Resolution Image Synthesis 链接:https://stabilityai-public-packages.s3.us-west-2.amazonaws.com/Stable+Diffusion+3+Paper.pdf 详细介绍 1 性能对比
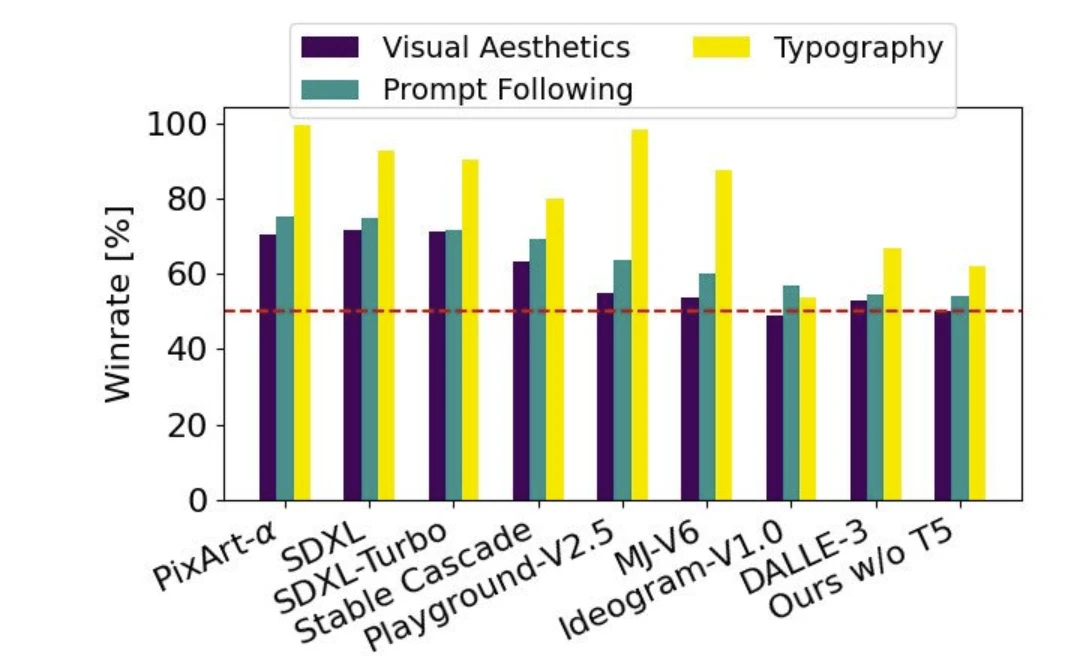
SD3与包括SDXL、Stable Cascade、Playground v2.5、Pixart-α以及闭源系统如DALL·E 3、Midjourney v6和Ideogram v1在内的多个模型进行了比较。基于人类反馈的性能评估显示,SD3在遵循提示、排版质量和视觉美学方面等于或优于这些最先进的文本到图像生成系统。 2 架构细节
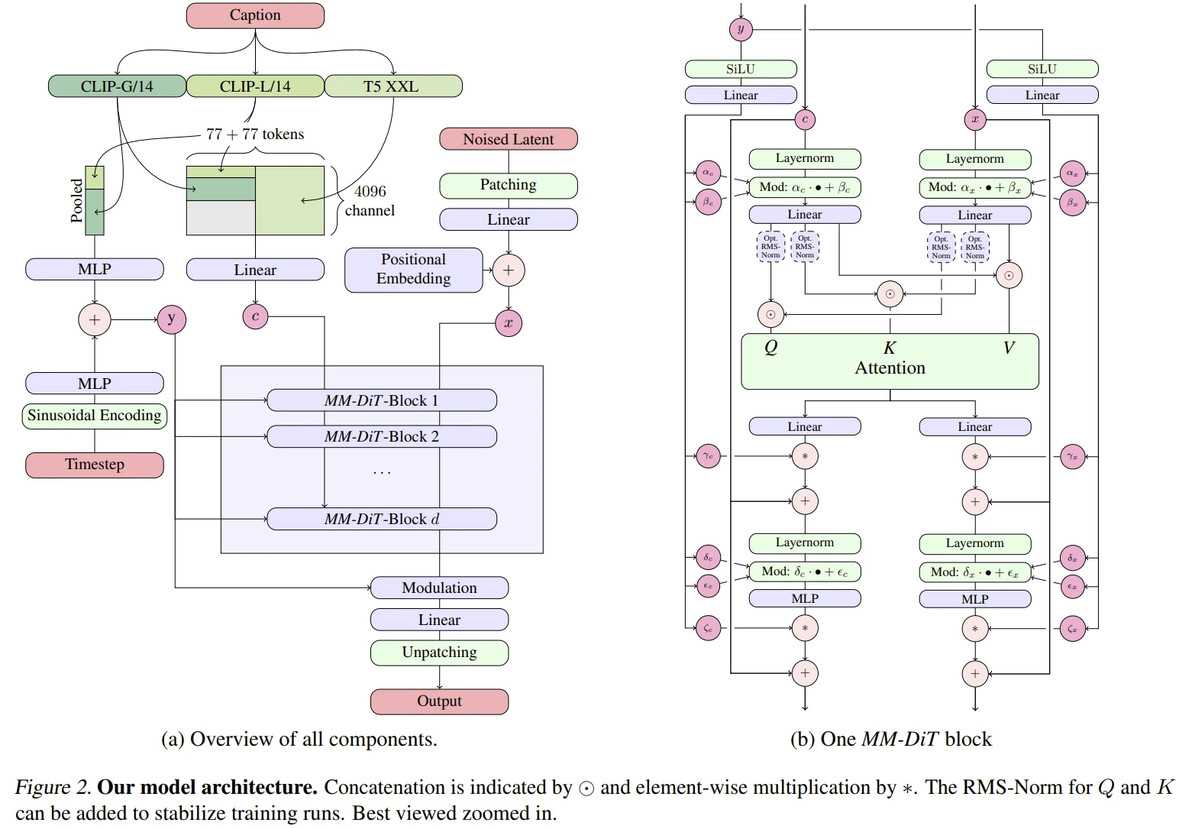
SD3采用了多模态扩散变换器(MMDiT)架构,这是一种考虑到文本和图像两种模态的新架构。通过使用预训练模型获取适当的文本和图像表示,并为这两种模态使用独立的权重集,MMDiT能够在保持各自空间独立性的同时,让两种表示形式在注意力操作中相互作用。 3 指令能力
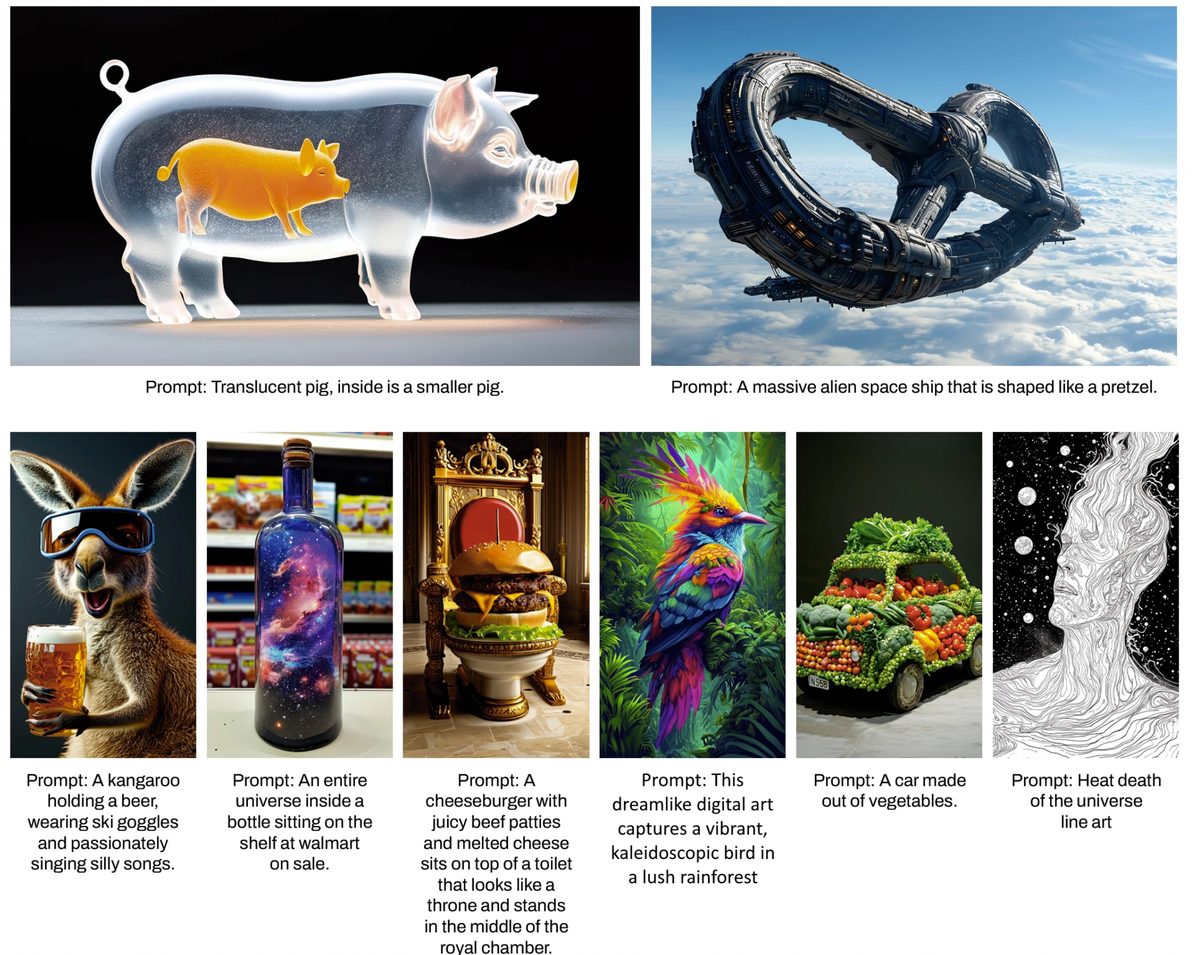
得益于MMDiT架构,信息能够在图像和文本标记之间流动,从而提高输出生成的整体理解能力和排版质量。此架构还可以轻松扩展到多种模态,例如视频。得益于稳定扩散3改进的提示遵循能力,我们的模型能够创造出专注于各种不同主题和特质的图像,同时在图像风格上保持高度的灵活性。
4 改进的矩形流 SD3采用了改进的矩形流(Rectified Flows, RF)公式,通过在训练期间将数据和噪声连接在一条直线轨迹上,实现了更直接的推理路径,从而允许使用更少的采样步骤生成图像。此外,通过引入一种新的轨迹采样计划,SD3进一步提高了性能。 5 灵活的文本编码器 通过在推理时移除内存密集的4.7B参数T5文本编码器,SD3能够显著降低内存需求,同时只造成微小的性能损失。这一策略在不牺牲视觉美学的情况下,仅略微降低了文本遵循能力。
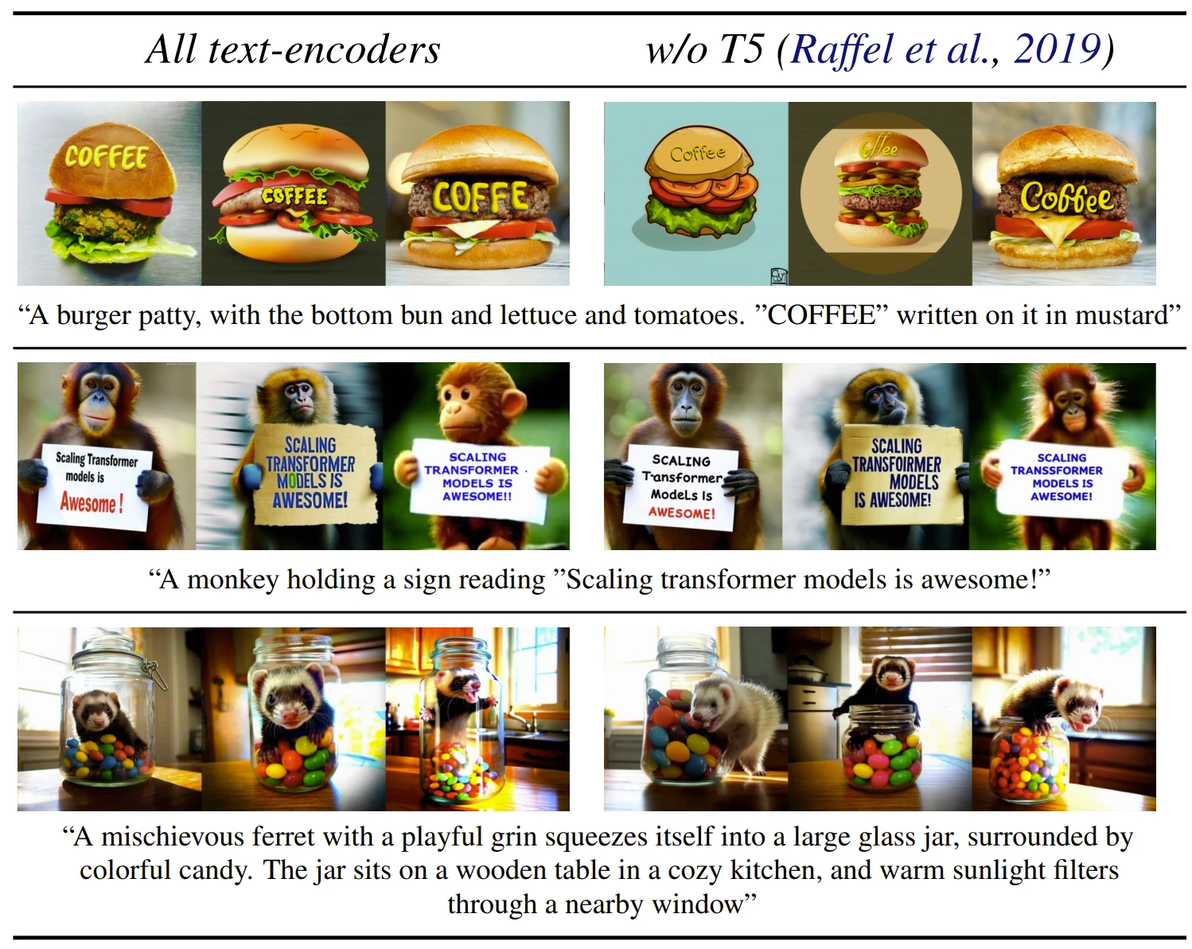
观点 学术上,从SD3和sora的效果可以看出,可扩展的框架才是未来的主流。并且,MMDiT的许多改进都挺有意思的,可以深入了解一下的。 商业上,SD3的高效性和灵活性使其成为企业和创意专业人士的有力工具,生产内容的主体可以逐步从组织变成个人。
特邀作者:日本早稻田大学计算机系博士生 王军杰
